重磅!OpenAI放大招,新模型GPT-4o 正式发布:视频语音交互丝滑到吓人,还免费可用...

【AUTOSAR-E2E】-2.2-配置E2E:基于E2EPW配置一个TX发送的Signal Group(使用E2E Profile 2) 《共13页精讲》:此法也适用于E2E Profile 4/5/6/7/11/22 目录 1 检查CAN Matrix Arxml/DBC是否满足E2E需求 2 在DaVinci Developer中为Port添加E2E保护 3 在DaVinci Configurator settings设置 4 如何使用应用层的E2E保护 5 结尾 <--返回「Autosar_BSW高阶配置」总目录--> <--返回「Autosar_BSW高阶配置」专栏主页--> &lt. 阅读详情

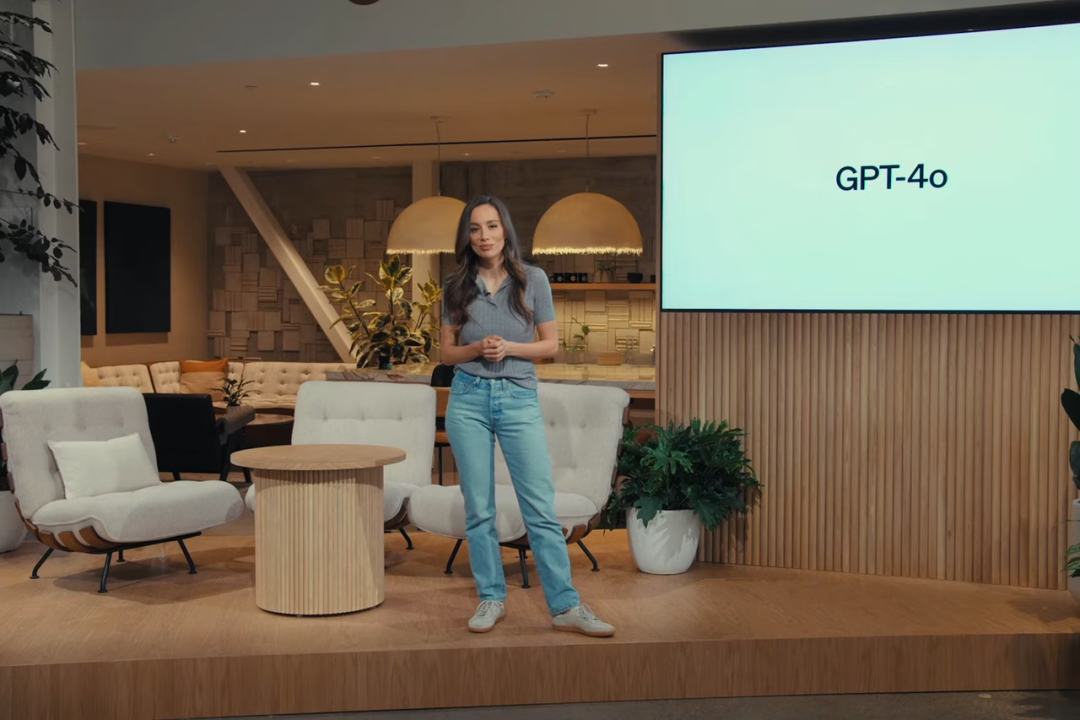
今晨,一场不足半小时的发布活动,再次极大地颠覆了人工智能产业和我们未来的日常生活,并将无数AI初创企业推向慌乱之境。

这并非夸大其辞,因为这是由OpenAI主办的发布会。

刚刚过去的,OpenAI宣布推出了GPT-4o型号,其中的「o」象征着「omni」(意即全面、全能),显示出这款模型不仅具备文本处理能力,还能处理图像、视频和语音,它甚至可以视作GPT-5的前身。

更为关键的是,这一GPT-4级别的模型将向所有用户公开,并预计在接下来几周优先升级至ChatGPT Plus用户。
32d751f7dde28319f32ee54cf6b47879.png

我们先给大家一次性总结这场发布会的亮点,更多功能解析请接着往下看。

发布会要点

1.

新的 GPT-4o 模型:打通任何文本、音频和图像的输入,相互之间可以直接生成,无需中间转换

2.

GPT-4o 语音延迟大幅降低,能在 232 毫秒内回应音频输入,平均为 320 毫秒,这与对话中人类的响应时间相似。

3.

GPT-4o 向所有用户免费开放

4.

GPT-4o API,比 GPT 4-Turbo 快 2 倍,价格便宜 50%

5.

惊艳的实时语音助手演示:对话更像人、能实时翻译,识别表情,可以通过摄像头识别画面写代码分析图表

6.

ChatGPT 新 UI,更简洁

7.

一个新的 ChatGPT 桌面应用程序,适用于 macOS,Windows 版本今年晚些时候推出

这些功能早在预热阶段就被 Altman 形容为「感觉像魔法」。既然全世界 AI 模型都在「赶超 GPT-4」,那 OpenAI 也要从武器库掏出点真家伙。

当然,还轮不到 GPT-5 登场。

视频来自@dotey

免费可用的 GPT-4o 来了,但这不是它最大的亮点

虽然免费提供的GPT-4o本身就非常引人注目,但这并不是它的最大卖点

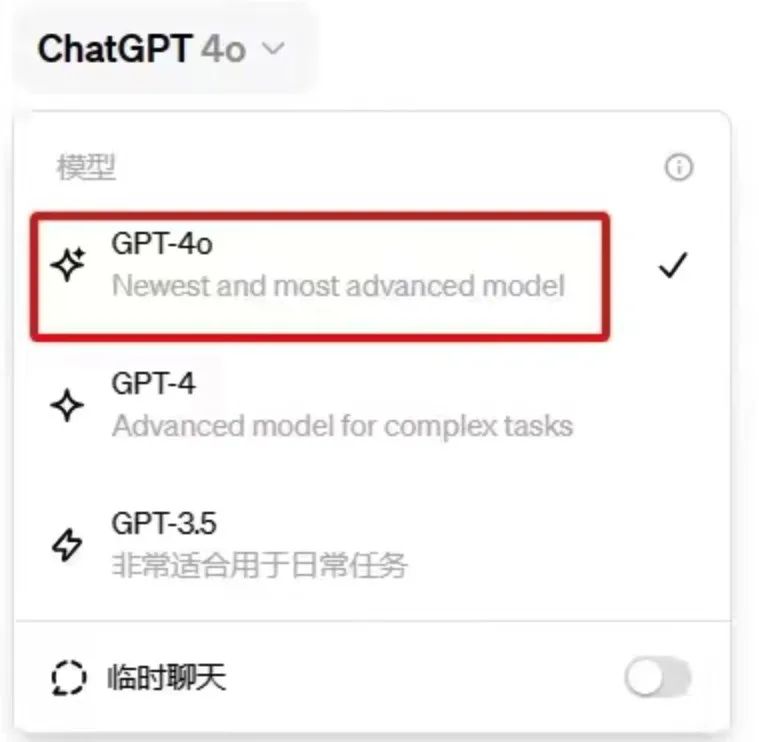
在发布会前一天,我们注意到OpenAI已悄然将GPT-4的描述从「最先进的AI模型」更改为仅仅「先进」。这正好为GPT-4o的到来作了铺垫。

GPT-4o的强大之处在于,它能够处理任何组合的文本、音频和图像输入,并直接产出这几种媒介的输出。

这预示着人机交流将愈发贴近人与人之间的自然沟通方式。

GPT-4o能够在232毫秒的时间内回应音频输入,平均反应时间为320毫秒,非常接近于人类交谈时的反应时间。以往与ChatGPT进行语音交流时,平均延迟为2.8秒(GPT-3.5版)和5.4秒(GPT-4版)。

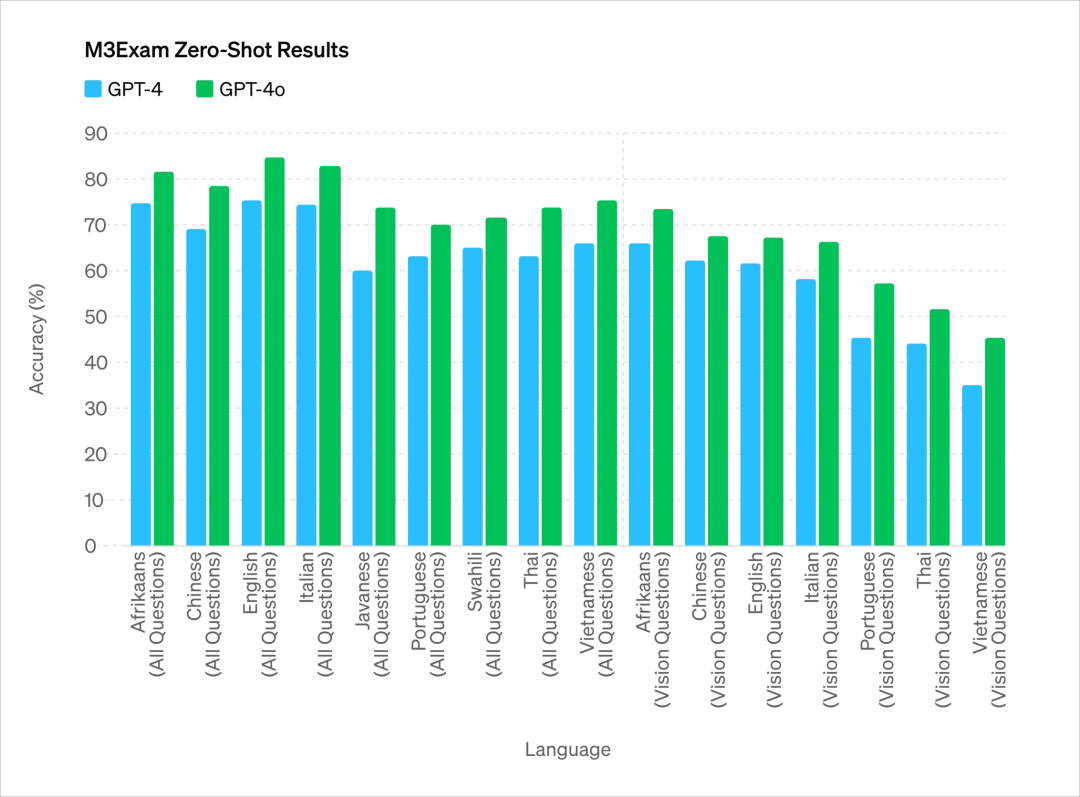
在英语文本和编程代码方面,它的性能与GPT-4 Turbo相媲美,在非英文文本处理方面有显著进步,同时API的响应更快,且价格降低了50%。
e58000d36c9a2c998d8322ad8c0df070.png

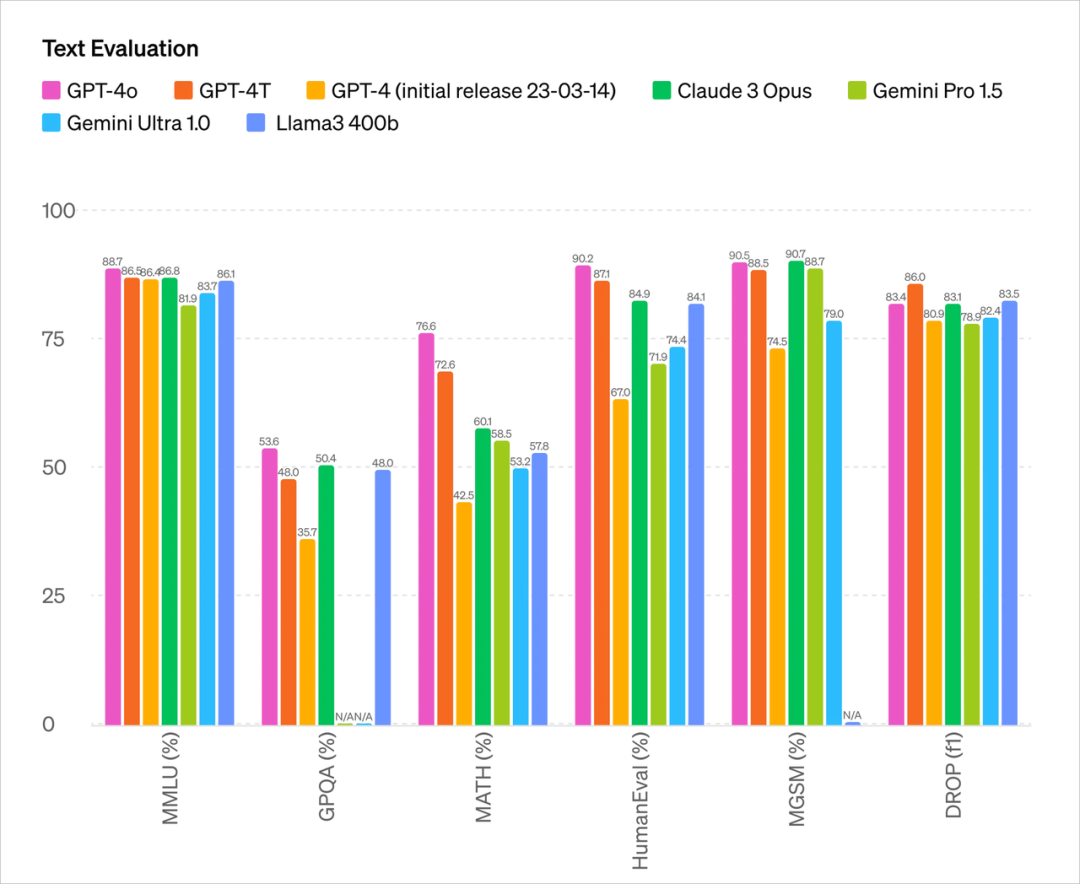
而与现有模型相比,GPT-4o 在视觉和音频理解方面表现尤为出色。

你在对话时可以随时打断

可以根据场景生成多种音调,带有人类般的情绪和情感

直接通过和 AI 视频通话让它在线解答各种问题

从测试参数来看,GPT-4o 主要能力上基本和目前最强 OpenAI 的 GPT-4 Turbo 处于一个水平。
0eb504fc34d25b6424449b27ba6ac47d.png

8fa61ab75c867e1de60ac31f7f9e739a.png

向左滑动查看更多内容

5fe97d43421c7227a09cb54154f4ef79.gif

在之前,使用Siri或其他语音助手的体验都不算理想,主要是因为语音助手需要经历以下三个阶段:

1.语音识别或称为「ASR」:将音频转换为文本,类似于Whisper技术;

2.用LLM计算下一步的发言内容:把文本1转换为文本2;

3.语音合成或「TTS」:再将文本2转换为音频,想象一下ElevenLabs或VALL-E的技术。
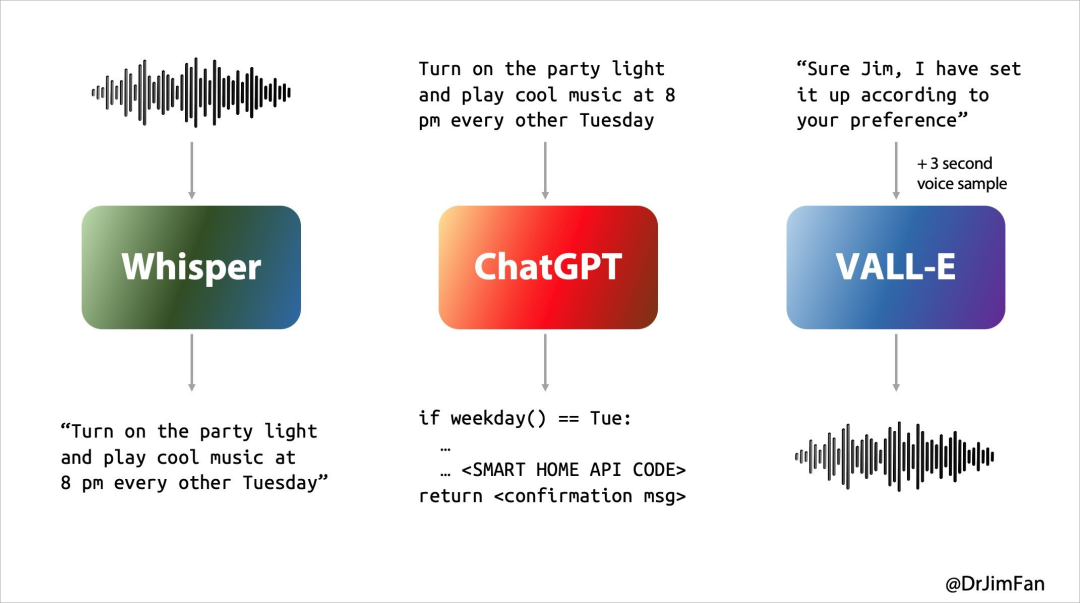
a92b3f76a94afa12fb0de6d33fcec7e3.png

然而我们日常的自然对话却通常包括这些过程:

a、一边听一边考虑接下来要说的内容;

b、在合适的时候插入像「是的」、「嗯」这样的应答;

c、预判对方讲话结束的时刻,并立即接话;

d、自然地决定是否打断对方,并且做到不引发不快;

e、在听和说的同时,思考下一步的对话内容;

f、在合适的时刻插入像「是的」、「嗯」这样的应答;

g、优雅地处理并打断对话。

之前的AI语言助手无法很好地处理这些问题,在对话的每个阶段都会出现延迟,因此体验不佳。并且在这个过程中会丢失许多信息,比如无法直接捕捉到语调变化、多个说话者的区分或背景噪音,并且无法表现出笑声、歌声或其他情感。
6218085fab26976f2e1f07bfc90f6a77.png

一旦音频能够直接转换为音频、图像、文字和视频,整个体验将是革命性的。

GPT-4o正是OpenAI为了实现跨文本、视频和音频的直接互转而训练出的全新模型,这一目标要求所有的输入和输出都由同一个神经网络处理。

而令人惊讶的是,即使是免费的ChatGPT用户也能够使用GPT-4o体验以下功能:

a、感受GPT-4级别的智能表现

b、直接从模型和网络获得响应

c、分析数据以及制作图表

d、分享你拍摄的照片并开展对话

e、上传文件以获取摘要、写作或分析的帮助

f、使用GPT技术和GPT应用商店

g、通过内存功能构建更为帮助的体验

当你观看GPT-4o的以下一些演示之后,可能会有更加复杂的情绪。

ChatGPT 版「贾维斯」,人人都有

ChatGPT不仅能听,还能说,同样还能看。这已经不是什么新鲜事了,但升级版的ChatGPT依然令人印象深刻。

睡前帮手

以一个具体的生活情景为例,如果要求ChatGPT讲述一个关于机器人和爱情的睡前故事,它能迅速不假思索地吐露一个情感丰富、情节动人的故事。

它甚至还能以唱歌的形式来叙述这个故事,几乎可以当做用户的睡眠伴侣。

答题能手
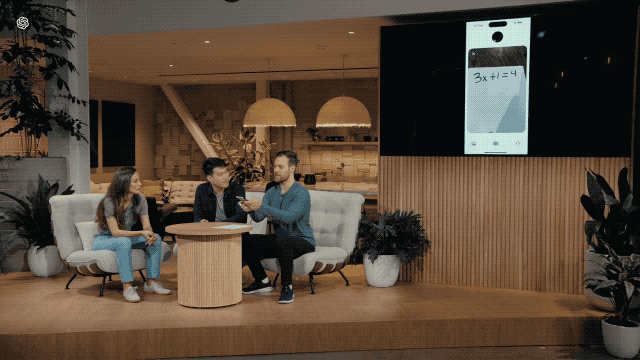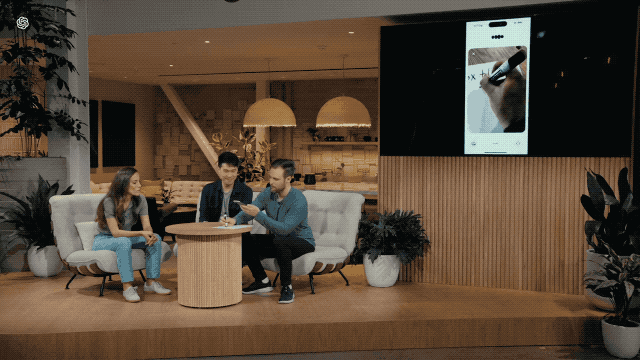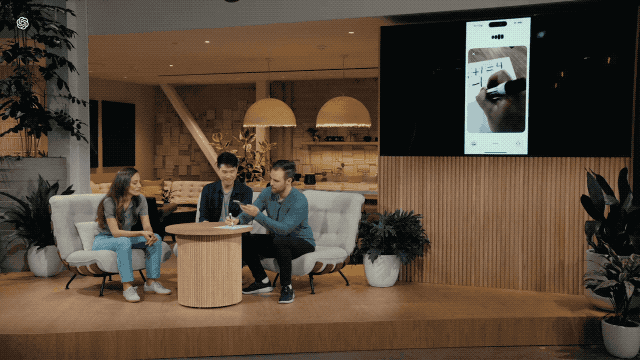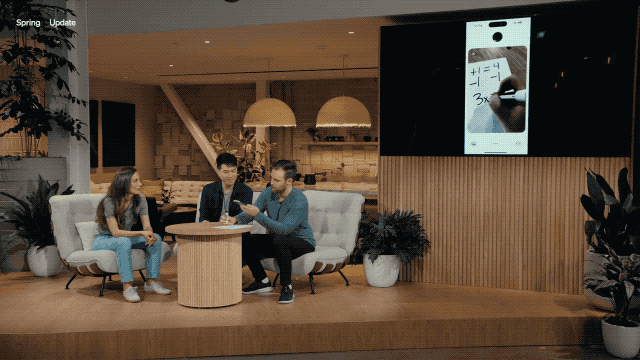
d7e3543c752f349a58ff674e7d34b838.gif

或者,在发布活动现场,当要求其演示如何为线性方程3X+1=4解题时,它能够耐心地一步一步指导并给出正确答案。

当然,以上还只是一些基础应用,现场的编程难题才是真正的挑战。不过,这些问题对它来说都不在话下,能够轻而易举地解决。
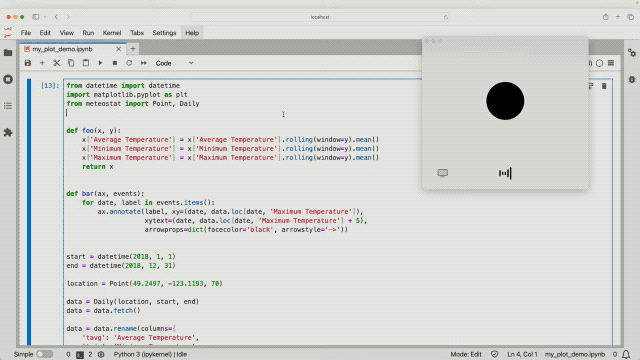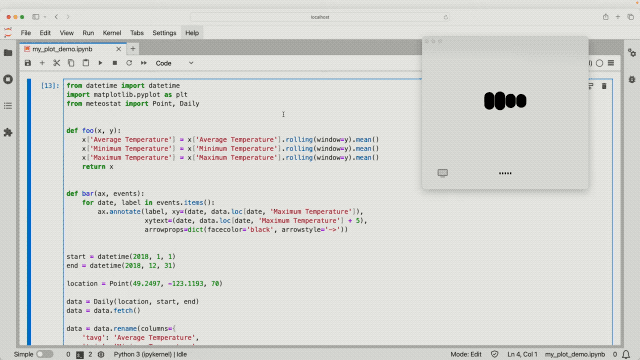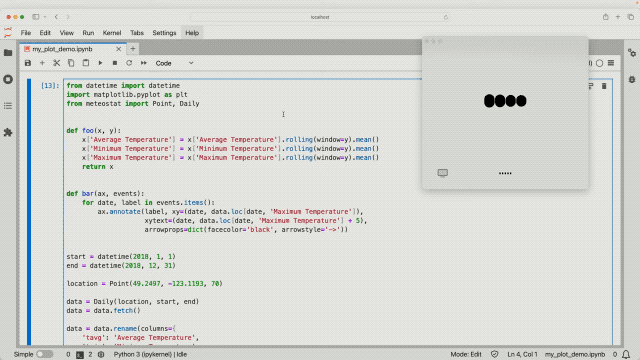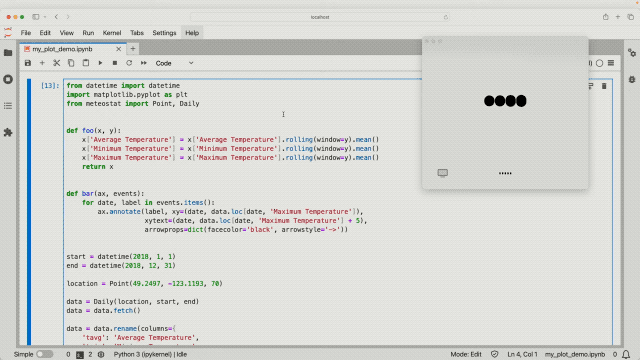
3833850daead79114cd56f4b6445001a.gif

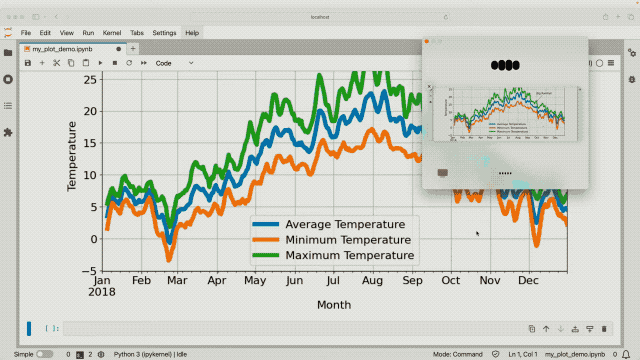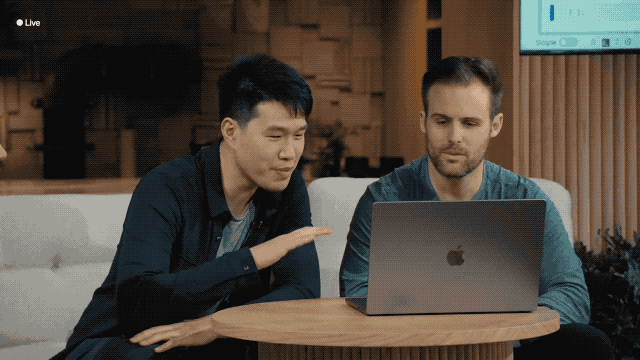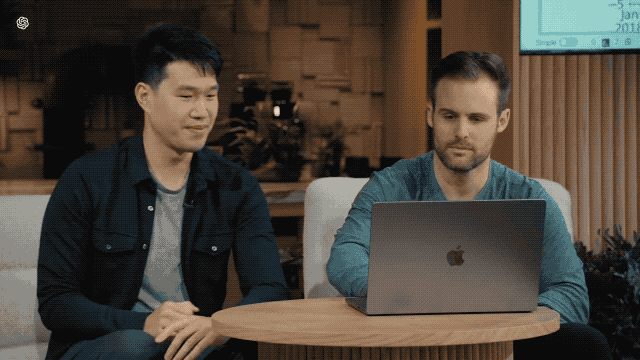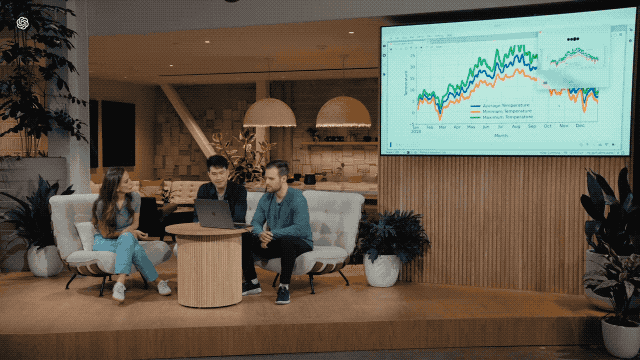
利用ChatGPT的「视觉功能」,它能够查看电脑屏幕上的所有内容,比如与代码库互动、查看代码生成的图表。这是否意味着我们将来的隐私也会被一览无遗?
3fadcbf80945c218dd63e3f0b91b080a.gif

同声传译

发布会现场的观众也向ChatGPT提出了一些棘手的问题。

无论是从英文翻译成意大利文,还是从意大利文翻译成英文,不管怎样挑战这个AI语音助手,它都能游刃有余地应对。未来,ChatGPT可能会比目前市面上的实时翻译设备更加可靠。

同声传译(官网案例)

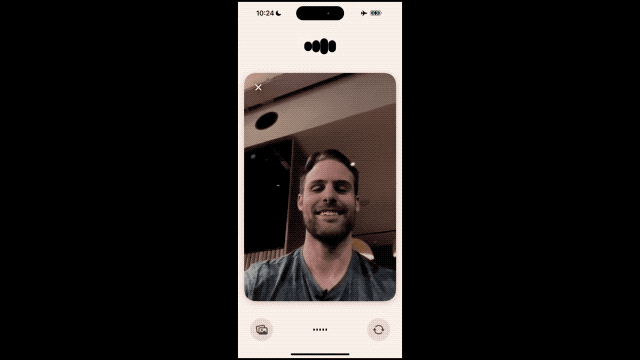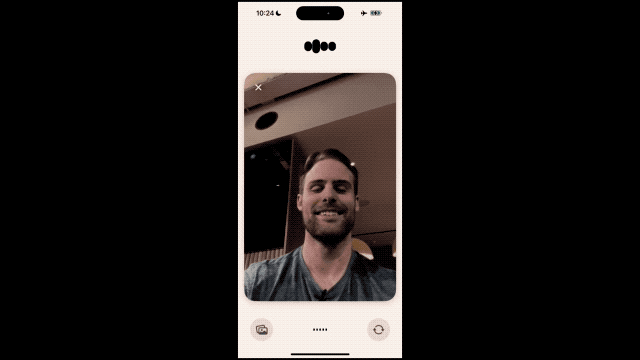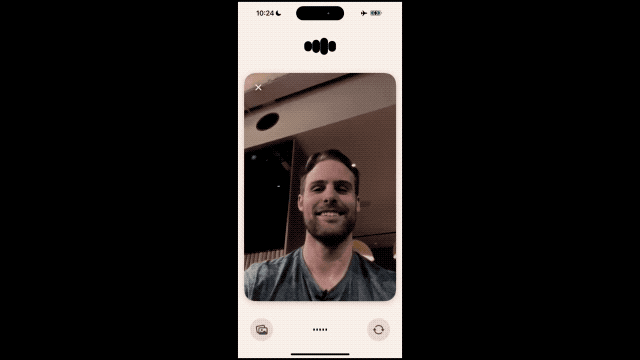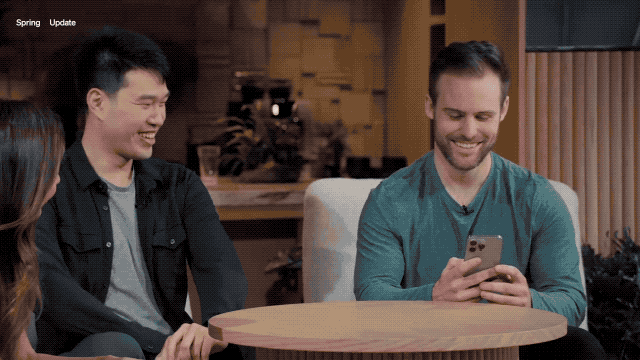
感知情绪语言只是第一步,ChatGPT还能解读人脸表情。
22b5a08c4397a3cd6338d8c4b10525d0.gif

在发布会现场,当面对摄像头拍摄的人面部时,ChatGPT一开始错误地将其识别成了桌子,让人误以为要出错了。但原来是因为开启的前置摄像头首先瞄准了桌子。

不过最终,它还是准确地描述了拍照面部的情感,并且正确识别了脸上的「灿烂笑容」。

两个 GPT-4o 互动并唱歌(官网案例)

有趣的是,在发布会快结束时,主持人也不忘提到了英伟达及其创始人老黄所提供的「大力支持」,这显示了对人情世故的理解。

对话语言界面的想法具有令人难以置信的预见性。

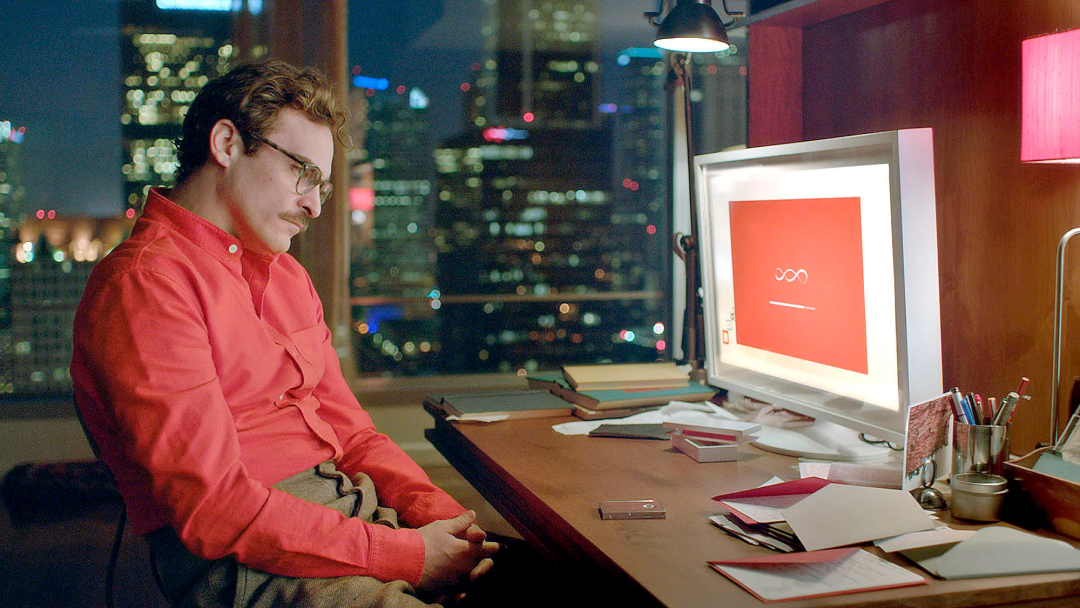
Altman在之前的采访中曾表示,他希望最终开发出类似于AI电影《她》中的AI助手。而今天OpenAI发布的语音助手,确实接近了现实版的「她」。
593b7d1d4a55e370e1242da0359ffaf9.png

OpenAI首席运营官Brad Lightcap不久前预测,未来我们会像与真人交谈一样与AI聊天机器人对话,把它们视作团队中的一员。

现在看来,这不仅为当日发布会埋下了伏笔,同时也是对我们未来十年生活方式的生动预告。

苹果在AI语音助手领域「徘徊」了十三年都未能找到方向,而OpenAI仅用一夜之力建立了通道。在不远的将来,每个人都拥有类似钢铁侠「贾维斯」的个人助手或许不再是梦想。

《她》来临

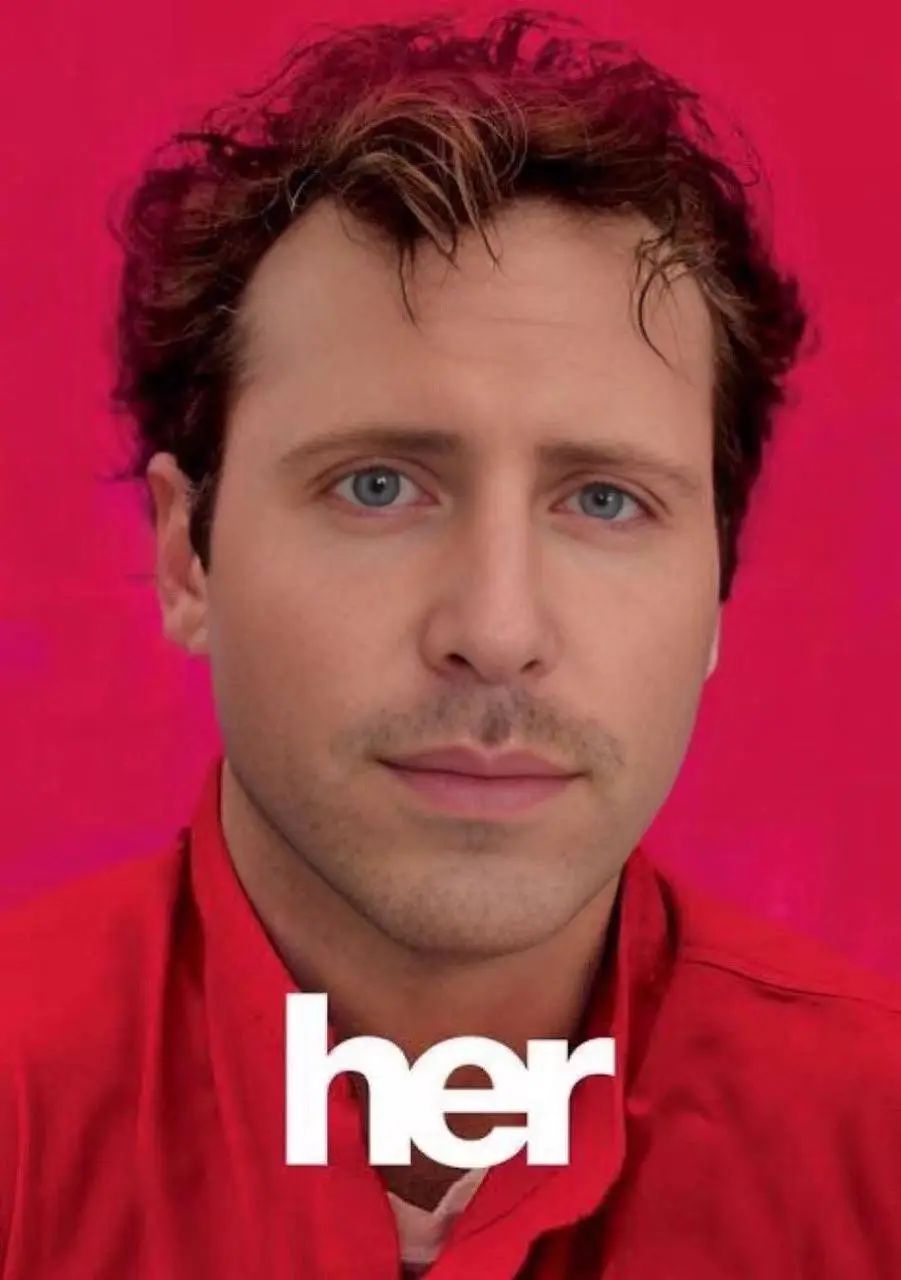
尽管Sam Altman没有亲自出现在发布会上,但在会后他立刻发布了一篇博客,并在X上发布了一个词:her。

这显然是在暗示那部同名经典科幻电影《她》。这也是我在观看发布会演示时,脑海中首先出现的画面。

电影《她》中的萨曼莎,不仅仅是一个普通产品,她甚至比人类更懂人,也更像人类自己。在与她的交流中,人们可能会逐渐忘记她其实是一个AI。
b25009a1f0c7ba67784263f9bb7c91f8.jpeg

这意味着人机交互模式可能会迎来继图像界面之后的真正革命性更新,如同Sam Altman在博客中所说:

全新的语音(和视频)模式是我体验过的最佳计算机界面。它给人一种电影中AI的感觉;我自己依然对它的真实性感到惊讶。达到人类水平的响应速度和表现力,原来是一个巨大的转变。

之前的ChatGPT向我们展示了自然用户界面初露端倪:简单胜过一切——复杂性是自然用户界面的敌人。每个互动都应该是显而易见的,无需任何指导手册。

但今日发布的GPT-4o则完全不同,几乎无延迟的响应、聪明、有趣且实用,我们与计算机的交互从未真正体验过这种的自然顺畅。

隐藏的巨大潜力在于,支持更多个性化功能和与不同终端设备的协同之后,我们将能够利用手机、电脑、智能眼镜等计算设备做到许多过去无法实现的事情。

AI硬件的积累不会停止,目前更让人期待的是,如果下个月苹果的WWDC宣布与OpenAI合作,那么iPhone的体验可能会有前所未有的提升。
b9482b753997b51bfc4e3f6db2f69102.jpeg

英伟达高级科学家Jim Fan认为,号称史上最大更新的iOS 18,与OpenAI的合作可能包含以下几个方面:

舍弃Siri,OpenAI为iOS打造一个完全在设备上运行的小型GPT-4o版本,用户可选择付费升级云服务。

原生功能将摄像头或屏幕流输出到模型中。芯片级支持神经网络音视频编解码器。

将其与iOS系统级操作API和智能家居API集成。人们已经不再使用Siri快捷方式,但现在是时候重振旗鼓了。这可能会成为一款刚上线就拥有十亿用户的AI代理产品。对于智能手机来说,这就像特斯拉的全尺寸数据飞轮。

说到这里,不禁为明天即将举行发布会的谷歌感到凉凉。

最后实测,目前手机版和GPT Plus已经支持GPT-4o,相信马上就会免费开放给GPT 普通用户。
8d50b7c50cf59dc8d7868c4feb7608ae.jpeg

加权均值向量算法(INFO)详解:从数学原理到智能算法 本文系统介绍了加权均值向量算法(INFO)的理论基础、数学模型与实现应用。该算法基于加权均值数学概念,通过MeanRule规则平衡探索与开发能力,具有结构新颖、参数合理的特点。核心内容包括:1) 算法理论基础,阐述加权均值数学定义与小波函数权重计算;2) 算法原理,详细解析更新规则、向量组合和局部搜索三阶段数学模型;3) 实现方法,提供MATLAB代码关键参数解析;4) 改进方向,介绍INFO-KELM混合模型等变体;5) 应用案例,涵盖函数优化、工程设计与机器学习领域。 阅读详情

相关推荐

骁龙X Elite笔记本重装Windows 11 Arm64系统完整指南与避坑手册

UEFI安全启动和Arm64架构是理解现代计算设备系统部署的基础。UEFI取代传统BIOS,提供了更安全的启动环境和模块化固件接口,而Arm64架构则以其高能效特性,在移动和新兴PC领域日益重要。其技术价值在于为设备带来更快的启动速度、更强的安全防护以及更优的功耗表现。在应用场景上,这直接关系到搭载高通骁龙X Elite等Arm处理器的笔记本电脑的系统安装与维护。对于这类设备,重装系统远非插入通用安装盘那么简单,核心挑战在于必须使用专为Arm64编译的Windows镜像,并需提前集成芯片组、网络等硬件的专属

weixin_33428613的博客 484

革命性GPT-4o:重塑人机交互体验

OpenAI 发布的 GPT-4o 模型无疑是一个巨大的突破,特别是在其能够处理多种输入媒介(文本、音频、图像)并生成相应输出方面。这种能力使得人机交互更加自然和直观,极大地提升了 AI 的实用性和可用性。GPT-4o 的几个关键亮点包括:1. 跨媒介输入/输出:GPT-4o 能够接受文本、音频和图像的任意组合作为输入,并直接生成这些媒介的输出。这打破了传统 AI 模型仅处理单一输入类型的限制,使...

wang_yu_shun的博客 352

Comsol固体力学仿真﹣﹣受均匀内压的厚壁球壳弹塑性分析(加载卸载全流程)

COMSOL固体力学及结构力学仿真较少,故而查询了有关资料,才建立了如下模型。图4 加载卸载全历程中的冯米塞斯应力变化。该有限元模型是通过扫掠而得的结构化网格。图2 加载卸载全历程中的塑型区域变化。图3 加载卸载全历程中的位移应力变化。图6 关键节点第一,第三主应力分布。图5 关键节点应力场与塑性区分布。《弹塑性力学》大作业,记录一下。图1 球体的有限元网格模型。

weixin_62236383的博客 1486

AI 音频/文本对话机器人:Whisper+Edge TTS+OpenAI API构建语音与文本交互系统(简易版)

在本篇博客中,我将分享如何利用Whisper模型进行语音转文本(ASR),通过Edge TTS实现文本转语音(TTS),并结合OpenAI API实现文本生成的语音与文本交互系统。这个系统可以用于构建智能助手、语音交互应用等场景。前段时间学了英伟达系列课程,最近有时间基于视频中的demo设计了一个支持文本和语音问答的ai机器人。一个内网ip可供访问,一个公网ip 72小时有效视频效果展示AI 音频/文本对话机器人。

小邓博客 2910

Shopee滑块验证码太刁钻?手把手教你用Python+Playwright绕过弧形验证(附影刀RPA接入代码)

本文详细介绍了如何使用Python和Playwright结合SadCaptcha第三方服务高效破解Shopee平台的弧形滑块验证码,并集成到影刀RPA工作流中。该方案开发周期短、准确率高(>90%),特别适合跨境电商自动化操作,已在实际项目中验证成功。

weixin_29284657的博客 567

[计算机头歌]爬虫进阶

【代码】爬虫进阶。

M_inherit的博客 921

GPT-4o,AI实时视频通话丝滑如人类,Plus功能免费可用

不开玩笑,电影《她》真的来了。OpenAI最新旗舰大模型,不仅可用,能力更是横跨听、看、说,丝滑流畅毫无延迟,就像在打一个视频电话。现场直播的效果更是炸裂:它能感受到你的呼吸节奏,也能用比以前更丰富的语气实时回复,甚至可以做到随时打断。GPT-4o里的“o”是的缩写,也就是**“全能”**的意思,。它可以在短至232毫秒、平均320毫秒的时间内响应音频输入,。

2401_84587944的博客 1992

音视频开发基础(1):模拟视频技术简介

模拟视频技术是指用模拟技术对动态影像进行捕捉、记来、处理、存储、传输、复现的技术.模拟视频技术的发明、发展与模拟电视系统的发展密不可分.下面将通过模拟电视系统来介绍模拟视频技术中的基本概念. 首先,人的视觉系统的特征为电视等視稿系铳的发明、发展提供了理论依据.光线通过角膜、腫孔、晶状体的折射光线.透过玻璃体到达视网展.视网膜上分布着光感受器,光感受器在光线的剌激下...

琅嬛福地 1493

GPT-4o视频通话版本下周来袭!你准备好了吗?

就在刚刚,openai CEO在推特上宣布,将在下周上线GPT-4o的视频通话版本,据悉这个版本将能实现毫秒级的视频识别。能够即时与GPT进行视频交互问答,实属大语言模型领域革命性的更新。而这个版本也将在Chatgpt plus(4.0)用户身上优先推送。而国内开通GPT4.0又颇有门槛,所以今天我就来教一下大家如何用最简单的方法开通GPT4.0,从而能够在下周体验上最前沿的AI黑科技。按下图操作开卡,推荐5347开头的mastercard,三分钟就能开成功。左上角打开升级界面,点中间绿色的个人版。

jhymdl3的博客 562

深入解析机器人软件开发中的核心:状态机管理(FSM)—— 理论、实践与优化

状态机(FSM)是机器人软件开发中管理复杂行为逻辑的核心工具,广泛应用于导航、任务执行、故障处理等场景。本文系统探讨状态机的基础理论(定义、要素)、主流设计模式(经典FSM、分层状态机HSM、行为树BT),以及工业级实现方法(代码架构、线程安全、调试技巧)。通过移动机器人导航和机械臂任务执行的案例,分析分层状态机的实际应用,并总结常见陷阱(如状态爆炸、阻塞操作)与优化策略(异步化、事件过滤)。

郑伟强dev的专栏 292

ARFoundation系列讲解-教程目录

一、教程目录 ARFoundation快速入门-01简介 ARFoundation快速入门-02环境搭建 ARFoundation快速入门-03环境配置之iOS ARFoundation快速入门-04环境配置之Android ARFoundation快速入门-05ARKit设备支持列表 ARFoundation快速入门-06ARCore设备支持列表 ARFoundation快速入门-07检查设备支持 ARFoundation快速入门-08平面检..........

a451319296的博客 3万+

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 224

主流反爬虫、反作弊防护与风控对抗手段

主流反爬虫、反作弊风控防护中的核心设计点与对抗策略

吴秋霖的博客 2555

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 235

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

本地化部署会议视频软件如何替换旧平台?账号迁移、历史数据与用户培训怎么安排?

账号先映射:身份与权限验证通过,再开放使用。资料分级处理:能查、能读、权限正确,比“全部搬完”更重要。切换可恢复:入口、增量数据和业务通知都要纳入回退方案。培训按岗位落地:让用户完成真实任务,而不是只听功能介绍。这套方法适合政企、集团及医疗等具有长期资料留存、多终端接入和业务集成需求的组织。小规模替换可以简化批次与流程,但不应省略权限验证、备份恢复和关键会议演练。

hz56789的博客 285

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

打字就能剪视频的AI工具

AI 会替代剪辑师吗?这个问题和“AI 会替代程序员吗”一样,问错了方向。会用 AI 工具的人,正在替代不会用的人。一个剪辑师用传统方式花三天做的宣传片,另一个人用 UniCut 一天做完,质量差不多,市场会选谁,答案很明显。工具的进化从来不是把专业的人淘汰掉,而是把专业的门槛拆掉。浏览器已经打开了,剩下的就是你愿不愿意试一下。体验地址:https://unicut.h5ds.com/开源仓库:https://github.com/mtsee/unicut。

d676015863的博客 157

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

音频自动匹配歌词:本地音乐库元数据维护实践

实施顺序建议为:建立主库、统一命名、批量匹配、人工校验、权限分享、定期备份。工具选择上,SMB/WebDAV、Navidrome、Jellyfin 以及轻量文件管理服务各有适用场景,应结合访问方式、权限需求和维护成本评估。把文件组织好、把批量操作控制住、把备份习惯建立起来,歌词补全才能真正提升本地音乐库的可用性,而不是带来新的整理负担。音乐文件不常修改,但歌词、封面、播放列表和目录结构属于人工整理成果,丢失后恢复成本较高。更合理的顺序是:集中存放、统一命名、批量匹配、人工校验、权限管理、定期备份。

zxcvb153的博客 116

视频美颜sdk的API设计会影响开发效率吗?

视频美颜SDK不仅需要具备优秀的图像处理能力,API接口设计同样会影响软件开发效率。本文从接口调用、参数配置、版本兼容、开发文档以及业务扩展等多个角度,分析API设计对视频美颜SDK集成和后期维护的实际影响,为直播APP、视频社交平台等项目的SDK选型与技术开发提供参考。

wanyuekeji的博客 217

视频号数据怎么采?接入方式、字段范围与场景适配

视频号数据采集的技术难点不在“调哪个接口”,而在。官方API服务的是“经营与交易”闭环,返回的是直播记录、订单、售后等结构化实体,但播放完成率、互动明细、评论区内容这些内容分析赖以生存的字段,并不在官方接口的返回Schema里。这意味着任何技术方案的选择,本质上是。

城章科技 301

本地化部署会议视频软件如何开展试点?试用范围、评估指标与推广步骤

试用范围覆盖真实差异,评估指标具有明确口径,推广过程具备放行和回退机制。对于政企、金融、医疗及信创项目,尤其要避免三个误区:把本地部署等同于合规,把演示并发等同于生产容量,把功能清单等同于可运维能力。如果正在准备试点,建议先整理一张“网络—终端—业务—故障”矩阵,再决定试用人数。

hz56789的博客 320

AI 礼盒开箱视频怎么做?让商品亮相更有仪式感

AI商品视频通过精细设计开箱动作与场景节奏,将礼盒从静态包装转化为沉浸式送礼体验。从暖光布景、情感化构图到手部停顿、商品细节特写,每一帧都传递“精致”与“珍视”。以珠宝礼盒为例,俯拍视角下,红色对开门展开如舞台揭幕,银色项链在深蓝夜空衬底中缓缓呈现,掌心承托、缓慢转动,强化视觉记忆。结尾平铺构图,礼盒与商品共存,情绪由期待落至静谧珍藏。全程无文字,靠画面叙事,实现仪式感与品牌调性的深度融合。

yunhhhhh的博客 118

RN鸿蒙空间音频实战

示例仓库:https://atomgit.com/m0_37170006/react-native-ohos-spatial-audio 社区导引:框架源码与版本发布见 https://atomgit.com/CPF-RN/ohos_react_native/tree/0.84-main CPF-RN 鸿蒙社区:https://atomgit.com/CPF-rn。

buhuisuanfa的博客 2万+

通过 AIGC 生成视频何时才能告别“抽卡”!

如果视频的主体内容已经符合要求,只存在错误字幕或局部画面瑕疵时,重新生成不仅增加成本,还可能改变原本满意的部分。针对这类问题,WAND-EraseVibe+ 提供了视频擦除与画面重建能力。根据腾讯云披露的技术方案,该工具采用基于隐空间 Transformer 的生成式修复架构,先将视频画面编码为隐空间特征,在特征层推断并重建需要修复的区域,再解码为视频画面。白模前置、垂直场景调优和局部修复分别作用于不同环节,目的都是减少为了获得可用内容而付出的重复生成成本。

Enweitech Software Works 151

网页视频资源识别与本地化管理:从 HTTP 流媒体技术到完整的视频工作流

现代网页视频技术已经从简单的文件传输发展到分段传输、自适应码率和浏览器端媒体处理。这使视频播放体验不断改善,也让资源识别和本地管理变得更加复杂。对于技术人员而言,理解 HTTP、HLS、MPEG-DASH 和 MSE 的基本工作机制,有助于更准确地分析网页视频的传输过程。对于视频创作者和研究人员而言,建立从内容发现、资源识别到本地整理的完整工作流,可能比单纯寻找一个下载工具更有长期价值。

m0_68263549的博客 428

联犀 Go SIMD 实战:视频转码从 16.5ms 到 5.46ms

联犀Go视频转码实战:在352×288测试流中单帧单核CPU耗时从16.5ms到5.46ms,区分SIMD、代码及编码策略的综合收益。保留测试条件、压测结果与适用边界。

QQ603785348的博客 334

15. 调用ComfyUI生成视频!

在“导演大师”中,我们不仅支持导出分镜导演包并一键导入运行,还为用户提供了极高的自定义自由度。许多创作者希望结合自己精心调试的 MiniMax H3 工作流来生成视频,这当然是完全支持的。通常有两种操作方式:一种是手动复制,将分镜的资产与提示词手动粘贴至本地工作流中;另一种则是更为高效的自动化方案——直接在“导演大师”中调用 ComfyUI 工作流,实现一键生成。本文将重点介绍后者的配置与使用全流程,帮助你打通从分镜脚本到视频直出的自动化链路。

2601_95544990的博客 249
上一篇: 史上最丑AI生图一夜爆火!又一款妙鸭级爆品来了?
下一篇: GPT-4o爆火震惊全球! 清北上交中科大6位华人领衔!
公众号:【GitHub爱好者社区】
博客等级 码龄6年 353粉丝 48原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值