推荐 3 款超好用的Whisper离线AI语音转文字客户端

基于OpenAI的Whisper构建的高效语音识别模型:faster-whisper faster-whisper是基于OpenAI的Whisper模型的高效实现,它利用CTranslate2,一个专为Transformer模型设计的快速推理引擎。这种实现不仅提高了语音识别的速度,还优化了内存使用效率。faster-whisper的核心优势在于其能够在保持原有模型准确度的同时,大幅提升处理速度,这使得它在处理大规模语音数据时更加高效。 阅读详情
AI摘要

文章介绍了OpenAI开源的Whisper语音识别模型及其在33字幕、MemoAI和幕译客户端中的应用。33字幕提供全面的字幕功能,MemoAI适合有笔记需求者,而幕译专注于基础识别,GPU加速需会员。

Whisper 是 OpenAI 开源的一个强大的通用语音识别模型,它使用了超过 68 万小时多语言来训练,支持了 99 种不同语言的转录,够实现高准确性的语音识别,尤其对于英文,识别度接近人类水平。

下面给大家推荐 3 款集成了这个模型的客户端。

33字幕

33字幕是一款非常强大的字幕工具,除了云端识别,它也同时支持Whisper离线模型识别。

它是唯一一个同时集成了 Whisper.CPP 和 FasterWhisper 两种离线识别引擎的客户端,并且还在这个基础上做了许多优化。

比如 Whisper 的时间戳不准确的问题,在33字幕中,通过选用 FasterWhisper,你会发现时间戳会变得准确许多,另外幻觉文本,断句等问题也得到了极大的改善。

除了基础的语音识别能力,33字幕还有完备的字幕编辑、字幕翻译、内容总结、压制字幕、字幕搜索、剪切片段等强大的功能。
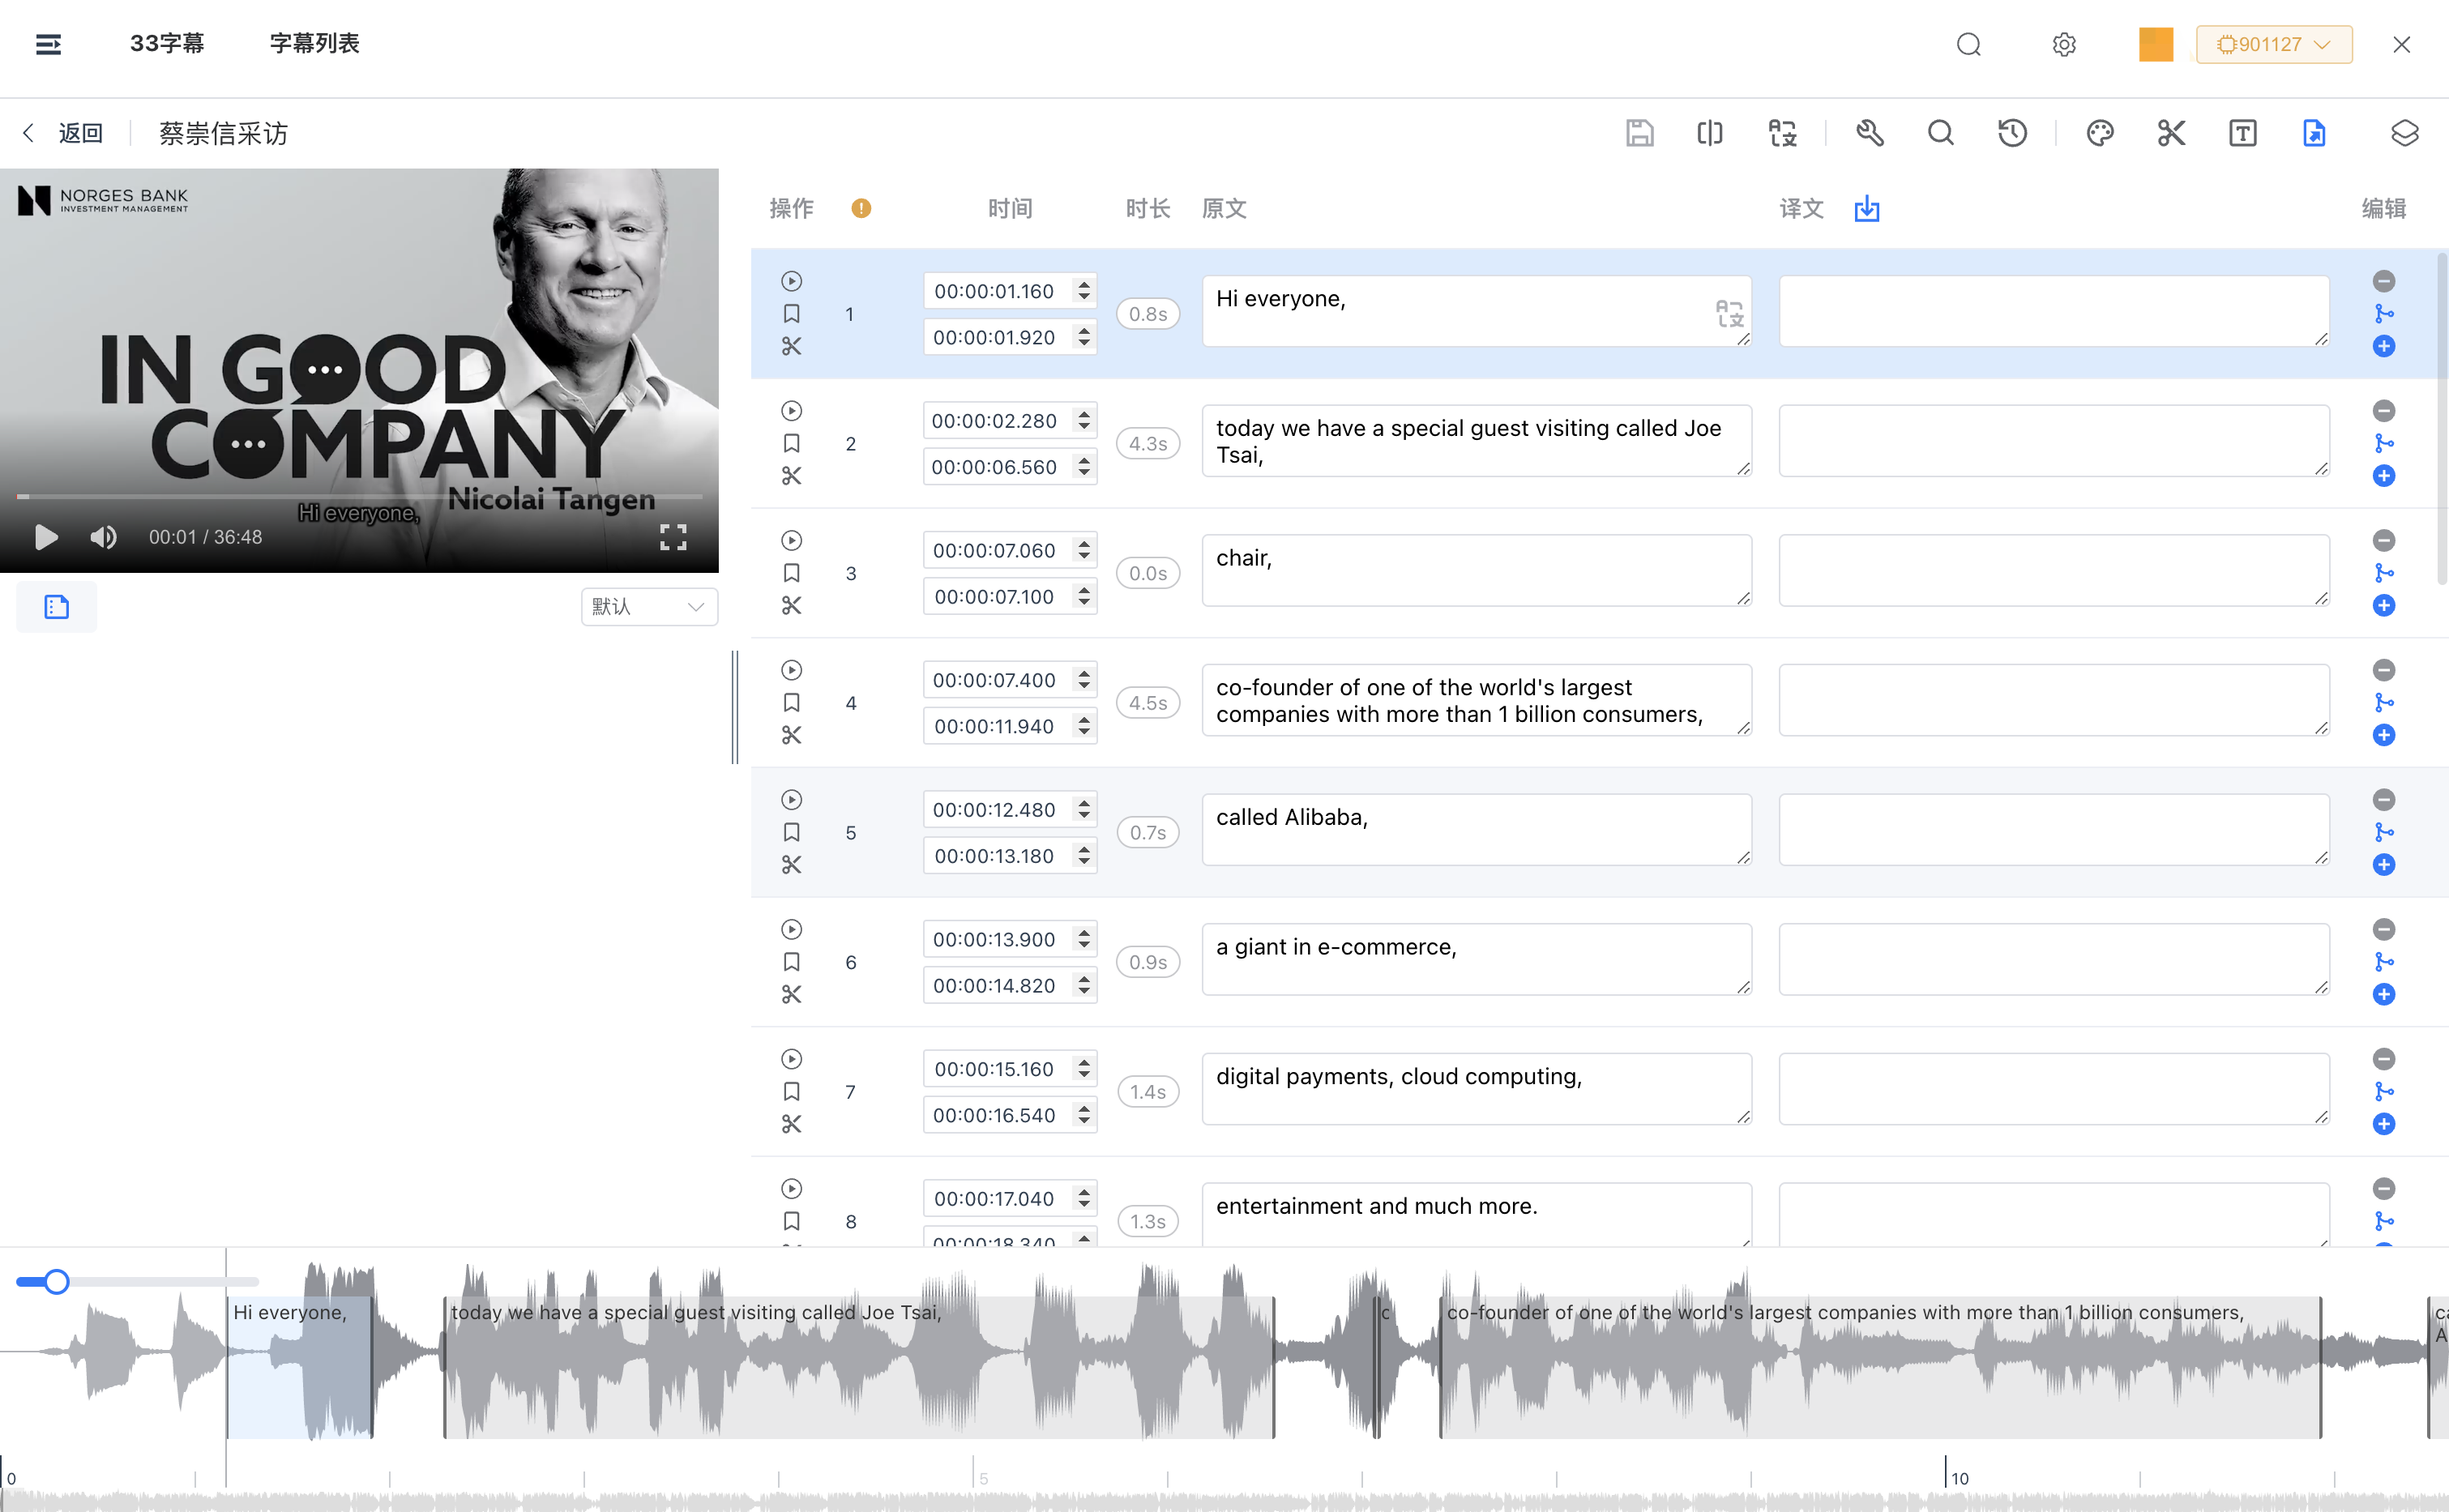
33字幕截图

MemoAI

MemoAI 是一款优秀的离线语音转文字应用,它集成的是 Whisper.CPP 引擎。

它具备有如下的特性:

  1. 可以将 YouTube、播客等视频转录成文字。
  2. 文字翻译:能够将文字翻译成多种语言。
  3. 笔记功能:在音视频播放过程中可以添加笔记和注释。
  4. 支持实时字幕显示,并可进行校准、剪辑和导出。
  5. 利用 ChatGPT 对转译后的内容进行摘要。

MemoAI的体验非常好,不过由于 Whisper.CPP 的时间戳问题有时候会比较严重,所以它也会有这个问题,另外它的GPU加速需要会员才能开启。
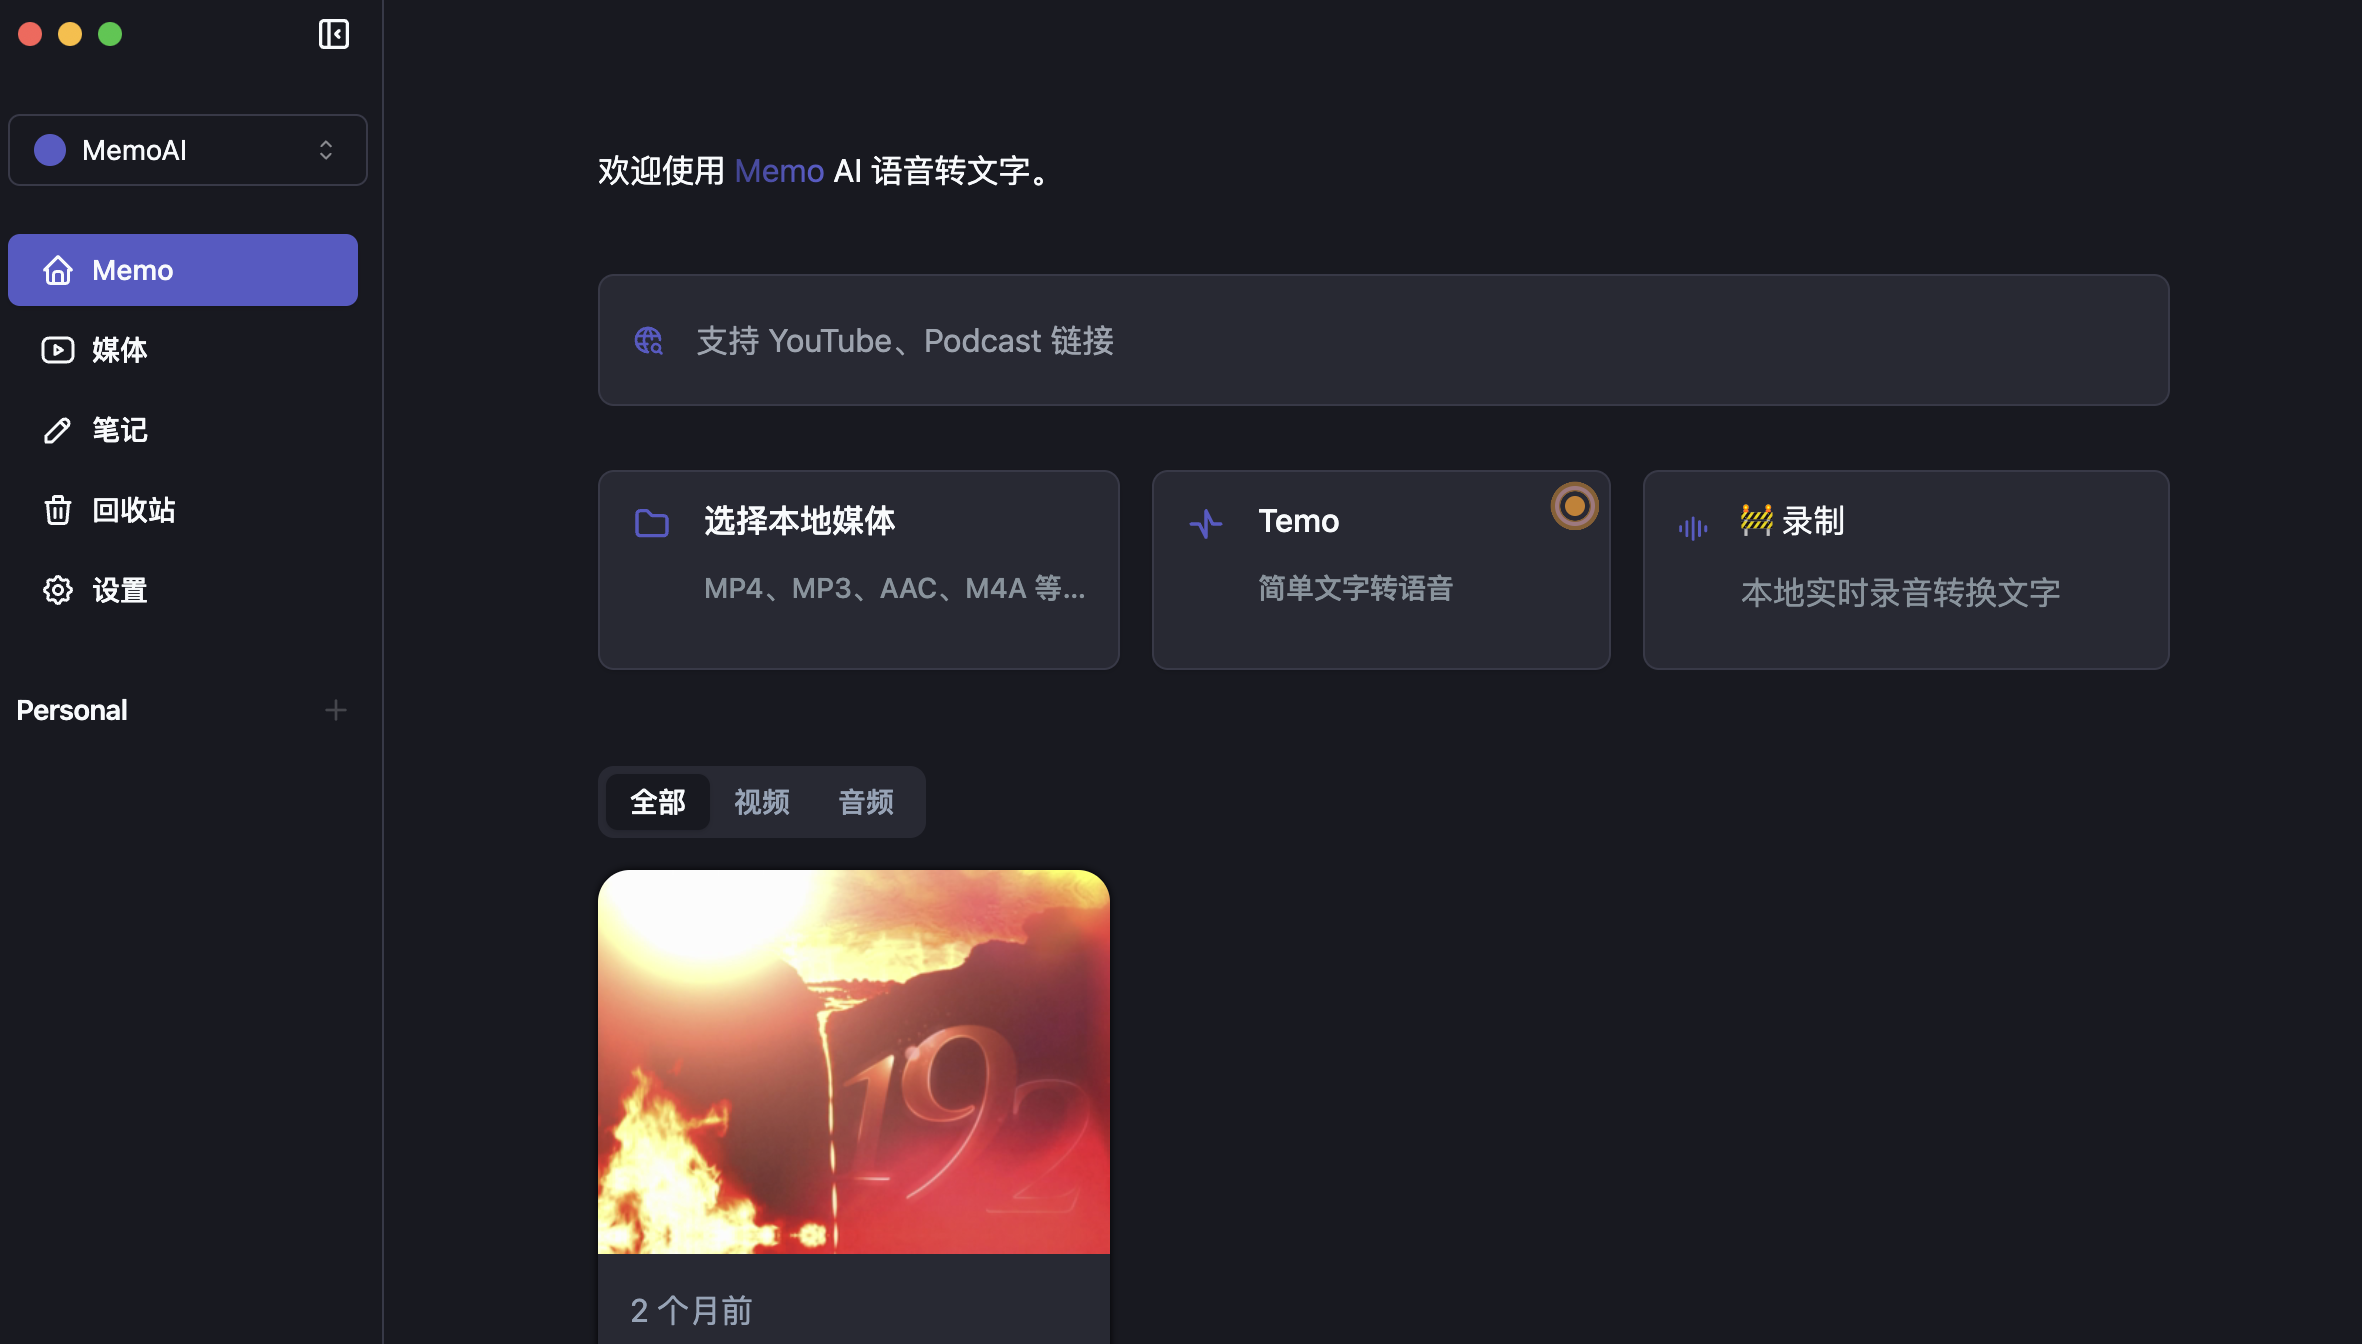
MemoAI 截图

幕译

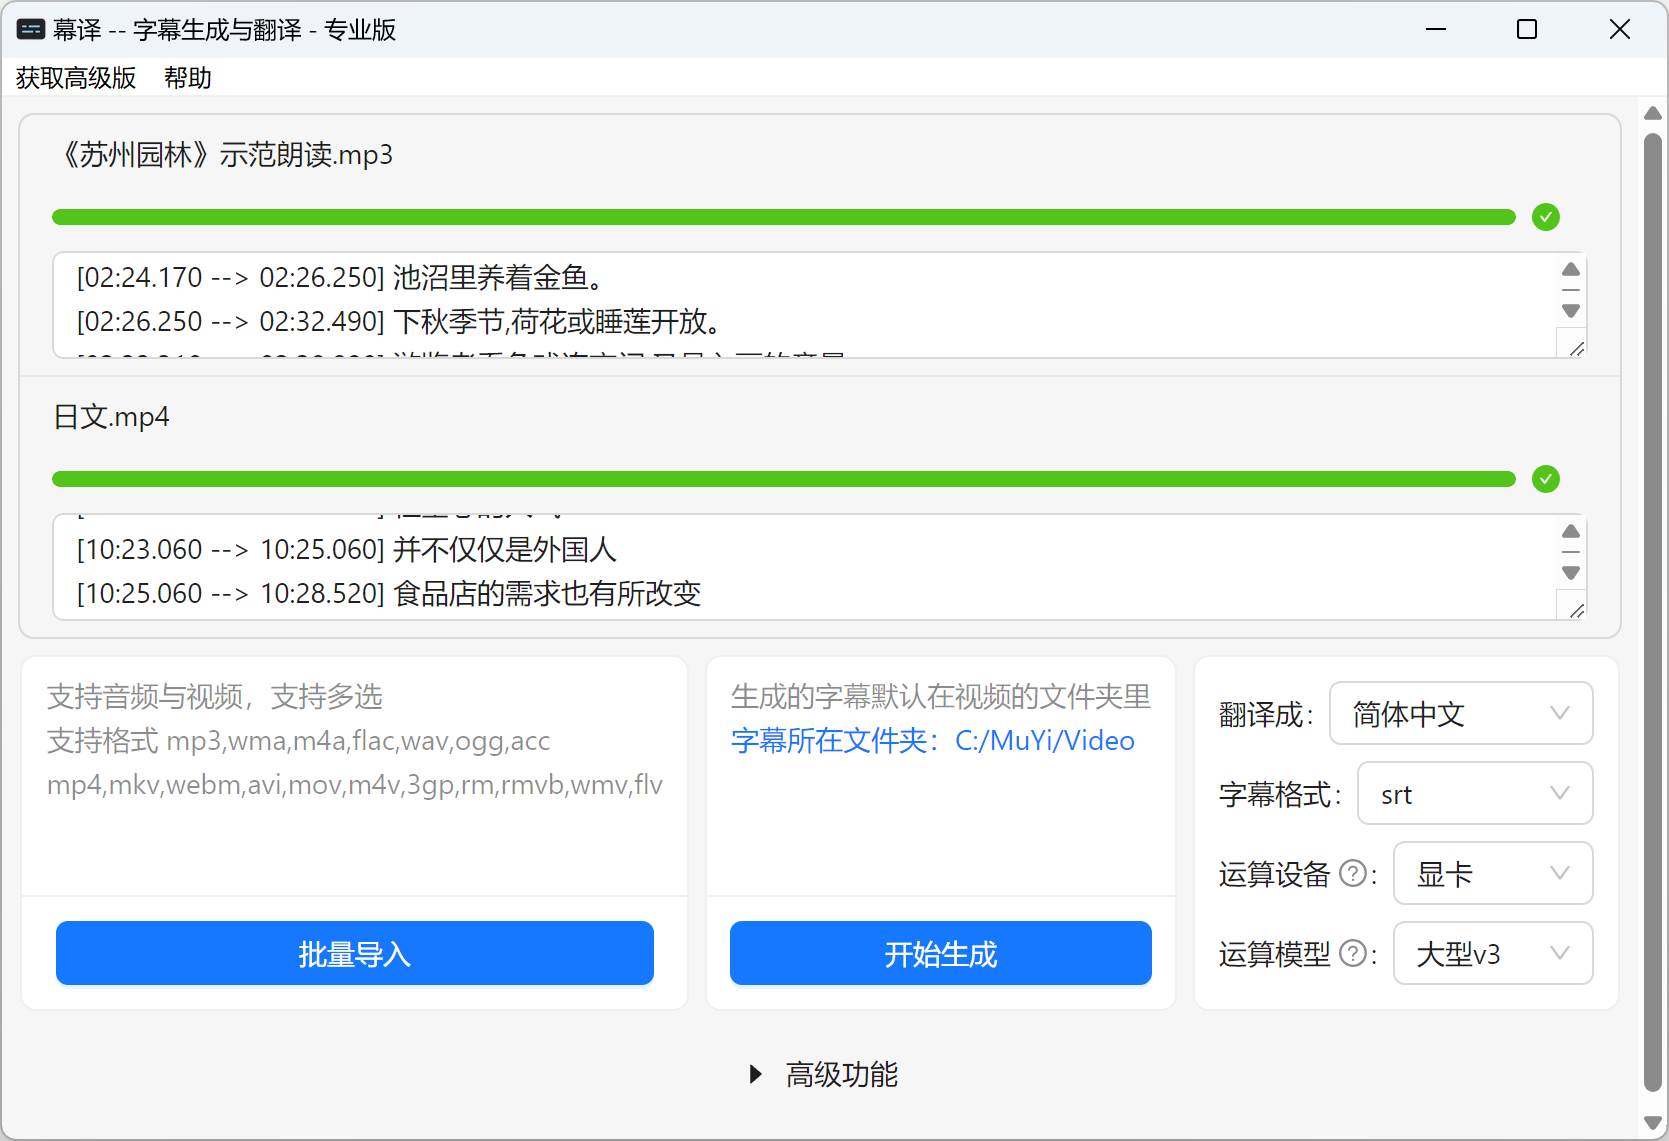
幕译是一款集成了 FasterWhisper 的离线客户端应用,它目前只有基础的语音识别能力,对于后期修正起来可能会比较麻烦。

无论是什么模型,它都有支持GPU加速,但是使用大模型需要会员。
综上所述,如果你是想制作字幕或者单纯把语音转文字,我们首先推荐你试一下33字幕,它的字幕功能是最齐备的。如果你需要一些笔记的功能,那么Memo AI是个不错的选择。

文章出处:推荐 3 款超好用的Whisper离线AI语音转文字客户端

Fastwhisper + Pyannote 实现 ASR + 说话者识别 最近在研究ASR相关的业务,也是调研了不少模型,踩了不少坑,ASR这块,目前中文普通话效果最好的应该是阿里的modelscope上的中文模型了,英文的话,还是非whisper莫属了,而且whisper很变态,粤语效果也还不错,因此,如果实际业务中需要涉及到不同的语言,还是更推荐whisper多一点faster-whisper是使用CTranslate2对OpenAI的Whisper模型的重新实现,CTranslate2是一个用于Transformer模型的快速推理引擎。 阅读详情

相关推荐

java 离线版语音转文字

使用vosk开源项目,基于java实现离线语音转文字 文章目录前言一、VOSK是什么?二、使用步骤1.环境准备2.maven依赖如果导入失败可以下载jar,build path一下;3.语言模型4.运行代码总结 前言 当前主流的语音识别大厂有科大讯飞、百度、谷歌等,但在他们官网中发现,支持java离线版的并不多,科大讯飞离线包仅基于安卓,而百度官方并没有离线版的,所以在资源查找中筛选出VOSK、CMU Sphinx,并且两者都是开源的,但CMU Sphinx官网中并没有中文模型,所以在选用上选择了VO.

qq_43704511的博客 1万+

Faster-Whisper 实时识别电脑语音转文本

以前做的智能对话软件接的Baidu API,想换成本地的,就搭一套Faster-Whisper吧。下面是B站视频实时转写的截图。

SlowFeather's blog 1万+

Unity集成Whisper与本地LLM:打造离线语音交互AI系统

语音识别(STT)与自然语言处理(NLP)是构建智能交互系统的核心技术基础。语音识别通过声学模型和语言模型将音频信号转换为文本,而大语言模型(LLM)则基于Transformer架构理解并生成人类语言。这些技术的结合,使得机器能够实现类人的对话能力,其核心价值在于创造低延迟、高隐私的本地化智能应用。在游戏开发、教育软件、虚拟助手等场景中,本地部署的语音AI可以避免云端服务的网络延迟和数据隐私风险。本文以Unity引擎为客户端,整合开源的Whisper模型进行高精度语音转文本,并利用NobodyWho框架连接

weixin_30301449的博客 444

faster-whisper-webui

whisper开源之后,很多相关的衍生产品也开源了,比如faster-whisper,它是一个比whisper转录更快的技术实现,转录速度是whisper的4倍,并且占用的显存更少,占用显存是whisper的1/2。而我们这次要讲的是faster-whisper-webui是内置了VAD的支持,可以很精准的定位到每一句话的开始和结束,对于转录长音视频很有意义,可以防止转录长音视频出现幻听的情况。

Luke Ewin的博客 1万+

基于faster whisper实时语音识别语音转文本python源码

模块: fast_whisper pyaudio 博客地址:blog.youkuaiyun.com/FL1623863129/article/details/135319194 视频演示:bilibili.com/video/BV1fQ4y1j7wb

利用 vivado实现加减法器的设计

本科计组实验:利用 vivado实现加减法器的设计

qq_52052302的博客 1万+

transformers.js语音识别:Whisper模型在浏览器中的实时语音转文字

还在为语音识别API调用延迟和隐私问题烦恼吗?transformers.js让您直接在浏览器中运行最先进的Whisper语音识别模型,无需服务器,实现真正的端到端实时语音转文字! ## 什么是transformers.js? transformers.js是Hugging Face推出的JavaScript库,将???? Transformers的强大功能带到Web浏览器中。它使用ONNX Run...

gitblog_00906的博客 1165

手把手搭建你的第一个OCT仿真模型:用Python和光学仿真库重现A-SCAN信号

本文详细介绍了如何使用Python和光学仿真库搭建OCT仿真模型,重现A-SCAN信号。从环境配置、干涉仪建模到信号处理全流程,手把手教你实现光学相干层析成像的核心技术。通过代码示例和性能优化技巧,帮助开发者深入理解OCT原理并应用于医疗诊断等领域。

weixin_42562079的博客 240

Handy 离线语音转文字:按住一个键说话,文字自动打进任何输入框

Handy 是一款完全离线、开源的语音转文字桌面应用:按住快捷键说话,松手后文字自动粘贴进你正在用的任何输入框,音频从不出机器。 ## 一|它凭什么 - **音频不出机器**:云端转写服务把录音上传到服务器,Handy 在本地完成识别,语音文件不离开电脑。 - **全局按键即录**:按住即录、松手即停,文字直接出现在光标处,不用来回切窗口。 - **模型引擎可换**:静音由 VAD(语音活动检

gitblog_00910的博客 598

HDFView安装及使用教程

简介:直接用记事本打开hdf5文件的话,是一团乱码。HDFView是用来查看hdf5文件的软件,可以免费使用,好多人都有闪退的情况,这是因为没有添加环境变量。

qq_43722079的博客 7万+

不用买VR设备!用UE5内置模拟器开发虚拟现实项目的完整教程

本文提供了一套无需购买昂贵VR硬件的虚拟现实开发最佳实践方案。详细介绍了如何利用虚幻引擎5内置的XR模拟器,从零开始配置开发环境、模拟操作、构建场景并实现核心交互逻辑。通过这套纯软件方案,开发者可以高效学习VR开发核心,大幅降低入门门槛和成本。

weixin_29019241的博客 612

Conky 快速上手:两分钟在桌面挂起轻量系统监控

先说效果:桌面左上角挂着一块小窗口,实时显示网速、CPU 占用和内存曲线。不占任务栏,几乎不耗资源。这就是 Conky,一个轻量级系统监控工具,支持 X、Wayland 和 macOS,也能把数据输出到控制台、文件或 HTTP 接口。 ## 两分钟跑起来 最快的路径是包管理器,三条命令搞定安装、生成默认配置、启动。 ```bash sudo apt install conky

gitblog_00603的博客 1080

【2024年5月备考新增】《2024高项论文精华版(5)项目工作绩效域和度量绩效域》

3、专注于工作过程和能力。③专注于工作过程和能力。1、制定有效的度量指标。2、度量内容及相应指标。3、展示度量信息和结果。4、管理沟通和参与。7、监督新工作和变更。①制定有效的度量指标。②度量内容及相应指标。③展示度量信息和结果。5、基于度量进行诊断。

Else 的博客 1265

Buzz 本地语音转文字全解:离线转录与批量字幕生成

会议录音、采访素材、播客节目,在线转录服务意味着音频要先上传到别人的服务器。Buzz 是一款本地语音转文字工具,基于 OpenAI 的 Whisper 模型(一种语音识别模型),在你自己的电脑上完成离线转录与翻译,数据不出本机。 ## 📌 项目速览 Buzz 是跨平台的音频转录客户端,支持 Windows、macOS、Linux 三大系统。它把音频、视频文件甚至 YouTube 链接转成带时

gitblog_00058的博客 285

DeepSeek+即梦:AI视频创作从0到1全突破

本文为 DeepSeek 与即梦生成视频全攻略,从前期注册登录、熟悉工具界面及硬件网络准备入手,助读者开启 AI 视频创作。详细阐述利用 DeepSeek 构思脚本、即梦实现画面生成与静态图转动态视频的方法,包括提示词编写、参数调整等技巧。同时介绍后期合成音画、添加字幕特效及多平台适配要点,结合实战案例解析全流程。还分享进阶提示词优化、版权注意等避坑指南,为创作者提供从 0 到 1 的 AI 视频创作完整解决方案。

邓邓子的博客 8100

Transformer大模型实战 文本摘要任务

Transformer, 文本摘要, 自然语言处理, 预训练模型, 序列到序列, BERT, BART, T5 1. 背景介绍 文本摘要任务是自然语言处理 (NLP) 领域的重要研究方向之一,旨在从长篇文本中提取关键信息,生成简洁、准确的摘要。随着深度学习技术的快速发展,基于 Tra

AI大模型应用之禅 1339

Buzz 离线语音转文字完整指南:免费安装、模型选型与提速 6 问

Buzz 是一款免费、开源的本地语音识别工具,基于 OpenAI 的 Whisper 模型,在你自己的电脑上离线完成音频转录和翻译——录音不上传任何服务器,转完即得带时间戳的文字稿。下文按"先做决策、再动手操作"的顺序,把安装、选型、调优和排错一次讲清。 ## 先回答三个问题:该不该用 Buzz 动手之前,用三个判断帮你确认它是否合适: - **内容敏感吗?** 会议报价、客户访谈、个人隐私

gitblog_00391的博客 247

第10章《VTK自定义部件Widget》

是用于交互式操作 3D 场景的组件,例如移动对象、调整尺寸、创建标注等。VTK 提供了一些内置的 Widget,如。,用户可以点击鼠标,在 3D 场景中放置一个点。负责绘制一个点,并控制其颜色、大小等。,可用于 3D 标注、对象拾取等应用!等,但在某些应用中,我们需要。这样,我们就创建了一个。

yumeiguo的博客 523

用 Electron 从零构建跨平台语音转文字桌面应用:云端 Whisper API 与本地 whisper.cpp 双模式实战

> 本指南是 easy-vibe 项目跨平台桌面开发章节的核心实战课,带你用 HTML + CSS + JavaScript 一套 Web 技术栈,通过 Electron 打造一款真正可安装、可运行于 Windows / macOS / Linux 的语音转文字(Speech-to-Text)桌面应用。文章完整覆盖 Electron 进程模型与 IPC 通信、麦克风录音实现、权限处理、OpenAI

gitblog_00583的博客 211

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

AI系列【仅供参考】:【AI工具篇】使用OpenAI开源的Whisper模型,制作本地离线的视频或音频转文本功能...

【AI工具篇】使用OpenAI开源的Whisper模型,制作本地离线的视频或音频转文本功能...

weixin_54626591的博客 1301

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

EmotiVoice 上手:免费开源的多情感语音合成,5 分钟跑出第一条音频

凌晨改完稿子,视频还差一条旁白。自己念?声音状态不对。找商业 TTS?按量计费,音色还挑不出几个满意的。EmotiVoice(易魔声)就是为这种场景准备的:网易有道开源的文本转语音引擎,完全免费,支持中英文双语,内置 2014 个音色,还能用一句自然语言描述(比如"哭唧唧")控制情感的语音合成。 ## 它凭什么值得试 - **2000+ 音色随便挑**:[speaker2](https://l

gitblog_00407的博客 238

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

3步解决Buzz语音转文字Faster Whisper模型下载难题:终极实操指南

在Windows 10系统上使用Buzz语音转文字工具时,很多用户遇到了一个令人困惑的问题:普通Whisper模型可以正常下载,但Faster Whisper模型却总是失败,错误提示"SSL证书验证失败"。这个Faster Whisper下载问题不仅影响了AI模型的获取效率,也让用户无法享受更快的转录速度。本文将为你提供完整的解决方案,让你轻松解决Buzz模型下载障碍,享受高效的语音转文字体验。

gitblog_00917的博客 231

自托管语音转文字AI助手实战:从核心概念到部署

语音识别(ASR)是人工智能领域的基础技术,它将音频信号转化为可处理的文本,是语音助手、会议记录、智能家居等应用的核心环节。传统云STT虽然接入简单,但存在数据隐私和定制性不足的问题。自托管语音识别技术应运而生,它允许用户将语音转文字服务部署在本地服务器,完全掌控音频数据,并通过模块化架构灵活集成AI助手。本文以S.A.T.U.R.D.A.Y项目为例,系统阐述自托管语音识别在AI助手场景中的工程实践。内容涵盖STT、自托管与AI助手的区别与联系,基于faster-whisper等开源引擎的推理原理,以及从麦

weixin_33834075的博客 346

如何选择合适的引擎?Vocalinux 6大语音引擎选型指南:whisper.cpp、Whisper、VOSK一文讲清

Vocalinux 是一款免费、开源、100% 离线运行的 Linux 语音听写工具,内置 whisper.cpp、Whisper、Faster Whisper、Vosk、Parakeet 和 Remote API 共 **6 大语音识别引擎**,支持 GPU 加速,同时兼容 X11 与 Wayland。选对引擎,你的听写体验会截然不同——本文将用一张对比表加一份"按需求选引擎"清单,帮你 3 分

gitblog_00853的博客 1001

OpenWhispr语音转文字听写应用:本地模型隐私优先

OpenWhispr语音转文字应用封面:现代桌面工作场景,笔记本电脑屏幕音频波形转化为文字,麦克风图标与波形连接,本地语音转文字主题,蓝紫渐变科技风格 语音转文字(Speech-to-Text, STT)是人工智能最成熟的落地应用之一,从手机输入法到会议纪要、从字幕生成到语音助手,语音转文字已经深度嵌入我们的工作和生活。然而,主流语音转文字工具大多依赖云端处理——音频上传到云端服务器,经过大模型识别后返回文字。这种模式虽然方便,却存在三个绕不开的痛点:隐私泄露风险(敏感对话、商业机密、医疗信息的音频被上传

巽视达的专栏 616

Owl 语音转文字全解析:Whisper、PyAnnote 说话人分离与字级对齐完整指南

Owl 是一个**完全在本地运行的个人可穿戴 AI** 项目:它持续采集穿戴设备上的语音,通过 **Whisper 语音识别**模型把音频转成文字,再用 **PyAnnote 说话人分离**区分"谁在说",并借助**字级对齐**为每个词打上精确时间戳。这篇文章带你完整看懂 Owl 语音转文字(Speech-to-Text)流水线的四大核心环节——流式实时转写、离线高质量转录、说话人分离与字级对齐,

gitblog_00176的博客 301
上一篇: 33字幕: 快速制作双语字幕,识别外语更准确
下一篇: 33字幕:免费给视频加字幕,把语音转文字
33黑板报
博客等级 码龄9年 29粉丝 12原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值