Word Embedding

自然语言处理(词向量——Word Embedding)总结 词向量(Word embedding),又叫Word嵌入式自然语言处理(NLP)中的一组语言建模和特征学习技术的统称,其中来自词汇表的单词或短语被映射到实数的向量。从概念上讲,它涉及从每个单词一维的空间到具有更低维度的连续向量空间的数学嵌入。在自然语言处理任务中,首先需要考虑词如何在计算机中表示。通常,有两种表示方式:one-hot representation和distribution representation。 阅读详情

如何表示词义

  • 流程

    文本文件->分词后的序列->词表示的向量(词嵌入)->解决具体任务的算法;

用离散符号表示词

传统NLP中,我们将词表示为一个个的离散符号,如:sun、hotel、fruit……,我们可以用one−hotone-hotone−hot方式将词代表为向量形式,如:

sun=[0,1,0,0,0,0,0,0,0,0]sun=[0,1,0,0,0,0,0,0,0,0]sun=[0,1,0,0,0,0,0,0,0,0]

hotel=[0,0,0,0,1,0,0,0,0,0]hotel=[0,0,0,0,1,0,0,0,0,0]hotel=[0,0,0,0,1,0,0,0,0,0]

此时存在问题:

  1. 向量之间无相似性,各个词用one−hotone-hotone−hot方式表示时,不同词之间都是正交的,不含有近似单词的信息;
  2. 向量维度过高,利用one−hotone-hotone−hot方式表示词向量时,向量维度等于词表中的词数,当词数量过多时,这个方法所带来的维度过高问题就会凸显出来;

分布式语义

  • 分布表示的思路

    语料->对共现词计数->将计数后的数据转换为向量 ->通过一系列降维方法,将高维转换为低维

  • LSA(潜在语义分析)

  • Word Embedding(词嵌入)

    通过给每个单词学习一个密集向量,类似于出现在相似上下文中的单词向量,这样的词向量就叫做word embedding或者word representations;

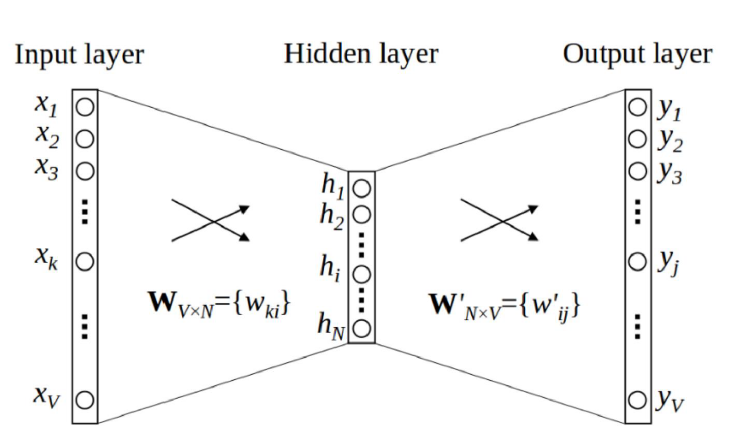
  • 模型结构图

word embedding

  • 算法基本思想

    输入层通过将大规模语料中的每个单词表示为一个密集向量,其中每个单词都是通过向量来表示,对文本进行遍历,每个位置都有一个中心词ccc和语境词表示ooo,通过利用ccc和ooo词向量之间的相似度,从而在给定ccc,计算出ooo的概率(或给定ooo,计算出ccc的概率),还需要通过调节词向量来最大化概率;

  • 具体例子

具体例子

在给定第ttt个位置中心词bankingbankingbanking的情况下,当窗口大小设为222时,通过给定p(wt)p(w_t)p(wt​)来计算左右窗口大小为222的词的条件概率;

  • 相似度

    对于每个位置t=1,2,……,Tt=1,2,……,Tt=1,2,……,T,当预测固定窗口大小为mmm的上文问关联词时,给出中心词为wtw_twt​,则相似度为:

L(θ)=∏t=1T∏−m<=j<=m,j≠0P(wt+j∣wt;θ),其中θ是所有需要优化的变量L(\theta)=\prod ^T_{t=1} \prod _{-m<=j<=m,j\not=0} P(w_{t+j}|w_t;\theta),其中\theta是所有需要优化的变量L(θ)=t=1∏T​−m<=j<=m,j​=0∏​P(wt+j​∣wt​;θ),其中θ是所有需要优化的变量

  • 目标函数(损失/代价函数)

J(θ)=−1TlogL(θ)=−1T∑t=1T∑−m<=j<=m,j≠0logP(wt+j∣wt;θ)J(\theta)=-\frac{1}{T}logL(\theta)=-\frac{1}{T}\sum^T_{t=1}\sum_{-m<=j<=m,j\not=0}logP(w_{t+j}|w_t;\theta)J(θ)=−T1​logL(θ)=−T1​t=1∑T​−m<=j<=m,j​=0∑​logP(wt+j​∣wt​;θ)

即目标函数为负的相似度函数对数的平均值,通过最小化目标函数,从而将预测的准确率最大化;

  • 预测函数

    如何最小化目标函数呢?我们可以通过对预测函数的的处理来解决这一问题。对于预测函数P(wt+j∣wj,θ)P(w_{t+j}|w_j,\theta)P(wt+j​∣wj​,θ),可以通过用词www的两个向量来解决。我们假设VwV_wVw​是中心词,UwU_wUw​是语境词。则对于中心词ccc和语境词ooo而言,存在如下关系:

P(o∣c)=exp(uoTvc)∑w∈Vexp(uwTvc)P(o|c)=\frac{exp(u^T_ov_c)}{\sum_{w\in V}exp(u^T_wv_c)}P(o∣c)=∑w∈V​exp(uwT​vc​)exp(uoT​vc​)​

其中,分子中ooo和vvv的点积uoTvCu^T_o v_CuoT​vC​越大,则最后得到的概率P(o∣v)P(o|v)P(o∣v)越大。而分母则通过指数函数计算之后,从而实现了对整个词表的标准化;

  • 实例

其中P(uproblems∣vinto)P(u_{problems}|v_{into})P(uproblems​∣vinto​)为P(problems∣into;uproblems,vinto,θ)P(problems|into;u_{problems},v_{into},\theta)P(problems∣into;uproblems​,vinto​,θ)的简写形式;

  • SoftmaxSoftmaxSoftmax回归

softmax(x)i=exp(xi)∑j=1nexp(xj)=pisoftmax(x)_i = \frac{exp(x_i)}{\sum^n_{j=1}exp(x_j)}=p_isoftmax(x)i​=∑j=1n​exp(xj​)exp(xi​)​=pi​

softmaxsoftmaxsoftmax又称为多项逻辑回归(multinomiallogisticregressionmultinomial logistic regressionmultinomiallogisticregression),多用于分类过程,它通过将多个神经元的输出,映射到(0,1)(0,1)(0,1)区间。它通过将任意值xix_ixi​映射到一个概率分布pip_ipi​上,"maxmaxmax“是因为它会将输入中最大的值的概率进一步放大,而”softsoftsoft"则是因为对于输入中极小的值,它也人然后分配一些概率,而不是直接丢弃。因此,softmaxsoftmaxsoftmax函数常常用在深度学习中;

word2vec中将文本进行向量表示的方法

  • CBOW(ContinuousBagofWords)CBOW(Continuous Bag of Words)CBOW(ContinuousBagofWords)

CBOW模型结构图

给定上下文中的词,然后预测中心词。从而利用中心词的预测结果情况,利用梯度下降方法不断调整上下文词的向量。训练完成后,每个词都作为中心词遍历了一遍,将上下文中的词向量进行调整,从而获取整个文本中所有词的向量;

  • SG(Skip−Gram)SG(Skip-Gram)SG(Skip−Gram)

SG模型结构图

给定中心词,然后预测上下文中的词。从而利用上下文中的词的预测结果情况,利用梯度下降法不断调整中心词的词向量,最后文本遍历完一遍之后,就得到了所有词的词向量;

  • CBOWCBOWCBOW和SGSGSG的比较

    两者均为三层神经网络(输入层、投影层和输出层)。SGSGSG中,每个词作为中心词时,是一对多的情况,多个上下文中的词对一个中心词进行“训练”,然后得出较准确地中心词的向量结果,这样最终的效果更好。CBOWCBOWCBOW中,是多对一的情况,多个上下文中的词从一个中心词处进行“学习”,这样效率更高,速度快,但是最终效果却不如SGSGSG。此外,在SGSGSG中,每个词都会受上下文词的影响,每个词作为中心词时,需要进行KKK次训练(KKK为窗口大小),所以经过多次调整将使得词向量相对更准确。CBOWCBOWCBOW预测词数和整个文本中词数几乎相等,每次预测才会进行一次反向传播。

模型优化的方法

  • 分层SoftmaxSoftmaxSoftmax

用于分层softmax的二叉树示例

用于计算softmaxsoftmaxsoftmax的方法,用二叉树(根据类标频数构造的霍夫曼树)来表示词汇表中的所有单词。如上图,其中,白色节点表示词汇表中的所有单词,而黑色节点则表示隐节点。其中VVV个单词存储于二叉树的叶子节点单元,而对于每个叶子节点,都有一条唯一的路径可以从根节点达到该叶子节点,这条路径用于计算该叶子节点所代表的单词的概率。在这个模型中,不存在单词的输出向量,而是V−1V-1V−1个隐节点中都有一个输出向量vn(w,j)‘v ^`_{n(w,j)}vn(w,j)‘​,单词作为输出词的概率被定义为:

p(w=wO)=∏j=1L(w)−1σ([[n(w,j+1)=ch(n(w,j))]].vn(w,j)‘Th)p(w=w_O)=\prod ^{L(w)-1}_{j=1}\sigma([[n(w,j+1)=ch(n(w,j))]].{v^`_{n(w,j)}}^Th)p(w=wO​)=j=1∏L(w)−1​σ([[n(w,j+1)=ch(n(w,j))]].vn(w,j)‘​Th)

其中,ch(n)ch(n)ch(n)是节点nnn的左侧子节点,vn(w,j)‘v^`_{n(w,j)}vn(w,j)‘​是隐节点n(w,j)n(w,j)n(w,j)的向量表示(即“输出向量”)。而hhh则是隐藏层的输出值(SG模型中,h=vwih=v_{wi}h=vwi​;CBOW模型中,h=1C∑c=1Cvwch=\frac{1}{C}\sum_{c=1}^C v_{w_c}h=C1​∑c=1C​vwc​​),[[x]][[x]][[x]]则为一个特殊函数,其定义如下:

[[x]]={1  ,if x is true−1 , others[[x]]=\begin{cases}1\ \ ,if\ x\ is\ true\\-1\ ,\ others\end{cases}[[x]]={1  ,if x is true−1 , others​

  • 负采样技术

    为解决数量过于庞大的输出向量的更新问题,于是在更新时不更新所有向量,而只更新他们的一个样本。正样本应该出现在我们的样本中,此外也需要加入几个单词作为负样本。而在采样的过程中,我们需要任意指定一个总体的概率分布,这个分布就叫做噪声分布,标记为Pn(w)P_n(w)Pn​(w)。在word2vecword2vecword2vec中,作者用一个定义好的后多项分布的负采样形式取代简化的训练目标,从而产生高质量的嵌入:

E=−logσ(vwO‘Th)−∑wj∈Wneglogσ(−vwj‘Th)E=-log\sigma({v^`_{w_O}}^Th)-\sum_{w_j\in W_{neg}}log\sigma(-{v^`_{w_j}}^Th)E=−logσ(vwO​‘​Th)−wj​∈Wneg​∑​logσ(−vwj​‘​Th)

其中,wOw_OwO​是正样本(即输出单词),vwO‘v^`_{w_O}vwO​‘​是词向量。而hhh则是隐藏层的输出值(SG模型中,h=vwih=v_{wi}h=vwi​;CBOW模型中,h=1C∑c=1Cvwch=\frac{1}{C}\sum_{c=1}^C v_{w_c}h=C1​∑c=1C​vwc​​)。Wneg={wj∣j=1,…,K}W_{neg}=\{w_j|j=1,…,K\}Wneg​={wj​∣j=1,…,K}是从Pn(w)P_n(w)Pn​(w)中采样得到的单词集合,即负样本。

GloveGloveGlove

  • 定义

    基于计数和直接预测的方法;

  • 目标函数

J(θ)=12∑i,j=1Wf(Pij)(uiTvj−logPij)2J(\theta)=\frac{1}{2}\sum^W_{i,j=1}f(P_{ij})(u^T_iv_j-logP_{ij})^2J(θ)=21​i,j=1∑W​f(Pij​)(uiT​vj​−logPij​)2

Xfinal=U+VX_{final}=U+VXfinal​=U+V

其中,PijP_{ij}Pij​是单词jjj出现在单词iii上下文中的概率,而f(Pij)f(P_{ij})f(Pij​)则是为了去除噪声而设定的函数。

如何评价EmbeddingEmbeddingEmbedding

  • 内在方式:对特定/中间子任务的评估;

  • 外在方式:应用到具体任务中;

fastTextfastTextfastText分类

在文本分类任务中,fastTextfastTextfastText作为一种浅层网络,能取得媲美于深度网络的精度,但是训练时间却比深度网络快许多数量级。一般情况下,用fastTextfastTextfastText进行文本分类的同时也会产生词的embeddingembeddingembedding;

  • 字符级的n−gramn-gramn−gram

    word2vecword2vecword2vec中以词作为原子,为每个词生成一个向量,而忽略词内部形态特征。面对这一问题,fastTextfastTextfastText采用字符级的n−gramn-gramn−gram来表示一个单词。通过这样处理则有两个优点;

  1. 对于低频词,生成的词向量效果更好,其n−gramn-gramn−gram可以与其他词共享;
  2. 对于训练词库外的词,仍然可以构建其词向量,可通过叠加其字符级n−gramn-gramn−gram从而生成向量;
  • 模型架构

fastText模型架构图

类似于word2vecword2vecword2vec中的CBOWCBOWCBOW模型,只有输入层、隐藏层、输出层三层。其中,输入为多个单词表示成的向量,输出是一个特定的targettargettarget,隐藏层是对多个词向量的叠加平均。不同的是,CBOWCBOWCBOW的输入是目标词上下文中的词,而fastTextfastTextfastText的输入则是多个单词及其n−gramn-gramn−gram特征。这些特征用于表示单个文档,CBOWCBOWCBOW中输入词的是经过one−hotone-hotone−hot编码过的,输出为目标词;而fastTextfastTextfastText中输入特征则是经embeddingembeddingembedding过的特征,输出是各个文档对应的类标,且采用分层softmaxsoftmaxsoftmax优化措施,大大加快了训练速度;

  • 核心思想

    将整篇文档的词及n−gramn-gramn−gram向量叠加平均,从而得到文档向量,然后利用文档向量做多层softmaxsoftmaxsoftmax多分类,主要涉及到n−gramn-gramn−gram特征的引入以及分层SoftmaxSoftmaxSoftmax分类技术;

  • fastTextfastTextfastText样例

    • 主要步骤

      1. 添加输入层(即embeddingembeddingembedding层);
      2. 添加隐藏层(即投影层);
      3. 添加输出层(即softmaxsoftmaxsoftmax层);
      4. 指定损失函数、优化器类型、评价指标、编译模型;
文本处理——Embedding、Word embedding、Word2vec 之说 这篇主要就是想让大家了解下 Embedding、word embedding、word2vec的一些相关知识。 Embedding在数学上表示一个单射的、结构保持的映射 f: X -> Y, 也就是一个function,此处的结构保持的具体含义要依赖于X 和 Y 是哪种数学结构的实例而定。 举个例子:我们可以把整数“嵌入”进有理数之中。显然,整数是一个group,同时它又是有理数的一个subgroup。整数集合中的每个整数,在有理数集合中都能找到一个唯一的对应(其实就是它本身)。同时,整数集合中的每个整数 阅读详情

相关推荐

深度学习之词向量Word Embedding总结

目录 一、Word Embedding介绍 二、One-Hot表示 三、Distributed 表示 四、word2vec表示 五、BERT任务 六、BERT与其他模型的调用 一、Word Embedding介绍 word embedding,又名词嵌入、词向量,在近几年的NLP领域变得越来越热,从概念上讲,它涉及从每个单词一维的空间到具有更低维度的连续向量空...

Ivan.J的博客 3061

(全)Word Embedding

原文链接:https://blog.youkuaiyun.com/L_R_H000/article/details/81320286 最近做完UNIT一个小项目后,结合同时期看KBQA的文章,对NLP/NLU方向产生了比较大的兴趣,想深入学习一下,结合一篇综述Recent Trends in Deep Learning Based Natural Language Processing(参考文献[5]为其阅读笔记)的阐述顺序,

qq_43703185的博客 4058

Word Embedding (NLP)简述

最近一直在调研文本摘要,主题,图像标注和视频摘要方面的基础和相关论文,所以mark一下,积累知识的同时,也便于日后进行分析和总结,毕竟不是搞这个的,有点跨方向了,不过好歹也是机器学习。 我觉得我可以把博客写的系统点,但是我做不到,因为现在脑子里的知识体系不完备。。。所以往后的几篇都会以知识点的形式,一点一点逐一展开 1.Word Embedding Word Embedding:词嵌入。最简

joshuaxx316的专栏 1万+

word embedding是什么,word embedding之前需要做什么?

我们知道自然语言处理是让机器能够看懂并理解人类所说的语言,能够像人类一样进行交互,和人对话。从自然语言的角度看,NLP可以大致分为自然语言处理和自然语言生成这两部分,就是理解文本和文本生成。具体应用领域几乎覆盖日常生活,如提取文章摘要,文本情感分析,淘宝京东上机器人客服的智能问答,实体命名识别,知识图谱,信息检索等等。又比如说现在已经有方言的语音转文字技术。那具体实现起来该怎么样呢?我们总不能直接把一堆文字或者一段英文直接倒给计算机,计算机只能处理数字,那么我们就得把词给转换成可以供计算机计算的数。

weixin_44535934的博客 3870

使用Word Embedding构造简洁有效的文本摘要系统

本文介绍了使用Word Embedding进行摘要提取的一种非常简洁的方法。

张俊林的博客 3万+

tensorflow学习:使用tensorflow实现word embedding

今天学习使用tensorflow实现word embedding,下面的例子来自于tensorflow的官方文档,实现word embedding本身是比较复杂的,下文只用比较简单的方法实现,限于本人刚入门,水平有限,有些细节还没有彻底搞明白,还需要再花些时间研究,现把今天的研究成果记下供日后继续完善。 文本参考:https://liusida.github.io/2016/11/14/stud

qoopqpqp的博客 6966

深度学习(六) Word Embedding

本文是李宏毅老师的关于词汇编码方面的总结

AliForever2020的博客 8671

主流双目相机技术参数横向评测:从ZED到国产新锐

本文对主流双目相机技术参数进行了横向评测,涵盖ZED、Bumblebee等国际品牌及国产新锐产品。详细分析了分辨率、帧率、视场角等关键参数,并针对机器人导航、AR/VR交互、工业检测等场景提供选型建议。特别推荐ZED相机在科研领域的成熟应用,以及国产方案在长基线设计和主动双目技术上的创新突破。

weixin_33670786的博客 318

NLP-词向量(Word Embedding):Embedding(Tranform Object To Vector)【对象向量化;Embedding的本质是以one-hot为输入的单层全连接层】

- 近年来,NLP自然语言处理、推荐系统,以及计算机视觉已成为目前工业界算法岗的主流方向,无论在哪个领域,对“Embedding”这个词概念的理解都是每个庞大知识体系的基石。 - “Embedding”直译是嵌入式、嵌入层。它能把万物嵌入万物,是沟通两个世界的桥梁! - 用数学的话来说:“它是单射且同构的” - 地图就是对于现实地理的Embedding,现实的地理地形的信息其实远远超过三维,但是地图通过颜色和等高线等来最大化表现现实的地理信息。 - 通过Embedding,我们在现实世界里的文字、图片、语言

u013250861的博客 3077

别再死记硬背公式了!用Multisim仿真软件,5分钟搞懂三极管放大电路的工作原理

本文介绍如何利用Multisim仿真软件快速掌握三极管放大电路的工作原理,避免死记硬背公式。通过动态实验和参数调整,直观理解三极管的工作状态和放大效果,提升学习效率和实践能力。

weixin_30566063的博客 569

常见消息队列:ActiveMQ、RabbitMQ、RocketMQ、Kafka的区别总结

常见消息队列:ActiveMQ、RabbitMQ、RocketMQ、Kafka的区别。

qq_30713721的博客 3472

word embedding_Word Embedding中Embedding的含义

本文完全是复制与知乎中的一个问答,因为该作者的确写的很好,所以就直接复制过来了。(本人也只是初级入门小白,感觉重新理解了写也不会比这个作者写的好,所以选择直接复制)。有谁可以解释下word embedding?最近在学nlp然后看到这个词了wiki的英文解释没太理解,求中文的解释。。题主问的是embedding的含义,楼上几位的回答都是拿word embedding说了一通,也没解释出embedd...

weixin_39888412的博客 97

51单片机超声波测距数码管显示并报警(Proteus 仿真)

HC-SR04超声波 实物图 使用方法 1、给TRIG端口至少10us 的高电平信号 2、模块自动发送 8 个 40khz 的方波,自动检测是否有信号返回 3、有信号返回,ECHO端口会输出一个高电平,高电平持续的时间就是超声波从发射到返回的时间 计算的话这里就不考虑温度的影响直接用声速340m/s Proteus仿真 HC-SR04可以用Proteus中的SRF04代替 下面附上代码 ...

m0_46254883的博客 1万+

Word embedding

Word embedding 视频链接 Word embedding:词向量 dimension reduction:维数缩减 Word embedding 其实是 dimension reduction一个非常好、非常广为人知的应用。 如果我们今天要你用一个vector 来表示一个Word,你会怎么做呢? 最经典的做法叫做 1-of-N encoding 每个word 对应的vector都不一样,但是从这个vector里面,你没有办法得到任何咨询。 比如说 cat 和 dog 都是动物这件事。 那怎么办

与或 548

UE5入门第二周总结:基于蓝图的国际象棋的实现

在C++的学习中,这是一个入门级别的项目。我们的目标是灵活运用蓝图的特性和强大的可视化功能,做出这一入门级项目的同时,思考如何优化并改进算法,并尽可能的用面向对象的方法实现,用蓝图中的继承和多态简化编码过程。

YoungeYang的博客 1263

【四足机器人项目实战】四足机器人弹簧倒立摆(SLIP)动力学模型

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 TODO:写完再整理 文章目录系列文章目录前言1.动力学建模构型方法2.四足机器人动力学模型(1)多体动力学模型【针对躯干+脚建模】方法一:VMC(VirtualModelController)模型方法二:SLIP模型(2)浮基单体动力学模型【针对躯干建模】【用于MPC】 前言 认知有限,望大家多多包涵,有什么问题也希望能够与大家多交流,共同成长! 本文先对四足机器人动力学模型-VMC、SLIP和浮动机体模型做个简

qq_35635374的博客 7314

PPG & Phoneme Embedding & word Embedding总结

word embedding简单翻译就是词嵌入,是NLP自然语言处理中对单词处理的一种方式。就是将自然语言表示的单词转换为计算机能够理解的向量或矩阵的形式。这种技术会把单词或者短语映射到一个n维的数值化向量,核心就是一种映射关系。词嵌入由于要考虑多种因素比如词的语义(同义词近义词)、语料中词之间的关系(上下文)和向量的维度(处理复杂度)等等,我们希望近义词或者表示同类事物的单词之间的距离可以理想地近,只有拿到很理想的单词表示形式,我们才更容易地去做翻译、问答、信息抽取等进一步的工作。

Barbara‘s Blog 1313

OpenCv —— 检测车牌号(附完整源码)

OpenCv —— 检测车牌号

5601

Unsupervised Learning: Word Embedding

Unsupervised Learning: Word Embedding Word Embedding 是 Dimension Reduction 的一种应用。 要用一个vector来表示一个word,有什么方法呢: 1-of-N Encoding: 每一个词汇对应vector的一维,如: 这种方式没法体现出word之间的关系,无法表达出语义 Word Class: ...

likyoo的博客 459

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

如何进行word embedding(tensorflow实现)

1. 什么是word embedding (1)从word到num 我们的自然语言,不管是中文还是英文都不能直接在机器中表达,此时就要将自然语言映射为数字。要映射成数字就要有字典,所以一般会先构建词典,举例如下: word_dict = {"我":0, "你":1, "他":2, "她":3, "是":4, "好":5, "坏":6, "人":7, "天":8, "第":9, "气":10, "今":11, "怎":12, "么":13, "样":14,

comli_cn的博客 2803

word embedding(详细讲解word embedding)

机器经过阅读大量的words,将每个单词用vector表示,vector的dimension表达着这个单词的属性,意思相近单词,dimension就会呈现出来。vector就是word embedding。 为了表示每个单词之间有联系,用二维vector来表示单词。可以更直观的看出每个单词的所属的类或者具有某种共同点。 ...

qq_44479403的博客 3741

如何使用预训练的word embedding

https://nlp.stanford.edu/projects/glove/

yanhe156的博客 3368

简单理解word embedding和word2vec

word embedding&amp;amp;word2vecone-hot encoding one-hot encoding 编码中编码单词的一种方法是one-hot encoding eg. 有1000个单词,按照字典顺序排序为&quot;a&quot;, “apple”, … , “zoo”。每一个单词可以用一个1000维的向量表示,分别为: ...

NevesZhang 4660

Word Embedding的学习

Word Embedding的概述: 根据之前对One Hot的介绍,我们发现它不能够表现出词语之间的相似度,因此提出Word Embedding。 首先,我们提一下分布式表示(distributed representation):若干元素的连续表现形式,将词的语义分布式地存储在各个维度中,与之相反的是独热向量(One Hot)。 而Word Embedding(词嵌入)是基于神经网络的分布式表示,也可称之为词向量,是将自然语言表示的单词转换为计算机能够理解的向量或矩阵形式的技术。总的来说,它.

longshendaren的博客 484

Word Embedding的通俗解释

**Word Embedding是NLP中最频繁出现的词了,关于word embedding,其实很简单。 word embedding的意思是:给出一个文档,文档就是一个单词序列比如 “A B A C B F G”, 希望对文档中每个不同的单词都得到一个对应的向量(往往是低维向量)表示。 比如,对于这样的“A B A C B F G”的一个序列,也许我们最后能得到:A对应的向量为[0.1 0.6 -0.5],B对应的向量为[-0.2 0.9 0.7] (此处的数值只用于示意) 之所以希望把每个单词变成一个

https://blog.datasource.space 4885
上一篇: Python实现文本分词并写入新的文本文件,然后提取出文本中的关键词
下一篇: NLP 基础知识大集合
村雨遥
村雨遥 优质创作者: Java技术领域 优质创作者: Java技术领域 领域专家: 算法与数据结构技术领域 领域专家: 算法与数据结构技术领域
博客等级 码龄9年 2万+粉丝 372原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

村雨遥

众筹一毛买键盘!

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值