【Scrapy】Scrapy的pipelines管道使用方法

Scrapy爬虫框架 Pipeline 数据传输管道 在 Scrapy 中,除了使用内置的 Pipeline 功能外,自定义 Pipeline 是一种非常灵活且强大的方式,可以根据具体需求来处理抓取到的数据。自定义 Pipeline 允许你编写自己的逻辑,以适应特定的业务需求,无论是数据清洗、过滤、存储,还是其他特殊的处理操作。自定义 Pipeline 是指开发者根据项目需求,自行编写的用于处理item的 Python 类。自定义 Pipeline 就像是你在厨房里制作一道特别的菜肴。 阅读详情

在讲解pipelines之前,我先举个例子,这样好了解爬取数据的具体过程:

  1. 发送请求
  2. 获取到数据(从网站上爬取了数据)
  3. 数据清洗(处理数据)
  4. 存储(把数据存储起来)

而现在,我介绍一下pipelines,它可以负责的就是第3和第4步的工作,专业述语就是管道。我们通过定义一个或多个class,可以用来处理我们传入的数据。

代码目录:
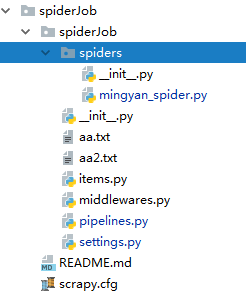
 

爬虫代码 mingyan_spider.py:

import scrapy

def getUrl():
    return 'https://search.51job.com/list/030200,000000,0000,00,9,99,%2520,2,1.html?lang=c&stype=&postchannel=0000&workyear=99&cotype=99&degreefrom=99&jobterm=99&companysize=99&providesalary=99&lonlat=0%2C0&radius=-1&ord_field=0&confirmdate=9&fromType=&dibiaoid=0&address=&line=&specialarea=00&from=&welfare='


class itemSpider(scrapy.Spider):
    name = 'argsSpider'
    def start_requests(self):
        url = getUrl()
        yield scrapy.Request(url, self.parse)  # 发送请求爬取参数内容

    def parse(self, response):
        mingyan = response.css('div#resultList>.el')  # 提取首页所有名言,保存至变量mingyan
        for v in mingyan:  # 循环获取每一条名言里面的:名言内容、作者、标签
            t1 = v.css('.t1 a::text').extract_first()
            t2 = v.css('.t2 a::attr(title)').extract_first()  # 提取名言
            t3 = v.css('.t3::text').extract_first()
            t4 = v.css('.t4::text').extract_first()

            t1 = str(t1).replace(' ', '')
            t1 = str(t2).replace(' ', '')
            t3 = str(t3).replace(' ', '')
            t4 = str(t4).replace(' ', '')

            item = {
                't1': t1,
                't2': t2,
                't3': t3,
                't4': t4,
            }
            yield item

配置文件setting.py:

(需要配置了,管道才能生效,数字越小,管道的优先级越高,优先调用。数字控制在0~1000. )

#SpiderjobPipeline2 先执行
ITEM_PIPELINES = {
   'spiderJob.pipelines.SpiderjobPipeline': 400,
   'spiderJob.pipelines.SpiderjobPipeline2':100,
}


管道文件pipelines.py:

#存储
class SpiderjobPipeline(object):
    # 可选实现,做参数初始化等
    def __init__(self):
        print("//////////////")

    # item (Item 对象) – 被爬取的item
    # spider (Spider 对象) – 爬取该item的spider
    # 这个方法必须实现,每个item pipeline组件都需要调用该方法,
    # 这个方法必须返回一个 Item 对象,被丢弃的item将不会被之后的pipeline组件所处理。
    def process_item(self, item, spider):
        fileName = 'aa.txt'  # 定义文件名
        if str(item['t1'])=='None':
            return item;
        with open(fileName, "a+", encoding='utf-8') as f:
            item = str(item['t1']) + "," + str(item['t2']) + "," + str(item['t3']) + "," + str(item['t4'])
            f.write(item)
            f.write('\n')  # ‘\n’ 表示换行
            # f.write('标签:' + tags)
            f.write('\n-------\n')
            f.close()
        return item


#先给数据加上title
class SpiderjobPipeline2(object):
    def process_item(self, item, spider):
        return {
            't1': '岗位:'+item['t1'],
            't2': '公司:'+item['t2'],
            't3': '地区:'+item['t3'],
            't4': '薪资:'+item['t4'],
        }

效果:

Scrapy爬虫框架 Pipeline 数据的过滤与存储 在本教程中,我们深入探讨了如何在Scrapy 中使用Pipeline来处理抓取到的数据。Pipeline是Scrapy中的一个关键组件,它不仅能够帮助你高效地存储数据,还可以对数据进行清理、去重和转换等操作。通过这一系列的学习,你已经掌握了如何将抓取的数据写入JSON文件和MongoDB数据库,如何利用Selenium保存网页截图,以及如何通过内存或数据库来过滤重复数据。希望通过本教程,你能够更加熟练地运用Scrapy的Pipeline功能,为你的爬虫项目增添更多的数据处理能力。 阅读详情

相关推荐

【Python自学笔记】新手爬虫必备!!Scrapy中item pipelines管道的使用(清洗数据&保存数据)!

文章目录Item定义item使用itemPipeline管道类保存数据 Item Scrapy可以将解析结果以字典形式返回,但是Python中字典缺少结构,在大型爬虫系统中很不方便!所以Scrapy中,定义了一个专门的通用数据结构:Item。这个Item对象提供了跟字典相似的API,并且有一个非常方便的语法来声明可用的字段。 定义item item对象结构定义在项目目录下的items.py文件中,只需要创建一个继承了 scrapy.Item 的类,并使用scrapy.Field() 类定义项目所需字

XiaoqiangClub的博客 869

scrapy框架之item pipeline的使用

转载:https://blog.youkuaiyun.com/kuangshp128/article/details/80321099 一、关于scrapy中pipleline的基本认识 Item Pipeline又称之为管道,顾名思义就是对数据的过滤处理,其主要的作用包括如下: 清理HTML数据。 验证爬取数据,检查爬取字段。 查重并丢弃重复内容。 将爬取结果保存到数据库。 二、几个核心的方法...

qq_36386435的博客 1115

别再为格式发愁:safetensors转GGUF的三种高效方法及Ollama集成对比

本文详细介绍了将safetensors格式转换为GGUF格式的三种高效方法,包括llama.cpp原生转换、GGUF官方工具链和Transformers中转方案,并对比了它们在Ollama集成中的表现。文章还提供了实际项目中的踩坑经验和性能调优建议,帮助开发者快速掌握模型转换技术。

weixin_42651281的博客 640

【Python_Scrapy学习笔记(五)】Scrapy框架之管道文件pipelines.py详解

pipelines.py 文件是 Scrapy 框架下,用于接收网络爬虫传过来的数据,以便做进一步处理的文件。例如验证实体的有效性、清除不需要的信息、存入数据库(持久化实体)、存入文本文件等。本文中介绍 pipelines.py 文件的基本使用方法。

禾戊之昂的博客 1404

银河麒麟高级服务器操作系统V10SP2(X86)PXE无人值守批量部署实战指南

本文详细介绍了银河麒麟高级服务器操作系统V10SP2(X86)PXE无人值守批量部署的实战指南。通过PXE网络引导技术,实现全自动化、高效率的系统部署,特别适用于企业级数据中心和国产化替代项目。文章涵盖基础环境准备、关键服务配置、Kickstart高级定制及部署测试等核心内容,帮助用户快速掌握批量部署技巧。

weixin_42525637的博客 382

SQL中的时间计算:员工每日工作时长

摘要:本文介绍了一个使用SQL查询计算员工每日工作时长的实用方法。通过分析包含员工打卡记录的数据库表,利用CTE(公共表表达式)将日期分组,计算最早和最晚打卡时间差,最终以"小时:分钟"格式输出工作时长。该方法适用于每日两次打卡的场景,并提示了处理漏打卡等特殊情况时的注意事项,为企业考勤管理提供了有效的数据支持方案。(148字)

m0_74337424的博客 412

一文带你深入了解 Scrapy 中的 Pipelines 和 Item

在Scrapy中定义Item类很简单,通常在项目中的items.py文件中创建。# 添加其他字段...

weixin_68789096的博客 916

扫码登录原理

扫码登录功能通过PC端与移动端的交互实现安全认证,分为三个阶段:待扫描阶段生成唯一二维码ID并轮询状态;已扫描阶段移动端提交token与二维码ID关联,生成临时token并要求用户确认;确认阶段验证临时token后为PC端生成正式登录凭证。整个过程通过二维码唯一性、状态轮询和二次确认机制确保安全性,防止未授权登录,最终完成跨设备认证流程。

阿杰同学的博客 344

Scrapy_pipelines管道文件详细教程保存csv,Mysql,Mongodb以及多个item返回pipelines的处理

Scrapy_pipelines文件详细教程保存到csv,Mysql,Mongodb以及多个item返回pipelines的处理

m0_73689941的博客 1937

第23章:代码迁移——用AI将Vue2迁移到Vue3、将JS迁移到TS

> - 用AI自动将Vue2 Options API转为Vue3 Composition API的完整流程 > - 将JavaScript项目批量迁移到TypeScript,自动添加类型推导 > - 处理依赖冲突、破坏性变更和迁移后的验证方法 > - 一个完整的Vue2到Vue3迁移案例(含路由、状态管理) > - 我如何用AI将公司一个10万行代码的老项目从JS升级到TS

sfishfly的博客 207

微信小程序推广策略,打开小程序领域流量大门

本文旨在为小程序开发者、运营者和企业主提供一套完整的微信小程序推广策略体系,帮助他们在竞争激烈的小程序生态中获得更多流量和用户。内容涵盖从0到1的冷启动策略,到成熟期的增长技巧。本文将首先介绍小程序的基础推广设置,然后深入探讨各种流量获取渠道,接着分析数据驱动的优化方法,最后展望未来发展趋势。小程序:无需下载安装即可使用的应用,运行在微信生态内:独立访客数:页面浏览量转化率:完成目标行为的用户比例留存率:用户在一定时间后仍活跃的比例自然流量获取:通过优化搜索、完善资料等方式获得基础流量社交裂变。

小程序开发 1031

4_scrapy的管道pipelines使用详解

1. pipelines常用的方法 process_item(self,item,spider): 管道类中必须有的函数 实现对item数据的处理 必须return item open_spider(self, spider): 在爬虫开启的时候仅执行一次 close_spider(self, spider): 在爬虫关闭的时候仅执行一次 2. 对管道文件修改 易错点:这里需要返回item,而且是在if外, 当该管道在setting文件中排第一个时,需要将item原封不动的返回, 否则下一个

跑着跑着人就瘦了 1039

基于Simulink和Control System Toolbox的线控转向(Steer-by-Wire)系统设计

通过上述步骤,我们成功设计并实现了基于 Simulink 和 Control System Toolbox 的线控转向(Steer-by-Wire)系统。该系统能够接收来自方向盘的角度指令,经过控制器处理后,驱动转向执行器(如电动机),实现对车辆前轮转向角度的精确控制。通过虚拟场景仿真、硬件在环测试和实车测试,验证了系统的响应速度、控制精度、车辆稳定性和实时性能,并通过参数优化进一步提升了系统的性能。

MHD0815的博客 549

scrapy 管道文件 pipelines.py

目录 process_item(self,item,spider) open_spider(self,spider) close_spider(self,spider) from_crawler(cls,crawler) 过滤重复数据的定义管道 存储到数据库 MongoDB 下载文件名的更改 存储到数据库 MySQL process_item(self,item,spider) ...

木下瞳的博客 1896

Yocto开发讲解系列 - 总目录

Yocto开发讲解系列总纲Yocto开发专栏前言

fulinux的博客 3万+

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Scrapy从入门到放弃4--管道pipelines使用

Scrapy管道的使用 学习目标: 掌握 scrapy管道(pipelines.py)的使用 之前我们在scrapy入门使用一节中学习了管道的基本使用,接下来我们深入的学习scrapy管道的使用 1. pipeline中常用的方法: process_item(self,item,spider): 管道类中必须有的函数 实现对item数据的处理 必须return item open_spider(self, spider): 在爬虫开启的时候仅执行一次 close_spider(self,

北山啦的博客 1660

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Scrapy爬虫框架管道文件pipelines数据图像存储

Scrapy爬虫框架管道文件pipelinesScrapy爬虫框架管道文件pipelines一、pipelines的通用性二、pipelines的主要功能1、对数据进行后处理,清洗,去重,融合,加时间戳......2、将数据存储在文件系统3、将数据存储到数据库4、下载图片视频等二进制文件 Scrapy爬虫框架管道文件pipelines 很多人开始使用scrapy框架会对pipelines的作用不够...

Boring_Doctor的博客 1000

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

scrapy框架pipelines管道文件基本写法

import json # 转码操作,继承json.JSONEncoder的子类,在json目录下的encoder.py中 class MyEncoder(json.JSONEncoder): def default(self, o): if isinstance(o, bytes): return str(o, encoding='utf-8') ...

執筆冩回憶 1232

Scrapy添加请求头、添加cookie、多个spider顺序运行、pipelines管道

记录一下scrapy使用中的添加请求头,添加cookie等

苟日新,日日新,又日新!!! 7144

Scrapy框架的学习(2.scrapy入门,简单爬取页面,并使用管道(pipelines)保存数据)

上个博客写了: Scrapy的概念以及Scrapy的详细工作流程https://blog.youkuaiyun.com/wei18791957243/article/details/86154068 1.scrapy的安装 pip install scrapy 2.创建Scarpy项目: 在cmd中进入到想要创建Scrapy项目的路径下(最好在已经创建好的pycharm的工程路径下,就不......

Mogul的博客 2066

scrapy爬虫框架 (1. Scrapy的基本介绍、使用流程、分组打印、pipelines(管道)使用)、分页爬取

1.scrapy介绍 scrapy是一个为更快爬取网站数据、提取结构性数据而编写的爬虫框架。并且scrapy使用了Twisted异步网络框架,使下载速度更快。 request是模块,模块只能帮助我们发送请求。 scrapy是框架,框架可以帮助我们解决各种需求,其中可能每一个都是模块,框架包含模块。 1.创建项目 通过cmd进入项目存放的文件夹下,然后输入 scrapy startproject [...

随笔 1369

Python爬虫——scrapy-3

使用scrapy爬取当当网的商品数据

WenJGo的博客 2745

解决Scrapy抓取中文结果保存为文件时的编码问题

1 import json 2 import codecs 3 4 5 # Define your item pipelines here 6 # 7 # Don't forget to add your pipeline to the ITEM_PIPELINES setting 8 # See: http://doc.scrapy.org/en/...

253

scrapy 基础使用以及错误方案_scrapytypeerro

scrapy crawl sina (这个是进入…>sina>sinaSpeder 文件夹后运行的)scrapy crawl sina (这个是进入…>sina>sinaSpeder 文件夹后运行的)# 文件名为子链接url中间部分,并将 / 替换为。# 大类的标题和url。,保存为 .txt格式。

2501_90404828的博客 435

scrapy学习---管道

使用管道必须实现process_item() 方法process_item(self,item,spider) 次方法实现数据的过滤处理等操作 open_spider(self,spider) 开始运行爬虫是调用 close_spider(self,spider) 结束爬虫时调用 from_crawler(cls,crawler) If present, this clas...

weixin_30950237的博客 78

SCRAPY框架执行爬虫无法进入pipeline管道问题

编写完spider、item、pipeline文件直接执行spider看程序是否能够抓取到数据,这时候会发现数据没通过pipeline保存下来,其实是忽略了配置文件setting.py。 pipeline.py文件其实有做出提示: # -*- coding: utf-8 -*- # Define your item pipelines here # # Don't forget to add y...

小绿的博客 4036
上一篇: Uncaught TypeError: Cannot assign to read only property 'exports' of object '
下一篇: HTML标签的maxlength无效的原因
gz-郭小敏
博客等级 码龄9年 39粉丝 112原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
