


让计算机程序并发的运行是一个经常被讨论的话题,今天我想讨论一下Python下的各种并发方式。
并发方式
线程(Thread)
多线程几乎是每一个程序猿在使用每一种语言时都会首先想到用于解决并发的工具(JS程序员请回避),使用多线程可以有效的利用CPU资源(Python例外)。然而多线程所带来的程序的复杂度也不可避免,尤其是对竞争资源的同步问题。
然而在python中由于使用了全局解释锁(GIL)的原因,代码并不能同时在多核上并发的运行,也就是说,Python的多线程不能并发,很多人会发现使用多线程来改进自己的Python代码后,程序的运行效率却下降了,这是多么蛋疼的一件事呀!如果想了解更多细节,推荐阅读这篇文章。实际上使用多线程的编程模型是很困难的,程序员很容易犯错,这并不是程序员的错误,因为并行思维是反人类的,我们大多数人的思维是串行(精神分裂不讨论),而且冯诺依曼设计的计算机架构也是以顺序执行为基础的。所以如果你总是不能把你的多线程程序搞定,恭喜你,你是个思维正常的程序猿:)
Python提供两组线程的接口,一组是thread模块,提供基础的,低等级(Low Level)接口,使用Function作为线程的运行体。还有一组是threading模块,提供更容易使用的基于对象的接口(类似于Java),可以继承Thread对象来实现线程,还提供了其它一些线程相关的对象,例如Timer,Lock
使用thread模块的例子
import thread
def worker():
    """thread worker function"""
    print 'Worker'
thread.start_new_thread(worker)
使用threading模块的例子
import threading
def worker():
    """thread worker function"""
    print 'Worker'
t = threading.Thread(target=worker)
t.start()
或者Java Style
import threading
class worker(threading.Thread):
    def __init__(self):
        pass
    def run():
        """thread worker function"""
        print 'Worker'

t = worker()
t.start()
进程 (Process)
由于前文提到的全局解释锁的问题,Python下比较好的并行方式是使用多进程,这样可以非常有效的使用CPU资源,并实现真正意义上的并发。当然,进程的开销比线程要大,也就是说如果你要创建数量惊人的并发进程的话,需要考虑一下你的机器是不是有一颗强大的心。
Python的mutliprocess模块和threading具有类似的接口。
from multiprocessing import Process

def worker():
    """thread worker function"""
    print 'Worker'
p = Process(target=worker)
p.start()
p.join()
由于线程共享相同的地址空间和内存,所以线程之间的通信是非常容易的,然而进程之间的通信就要复杂一些了。常见的进程间通信有,管道,消息队列,Socket接口(TCP/IP)等等。
Python的mutliprocess模块提供了封装好的管道和队列,可以方便的在进程间传递消息。
Python进程间的同步使用锁,这一点喝线程是一样的。
另外,Python还提供了进程池Pool对象,可以方便的管理和控制线程。
远程分布式主机 (Distributed Node)
随着大数据时代的到临,摩尔定理在单机上似乎已经失去了效果,数据的计算和处理需要分布式的计算机网络来运行,程序并行的运行在多个主机节点上,已经是现在的软件架构所必需考虑的问题。
远程主机间的进程间通信有几种常见的方式
-
TCP/IP
TCP/IP是所有远程通信的基础,然而API比较低级别,使用起来比较繁琐,所以一般不会考虑
-
远程方法调用 Remote Function Call
-
远程对象 Remote Object
远程对象是更高级别的封装,程序可以想操作本地对象一样去操作一个远程对象在本地的代理。远程对象最广为使用的规范CORBA,CORBA最大的好处是可以在不同语言和平台中进行通信。当让不用的语言和平台还有一些各自的远程对象实现,例如Java的RMI,MS的DCOM
Python的开源实现,有许多对远程对象的支持
-
消息队列 Message Queue
比起RPC或者远程对象,消息是一种更为灵活的通信手段,常见的支持Python接口的消息机制有
在远程主机上执行并发和本地的多进程并没有非常大的差异,都需要解决进程间通信的问题。当然对远程进程的管理和协调比起本地要复杂。
Python下有许多开源的框架来支持分布式的并发,提供有效的管理手段包括:
-
Celery是一个非常成熟的Python分布式框架,可以在分布式的系统中,异步的执行任务,并提供有效的管理和调度功能。参考这里
-
SCOOP (Scalable COncurrent Operations in Python)提供简单易用的分布式调用接口,使用Future接口来进行并发。
-
相比起Celery和SCOOP,Dispy提供更为轻量级的分布式并行服务
-
PP (Parallel Python)是另外一个轻量级的Python并行服务, 参考这里
-
Asyncoro是另一个利用Generator实现分布式并发的Python框架,
当然还有许多其它的系统,我没有一一列出
另外,许多的分布式系统多提供了对Python接口的支持,例如Spark
伪线程 (Pseudo-Thread)
还有一种并发手段并不常见,我们可以称之为伪线程,就是看上去像是线程,使用的接口类似线程接口,但是实际使用非线程的方式,对应的线程开销也不存的。
-
greenlet提供轻量级的coroutines来支持进程内的并发。
greenlet是Stackless的一个副产品,使用tasklet来支持一中被称之为微线程(mirco-thread)的技术,这里是一个使用greenlet的伪线程的例子
from greenlet import greenlet

def test1():
    print 12
    gr2.switch()
    print 34

def test2():
    print 56
    gr1.switch()
    print 78

gr1 = greenlet(test1)
gr2 = greenlet(test2)
gr1.switch()
运行以上程序得到如下结果:
12
56
34
伪线程gr1 switch会打印12,然后调用gr2 switch得到56,然后switch回到gr1,打印34,然后伪线程gr1结束,程序退出,所以78永远不会被打印。通过这个例子我们可以看出,使用伪线程,我们可以有效的控制程序的执行流程,但是伪线程并不存在真正意义上的并发。
eventlet,gevent和concurence都是基于greenlet提供并发的。
-
eventlet http://eventlet.net/
eventlet是一个提供网络调用并发的Python库,使用者可以以非阻塞的方式来调用阻塞的IO操作。
import eventlet
from eventlet.green import urllib2

urls = ['http://www.google.com', 'http://www.example.com', 'http://www.python.org']

def fetch(url):
    return urllib2.urlopen(url).read()

pool = eventlet.GreenPool()

for body in pool.imap(fetch, urls):
    print("got body", len(body))
执行结果如下
('got body', 17629)
('got body', 1270)
('got body', 46949)
eventlet为了支持generator的操作对urllib2做了修改,接口和urllib2是一致的。这里的GreenPool和Python的Pool接口一致。
gevent和eventlet类似,关于它们的差异大家可以参考这篇文章
import gevent
from gevent import socket
urls = ['www.google.com', 'www.example.com', 'www.python.org']
jobs = [gevent.spawn(socket.gethostbyname, url) for url in urls]
gevent.joinall(jobs, timeout=2)

print [job.value for job in jobs]
执行结果如下:
['206.169.145.226', '93.184.216.34', '23.235.39.223']-
concurence https://github.com/concurrence/concurrence
concurence是另外一个利用greenlet提供网络并发的开源库,我没有用过,大家可以自己尝试一下。
实战运用
通常需要用到并发的场合有两种,一种是计算密集型,也就是说你的程序需要大量的CPU资源;另一种是IO密集型,程序可能有大量的读写操作,包括读写文件,收发网络请求等等。
计算密集型
对应计算密集型的应用,我们选用著名的蒙特卡洛算法来计算PI值。基本原理如下
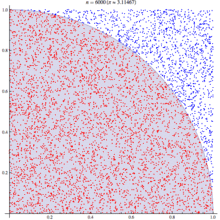
蒙特卡洛算法利用统计学原理来模拟计算圆周率,在一个正方形中,一个随机的点落在1/4圆的区域(红色点)的概率与其面积成正比。也就该概率 p = Pi * R*R /4 : R* R , 其中R是正方形的边长,圆的半径。也就是说该概率是圆周率的1/4, 利用这个结论,只要我们模拟出点落在四分之一圆上的概率就可以知道圆周率了,为了得到这个概率,我们可以通过大量的实验,也就是生成大量的点,看看这个点在哪个区域,然后统计出结果。
基本算法如下:
from math import hypot
from random import random

def test(tries):
    return sum(hypot(random(), random()) < 1 for _ in range(tries))
这里test方法做了n(tries)次试验,返回落在四分之一圆中的点的个数。判断方法是检查该点到圆心的距离,如果小于R则是在圆上。
通过大量的并发,我们可以快速的运行多次试验,试验的次数越多,结果越接近真实的圆周率。
这里给出不同并发方法的程序代码
-
非并发
我们先在单线程,但进程运行,看看性能如何
from math import hypot
from random import random
import eventlet
import time

def test(tries):
    return sum(hypot(random(), random()) < 1 for _ in range(tries))

def calcPi(nbFutures, tries):
    ts = time.time()
    result = map(test, [tries] * nbFutures)

    ret = 4. * sum(result) / float(nbFutures * tries)
    span = time.time() - ts
    print "time spend ", span
    return ret

print calcPi(3000,4000)-
多线程 thread
为了使用线程池,我们用multiprocessing的dummy包,它是对多线程的一个封装。注意这里代码虽然一个字的没有提到线程,但它千真万确是多线程。
通过测试我们开(jing)心(ya)的发现,果然不出所料,当线程池为1是,它的运行结果和没有并发时一样,当我们把线程池数字设置为5时,耗时几乎是没有并发的2倍,我的测试数据从5秒到9秒。所以对于计算密集型的任务,还是放弃多线程吧。
from multiprocessing.dummy import Pool

from math import hypot
from random import random
import time

def test(tries):
    return sum(hypot(random(), random()) < 1 for _ in range(tries))

def calcPi(nbFutures, tries):
    ts = time.time()
    p = Pool(1)
    result = p.map(test, [tries] * nbFutures)
    ret = 4. * sum(result) / float(nbFutures * tries)
    span = time.time() - ts
    print "time spend ", span
    return ret

if __name__ == '__main__':
    p = Pool()
print("pi = {}".format(calcPi(3000, 4000)))-
多进程 multiprocess
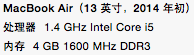
理论上对于计算密集型的任务,使用多进程并发比较合适,在以下的例子中,进程池的规模设置为5,修改进程池的大小可以看到对结果的影响,当进程池设置为1时,和多线程的结果所需的时间类似,因为这时候并不存在并发;当设置为2时,响应时间有了明显的改进,是之前没有并发的一半;然而继续扩大进程池对性能影响并不大,甚至有所下降,也许我的Apple Air的CPU只有两个核?
当心,如果你设置一个非常大的进程池,你会遇到 Resource temporarily unavailable的错误,系统并不能支持创建太多的进程,毕竟资源是有限的。
from multiprocessing import Pool

from math import hypot
from random import random
import time

def test(tries):
    return sum(hypot(random(), random()) < 1 for _ in range(tries))

def calcPi(nbFutures, tries):
    ts = time.time()
    p = Pool(5)
    result = p.map(test, [tries] * nbFutures)
    ret = 4. * sum(result) / float(nbFutures * tries)
    span = time.time() - ts
    print "time spend ", span
    return ret

if __name__ == '__main__':
print("pi = {}".format(calcPi(3000, 4000)))-
gevent (伪线程)
不论是gevent还是eventlet,因为不存在实际的并发,响应时间和没有并发区别不大,这个和测试结果一致。
import gevent
from math import hypot
from random import random
import time

def test(tries):
    return sum(hypot(random(), random()) < 1 for _ in range(tries))

def calcPi(nbFutures, tries):
    ts = time.time()
    jobs = [gevent.spawn(test, t) for t in [tries] * nbFutures]
    gevent.joinall(jobs, timeout=2)
    ret = 4. * sum([job.value for job in jobs]) / float(nbFutures * tries)
    span = time.time() - ts
    print "time spend ", span
    return ret

print calcPi(3000,4000)-
eventlet (伪线程)
from math import hypot
from random import random
import eventlet
import time

def test(tries):
    return sum(hypot(random(), random()) < 1 for _ in range(tries))

def calcPi(nbFutures, tries):
    ts = time.time()
    pool = eventlet.GreenPool()
    result = pool.imap(test, [tries] * nbFutures)

    ret = 4. * sum(result) / float(nbFutures * tries)
    span = time.time() - ts
    print "time spend ", span
    return ret

print calcPi(3000,4000)-
SCOOP
SCOOP中的Future接口符合PEP-3148的定义,也就是在Python3中提供的Future接口。
在缺省的SCOOP配置环境下(单机,4个Worker),并发的性能有提高,但是不如两个进程池配置的多进程。
from math import hypot
from random import random
from scoop import futures

import time

def test(tries):
    return sum(hypot(random(), random()) < 1 for _ in range(tries))

def calcPi(nbFutures, tries):
    ts = time.time()
    expr = futures.map(test, [tries] * nbFutures)
    ret = 4. * sum(expr) / float(nbFutures * tries)
    span = time.time() - ts
    print "time spend ", span
    return ret

if __name__ == "__main__":
print("pi = {}".format(calcPi(3000, 4000)))-
Celery
任务代码
from celery import Celery

from math import hypot
from random import random

app = Celery('tasks', backend='amqp', broker='amqp://guest@localhost//')
app.conf.CELERY_RESULT_BACKEND = 'db+sqlite:///results.sqlite'

@app.task
def test(tries):
    return sum(hypot(random(), random()) < 1 for _ in range(tries))
客户端代码
from celery import group
from tasks import test

import time

def calcPi(nbFutures, tries):
    ts = time.time()
    result = group(test.s(tries) for i in xrange(nbFutures))().get()

    ret = 4. * sum(result) / float(nbFutures * tries)
    span = time.time() - ts
    print "time spend ", span
    return ret

print calcPi(3000, 4000)
使用Celery做并发的测试结果出乎意料(环境是单机,4frefork的并发,消息broker是rabbitMQ),是所有测试用例里最糟糕的,响应时间是没有并发的5~6倍。这也许是因为控制协调的开销太大。对于这样的计算任务,Celery也许不是一个好的选择。
-
asyncoro
Asyncoro的测试结果和非并发保持一致。
import asyncoro

from math import hypot
from random import random
import time

def test(tries):
    yield sum(hypot(random(), random()) < 1 for _ in range(tries))


def calcPi(nbFutures, tries):
    ts = time.time()
    coros = [ asyncoro.Coro(test,t) for t in [tries] * nbFutures]
    ret = 4. * sum([job.value() for job in coros]) / float(nbFutures * tries)
    span = time.time() - ts
    print "time spend ", span
    return ret

print calcPi(3000,4000)
IO密集型
IO密集型的任务是另一种常见的用例,例如网络WEB服务器就是一个例子,每秒钟能处理多少个请求时WEB服务器的重要指标。
我们就以网页读取作为最简单的例子
from math import hypot
import time
import urllib2

urls = ['http://www.google.com', 'http://www.example.com', 'http://www.python.org']

def test(url):
    return urllib2.urlopen(url).read()

def testIO(nbFutures):
    ts = time.time()
    map(test, urls * nbFutures)

    span = time.time() - ts
    print "time spend ", span

testIO(10)
在不同并发库下的代码,由于比较类似,我就不一一列出。大家可以参考计算密集型中代码做参考。
通过测试我们可以发现,对于IO密集型的任务,使用多线程,或者是多进程都可以有效的提高程序的效率,而使用伪线程性能提升非常显著,eventlet比没有并发的情况下,响应时间从9秒提高到0.03秒。同时eventlet/gevent提供了非阻塞的异步调用模式,非常方便。这里推荐使用线程或者伪线程,因为在响应时间类似的情况下,线程和伪线程消耗的资源更少。
总结
Python提供了不同的并发方式,对应于不同的场景,我们需要选择不同的方式进行并发。选择合适的方式,不但要对该方法的原理有所了解,还应该做一些测试和试验,数据才是你做选择的最好参考。

 60


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


