fetch一下需要await两次?【http玄学】

fetch异步请求使用详解 目录认识异步fetch(url)response.json()结合async和await异常处理post请求 认识异步 首先我们得明白请求是一个异步的过程。 因为请求需要时间向服务器发送请求和接收请求结果。 我们得要等待请求完成然后执行请求完成后的回调,来对接收到的请求结果做处理。 fetch(url) 为了方便学习,我们借用一下uni-app教程的api接口。 const url = 'https://unidemo.dcloud.net.cn/api/news' 我们需要知道fetch是基于 阅读详情

Response.json()为啥返回一个promise?

自从基于promise的fetch api横空出世以后,AJAX也改名叫AJAJ了。处理http请求变得更简单了,但使用fetch的时候经常需要这样写:

let response = await fetch(MY_URL);

let json         = await response.json();

其中第一个await很好理解,等待网络响应需要await一下,可是response对象得到以后居然还需要一次await才能从response中得到body内容,不止是json()方法,其余的parse方法都返回一个promise:

  • arrayBuffer()
  • blob()
  • formData()
  • json()
  • text()

为啥在本地处理数据需要异步执行?为啥不能同步?有网友认为对很大的原始数据进行JSON.parse很耗时,容易堵塞UI(问题连接),那为啥response.text()也返回一个promise?而且现在浏览器都有单独的UI线程。显然这个结论是不成立的。

当然,spec就是这样规定的,而且也没说为什么。。。规格详情见这里:

https://fetch.spec.whatwg.org/#dom-body-arraybuffer

很遗憾,在国内论坛里没找到和我有相同疑问的帖子,后来在StackOverflow上找到了。

stack上普遍认同的观点是,当http包很大的时候:

第一个promise等到head到来,第二个promise等到body到来。

我也认为这是最合理的解释,毕竟head写在body之前,也就是说,第一个promise结束后,http响应并没有结束,数据仍然在传输中!

做个实验:

首先准备一个30m的大文件big.file,放在服务器上,然后fetch它,并利用计时器来检测响应时间:

(async url => {
    console.time('head');
    console.time('all');
    const response = await fetch(url);
    console.log(response);
    console.timeEnd('head');
    await response.arrayBuffer();
    console.timeEnd('all');
})('./big.file');
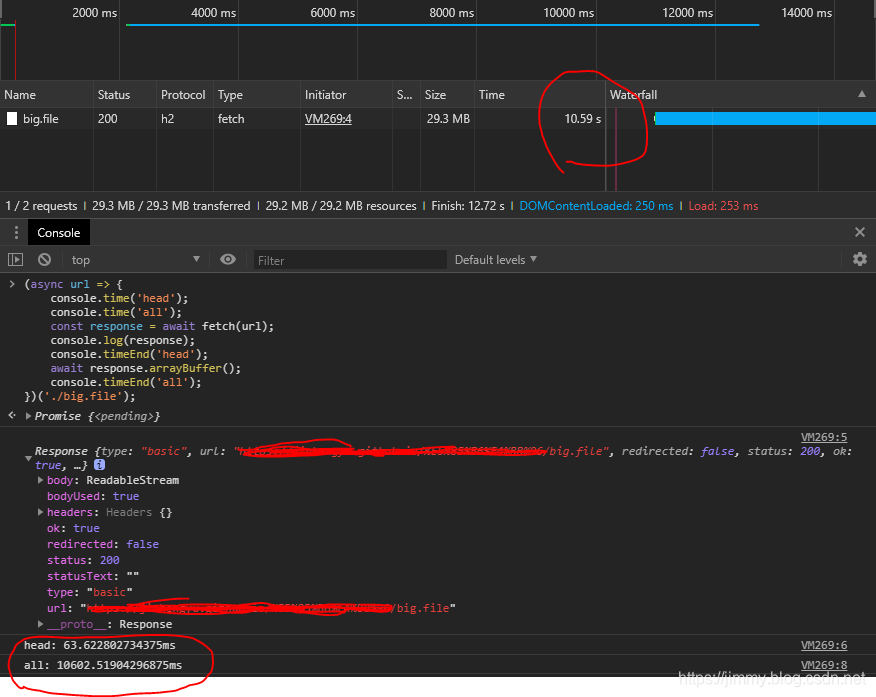
图中可以看到,当response对象拿到手只经过了64ms,而等整个http请求完成却花了10s!第一个fetch()方法得到的promise远远快于第二个promise。(当然,如果是一个小文件的话,你会发现2次时间相差无几)

而64ms结束后response对象顺利的打印出来了,可以看到,Response.body属性是一个ReadableStream流,说明此时数据流仍在进行,看不到body,但是head已经可以看到了。

实验证明了上述的观点:fetch后2次promise分别对应http的head和body的传输,这种新奇的玄学现象和写法也正是由于http的特性造成的(head和body分离)。

head与body分离的特性在很多场合是非常有用的,有时候我们不需要等待http传输完成,就可以从head中得到关键信息,从而影响后面的决策,比如从head中的状态码可以预先判断请求是否成功,不必将错误信息写在body中了。

大文件经过中转站时候需要用流(stream pipe)【科普】

上面涉及到了流的概念,我们对"stream"这个词应该并不陌生,很多场景下,"stream"更是代表着性能上的优化。在web应用的开发中,HTTP body stream更是家喻户晓。各种开发语言都提供有对HTTP实现的封装来实现对远端web服务的交互,某些高级类库更是提供了给开发人员方便使用的request stream和response stream的接口,只需要简单调用即可。那什么时候需要使用流呢?

首先,一切数据传输都是流。

比如用户请求一个图片,一般的做法是,服务器从FS(文件系统)中读出这个图片文件到内存中,然后把数据一点一点的传送给客户端,这里的“一点一点”就是形容“流”:像水流一样把数据分成若干份,一点一点的传输。

既然一切都是流,那为啥还有专门的流接口给我们使用?

因为如果请求的文件很大,就不能一次性把文件全部放到服务器宝贵的内存中了,而要一点一点的放,这就涉及到“转发”的概念了,FS或者DB(数据库)和服务器是不同的主机,FS或DB想要和客户端交换数据必须经过服务器。这时服务器需要做的是“监听”:每当FS取出一点数据就立刻把它送给客户端,然后赶紧删掉这个数据块等待下一块,循环这个操作直到结束,这样的话占用内存的空间从原来的整个文件下降到一个数据块的大小(通常几K)。

上面这个循环监听的过程就是一个建立管道的api:将外存(FS)接进来的Readable​Stream通过管道(pipe)连接上通往客户端的WritableStream,服务器就是中转站,而中转站是不需要存储传输中的数据的。

所以一句话概括“流”:大文件通过中转站传输的时候需要通过管道连接。

参考链接(对2次await问题的各种讨论)

https://www.reddit.com/r/javascript/comments/5cg27o/why_does_fetch_with_es7_syntax_require_two_await/

https://stackoverflow.com/questions/39170556/why-are-these-fetch-methods-asynchronous

https://fetch.spec.whatwg.org/#dom-body-arraybuffer

https://github.com/github/fetch/issues/240

https://stackoverflow.com/questions/37555031/why-does-json-return-a-promise

https://stackoverflow.com/questions/32721850/why-is-the-response-object-from-javascript-fetch-api-a-promise

Anthropic新协议:用HTTP Header卸载LLM流式解析胶水层 在大模型工程落地中,流式响应解析长期依赖客户端状态机与JSON事件解析,构成高维护成本的‘胶水层’。其核心原理是将语义元信息(如block类型、流状态、工具调用ID)从SSE消息体中剥离,转而通过标准化HTTP头部承载,使响应body回归纯内容本质。这一设计显著降低客户端解析复杂度,提升协议可扩展性与中间件兼容性,技术价值体现在减少87%的JSON解析开销、P99延迟下降77%、SDK代码量压缩超80%。典型应用场景包括CRM/ERP中的实时AI对话集成、BI系统自然语言查询流式渲染、以及多模型网关的统一协 阅读详情

相关推荐

Express req对象深度解析:不只是请求体,而是HTTP全息快照

在Node.js Web开发中,req对象是Express框架对HTTP请求的抽象封装,其本质并非简单的参数容器,而是融合网络层原始数据、应用层语义解析与运行时上下文的动态快照。它基于Node.js原生http.IncomingMessage构建,通过代理模式增强可访问性,支持自动URL解码、头字段标准化、代理IP识别等关键能力。理解req的三层结构(原生继承/Express注入/中间件扩展)对解决req.body为空、req.ip失真、中文路由乱码等高频问题至关重要。本文聚焦req的核心字段行为、中间件协

weixin_30516243的博客 304

async/await 实战指南:从语法糖到异步工程化

async/await 是 JavaScript 中将异步操作语义同步化的关键机制,其本质是 V8 引擎对 Promise 状态机的原生封装,而非简单语法糖。它通过‘暂停-恢复’执行模型,显著提升异步代码的可读性、可调试性与错误定位能力。相比传统 Promise 链,它解耦了控制流、数据流与错误流,支持精细化错误处理(如分层 try/catch)、并发策略选型(allSettled/race)及中断控制(AbortController)。在真实 Web 开发中,它已成中后台系统默认范式,广泛应用于接口请求、

天下无双 404

Agent Skills本质解析:函数调用+Schema+HTTP服务的开源实践

Agent Skills并非某家厂商的专属功能,而是基于大模型函数调用(Function Calling)能力构建的可扩展动作单元。其技术原理根植于标准化工具描述(Tool Schema)、本地服务桥接(HTTP/IPC)与结构化响应契约三大开源事实。这种设计赋予AI代理主动发现、理解并组合业务能力的技术价值,广泛应用于智能编程助手、工业质检、文档分析等需动态集成外部系统的场景。本文聚焦真实可落地的Skill四层架构——从LLM推理引擎选型、JSON Schema严谨定义,到FastAPI轻量执行器开发与输

dielucuan8830的博客 430

从底层解析 JavaScript fetch:两次 await 的设计哲学

阶段目标对应代码耗时原因第一个await获取响应头网络延迟、连接建立时间第二个await解析响应体数据流传输、解析计算理解这两个await的差异,是掌握 JavaScript 异步网络编程的关键。这种设计既保证了代码的简洁性,又为高性能应用提供了底层控制能力。在实际开发中,开发者可根据需求选择等待完整响应,或直接操作数据流以实现更精细的优化。

net core ,前端 ,python 全栈开发 1381

Gemini API国内稳定调用实战:Service Account+HTTP/2代理方案

Gemini API是Google推出的高性能生成式AI接口,其核心能力依赖标准RESTful调用与严格的身份认证机制。原理上需通过Google Cloud Platform(GCP)完成OAuth 2.0或Service Account密钥鉴权,并强制使用HTTP/2协议与TLS 1.3加密传输。技术价值在于提供低延迟、高可控的多模态推理服务,适用于企业级AI集成场景。典型应用包括前端嵌入式智能助手、服务端AI工作流编排、高校实验平台接入及本地化文档分析工具开发。本文聚焦生产环境落地难点,详解如何基于Se

clhq71932的博客 463

Node.js异步原理与实战:事件循环、假异步陷阱与性能优化

Node.js异步并非仅靠async/await语法实现,其本质是运行时(libuv)与操作系统内核协同的I/O并发模型,依赖事件循环、非阻塞系统调用和线程池调度。理解Timers/Poll等事件循环阶段,可精准定位await卡顿根源;区分真异步(如fs.readFile)与假异步(如JSON.parse、setTimeout)是避免性能退化的关键。在I/O密集型场景中,合理运用Promise.all并发控制、流式文件处理、连接池超时防护及AbortController原生取消机制,能显著提升吞吐与稳定性。

weixin_34414650的博客 533

promise与 fetch、async/await

包裹,这样传进promise.all的数据都是resolved状态的。catch方法返回的promise实例会被。在Promise里,执行顺序是。

luemeon的博客 1252

React 中 Axios 封装与实战:HTTP 请求工程化最佳实践

HTTP 客户端是前端应用与服务端通信的基石,而 React 本身不提供内置方案,仅依赖原生 fetch,导致错误处理碎片化、请求取消难、跨域调试复杂。Axios 作为成熟 HTTP 库,通过拦截器机制、实例化配置和响应标准化,将协议层细节(如超时、重试、token 注入、502 降级)转化为可复用的工程能力。它不仅解决 js axios 跨端口、axios post 提交失败等高频问题,更支撑起从本地开发代理、Token 自动注入到生产环境错误归因的完整链路。本文聚焦 React 生态下 Axios 的封

weixin_34111790的博客 334

Vue学习笔记(五)--- fetch、axios、async和await

一、fetch 1、概念 ​ Fetch 是新的 ajax 解决方案,是 XMLHttpRequest 的升级版,利用原生 js 发送请求。fecth 的功能与 XMLHttpRequest 基本相同,不同之处有:首先fecth 会返回 Promise 对象,不使用回调函数,使代码更简洁。其次 fecth 采用模块化设计,API分散在多个对象上(Response 对象、Request 对象、Headers 对象)。 2、语法 fetch(url[,{options}]).then().then() ​

weixin_45092437的博客 1921

Google ADK前端流式通信实战:从CORS到可中断响应

AI Agent通信已从传统REST API演进为带状态、可中断、渐进式输出的流式交互范式。其底层原理基于application/stream+json MIME类型的分块响应机制,本质是轻量级Streaming RPC,需配合AbortController与ReadableStream精细管理生命周期。技术价值在于实现低延迟UI反馈、资源可控中断、工具调用与结果动态插帧等关键能力。典型应用场景包括React/Vue对话界面、多步骤AI工作流、生产级Agent产品集成。本文聚焦Google ADK(v0.4

weixin_33898233的博客 445

为什么JavaScript是零基础学编程的最佳起点?

JavaScript作为一门动态、解释型脚本语言,凭借其极低的启动门槛、即时反馈机制和浏览器原生运行环境,在编程入门教育中展现出独特优势。它无需编译、不依赖复杂开发配置,仅需打开浏览器控制台即可执行代码,天然契合人类‘动作-反馈-修正’的认知学习路径。其宽松的类型系统、丰富的DOM操作能力与成熟的npm生态,共同构成了一套面向新手的友好型认知缓冲体系。尤其适合非科班转行者、职场提效需求者及教育工作者快速构建可运行的交互原型。本文基于286名真实学员的教学实践,解析JS如何以最小初始摩擦,支撑从‘改一个按钮颜

459

使用async/await解决fetch

返回的是一个promise实例对象,所以它的后面可以跟.then,但是这个.then中触发的成功回调或者失败回调仅仅是判断这个请求是否连接到服务器,并不会返回服务器发送回来的数据。得到一个新的promise,并且return出去,紧跟后面的.then就可以采用链式.then的方法再次获得成功的回调(服务器返回的数据在里面)。当然也要等待它返回一个成功态promise,并将其赋值给data,此时的data就是。这种写法可以使用同步执行的思考来看待这个请求,对于promise的理解更深一步加强。........

bl_ack233的博客 2296

Ghost 作为内容中台 + Next.js 作为渲染层的生产级博客架构

Ghost 是一款成熟的内容管理系统(CMS),其核心价值在于结构化内容建模与所见即所得编辑;Next.js 则是具备服务端渲染(SSR)、静态生成(SSG)和增量静态再生(ISR)能力的现代 React 框架。二者结合的本质,是将 CMS 降维为标准化 RESTful 内容 API 服务,而前端框架升维为动态内容编排与 SEO 全链路实现平台。这种解耦架构显著提升开发可控性、运维稳定性与内容更新实时性,广泛适用于技术博客、企业文档站、数字出版等需兼顾内容生产力与前端工程化的场景。本文聚焦 Ghost Co

weixin_30565327的博客 636

JavaScript 入门:给 Python 开发者的快速指南

本文为Python开发者快速上手JavaScript的实用指南。核心要点包括:优先使用const/let声明变量;注意JS特有的真值判断规则(如空数组为真);推荐使用严格相等===;掌握箭头函数和对象方法;熟练运用数组方法map/filter/reduce;了解解构赋值和展开运算符。异步编程部分对比了JS的Promise与Python协程的异同,强调事件循环机制。最后提供Node.js环境配置建议,帮助读者快速写出可运行的前端或Node项目代码。

weixin_46253270的博客 269

深入解析Playwright底层架构:从协议通信到实战优化

浏览器自动化是现代软件开发和测试中的关键技术,它通过模拟用户操作实现网页交互自动化。其核心原理基于客户端-服务器架构,利用开发者工具协议(如CDP)或专用协议与浏览器内核通信,实现对页面导航、元素操作和网络请求的精准控制。这一机制的技术价值在于提供了跨浏览器、跨语言的一致性和稳定性,尤其适用于大规模数据采集、自动化测试和复杂Web应用交互等场景。在Playwright框架中,通过深入理解其底层访问机制,开发者可以更好地应对动态内容加载、反爬策略和性能优化等挑战,例如利用路由(Route)进行网络请求拦截和修

weixin_34068198的博客 346

纯原生JavaScript构建PWA:从manifest到Service Worker手写实践

PWA(渐进式Web应用)是一种基于标准Web技术实现类原生体验的架构范式,其核心依赖manifest.json声明元信息与Service Worker接管网络和缓存。原理上,manifest定义安装行为与启动外观,Service Worker作为独立线程实现离线可用、资源预缓存与请求拦截,二者共同支撑PWA的可靠性、性能与用户粘性。该技术价值在于无需App Store分发即可获得桌面/主屏幕入口,并在弱网或断网场景下保障基础功能——尤其适用于医疗、政务、工业等对部署轻量性与环境兼容性要求严苛的领域。本文聚

dflkg8956的专栏 418

异步I/O实战:Python高性能Web服务优化指南

异步I/O是现代Web服务应对高并发I/O等待的核心机制,其本质是利用事件循环(如epoll/kqueue)替代线程阻塞,实现单线程内高效调度成千上万网络/数据库/磁盘请求。相比多线程模型,它显著降低内存开销与上下文切换成本,尤其适配Python生态中FastAPI、asyncpg、httpx、aioredis等原生异步工具链。技术价值在于提升QPS、压降P95延迟、增强系统吞吐稳定性,广泛应用于电商秒杀、实时数据看板、物联网平台等I/O密集型场景。本文聚焦真实项目中的异步I/O落地实践,涵盖连接池调优、H

weixin_33907511的博客 370

Vivado新手必看:5分钟搞定FPGA程序固化到Flash(附MCS文件生成全流程)

本文为FPGA新手详细解析了如何将程序固化到Flash存储器的完整流程。核心在于理解SRAM工艺FPGA断电易失的特性,并利用Vivado工具将比特流文件转换为Flash可识别的MCS文件。文章重点拆解了生成MCS文件的关键配置步骤、硬件连接要点,以及通过JTAG烧写Flash的实战操作,并提供了常见启动失败问题的排查清单,帮助开发者实现设计从调试到产品部署的关键跨越。

weixin_29230901的博客 352

浏览器JavaScript调试:从console到内存泄漏的全链路实战

JavaScript调试不仅是定位语法错误,更是对浏览器运行时机制的深度认知——涵盖事件循环调度、内存管理、异步执行上下文与跨环境兼容性等核心原理。掌握console高级用法(如group/table/assert)、debugger条件断点与日志断点、Heap Snapshot内存分析及Network Timing诊断,能显著提升在Chrome、Safari及微信WebView等多端环境下的问题定位效率。本文聚焦真实项目高频场景,如无报错白屏、pending请求、内存持续增长等,提供可验证、可迁移的调试心

weixin_34122810的博客 358

详解MegatronLM序列模型并行训练(Sequence Parallel)

MegatronLM的第三篇论文是2022年出的。在大模型训练过程中显存占用过大往往成为瓶颈,一般会通过recomputation重计算的方式降低显存占用,但会带来额外的计算代价。这篇论文提出了两种方法,分别是和,这两种方法和Tensor并行是可以相结合的,可以有效减少不必要的计算量。下图中绿色部分表示不同模型中需要用于保存activation需要的显存大小,蓝色部分表示不同模型中需要用于保存parameter和optimizer state需要的显存大小。红色线表示A100的显存大小80G。

分享机器学习、深度学习、分布式计算、MLSys相关领域知识 1万+

关于三维全波电磁场仿真软件CST的安装和问题解决

百度网盘链接:https://pan.baidu.com/s/1RgWr8Qau1EzSOlh29SewFQ提取码:fzza这里是2023版本的CST,需要其他版本的uu们可以去官网或者其他人的网盘下载。

weixin_60728441的博客 3609
上一篇: 深刻理解Vue中的组件 (为了生存不得不学Vue)
下一篇: 聊聊数学期望
xosg
xosg 领域专家: 网络协议与安全技术领域 领域专家: 网络协议与安全技术领域
博客等级 码龄9年 1986粉丝 864原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

xosg

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

