


👉 这是一个或许对你有用的社群
🐱 一对一交流/面试小册/简历优化/求职解惑,欢迎加入「芋道快速开发平台」知识星球。下面是星球提供的部分资料:
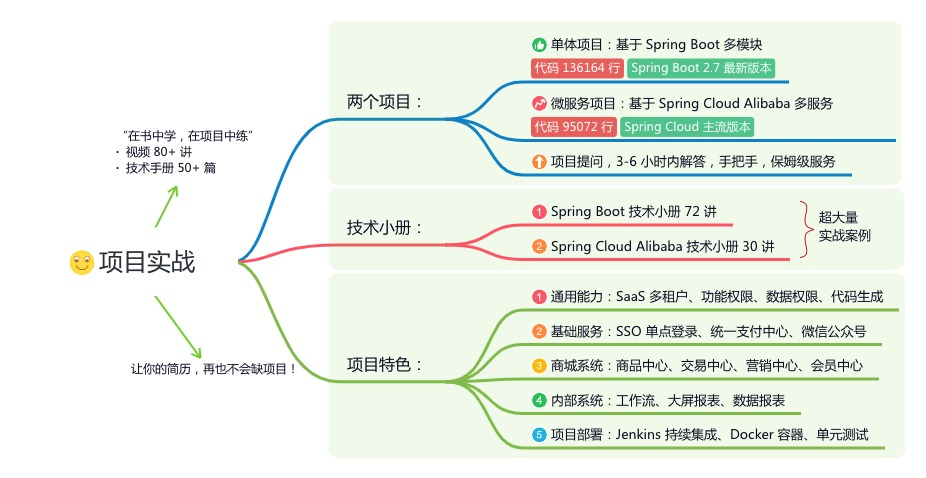
《项目实战(视频)》:从书中学,往事上“练”
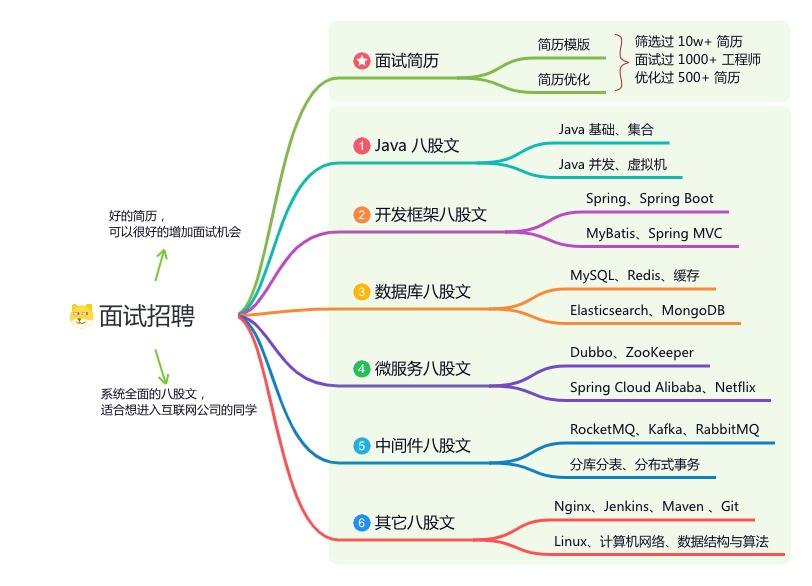
《互联网高频面试题》:面朝简历学习,春暖花开
《架构 x 系统设计》:摧枯拉朽,掌控面试高频场景题
《精进 Java 学习指南》:系统学习,互联网主流技术栈
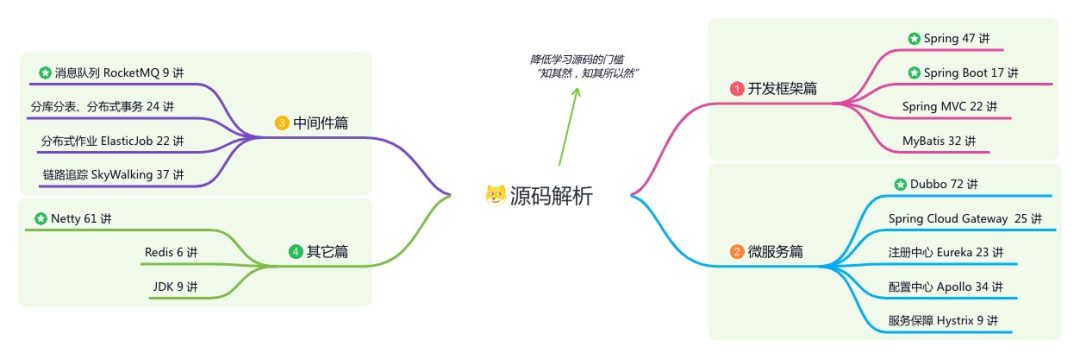
《必读 Java 源码专栏》:知其然,知其所以然
👉这是一个或许对你有用的开源项目
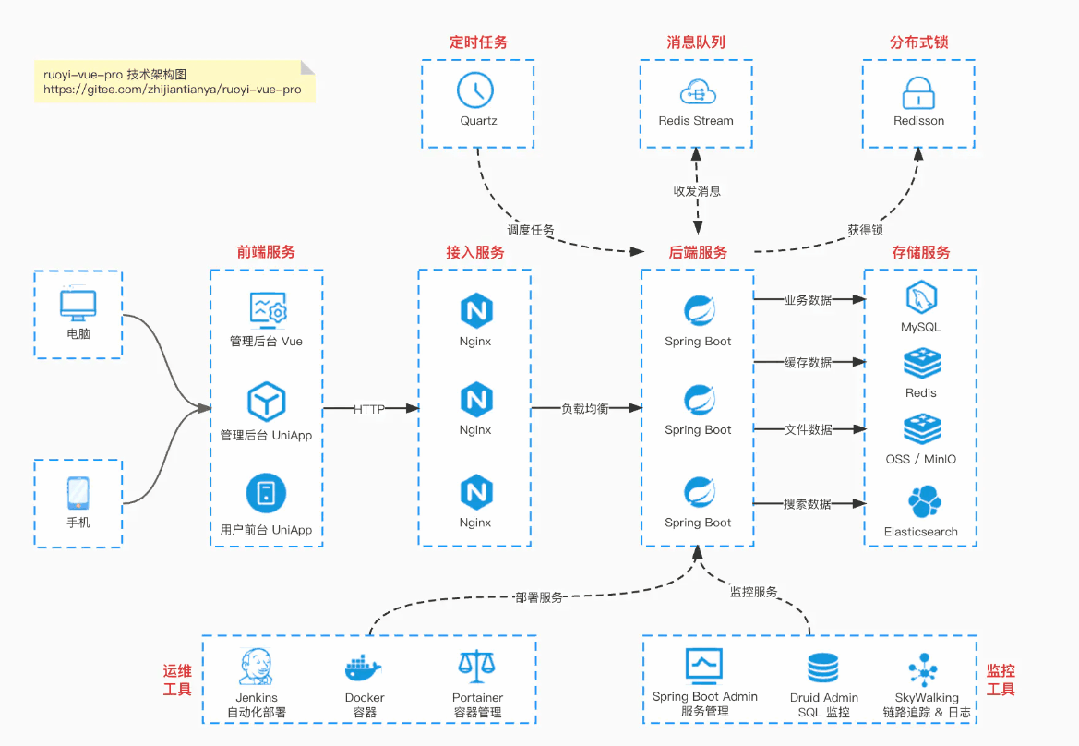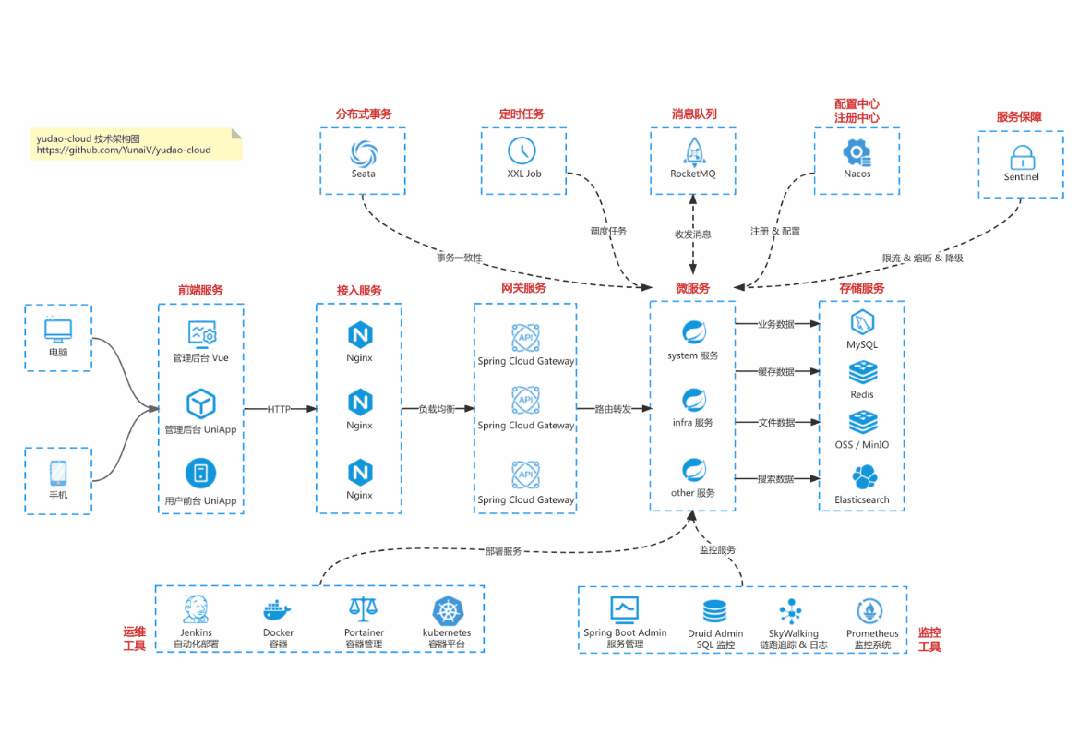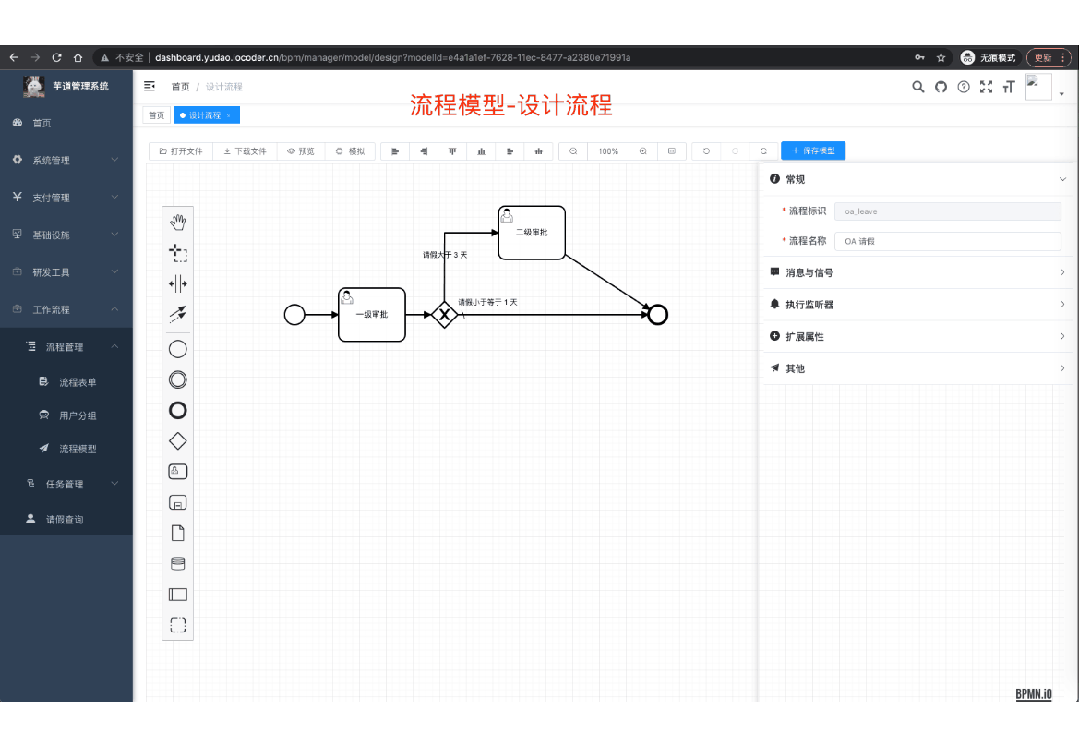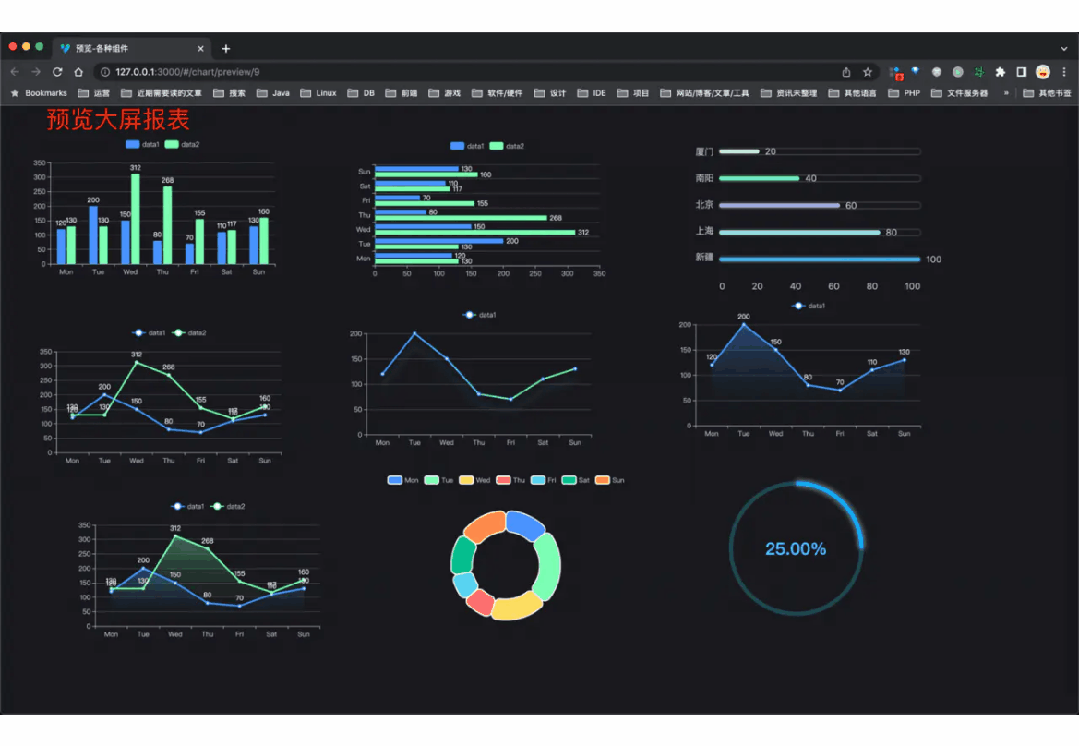
国产 Star 破 10w+ 的开源项目,前端包括管理后台 + 微信小程序,后端支持单体和微服务架构。
功能涵盖 RBAC 权限、SaaS 多租户、数据权限、商城、支付、工作流、大屏报表、微信公众号、CRM 等等功能:
Boot 仓库:https://gitee.com/zhijiantianya/ruoyi-vue-pro
Cloud 仓库:https://gitee.com/zhijiantianya/yudao-cloud
视频教程:https://doc.iocoder.cn
【国内首批】支持 JDK 21 + SpringBoot 3.2.2、JDK 8 + Spring Boot 2.7.18 双版本
一、背景
预约业务是 vivo 游戏中心的重要业务之一。由于历史原因,预约业务数据表与其他业务数据表存储在同一个数据库中。当其他业务出现慢 SQL 等异常情况时,可能会直接影响到预约业务,从而降低系统整体的可靠性和稳定性。为了尽可能提高系统的稳定性和数据隔离性,我们迫切需要将预约相关数据表从原来的数据库中迁移出来,单独建立一个预约业务的数据库。
基于 Spring Boot + MyBatis Plus + Vue & Element 实现的后台管理系统 + 用户小程序,支持 RBAC 动态权限、多租户、数据权限、工作流、三方登录、支付、短信、商城等功能
项目地址:https://github.com/YunaiV/ruoyi-vue-pro
视频教程:https://doc.iocoder.cn/video/
二、方案选型
常见的迁移方案大致可以分为以下几类:
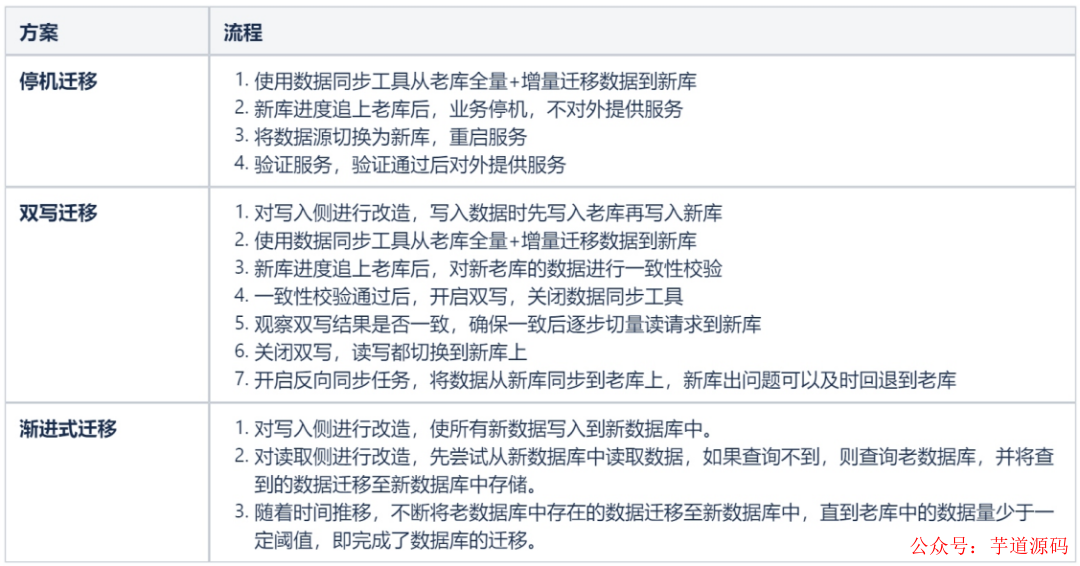
而预约业务有以下特点:
读写场景多,频率高,在用户预约/取消预约/福利发放等场景均涉及到大量的读写。
不可接受停机,停机不可避免的会造成经济损失,在有其他方案的情况下不适合选择此方案。
大部分的场景能接受秒级的数据不一致,少部分不能。
结合这些特点,我们再评估下上面的方案:
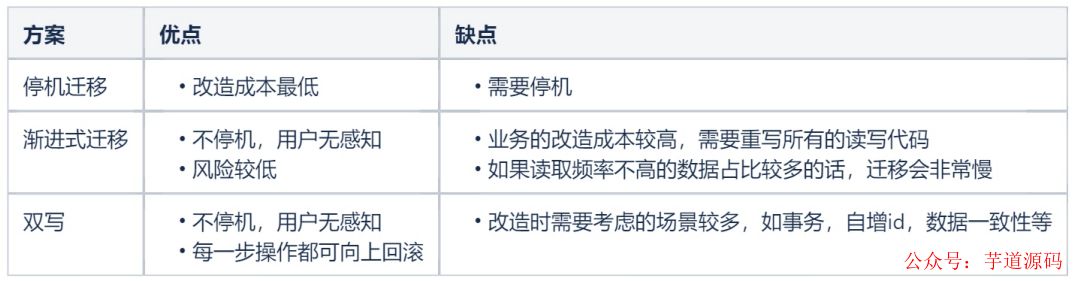
停机迁移方案需要停机,不适用于预约场景。预约场景存在不活跃的用户数据,如果用渐进式迁移方案的话很难迁移干净,可能还需要再写一个迁移任务来辅助完成迁移。而双写方案最大的优势在于每一步操作都可向上回滚,能尽可能的保证业务不出问题。
因此,最终选择的是双写方案。预约业务涉及到的读写场景多,每一个场景单独进行改造的成本大,采用 Mybatis 插件来实现迁移所需的双写等功能,可以有效降低改造成本。
基于 Spring Cloud Alibaba + Gateway + Nacos + RocketMQ + Vue & Element 实现的后台管理系统 + 用户小程序,支持 RBAC 动态权限、多租户、数据权限、工作流、三方登录、支付、短信、商城等功能
项目地址:https://github.com/YunaiV/yudao-cloud
视频教程:https://doc.iocoder.cn/video/
三、前期准备
3.1 全量同步&增量同步&一致性校验
这几步使用了公司提供的数据同步工具。全量同步基于 MySQLDump 实现;增量同步基于 binlog 实现;一致性校验通过在新老库各选一个分块,然后聚合列数据计算并对比其特征值实现。
3.2 代码改造
引入了新库,那自然就需要在项目里新建数据源,并创建表对应的 Mybatis Mapper 类。这里有一个小细节需要注意,Mybatis 默认的 BeanNameGenerator 是
AnnotationBeanNameGenerator,它会使用类名作为 BeanName 注册到 Spring 的 ioc 容器中,Spring 启动时如果发现有了两个重名 Bean 就会启动失败,笔者这里给 Mybatis 设置了一个新的 BeanNameGenerator ,使用类的全路径名作为 BeanName 解决了问题。
public class FullPathBeanNameGenerator implements BeanNameGenerator {
    @Override
    public String generateBeanName(BeanDefinition definition, BeanDefinitionRegistry registry) {
        return definition.getBeanClassName();
    }
}
还有一点是主键 id,本次预约迁移需要保证新老库主键 id 一致,预约业务没做分库分表,id 都是直接用 MySQL 的自增 id,没有用 id 生成器之类的中间件。因此插入新表时只需要使用插入老表后 Mybatis 自动设置好的 id 即可,这次迁移前先检查了一遍业务代码,确保插入语句都用了 Mybatis 的 useGeneratedKeys 功能来自动设置 id。
3.3 插件实现
Mybatis 插件可以拦截 SQL 语句执行过程中的某一点进行干预和处理,而 Executor 是 Mybatis 中负责执行 SQL 语句的核心组件。我们可以对 Executor 的 update 和 query 方法进行代理以实现迁移所需的功能。
插件需要为读写场景分别实现以下功能:
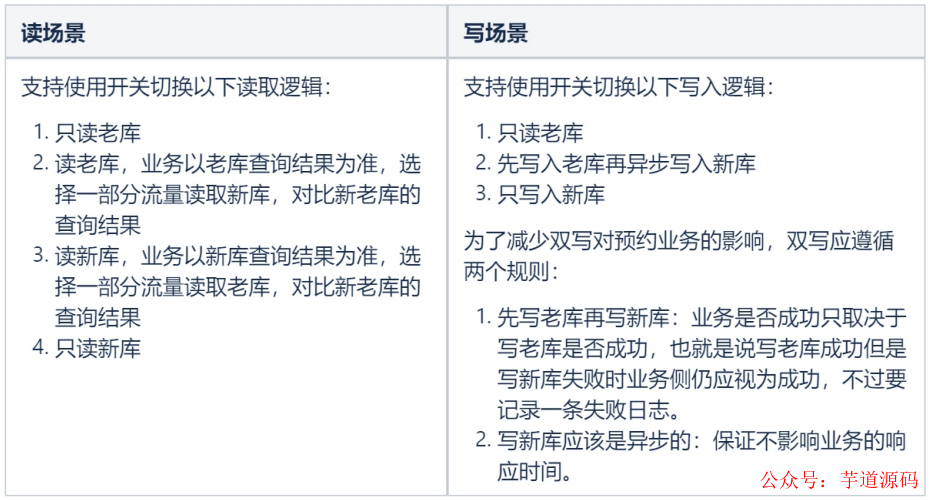
考虑到开关切换部分的代码逻辑较为简单,因此在下文中,笔者将不再过多介绍该部分的具体实现,而是着重介绍如何在插件中使用老库的执行语句来访问新的数据库。此外,代码里会涉及到 Mybatis 相关的一些概念,由于网上已经有较多详尽的资料,这里就不再赘述。
迁移插件代理了 Executor 的 query 和 update 方法,首先在插件里获取到当前执行的 SQL 语句所在的 Mapper 路径。
@Intercepts(
        {
                @Signature(type = Executor.class, method = "update", args = {MappedStatement.class, Object.class}),
                @Signature(type = Executor.class, method = "query", args = {MappedStatement.class, Object.class, RowBounds.class, ResultHandler.class}),
                @Signature(type = Executor.class, method = "query", args = {MappedStatement.class, Object.class, RowBounds.class, ResultHandler.class, CacheKey.class, BoundSql.class}),
        }
)
public class AppointMigrateInterceptor implements Interceptor {

    @Override
    public Object intercept(Invocation invocation) throws Throwable {

        Object[] args = invocation.getArgs();
        // Mybatis插件代理的Executor的update或者query方法,第一个参数就是MappedStatement
        MappedStatement ms = (MappedStatement) args[0];
        SqlCommandType sqlCommandType = ms.getSqlCommandType();
        String id = ms.getId();
        // 从MappedStatement id中获取对应的Mapper接口文件全路径
        String sourceMapper = id.substring(0, id.lastIndexOf("."));

        // ...
    }

    // ...
}
得到老库 Mapper 路径后,将其转换为新库 Mapper 路径,再使用 Class.forName 获取到新库 Mapper 类,然后用新库的 sqlSessionFactory 开启 sqlSession,再获取反射调用所需的方法、对象、参数,在新库上执行语句。
protected Object invoke(Invocation invocation, TableConfiguration tableConfiguration) throws NoSuchMethodException, InvocationTargetException, IllegalAccessException {
    // 获取 MappedStatement
    MappedStatement ms = (MappedStatement) invocation.getArgs()[0];

    // 获取 Mybatis 封装好的入参,封装函数 MapperMethod.convertArgsToSqlCommandParam(Object[] args)
    Object parameter = invocation.getArgs()[1];

    // 使用 Class.forName 获取到的新库 Mapper
    Class<?> targetMapperClass = tableConfiguration.getTargetMapperClazz();

    // 使用新库的 sqlSessionFactory 创建 sqlSession
    SqlSession sqlSession = sqlSessionFactory.openSession();
    Object result = null;
    try{
        // 使用新库的 Mapper 路径获取对应的 MapperProxy 对象
        Object mapper = sqlSession.getMapper(targetMapperClass);

        // 将 Mybatis 封装好的参数转换为原始参数
        Object[] paramValues = getParamValue(parameter);

        // 使用 mappedStatement Id 从新库对应的 Mapper 里获取对应的方法
        Method method = getMethod(ms.getId(), targetMapperClass, paramValues);
        paramValues = fixNullParam(method, paramValues);

        // 反射调用新库 Mapper 的方法,本质上执行的是 MapperProxy.invoke
        result = method.invoke(mapper, paramValues);
    } finally {
        sqlSession.close();
    }
    return result;
}

private Object[] fixNullParam(Method method, Object[] paramValues) {
    if (method.getParameterTypes().length > 0 && paramValues.length == 0) {
        return new Object[]{null};
    }
    return paramValues;
}
上述代码里,getMethod 方法负责从新库 Mapper 类里找到对应的方法,以用于后续的反射调用。
private Method getMethod(String id, Class mapperClass) throws NoSuchMethodException {
    //获取参数对应的 class
    String methodName = id.substring(id.lastIndexOf(".") + 1);
    String key = id;
    // methodCache 用来缓存 MappedStatement 和对应的 Method,避免每次都从 Mapper 里查找
    Method method = methodCache.get(key);
    if (method == null){
        method = findMethodByMethodSignature(mapperClass, methodName);
        if (method == null){
            throw new NoSuchMethodException("No such method " + methodName + " in class " + mapperClass.getName());
        }
        methodCache.put(key,method);
    }
    return method;
}

private Method findMethodByMethodSignature(Class mapperClass,String methodName) throws NoSuchMethodException {
    // mybatis 的 Mapper 内的方法不支持重载,所以这里只要方法名匹配到了就行,不用进行参数的匹配
    Method method = null;
    for (Method m : mapperClass.getMethods()) {
        if (m.getName().equals(methodName)) {
            method = m;
            break;
        }
    }
    return method;
}
得到方法后,还需要得到反射调用所需的参数。Mybatis 执行到 Executor.update/query 方法时,参数已经经过 MapperMethod.convertArgsToSqlCommandParam(Object[] args) 方法封装,不能直接用来执行 MapperProxy.invoke ,需要转换后才可用。下图是MapperMethod.convertArgsToSqlCommandParam(Object[] args) 的封装过程,而下面的 getParamValue 是这个函数的逆过程。
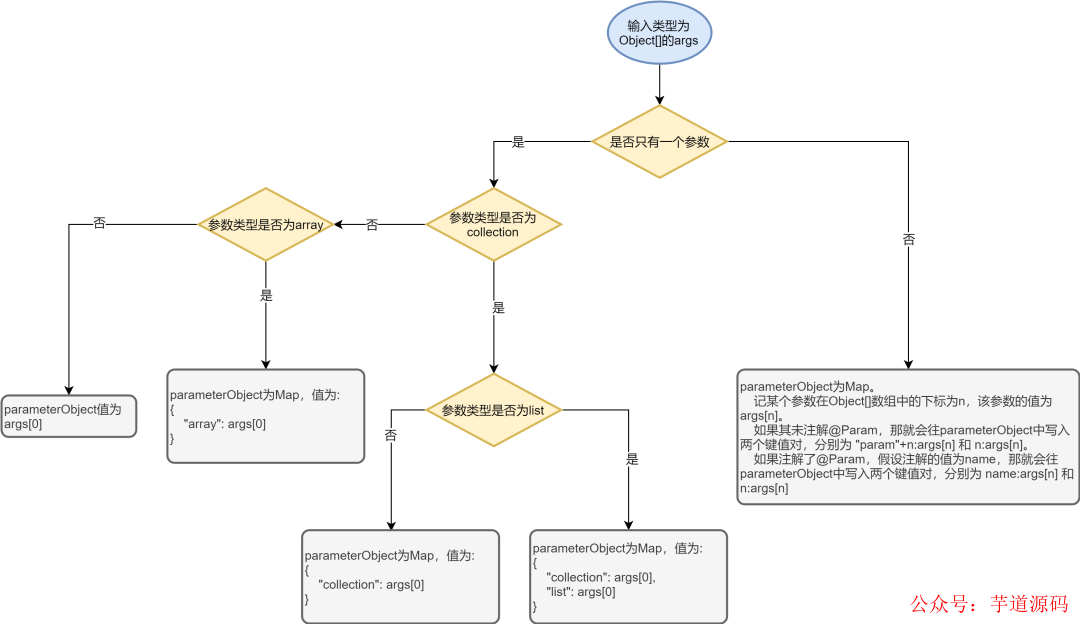
private Object[] getParamValue(Object parameter) {
    List<Object> paramValues = new ArrayList<>();

    if (parameter instanceof Map) {
        Map<String, Object> paramMap = (Map<String, Object>) parameter;
        if (paramMap.containsKey("collection")) {
            paramValues.add(paramMap.get("collection"));
        } else if (paramMap.containsKey("array")) {
            paramValues.add(paramMap.get("array"));
        } else {
            int count = 1;
            while (count <= paramMap.size() / 2){
                try {
                    paramValues.add(paramMap.get("param"+(count++)));
                }catch (BindingException e){
                    break;
                }
            }
        }
    } else if (parameter != null){
        paramValues.add(parameter);
    }
    return paramValues.toArray();
}
(左右滑动查看更多)
通过上述流程,我们就能使用 Mybatis 插件拦截老库的执行过程,实现迁移所需的读写数据源切换/新老库查询结果对比/先写老库再异步写新库等功能。
四、双写流程
4.1 上线双写改造后的业务代码,上线时只读写老库
读开关:只读老库
写开关:只写老库
新老库查询结果对比开关:关
此时业务仍只读写老库。
4.2 使用公司中间件平台提供的数据工具同步老库数据到新库
读开关:只读老库
写开关:只写老库
新老库查询结果对比开关:关
第1步和第2步并没有严格的顺序要求,只要在切换为双写前做完第1步和第2步就好。
条件允许的情况下,全量+增量同步时应选择不对外提供服务的离线从库作为数据源,避免主从延迟等问题对线上业务造成影响。
4.3 停止同步程序,然后开启双写
读开关:只读老库(开启查询结果对比开关)
写开关:双写
新老库查询结果对比开关:开
老库追上新库后,对数据做一次全量校验,避免出现数据不一致的情况。此外还需要开启新老库查询结果对比开关,通过日志监控观察新老库的查询结果是否一致。
停止数据同步和切换双写之间必然有时间差,如果先开启双写再停止数据同步,则可能出现插入重复数据或数据被覆盖的情况。因此需要对数据同步工具和迁移插件进行改造,以处理数据异常的情况,但是这样改造需要处理的情况较多,改造成本较高。所以这里选择先停止同步,再切换到双写,中间丢失的数据使用对比&补偿任务恢复,由于此时仍然全量读老库,所以对业务不会有影响。需要注意的是,双写阶段的时间不应太长,只要确保新老库数据一致就应该前进到下一步。
这一步在实际操作过程中需要注意以下情况:
4.3.1 自增主键
预约业务新库的主键 id 需要和老库保持一致,因此在迁移前检查了一遍业务代码,确保插入语句都用了 Mybatis 的 useGeneratedKeys 功能来返回 id ,这样插入新库时可以直接用设置好 id 的对象。但是这里有一个问题,批量插入时 Mybatis 自动设置的 id 和数据库生成的自增主键不一定完全一致,比如批量 insert ignore 和 on duplicate key update 语句。
这个问题和 useGeneratedKeys 的实现有关,代码可参考
com.mysql.jdbc.StatementImpl#getGeneratedKeysInternal(long) 函数,以下是其执行逻辑:
Mybatis 执行完插入语句后,MySQL 会返回这次插入影响的数据行数,注意,使用 insert ignore 插入时,忽略的那部分数据不会加到影响的行数上。
Mybatis 使用 SELECT LAST_INSERT_ID() 查询这次插入的最小 id 。
Mybatis 循环遍历插入时用的对象列表,循环的最大次数为第1步里获取的这次插入影响的行数,使用 n 代表当前的循环次数,列表中的每个对象的 id 被赋值为 LAST_INSERT_ID() + n*AUTO_INCREMENT 。
举例来说,假设老库的某张表里有数据 b ,其 id=1,此时往该表使用 insert ignore 批量插入三条数据 a,b,c,其在表内的 id 为 a:2、b:1、c:3,返回的影响行数为2,SELECT LAST_INSERT_ID() 返回的是2,因此 Mybatis 往对象里设置的主键分别为 a:2、b:3、c:null,再使用这个设置好 id 的对象列表插入新库时会导致新老库 id 不一致。
解决方案:由于直接删除 ignore 会改变这条 SQL 的语义,无法通过修改语句来解决问题。所以我们只能在迁移插件里跳过这条语句,使其固定写入老库。然后在业务层单独对其进行迁移改造,将插入新库的流程修改为先使用 id 以外的唯一键查询一次老库的数据,获取到 id 以后设置到对象列表里,再插入新库。
4.3.2 事务
预约业务有部分逻辑用到了事务,但这部分逻辑在双写期间均可以暂停功能,因此迁移插件没有实现事务的支持。如果需要支持业务的话可以不依赖插件,在业务层单独对那部分代码进行改造。
4.3.3 异步写入新库引起的问题
双写过程中是异步写新库,需要重点关注是否会有线程安全问题。举例来说,假设有个业务需要往表里插入一个列表,插入完列表后又对列表进行了修改,比如执行了 List.clear() 函数或者其中的对象发生了变更,由于是异步写新库,所以实际的执行流程可能如下:
老库 insert(list)
list.clear()
新库 insert(list)
这会导致新库执行操作时,传入的对象和老库执行操作时不一样,导致新老库数据不一致。建议在迁移前人为的确认业务逻辑,避免异步写入导致新老库数据不一致。
4.4 开启对比和补偿程序,补偿切换开关的过程中遗失的数据
读开关:只读老库(对比开关开启)
写开关:双写
新老库查询结果对比开关:开
对比&补偿任务:开启
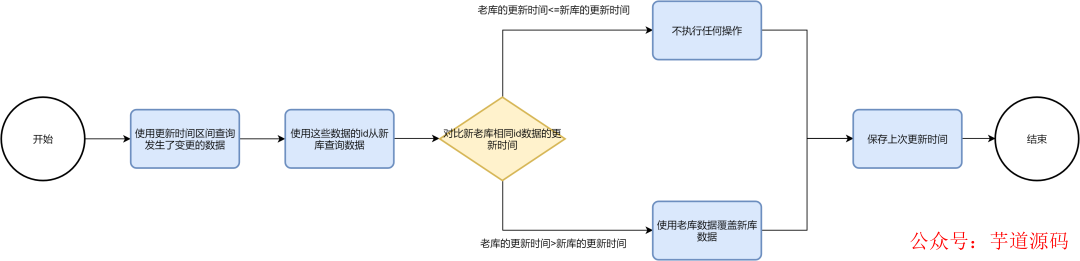
该对比&补偿任务有一个缺陷,其不能处理数据被删除的情况,如果老库里的数据被删除但是新库的数据删除失败,那使用更新时间区间就无法从老库查出这条数据,自然也无法进行对比&补偿。
双写期间,如果出现删老库成功但是删新库失败的情况会有日志告警,所以不会有问题。但是停止数据同步工具 → 开启双写开关这一过程中删除的数据无法补偿。不过大部分业务用的都是逻辑删除,只有一处用了物理删除,笔者在这一处添加了日志,如果切换过程中出现删除数据的日志,就需要手动进行补偿操作。实际操作过程中,开关的切换的耗时较短,只花了30秒左右,在这过程中没有打印删除数据的日志。
4.5 逐步切量请求到新库上
读开关:部分读新库 → 只读新库
写开关:双写
新老库查询结果对比开关:开
对比&补偿任务:开启
双写时,由于数据先写入老库再异步写入新库,因此新库的数据肯定会滞后于老库。如果将一部分读流量切换到新库上,就可能会在一些对延迟要求较高的业务场景中出现问题。对于这种场景,我们不能采用逐步切量的策略,只能同时切换读写开关,将其修改为只写老库+只读新库。
4.6 停止对比补偿程序,关闭双写,读写都切换到新库,开启反向补偿任务
读开关:只读新库
写开关:只写新库
新老库查询结果对比开关:关
对比&补偿任务:开启反向补偿
反向补偿是从新库补偿数据到老库,由于该任务是定时执行,开启后,新库和老库的数据会有 1~2 分钟的延迟,万一写新库的逻辑有问题,可以切回老库。至于为什么用反向补偿任务而不是使用先写新库再异步写老库的策略,是因为双写是用 MyBatis 插件实现的,插件代理的是 excutor 的 update 和 query 方法,如果异步写入老库,有可能会发生以下情况:
假设有两个线程,业务线程 A 需要写入一条数据,迁移插件拦截后,先同步写入新库,写完新库后提交任务给线程 B 中异步写入老库,提交完任务后插件立刻返回。
由于插件已返回结果,executor 上层的 sqlsession 调用 close() 方法关闭 executor (见 org.mybatis.spring.SqlSessionTemplate.SqlSessionInterceptor#invoke ),此时线程 B 可能还没执行完写老库的操作。
线程 B 执行过程中,由于 executor 已经关闭,导致其写老库失败。
因此无法使用 Mybatis 插件来实现异步写老库。
4.7 停止反向补偿任务,删除表迁移相关代码
停止反向补偿前,需要关注是否还有业务在读老库。观察一段时间,确认老库没有补偿任务以外的读写流量后,可以关闭补偿任务,清理迁移过程中产生的代码,清理老库数据。
五、总结
在进行数据表迁移的过程中,虽然遇到了一些问题,但是制定的方案中每一步都有回退措施,即使出现问题也不会影响业务的正常运行。此外,笔者在迁移过程中对各种异常情况进行了监控,能及时发现并解决问题。如果其他业务需要进行类似的迁移,需要关注以下几个方面:
迁移插件实现:在对迁移过程进行反思后,笔者人为通过代理或重写 MapperProxy 的方式来实现迁移插件可能是更加合理的方案。这种方案有两个优点:一方面,可以避免处理 Mybatis 复杂的参数转换流程,从而减少潜在的错误和异常;另一方面,可以实现先写新库再异步写老库的操作。但是这个方案没有经过实践,还不能确定是否有可行性。
自增主键:需要确定业务是否需要保证新老库的 id 一致。
事务:双写过程中应该结合业务考虑是否需要实现事务支持。本次迁移过程中,我们暂停了部分需要事务支持的业务。
异步写入:先写老库再异步写入新库的方式可能导致新老库数据不一致,迁移插件自身无法解决这个问题,只能人工提前排查可能存在的隐患。
欢迎加入我的知识星球,全面提升技术能力。
👉 加入方式,“长按”或“扫描”下方二维码噢:
星球的内容包括:项目实战、面试招聘、源码解析、学习路线。
文章有帮助的话,在看,转发吧。
谢谢支持哟 (*^__^*) 527


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


