Python生成文档向量

文本转化为向量 假如有一句话"I am a student"。用向量来表示每个单词,采用one hot 编码表示方式: I -> [1,0,0,0] am -> [0,1,0,0] a -> [0,0,1,0] student -> [0,0,0,1] 我们会发现两个缺点: (1)单词向量之间的内积为0,它们相互独立。这与实际情况是矛盾的,单词之间是有一定的联系,比如woman与girl,... 阅读详情

1  相关技术

    gensim包

2  生成文档向量模型

import gensim
import numpy as np
from gensim.models.doc2vec import Doc2Vec, LabeledSentence
TaggededDocument = gensim.models.doc2vec.TaggedDocument


def get_corpus():
    with open("../data/embeding_data/seg_test_data.txt", 'r', encoding='utf-8') as doc:
        docs = doc.readlines()
    train_docs = []
    for i, text in enumerate(docs):
        word_list = text.split(' ')
        length = len(word_list)
        word_list[length - 1] = word_list[length - 1].strip()
        document = TaggededDocument(word_list, tags=[i])
        train_docs.append(document)
    return train_docs


def train(x_train, size=100, epoch_num=1):
    model_dm = Doc2Vec(x_train, min_count=1, window=3, vector_size=size, sample=1e-3, negative=5, workers=4)
    model_dm.train(x_train, total_examples=model_dm.corpus_count, epochs=100)
    model_dm.save('../data/models/segmentedWords_test_vectormodel')
    return model_dm


if __name__ == '__main__':
    x_train = get_corpus()
    model_dm = train(x_train)

    代码说明:将分好词(用一个空格隔开)的文本文件放入指定目录,然后就会生成文档模型文件。可以修改具体代码,将读文件、写文件路径和训练参数进行调整。

 3  加载文档向量模型并生成文本文件

import gensim
import numpy as np
from gensim.models.doc2vec import Doc2Vec

model_dm = Doc2Vec.load("../data/models/segmentedWords_test_vectormodel")
np.savetxt('../result/test_features.txt', model_dm.docvecs.vectors_docs)

    生成的文本文件样本如下图所示:
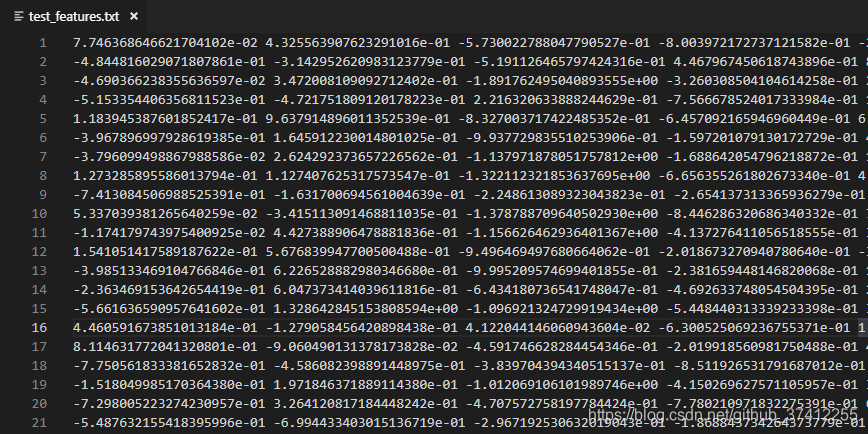
图3.1  文档向量截图


AI代码理解工具:基于AST与向量化的Python项目文档自动生成 代码理解是软件维护与协作的基础能力,其本质是解析程序结构、识别语义关系并推断开发意图。传统方式依赖人工阅读与注释,效率低且易过时;现代方案则结合静态分析(如AST解析)与语义向量化(如Sentence-BERT),将函数签名、调用链和数据流转化为可计算的上下文图谱。这种技术路径显著提升文档生成的准确性与可复现性,支撑README自动构建、架构可视化及可解释的重构建议等工程实践。尤其适用于Python项目维护、技术债治理与新人上手加速等高频场景,代表了AI辅助软件工程从‘问答式交互’迈向‘系统级理解’的关键演 阅读详情

相关推荐

python中的jieba实现对一个文件夹中的所有文档进行分词,根据停用词表去除停用词,基于文档中的非停用词及其TF-IDF值,生成该文档的词向量,具体代码...

这是一个使用 Python 中的 jieba 库来分词,并去除停用词的示例代码: import jieba import os# 首先,需要加载停用词表 with open('stop_words.txt', 'r', encoding='utf-8') as f: stop_words = set([w.strip() for w in f]) # 然后,获取文件夹中的所有文件 fil...

weixin_42577735的博客 701

gensim官方文档实践笔记

文档document 语料库Corpus 语料库作用 语料库预处理 词汇编号 向量Vector 方法1: 特征向量(vector of features) 方法2: doc2bow 模型Model 语料库和向量空间 字符串转向量 语料库流Corpus Streaming 语料库保存 与NumPy/SciPy相互转换 主题和转换 创建转换 转换向量 转换方法 相似性查询 创建语料库 相似性接口 执行查询 Word2Vec 模型 词袋

越开源越幸运 1858

Python实现文本相似度比较分析

创建文档摘要向量之后,可通过比较两个文档摘要向量的距离的方法来判断两个文档的相似度。

Zhangguohao666的博客 1万+

python中文相似度_最准的中文文本相似度计算工具

text2vectext2vec, chinese text to vetor.(文本向量化表示工具,包括词向量化、句子向量化)Feature文本向量表示字词粒度,通过腾讯AI Lab开源的大规模高质量中文词向量数据(800万中文词),获取字词的word2vec向量表示。句子粒度,通过求句子中所有单词词嵌入的平均值计算得到。篇章粒度,可以通过gensim库的doc2vec得到,应用较少,本项目不实...

weixin_39719732的博客 2912

1.43 NativeRAG实战:无需复杂框架,用Python实现基础RAG系统

本文介绍了如何用纯Python实现基础的RAG(检索增强生成)系统,避免使用复杂框架。文章首先展示了NativeRAG的架构流程,包括文档处理、向量化、存储和检索等环节。然后详细讲解了核心实现代码:1)文档处理器实现文本加载和分块;2)基于TF-IDF的简易向量化器;3)向量存储和检索系统,使用余弦相似度计算匹配度。这种轻量级实现有助于深入理解RAG的核心原理,适合学习和小规模应用场景。

yonggeit的博客 3937

大模型落地的实战解析:在Python中使用LangChain实现多向量信息检索的高级技巧

摘要向量化是另一种有效的方法。通过为每个文档生成摘要并对摘要进行向量化,我们可以在保持文档原有语义的同时,更加高效地进行信息检索。# 初始化LLM# 生成摘要链chain = (| llm# 为文档生成摘要# 将摘要添加到向量存储中在这个示例中,我们首先使用LLM生成文档的摘要,然后对这些摘要进行向量化处理。通过这种方法,我们可以在查询时返回更为精准的检索结果。在本文中,我们详细探讨了如何在Python中使用LangChain框架,通过多向量生成和检索技术实现更为精准的信息检索。

m0_57781768的博客 322

自然语言处理之Doc2Vec的原理和使用

摘要:本文主要描述了一种文章向量(doc2vec)表示及其训练的相关内容,并列出相关例子。两位大牛Quoc Le 和 Tomas Mikolov(搞出Word2vec的家伙)在2014年的《Distributed Representations of Sentences and Documents》所提出文章向量(Documents vector),或者称句向量(Sentences vector)...

永远飞翔的鸟 3100

基于OFDM的实时图像传输系统MATLAB仿真:MPSK与MQAM调制性能对比与误码率分析

本文详细介绍了基于OFDM的实时图像传输系统在MATLAB中的仿真实现,重点对比了MPSK与MQAM调制方式的性能差异与误码率分析。通过搭建OFDM系统模型,探讨了QPSK和16QAM在不同信道条件下的表现,包括频谱效率、抗噪能力和误码率等关键指标。文章还提供了MATLAB代码示例和实用技巧,帮助读者快速掌握OFDM图像传输系统的核心算法与优化方法。

weixin_29064009的博客 355

python将一列数据转换成向量_python读取csv和txt数据转换成向量的实例

最近写程序需要从文件中读取数据,并把读取的数据转换成向量。查阅资料之后找到了读取csv文件和txt文件两种方式,下面结合自己的实验过程,做简要记录,供大家参考:1、读取csv文件的数据import csvfiltpath = "data_test.csv"with open(filtpath,'r') as csvfile:reader = csv.reader(csvfile...

weixin_42523260的博客 1100

单细胞转录组肿瘤细胞识别:inferCNV与CopyKAT实战解析

单细胞转录组测序(scRNA-seq)是解析肿瘤微环境的重要技术,但如何从海量细胞中准确区分恶性细胞与正常细胞,始终是数据分析的关键难题。传统marker注释在异质性肿瘤中常失效,而基于拷贝数变异(CNV)的推断方法为这一问题提供了更稳健的解决路径。CNV通过检测染色体大片段的增益或缺失,可在无先验标记的情况下识别恶性细胞,尤其适合实体瘤研究。inferCNV利用染色体滑动窗口分析相对表达量,生成直观的CNV热图;CopyKAT则结合高斯混合模型对每个细胞直接分类,输出肿瘤/正常/非整倍体标签。本文从原理出

weixin_31236101的博客 250

ESP32-C3芯片通过蓝牙控制开锁功能

定义BLE服务和特征,用于接收开锁命令。0x00FF// 服务UUID0xFF01// 特征UUID4// 句柄数量// 特征值// 特征属性// 处理GATT服务器事件// 处理事件(详细代码见下文)// 注册GATT回调if (ret) {return;// 创建GATT服务器。

m0_46145044的博客 921

python中的jieba实现对一个文件夹中的所有文档进行分词,基于文档中的非停用词及其TF-IDF值,生成该文档的词向量,具体代码...

对于一个文件夹中的所有文档进行分词,需要首先使用os模块来遍历文件夹内的所有文件。然后,对于每一个文件,使用jieba库的相关功能来对文件内的文本进行分词。 下面是一个参考代码: import os import jieba# 读取文件夹中的所有文件 for file in os.listdir(folder_path): # 打开文件 with open(file, 'r', e...

weixin_42601547的博客 999

【2024-06-21】网易互娱秋招实习笔试三道编程题解

恭喜发现宝藏!搜索公众号【TechGuide】回复公司名,解锁更多新鲜好文和互联网大厂的笔经面经。作者@TechGuide【全网同名】

试问道几许 1055

python中的jieba实现对一个文件夹中的所有文档,基于文档中的非停用词及其TF-IDF值,生成该文档的词向量,具体代码

你可以使用 Python 的 os 模块来遍历文件夹中的文件,并使用 jieba 库来分词和去除停用词。你还可以使用 scikit-learn 库中的 TfidfVectorizer 类来计算每个文档的 TF-IDF 值。这里是一个示例代码: import os import jieba import jieba.analysefrom sklearn.feature_extraction.tex...

weixin_35753431的博客 338

第10集:AIOps 平台架构设计!画出面试官最想看的系统全景图

本文介绍了如何将AIOps平台的六大功能模块整合为四层架构设计,并生成专业系统全景图。文章首先指出面试中架构设计能力的重要性,强调一张清晰的架构图能直观展现全局观。随后指导读者检查项目结构,准备绘图环境。核心部分详细拆解了四层架构:数据采集层(Prometheus、ELK等)、AI分析层(巡检、告警、预测等)、决策执行层(工作流引擎、自愈Agent)和展示交互层(API、控制台)。通过Python代码自动生成模块依赖关系图,并提供了面试讲解技巧。全文旨在帮助开发者在面试中系统性地展示项目架构设计能力。

qq_2937655951的博客 93

PCL 快速均匀下采样

快速均匀下采样 是一种点云降采样技术,通过设置采样步长来实现等距降采样,从而减少点的数量。用户可以通过指定步长,选择每隔一定数量的点采样一个点,这样可以在保持点云几何特性的同时,显著减少点的数量。

纵马踏花向自由 870

python 文档比对

python相关学习资料:https://edu.51cto.com/video/3832.htmlhttps://edu.51cto.com/video/4645.htmlhttps://edu.51cto.com/video/1158.htmlPython 文档比对入门指南 作为一名刚入行的开发者,你可能会遇到需...

weixin_37993018的博客 167

基于Dijkstra算法的共享单车调度优化系统设计与实现

根据最新统计数据,全球共享单车市场规模已超过300亿美元,中国作为最大的共享单车市场,日订单量超过5000万次。Dijkstra算法由荷兰计算机科学家Edsger W. Dijkstra于1956年提出,用于解决带权有向图中的单源最短路径问题。本文详细介绍了基于Dijkstra算法的共享单车调度优化系统的设计与实现。本文将详细介绍基于Dijkstra算法的共享单车调度优化系统的设计与实现,采用Java 17、Spring Boot 3.x等最新技术栈。

2201_76125393的博客 618

LangChain实战:5分钟用Python打造一个智能文档问答机器人(附完整代码)

本文详细介绍了如何使用LangChain和Python在5分钟内构建一个智能文档问答机器人,涵盖从环境准备、文档加载与预处理、向量知识库构建到问答链实现的完整流程。通过RAG技术,该方案能显著提升企业知识管理效率,适用于金融、医疗等多个行业。

silver的专栏 804

OpenOCD入门到精通:第 0 章 教程导读

摘要:本教程是OpenOCD嵌入式调试工具的完整指南,适合从新手到资深工程师的学习需求。内容涵盖基础配置、调试技巧、Flash编程、TCL脚本自动化、源码解析和二次开发,共8大部分30章。教程提供5种学习路线,可根据角色和目标灵活选择,配套资源包含示例代码和配置文件。通过系统学习,读者将掌握OpenOCD从使用到扩展的全套技能,成为嵌入式调试领域的专家。

从事嵌入式linux android驱动开发,拥有全栈能力 1940

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

基于Python的RAG全流程实战:从文档处理到智能问答

提取内容try:# 获取请求数据和会话 IDreturn JsonResponse({'error': '缺少消息内容'}, status=400)return JsonResponse({'error': '缺少会话ID'}, status=400)

qq_64389417的博客 880

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

python kmeans算法文档_Kmeans文档聚类算法实现之python

实现文档聚类的总体思想:将每个文档的关键词提取,形成一个关键词集合N;将每个文档向量化,可以参看计算余弦相似度那一章;给定K个聚类中心,使用Kmeans算法处理向量;分析每个聚类中心的相关文档,可以得出最大的类或者最小的类等;将已经分好词的文档提取关键词,统计词频:#计算每个文档的关键词和词频#关键词统计和词频统计,以列表形式返回defCount(resfile):t={}infile= open...

weixin_42237925的博客 289

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

kmeans聚类算法代码python_Kmeans文档聚类算法实现之python

实现文档聚类的总体思想:将每个文档的关键词提取,形成一个关键词集合N;将每个文档向量化,可以参看计算余弦相似度那一章;给定K个聚类中心,使用Kmeans算法处理向量;分析每个聚类中心的相关文档,可以得出最大的类或者最小的类等;将已经分好词的文档提取关键词,统计词频:#计算每个文档的关键词和词频#关键词统计和词频统计,以列表形式返回defCount(resfile):t={}infile= open...

weixin_39540744的博客 416

从零构建AI文档系统,基于Python的自动化写作全解析

掌握自动化写作核心技术,本教程系统讲解基于Python的AI文档生成方法,涵盖自然语言处理、模板引擎与批量输出等关键应用。适用于报告生成、内容创作等场景,高效精准。完整PythonAI生成文档教程,值得收藏。

GatherTide的博客 882

Python+LangChain+Ollama+Chroma实现RAG问答

Python+LangChain+Ollama+Chroma实现RAG问答

tadexinnian的博客 563

GPT4Readability:面向Python项目的AI代码理解与文档生成工具

Python项目文档缺失与可读性差是开发者长期面临的工程痛点,其本质源于代码语义理解难、上下文整合难、人工补全成本高。基于AST静态解析+向量检索+大模型推理的三层架构,GPT4Readability突破传统LLM单次prompt的上下文瓶颈,实现对整个项目目录的结构化认知;它不依赖人工提问,而是自动构建模块依赖图、提取函数意图、锚定关键代码片段,再驱动GPT-3.5-turbo或GPT-4生成精准README与可落地的重构建议。该方案已验证适用于独立开发、遗留系统维护及教学辅助等典型场景,兼顾技术严谨性与

weixin_30258901的博客 440
上一篇: Java Servlet学习(一)
下一篇: 论文参考文献的.bib文件
评论 6
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


