台大机器学习基石 Lecture 5 - Training versus Testing

RT-Thread网络编程:基于STM32F407的TCP客户端实现(含完整代码解析) 本文详细介绍了在STM32F407平台上,基于RT-Thread操作系统和LWIP协议栈实现工业级可靠TCP客户端的完整过程。内容涵盖底层ETH驱动配置、Socket编程、连接保活与断线重连机制、数据收发协议设计以及资源管理,提供了可应用于实际项目的健壮代码框架与调试技巧。 阅读详情

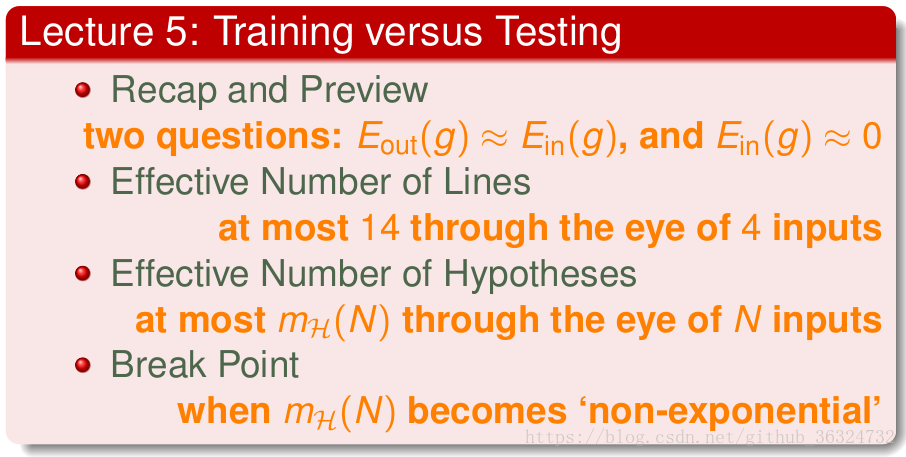
本次Lecture先将之前一部分对“When Can Machines Learn”中的内容梳理了一下,归结为机器学习的两个核心问题:E_{in}(g)\approx E_{out}(g)?E_{in}(g)\approx 0?然后研究在无限hyphothesis set上如何归类,成为一个在有限的M上(也就是m_H(N))的问题,并且试图求出m_H(N),并探讨其什么时候是非指数形式,这样机器学习才有效。

Recap and Preview

我们在之前的课程中得出的结论:只要数据集足够大,hyphothesis有限个,就能证明每个hyphothesis的E_{in}(h) \approx E_{out}(h),从中就能让机器学习算法选出一个最低的E_{in}(h)使之成为g,根据PAC就能知道E_{in}(g)\approx E_{out}(g) \approx 0,从而机器学习是可行的。

B_i

通过上图就能把前4次Lecture的内容串起来,机器学习就分成了两个核心问题——

  • 我们能否保证E_{in}(g)与E_{out}(g)是足够接近的?
  • 我们能否让E_{in}(g)足够小?

那么,对于有限的M来看,当M较小时,坏事情发生的几率很小,但g的选择范围又太小;当M较大时,g的选择范围够大,但坏事情发生的几率又增大了。因此,就算当M是无限大的时候,我们也要选择一个合适的(不太大又不太小)有限的m_H来替代M,然后我们要证明在无限M的前提下学习的可行性,以及如何选择“正确的”hyphothesis set H。

Effective Number of Lines

在推导M个hypothesis的Hoeffding不等式时,我们用到了级联(union bound):

\mathbb{P}\left [ B_1 or B_2or...B_M \right ]\leq \mathbb{P}\left [ B_1 \right ]+\mathbb{P}\left [ B_2 \right ]+...+\mathbb{P}\left [ B_M \right ]

这是基于B_i互相之间是独立的,而他们实际上有交集有重叠的,这位就导致级联over-estimating了。
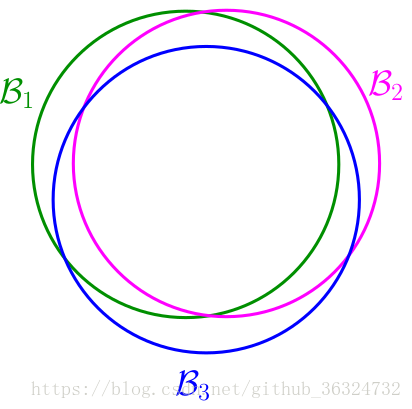
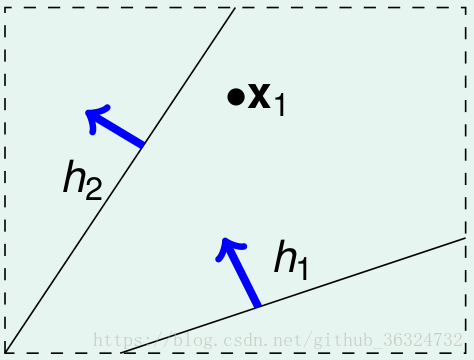
从而我们知道M没有那么大,我们能不能找出重叠部分,将无限的hypothesis set转化为有限个类?

我们看到将data分为相同的+1和-1方法的hypothesis是相似的,这些可以被归为1类。

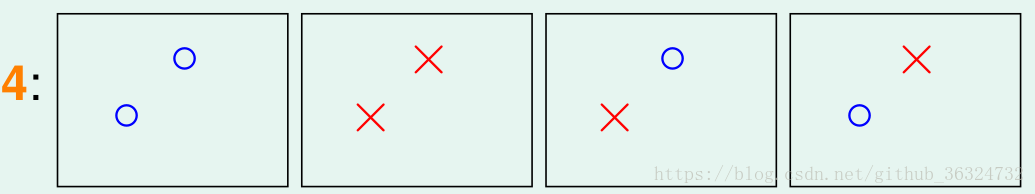
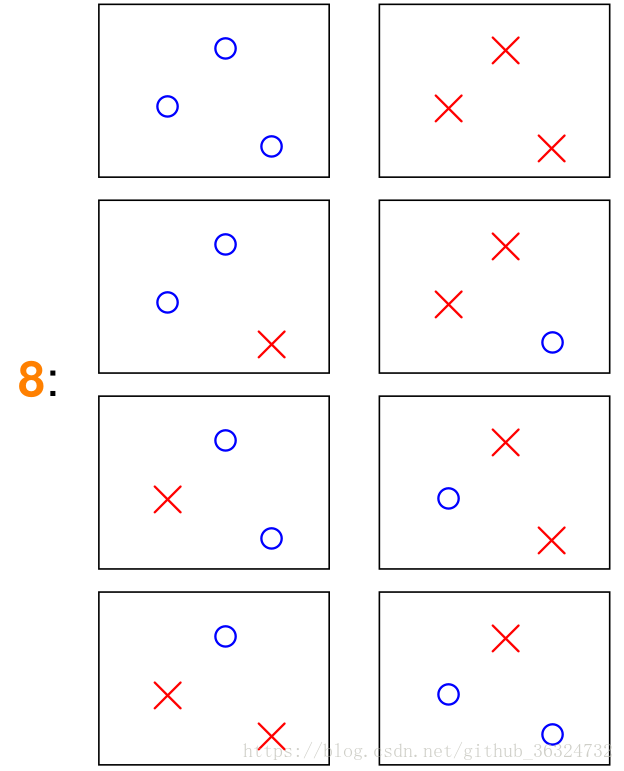
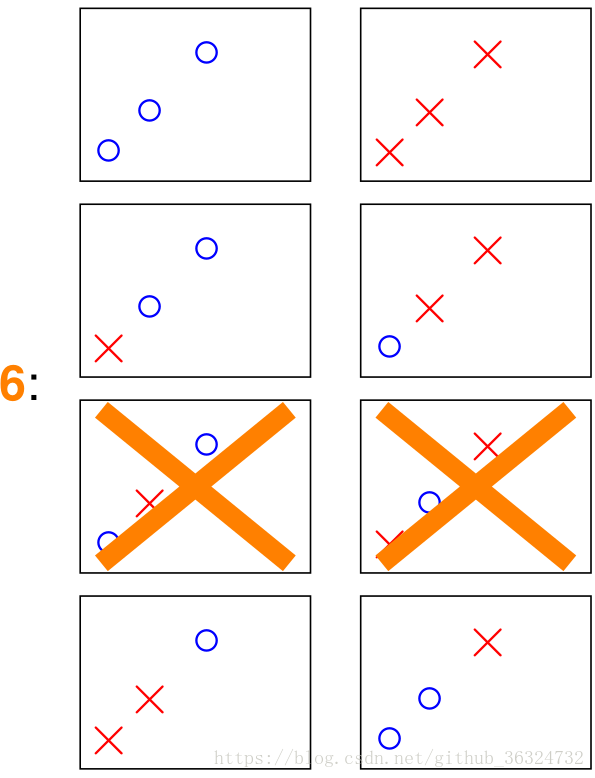
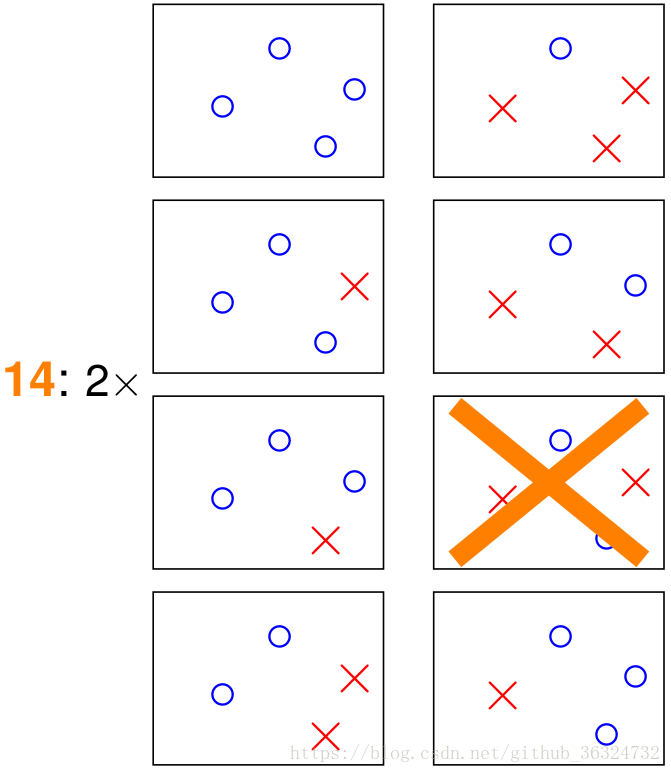
在2D的平面上,hypothesis就是一条直线,那么点的个数和划分方法数对应如下——

点的个数N划分方法数effective(N)图例
12
24
36或8
4\leq 14

显然我们看到在N个输入点的情况下,也每一个点都有两个状态二选一,有效直线的个数\leq 2^N。从而我们看到M显然是有上界为effective(N),那么Hoeffding不等式就能被改写为——

\mathbb{P}[\left | E_{in}(g)-E_{out}(g) \right | > \varepsilon ]\leq 2\cdot effective(N)\cdot exp(-2\varepsilon ^2N)

已知effective(N)\leq 2^N,如果有effective(N)\ll 2^N就能保证在无限多的hypothesis上的机器学习可行。

Effective Number of Hypothesis

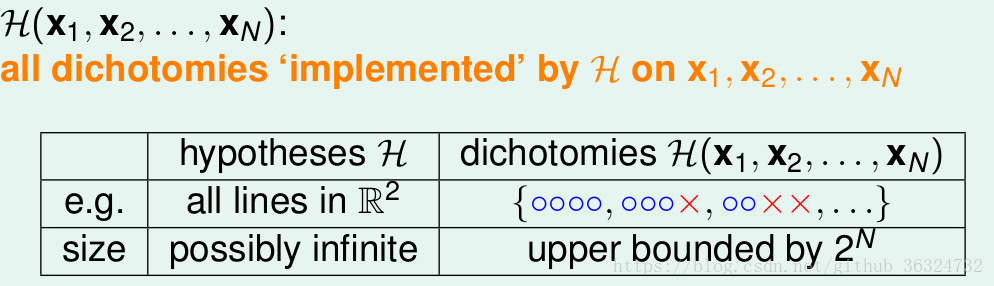
引入一个新的概念dichotomy,就是将空间中的点(例如二维平面)分成正类(蓝色o)和负类(红色x)。

用这种方式来表示每一种hypothesis,数学表达如:H=\{ hypothesis\ h: \chi \rightarrow \{ \times ,\circ \} \}

定义h(x_1,x_2,...,x_N) = (h(x_1),h(x_2),...,h(x_N)) \in \{\times, \circ\}^N来表示一个hypothesis对数据集的分类情况,每个h都是由x_i的情况来表达。对假设集H和H(x_1, x_2, ... , x_N)有如下区别——

我们定义成长函数(Growth Function):m_H(N) = \max \left | H(x_1,x_2,...,x_N) \right |,通过所有(x_1,x_2,...,x_N)所产生的\left | H \right |中的最小值来消除对数据的依赖。其实这个成长函数就是之前effective(N)的最大值。

然后的问题是怎么求成长函数m_H(N)呢?

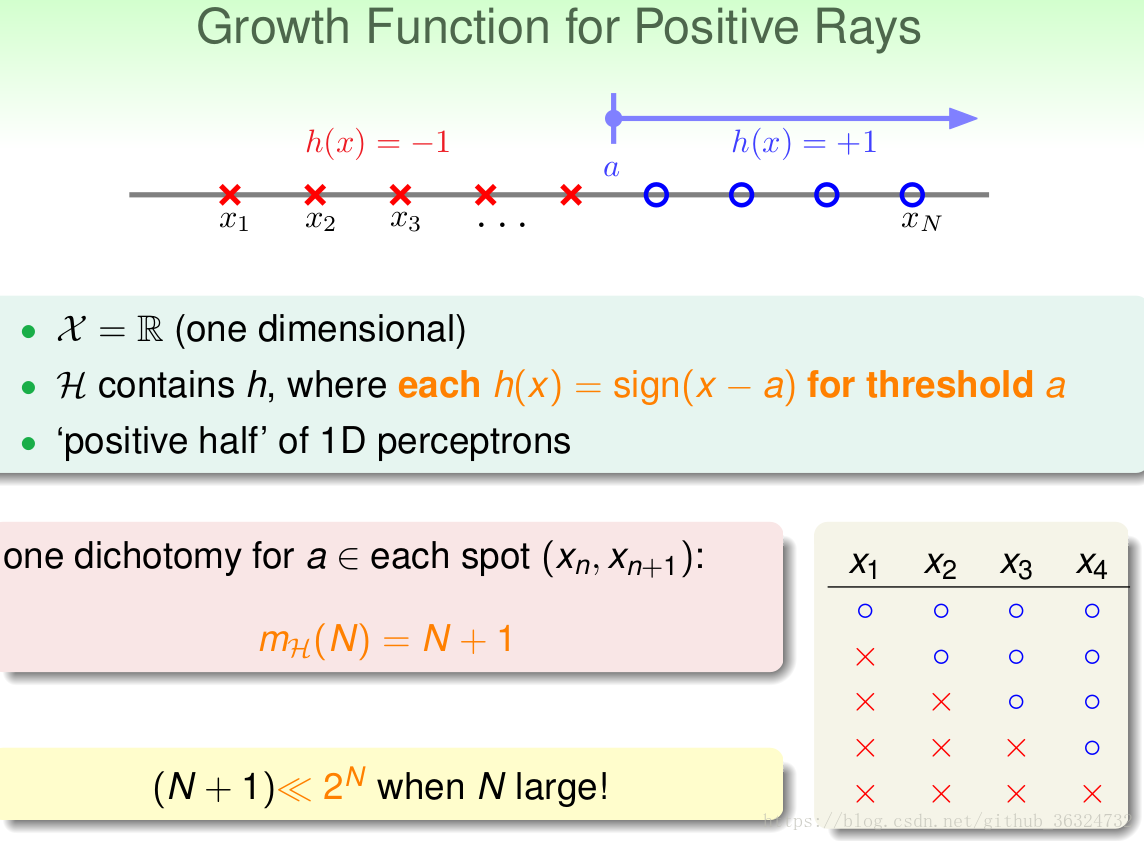
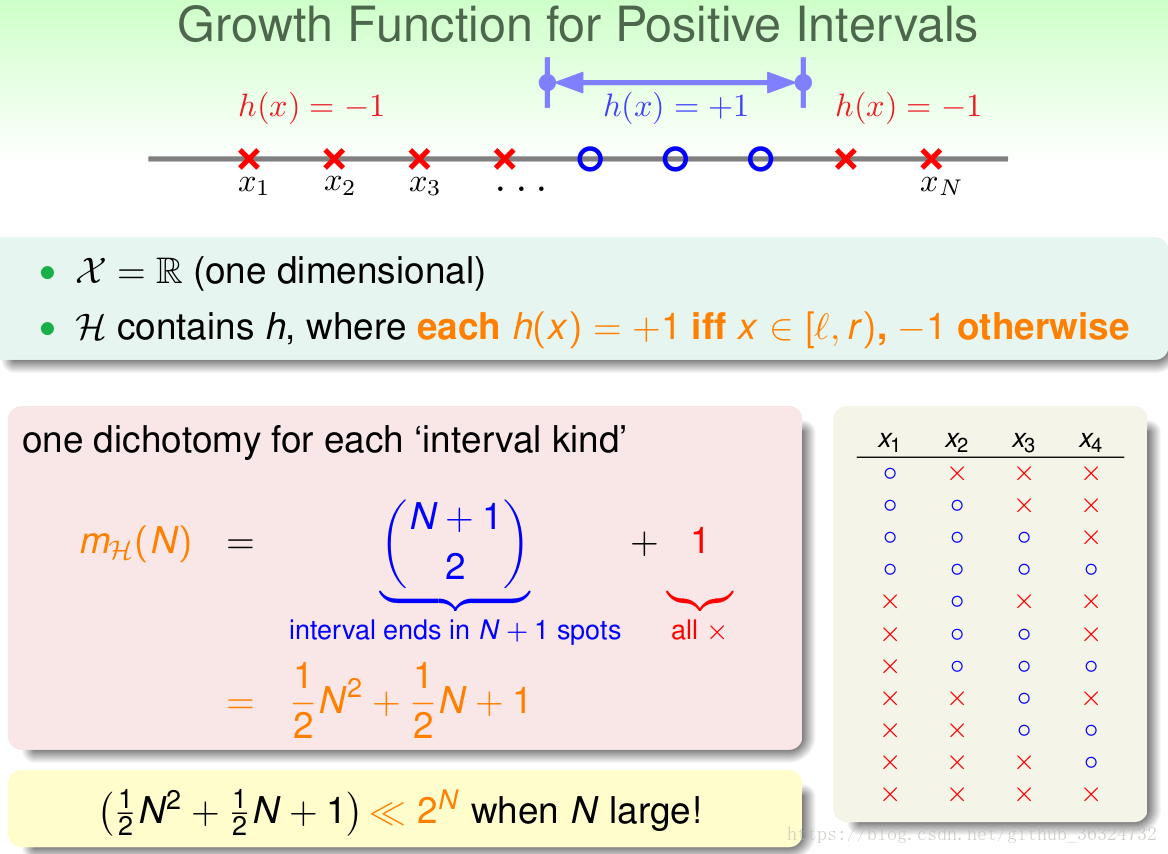
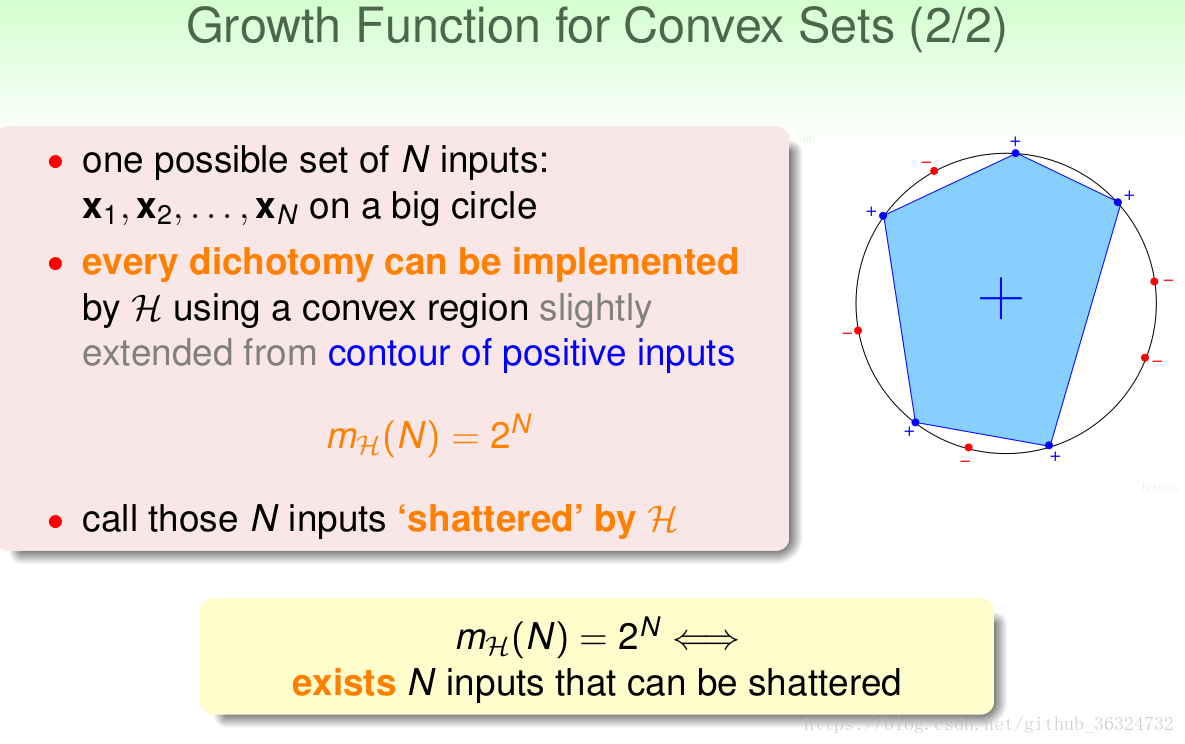
课程中给出了三种具体情况的求解:

也就是在平面上任意多个点,只要能被shatter掉(这个词不知道怎么解释比较好?分散开?),就有m_H(N)=2^N。

总结以下就是——

Typem_H(N)
positive raysN+1
positive intervals\frac{1}{2}N^2+\frac{1}{2}N+1
convex sets2^N

Break Point

从上面我们能看到前两个的m_H(N)是多项式级的,而第三个是指数级的。而我们希望m_H(N)是多项式级的,这样在N增长的时候m_H(N)增长较慢,E_{in}(g)和E_{out}(g)相差很大的几率才能越来越小,这样机器学习才是可行的。

对于2D Perception模型,我们之前证明了N = 3时能shatter,而N = 4时则完全不能,此时就成k = 4为H上的break point,那么k > 4的时候也为break point(显然可以先去掉一些点不满足,加上点后仍然不满足),因而我们只要研究最小的break point就可以了。

以上我们发现,当没有break point时(比如convex sets),m_H(N) = 2^N;当存在break point为k时,是否有m_H(N) = O(2^{k - 1})呢?这一点在positive rays、positive intervals、2D perception模型中都适用,我们对此猜测的证明将在下一节课完成~如果证明成功,我们就能够将m_H(N)代替M,从而机器学习就可行了。


关于红队方面的学习资料 阅读详情

相关推荐

利用OrthoFinder做泛基因家族聚类分析

这条命令会将 Arabidopsis_thaliana.TAIR10.59_longest_trans.pep.fa 文件中的所有序列ID,去掉ID中的空格后面的部分,只保留 > 后第一个空格之前的基因ID,并将结果保存在 An1.fasta 文件中。muscle 是一种常用的多序列比对工具,用于基因组或蛋白质序列的比对。基因家族(Gene family),是来源于同一个祖先,由一个基因通过基因重复而产生两个或更多的拷贝而构成的一组基因,它们在结构和功能上具有明显的相似性,编码相似的蛋白质产物。

qq_64400864的博客 2759

Machine Learning Foundations 笔记:1-5 Traing versus Testing

我思故我在! 408

实战解析:如何利用MDFEND与Weibo21数据集构建多领域假新闻检测系统

本文实战解析了如何利用MDFEND模型与Weibo21数据集构建多领域假新闻检测系统。文章深入剖析了MDFEND的领域门控与专家混合机制,并提供了从数据预处理、模型理解到训练部署的完整指南,旨在解决通用模型在不同领域新闻检测中的性能衰减问题,提升检测的准确性与适应性。

vulkan6gpu的博客 582

《机器学习基石》学习笔记 5 Training versus Testing

上节课,我们主要介绍了机器学习的可行性。首先,由NFL定理可知,机器学习貌似是不可行的。但是,随后引入了统计学知识,如果样本数据足够大,且hypothesis个数有限,那么机器学习一般就是可行的。本节课将讨论机器学习的核心问题,严格证明为什么机器可以学习。从上节课最后的问题出发,即当hypothesis的个数是无限多的时候,机器学习的可行性是否仍然成立? ...

Wolf_xujie的博客 381

Protobuf NDK以及QNX交叉编译

Protobuf 用处很广,尤其是通讯数据序列化,反序列化。TODO。

静虚待令,有物混成 1560

【Konva】解决图形加入group后无法获取到绝对坐标,以及group内绘制新图形坐标偏移的问题

解决konva绘图开发时“图形加入group后坐标不会变动,无法获取到绝对坐标”的问题

近10年前端开发工作经验,为你分享日常经验所得 1500

《机器学习基石》5-Training versus Testing

接着上一篇所讨论的问题,继续讨论。 Recap and Preview 回顾一下机器学习的流程图: 机器学习可以理解为寻找到 ggg,使得 g≈fg≈fg \approx f,也就是 Eout(g)≈0Eout(g)≈0E_{out}(g) \approx 0 的过程。 为了完成这件事情,有两个关键的步骤: 保证 Eout(g)≈Ein(g)Eout(g)≈Ein(g)E_{o...

Eathen的练级之路 383

基于CNN的表情识别(FER)pytorch实现

Report for FER Jian Tang Abstract 我们使用卷积神经网络(CNN)实现了baby的面部表情识别(FER)。 数据上,我们获取了开源FER数据集FER2013[1],besides我们使用爬虫获取了baby相关的人脸图片,进行了手工分类标注以形成一个全新的baby FER数据集。 模型上,我们首先复现了Luan[2]的工作,即参考Kuo[3]在CVPR 2018上的工作并实现一个轻量的CNN网络,在FER2013上进行训练并得到了XXXX%的平均分类准确率(avg a

qq_20241587的博客 3685

Lecture 5:Training versus Testing

Lecture 5:Training versus Testing 参考:https://beader.me/mlnotebook/section2/vc-dimension-one.html 【概括】当M趋于无穷时,考虑如何去限制不等式左面 -> 考虑 增长函数 breakpoint 前四节汇总体系: “什么时候机器学习是可行的” 两个关键问题:训练结果与测试结果类似、让错误足够小 假设集的大小很关键,同时解决两个问题很难 【关键】不等式 第m个方程遇到bad sample为事件,则遇到

weixin_43860935的博客 181

使用DCA1000和EVM板进行数据采集

目录 1. 准备工作 1.1 硬件 1.2 软件 2. 驱动安装 3. 设置静态IP地址 4. 采集数据 5. 采集的数据文件的格式 6. 数据采集存储的数据流 参考资料 1. 准备工作 1.1 硬件 EVM板,电源线(5V,>2.5A),USB线 DCA1000,电源线(5V,>2A),USB线,网线,60pin Samtec cable 1.2 软件 mmWave Studio Matlab Runtime Engine v8.5.1 将DCA1000和EVM板

qq_42235129的博客 1万+

海思图像质量之HiPQTool调试

文章目录一. HiPQTool 界面二. 图像调试三. 将调试参数写入程序中 一. HiPQTool 界面 二. 图像调试 三. 将调试参数写入程序中

lzg2011的博客 2383

机器学习基石 Lecture5: Training versus Testing

机器学习基石 Lecture5 Training versus TestingRecap and PreviewEffective Number of LinesEffective Number of HypothesesBreak Point Recap and Preview 到上一课为止,讲到了机器学习整体的流程。在假设函数空间HHH大小是有限的而且样本DDD数量NNN足够大时,对于任何的算...

无所知的博客 412

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

机器学习基石 5 Training versus Testing

机器学习基石 5 Training versus Testing Recap and Preview 回顾一下机器学习的流程图: 机器学习可以理解为寻找到 \(g\),使得 \(g \approx f\),也就是 \(E_{out}(g) \approx 0\) 的过程。为了完成这件事情,有两个关键的步骤,一个是保证 \(E_{out}(g) \approx E_{in}(g)\),另一个是保证...

weixin_30784945的博客 141

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

机器学习和数据挖掘 第五讲 训练与测试

本章节有些概念还没想清楚用途和目的,暂时参考他人博客。 机器学习和数据挖掘(5):训练与测试 Coursera台大机器学习课程笔记4 – Training versus Testing 机器学习基础(林軒田)笔记之五 ...

leeningzzu的博客 297

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

台大机器学习基石 Lecture 13 - Hazard of Overfitting

本次Lecture主要介绍机器学习中很重要的问题:过拟合(overfitting),并且介绍了部分解决过拟合问题的方法。 What is Overfitting? 先通过一个例子来介绍bad generalization。 假设平面上有5个点,目标函数是2阶多项式: 如果hypothesis是二阶多项式加上一些小的noise的话,那么这5个点很靠近这个hypothesis,很小。 ...

ZayneHuang的博客 1128

台大机器学习基石 Lecture 9 - Linear Regression

这节课开始介绍一些常见算法,这次Lecture介绍了最常见的Linear Regression线性回归算法。 Linear Regression Problem 在Linear Regression模型下的hypothesis为,特征集为d维,加上常数项后就为d + 1维(所以注意i从0开始)。在线性回归中,误差的衡量常采用平方误差(squared error):,相关的记号已经在上一节课...

ZayneHuang的博客 502

台大机器学习基石 Lecture 6 - Theory of Generalization

这节课基于上节课与break point的关联,研究了的上界是否为多项式的问题,得到结论为多项式上界,并将其代入Hoeffding不等式,得到VC Bound,证明只要break point存在,机器学习就是可行的。 Restriction of Break Point 我们先看一下四个成长函数与break point的关系: 成长函数是一个hypothesis在N个数据点上可以产生...

ZayneHuang的博客 369

台大机器学习基石 Lecture 11 - Linear Models for Classification

这次Lecture总结比较了已经学习的三种模型优缺点,引入SGD来优化Logistic Regression,讲解了Multiclass Classification中的OVA和OVO方法。 Linear Models for Binary Classification 之前三种线性模型都是对样本特征x的加权运算,我们引入一个线性得分函数(linear scoring function)s...

ZayneHuang的博客 365

台大机器学习基石 Lecture 7 - The VC Dimension

本次Lecture主要介绍VC Dimension,从non-break point的角度来看之前break point对VC Bound的影响。最终得出结论要选择合适的来同时保证较小的和较低的模型复杂度。 Recap 通过上节课的证明,我们知道了有多项式上界,这是在的条件下的。我们又得到了VC Bound,这是在M无限的前提下的Hoeffding不等式,那么我们将代入VC Bound...

ZayneHuang的博客 360

台大机器学习基石 Lecture 8 - Noise and Error

本次Lecture主要讲了在存在Noise噪声的情况下,是否能够进行机器学习,VC Dimension是否还有作用,并且介绍了一些评价Model的Error度量方法,这是要根据实际问题来确定的。 Noise and Probablistic Target 数据集D存在噪声的情况下,是否还能学习呢? Noise主要来源于以下三种—— 由于人为因素,正类被误分为负类,或者负类被误分为正...

ZayneHuang的博客 344

台大机器学习基石 Lecture 14 - Regularization

本次Lecture主要讲解了解决overfitting问题的方法——Regularization正则化 Regularized Hypothesis Set 我们在上节课知道,当用一个高次的多项式对target function进行拟合的时候,就会出现小而大的情况,这就是过拟合(overfitting)。而当用较低次的多项式进行拟合的时候,就能够得到左边这样比较良好的效果。 于是,这...

ZayneHuang的博客 317

台大机器学习基石 Lecture 16 - Three Learning Principles

本次Lecture介绍了机器学习中比较常用的三个“锦囊妙计”。 Occam's Razor 奥卡姆剃刀定律(Occam’s Razor),总结而言就是“如无必要,勿增实体”,要用尽可能简单且有好效果的方法来处理数据。 那么就有两个问题: 什么样的模型是“简单的”?简单的模型一方面指hypothesis比较简单,也就是模型的参数比较少;另一方面指模型的hypotheses有限不太多。这两者是...

ZayneHuang的博客 304

台大机器学习基石 Lecture 15 - Validation

本次Lecture介绍了通过validation的方法来帮助我们选择模型并在没有测试集的情况下评价模型好坏,保证训练的模型有良好的泛化能力。 Model Selection Problem 上面这幅图就说明,就算是一个最简单的二元分类问题,都要涉及算法A、迭代次数T、步长、特征转换方法、正则regularizer、正则参数这些选择,他们叠加起来会形成不同的机器学习效果,因此我们要找到合...

ZayneHuang的博客 296

台大机器学习基石 Lecture 10 - Logistic Regression

这次Lecture讲的是另一种回归方法——逻辑回归(Logistic Regression),虽然说的是回归问题,但它其实是一个‘软’分类,本次课介绍了逻辑回归的方法、错误衡量方法、求解最优的方法。 Logistic Regression Problem 之前提过的二元分类器如PLA,其目标函数为,,是一个“硬”的分类器。而Logistic Regression的输出是的概率,因此Logi...

ZayneHuang的博客 287

台大机器学习基石 Lecture 2 - Learning to Answer Y/N (PLA)

Perceptron Hypothesis Set Perceptron : 感知机 对于一个假设h(x),结果与权值w和阈值threshold有关。 sign(x)函数表示:sign(x > 0) = +1, sign(x < 0) = -1。 对二元的h(x),形成如下线性分类: 由此,感知机模型成为了一个线性(二分)分类器(linear/binary class...

ZayneHuang的博客 272

台大机器学习基石 Lecture 4 - Feasibility of Learning

这次Lecture主要讨论的是有限假设下的机器学习可行性。我们为什么能通过算法选出的定作,而又为什么一定与相接近呢? Learning is Impossible? 这一部分主要讨论了这么一个问题:能够在数据集上满足的是否一定能有? 上图就说明了,在以外的数据中更接近目标函数是不确定的,而我们希望机器学习能做到所选模型能在数据集之外也有与真实结果一致的预测结果,而不是仅限于数据集中。...

ZayneHuang的博客 270
上一篇: LeetCode 824. Goat Latin
下一篇: 台大机器学习基石 Lecture 6 - Theory of Generalization
ZayneHuang
博客等级 码龄10年 5粉丝 116原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值