电商数据应用体系建设总结(三)—— 离线数据兜底方案

AI系统实时数据处理故障:架构师应急:批处理转存+离线补偿计算方案详解 如果实时计算用了自定义算子(比如Flink的),可以将UDF代码编译成Jar包,在Spark中引用。break;break;// Spark UDF:复用相同的逻辑// 定义UDF函数})// 注册UDF// 执行补算「批处理转存+离线补偿」是一套低成本、高可靠保数据:用双写、侧输出或MirrorMaker将实时数据转存到可靠存储;补结果:复用实时逻辑,用批处理框架计算故障时间段的数据;装回去:将补算结果幂等写入业务数据库,恢复业务;防复发。 阅读详情

背景

目前我们使用Lambda架构来处理数据,Flink处理实时数据,Spark处理离线数据。Spark离线任务在每天凌晨的0-8点调度执行,在这段时间内,用户是看不到昨日未产出的离线数据的,数据应用对这些未产出的指标进行了特殊处理,用户看到的未产出的指标数据为0或者—。但在没有任何提示的情况下,用户不明白为什么会有这样的情况,给用户带来不好的使用体验。因此,我们需要一套离线数据兜底方案来解决昨日离线数据未产出,导致用户看数体验下降的问题。

目标

通过数据产品功能和数据查询方式上的改进与优化,解决0-8点离线数据未产出问题,降低该问题对用户使用数据的影响。

解决方案

当前在数据应用产品上我们可以看到日周月三个时间粒度的数据,其中,今日数据是实时的,昨日数据是离线的,周和月的数据也是离线的。基于Lambda架构下离线数据和实时数据的特点,为了降低离线数据未产出的问题对用户使用数据带来的影响,我们在数据查询方式和数据产品功能设计上,使用以下三个方案实现离线数据兜底,通过这套离线数据兜底方案,使用户对数据的产出无感知,屏蔽数据产出对用户看数的影响,方案如下:
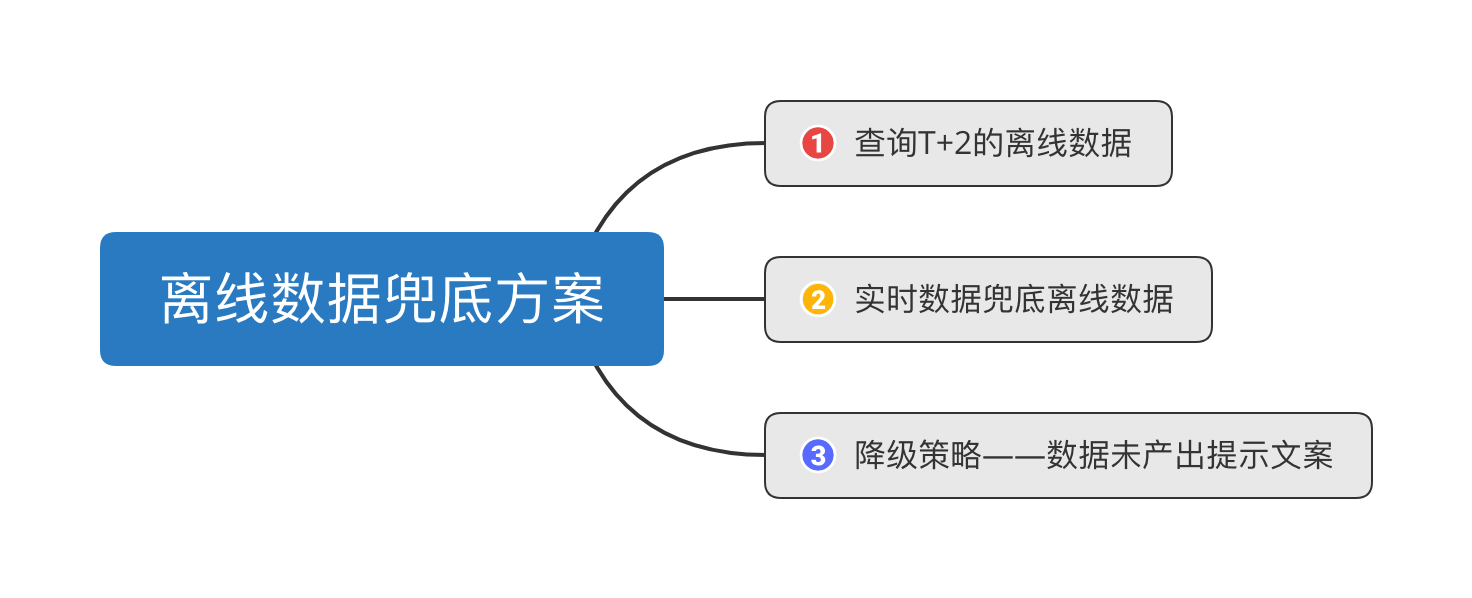
总体上我们使用的是方案2+方案3整合的解决方案。方案1和2属于数据查询方式上的优化,都是为了解决昨日离线数据未产出的问题,在查询方式优化上,我们主要使用的是方案2,方案1属于早期方案,已被废弃。方案3属于数据产品功能上的优化,在产品功能设计上,对于时间粒度为日周月的离线数据,都会考虑加入方案3。

由于用户对数据的使用粘性很高,无论是离线数据还是实时数据,使用上都要求能对数据进行实时查询、实时多维分析。因此,我们选择使用ClickHouse为主、StarRocks为辅的存储架构,这两款OLAP引擎都具备实时OLAP分析的能力,我们会根据实际遇到的问题和场景来选择使用哪一款存储引擎,这两款OLAP引擎对比如下:
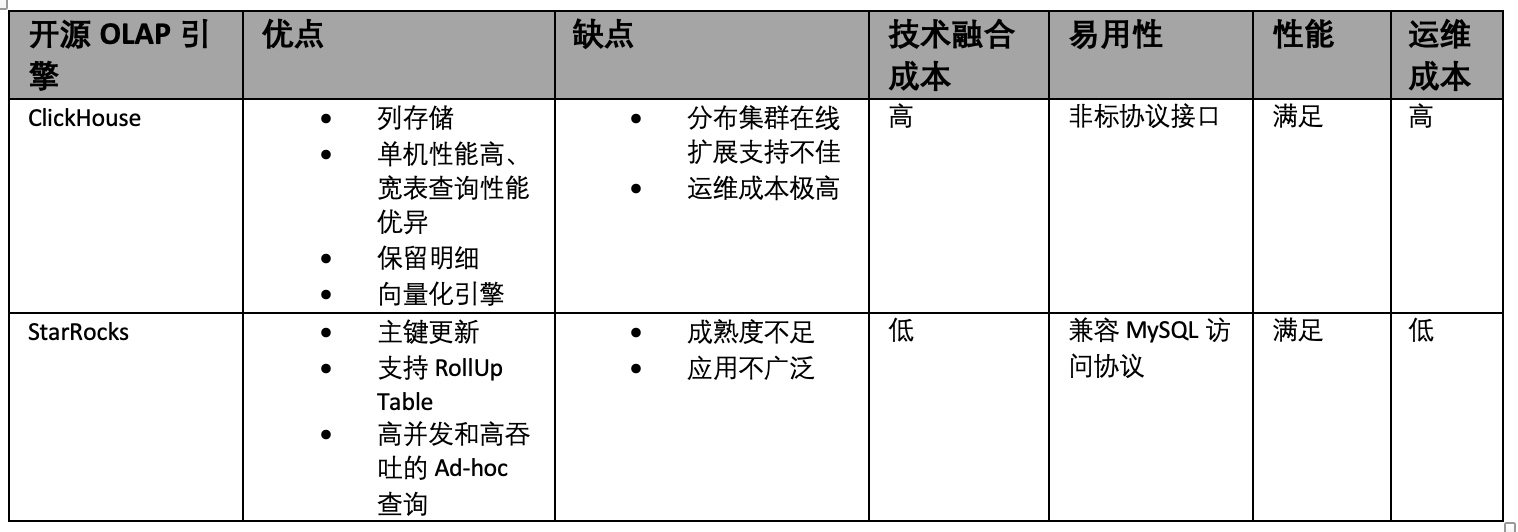
由于方案1比较简单,而且我们不再继续使用,接下来重点介绍方案2和方案3。

实时数据兜底离线数据方案

在Lambda架构中,无论是实时场景还是离线场景,对于同一个指标,它的统计口径都是一样的。在这个前提下,我们利用StarRocks的临时分区、临时分区可以原子替换正式分区的特性,制定了实时数据兜底离线数据方案,方案设计思路如下:
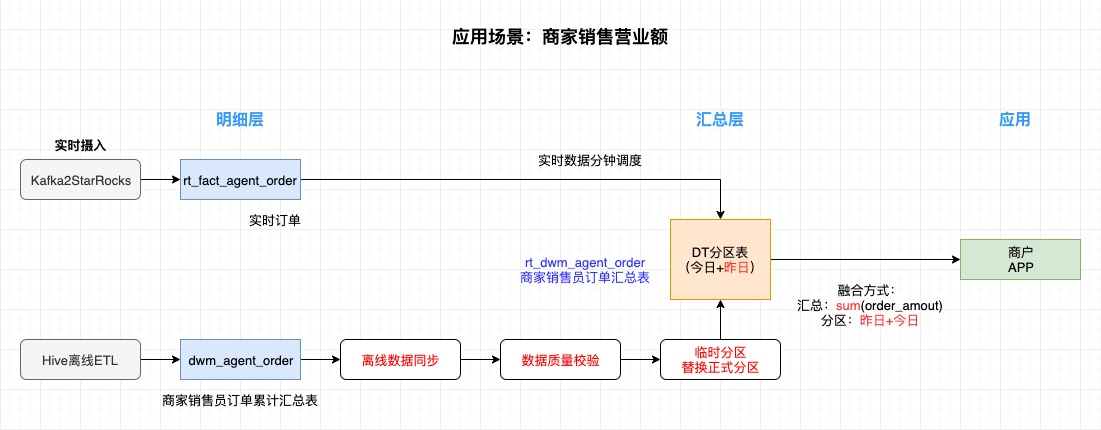
在这个方案中,Hive保存离线数据,StarRocks保存实时数据,StarRocks表的临时分区是实现这个方案的核心,整个方案主要分为三个步骤实现:

1、数据生产: 数据生产分为实时数据链路和离线数据链路,这两条链路产出的数据最终下推到汇总层,数据应用直接从汇总层取数展示给用户。我们以离线任务汇总出的数据为准,数据汇总层的汇总表按天分区,实时任务计算出的汇总数据直接写到汇总表的今日分区里,每天0点过后,今日分区变成昨日分区。

2、分区替换: 这是该方案实现的核心环节,主要分为三步进行:

  • (1) 同步Hive离线汇总表数据到StarRocks汇总表临时分区: 一旦离线汇总表的计算任务完成,负责给StarRocks汇总表临时分区同步离线数据的Spark任务就可以将Hive离线汇总表的昨日分区数据同步到StarRocks汇总表临时分区,StarRocks汇总表临时分区的名称与Hive离线汇总表昨日分区的名称一致,比如都是yyyy-MM-dd格式
  • (2) 数据质量校验: 第一个步骤完成之后,需要对Hive离线汇总表昨日分区数据与StarRocks汇总表临时分区数据的关键字段、数据行数等指标进行对比,如果两表的分区数据一致,执行第三步的替换操作
  • (3) 临时分区替换正式分区: 数据质量检验完成后,在Spark任务里执行StarRocks临时分区替换正式分区脚本,用StarRocks汇总表临时分区的数据覆盖正式分区的数据

3、 数据查询: 数据应用在查询数据时,都可以从StarRocks汇总表去查询

经过以上步骤,就解决了凌晨离线数据未产出,用户不能看到昨日数据的问题。以日时间粒度的数据表为例,实时数据和离线数据都是以0点为分界线,0点过后,实时数据的今日分区变成昨日分区,离线数据的昨日分区的调度任务开始执行,如果用户想要访问昨日的数据,分以下两种情况:

  • 当离线数据昨日分区的调度任务未执行完成时,数据应用查询的是实时表昨日分区里未用昨日离线数据替换的汇总数据
  • 当离线数据昨日分区的调度任务执行完成,并替换实时表昨日分区的数据之后,数据应用查询的是实时表昨日分区里用昨日离线数据替换后的汇总数据

以上操作都是在数据处理环节完成,对于查看昨日数据的用户,看到的是离线数据还是实时数据,是没有感知的。但最终,用户查看的今日数据还是实时的,今日以前的数据还是离线的,通过昨日离线覆盖昨日实时这一操作,我们将实时数据和离线数据统一存储到一张实时表中,将实时表作为数据的统一出口。

降级策略

降级是在数据应用和业务系统里经常使用的一个策略,比如当用户访问出异常时给用户一个友好的提示,通过这个策略,提升用户的使用体验。

在数据应用层解决离线数据未产出这个问题时,除了使用实时数据兜底离线数据方案,我们也会配合使用数据未产出提示文案的形式给用户提示,减少用户在数据应用产品使用上产生的疑问。在需求、技术评审阶段确认是否需要支持“降级文案“的功能,前端&后端提供管理页面,用来控制文案展示的时间段、文案展示的内容、文案显示的页面,如果遇到数据加工异常可以通过更改文案,提示用户,比如”数据校准中仅供参考,预计6点后更新“的文案,前端会通过在页面上方挂”黄色滚动条“提示用户。

小结&思考

以上方案只是个人在工作实践中的总结,还需要不断完善和改进,后续会考虑在数据处理层使用批流一体架构来统一离线和实时数据,提升数据的产出效率和质量。

京东零售基于Flink的推荐系统智能数据体系 |Flink Forward Asia 峰会实录分享 接下来详细介绍京东搜索推荐系统智能数据体系的构成,第一个模块为索引,主要为召回服务提供数据支持。常见的索引构建流程是,从底池数据出发,经过索引构建操作,将构建完成的索引提供给召回服务。索引常见类型可划分为三类:(1) 个性化索引:这类索引可能涉及特定用户或某类用户的行为足迹或者是基于品类、品牌偏好形成的索引。(2) 基础索引:以京东海量商品为例,可将其归纳为基于品类、品牌的索引,同时还包括时间、LBS相关的索引。 阅读详情

相关推荐

数据集成实战:从CDC实时同步到离线整合的架构选型与踩坑记录

数据集成是大数据平台稳定运行的隐形地基,它负责将散布在业务库、日志文件、第三方服务与物联网设备中的数据高效汇聚到分析链路中。实现这一目标需要深入理解批量抽取、实时同步、变更捕获、Schema映射与幂等控制等核心原理。在实际工程中,CDC技术基于Binlog解析实现秒级同步,Kafka作为缓冲层承担削峰填谷的角色,而Flink流式计算则支撑复杂的事件加工与乱序处理。无论是电商订单的实时链路、金融数仓的多源离线整合,还是工业IoT的时序汇聚,都依赖一套规范的架构选型与质量治理机制。本文复盘三个典型场景的实施方案

weixin_42551227的博客 299

数据存储快照

存储快照 存储快照技术SNIA(StorageNetworking Industry Association)对快照(Snapshot)的定义是:关于指定数据集合的一个完全可用拷贝,该拷贝包括相应数据在某个时间点(拷贝开始的时间点)的映像。快照可以是其所表示的数据的一个副本,也可以是数据的一个复制品。 快照的作用主要是能够进行在线数据备份与恢复。当存储设备发生应用故障或者文件损坏时可以进行快速

fang_fang_2008的专栏 1688

Android原生Java电商App实战:农产品溯源与离线购物系统

Android原生开发是构建高可控、低依赖移动应用的基础技术路径,其核心在于Java语言能力、SQLite本地数据管理与Activity生命周期深度把控。在弱网、低配设备及敏感业务场景下,原生方案展现出不可替代的稳定性与定制化优势。本文围绕一个真实落地的农产品电商App,解析如何通过纯Java实现扫码溯源、离线订单提交、跨App评价同步等关键能力,涵盖MVC分层设计、SQL注入防护、APK体积优化及冷启动加速等工程实践要点,为县域数字化、农业上行链路技术落地提供可复用的Android工程化范本。

weixin_31220401的博客 188

hadoop之离线处理电商项目架构和实现

处理流程 1.涉及的基本技术组件 Hadoop:HDFS MapReduce(清洗) YARN、需要部署Hadoop集群 Hive:外部表、SQL 、解决数据倾斜 、sql优化、基于元数据管理、SQL 到MR过程 Flume:将数据抽取到hdfs 调度:crontab、shell、Azkaban HUE:可视化的notebook,CM自带 ,排查数据 2.处理流程 大数据开...

Big Data 1278

Unity 2022.3.3 LTS + Visual Studio 2022:手把手教你复刻《吸血鬼幸存者》核心战斗(附完整项目源码)

本文详细介绍了如何使用Unity 2022.3.3 LTS和Visual Studio 2022从零构建《吸血鬼幸存者》式战斗系统。通过图文开发教程,涵盖对象池优化、ECS架构雏形、2D物理碰撞控制等关键技术,帮助开发者高效复刻这款热门游戏的自动攻击与海量刷怪机制。

weixin_30721077的博客 460

ansys workbench生成simpack使用的柔性体文件(.sub和.cdb文件)

由于需要做齿轮箱的刚柔耦合仿真,所以需要使用ansys生成.sub和.cdb文件,通过simpack内置的插件完成柔性体的建立。但是网络的教程相当有限。bilibili用户分享,apdl生成.sub和.cdb文件(apdl)子结构处理超大型模型问题ansys子结构分析时如何选取主自由度但是apdl学习成本比较高,所以我还是希望使用workbench实现这些功能,所以在此,我总结一下操作方法。

chbl6的博客 9714

(五)Feign兜底数据 fallback

feign 返回兜底数据 微服务

csdn570566705的博客 1705

计算pi小数点后10000位

数据结构课上,老师让我们计算一下pi的10000位,复习一下面向对象。 First Try:定义一个高精度类hp(high precision),实现加减乘除,输入输出,然后随便找一个公式,比如Wallis公式,全都用hp进行计算。 现实是:大数乘大数或者大数除大数,实在是太慢了。而且Wallis公式收敛太慢。 Second Try先找到一个收敛较快的公司:BBP公式,观察公式发现,...

我的技术人生 7395

大流量下的兜底容灾方案

原文地址:http://www.barretlee.com/blog/2015/09/16/backup-solution-at-big-traffic/ 注:本博主稍有修改! 随着网络的普及,上网的成本和门槛越来越低,很多网站的流量也是蹭蹭蹭的往上涨,而页面上的数据来源也不确定,可能来自多个平台,也可能是有专门的人员在手动维护。由于数据来源众多,出错的概率也会增加...

weixin_30270889的博客 1542

Fluent后台计算中Journal文件的自动化编写与优化实践

本文深入探讨了Fluent在Linux/Unix环境下进行后台计算时,Journal文件的自动化编写与优化实践。Journal文件作为Fluent后台计算的“灵魂”,是实现仿真流程自动化、保证计算可重复性与准确性的关键。文章从基础脚本骨架搭建、命令简写技巧,到进阶的参数化研究与批量计算实现,提供了详实的实战指南,帮助工程师大幅提升仿真效率。

postgres8guard的博客 760

AutoSAR系列讲解(入门篇)2.4-Runnables可运行实体

讲解一下Runnable和其工程的实际映射

雪云飞星的博客 3万+

架构相关:服务降级思路与方法

如果看过我前面对服务限流的分析,理解服务降级就很容易了,对于一个景区,平时随便进出,但是一到春节或者十一国庆这种情况客流量激增,那么景区会限制同时进去的人数,这叫限流,那么什么是服务降级呢?简单来说就是,将一些不太重要的景区项目砍掉,平时就那么三五八个人,景区可以开放湖中游泳啦,摸鱼啦,捉虾啦,有情况工作人员可以下湖捞你,但是现在客流量大了,工作人员关注不过来,都在湖里晃荡万一沉了不太安全,大手一挥,这个项目砍了,将工作人员分配在其他地方。在互联网中也有类似的降级措施,像之前双11, 有段时间是只允许下单不

Java搜索工程技术栈 2219

基于高频变压器的隔离式推挽栅极驱动电路

摘要:本文介绍了一种基于高频变压器的隔离式推挽栅极驱动电路,通过变压器实现电气隔离,为功率MOS管提供可靠驱动信号。电路包含输入侧PWM信号处理、变压器磁耦合隔离传输以及副边驱动逻辑等关键部分,利用电阻电容网络控制开关速度并防止误触发。该隔离驱动方案广泛应用于高压开关电源、新能源汽车电机控制器、光伏逆变器和工业变频器等需要高电压隔离及抗干扰能力的电力电子设备中,有效保障系统安全性和可靠性。

qq_37999850的博客 491

亿级流量系统的优雅降级:兜底数据与静态化的三层架构设计

分级舍弃,渐进恢复。第一层关闭非核心功能,是"减负不减质"——用户仍然能看到核心数据,只是少了一些锦上添花的模块。第二层切换到纯缓存读,是"保命不保新"——数据可能不是最新的,但至少能返回。第三层静态兜底,是"活着就有希望"——用一个预先烘焙的快照撑过最艰难的时刻。落地这套架构有三个工程要点:一是降级触发条件必须基于多维度指标(错误率、RT、P99)而非单一信号,避免误触发;二是每一级降级都需要独立的测试用例和压测场景,代码逻辑不能"写完即走";

dicky_zhang3的博客 4638

华为OD机试 - 整型数组按照个位数排序(Python/JS/C/C++ 双机位C卷 100分)

本专栏收录于《华为OD机试真题(Python/JS/C/C++)》。刷的越多,抽中的概率越大,私信哪吒,备注华为OD,加入华为OD刷题交流群,每一题都有详细的答题思路、详细的代码注释、3个测试用例、为什么这道题采用XX算法、XX算法的适用场景,发现新题目,随时更新。给定一个非空数组(列表),其元素数据类型为整型,请按照数组元素十进制最低位从小到大进行排序,十进制最低位相同的元素,相对位置保持不变。当数组元素为负值时,十进制最低位等同于去除符号位后对应十进制值最低位。给定一个非空数组,其元素数据类型为32位有

学Java,找哪吒 400

PSO-BP和BP多输入多输出回归预测模型 matlab (多输入多输出)

PSO-BP和BP多输入多输出回归预测模型 matlab (多输入多输出)

算法如诗的博客 258

解决大模型输出幻觉:AI 质量评估、异常检测、人工兜底机制工程实践

摘要: 本文针对跨境电商AI Agent中普遍存在的大模型幻觉问题,提出了一套完整的三层风控治理方案。通过分析幻觉类型(事实型、工具调用、逻辑推理、上下文混淆)及其业务危害,设计了自动化质量评估、实时异常检测、人工兜底审核的闭环体系。技术实现包括检索相关性、事实一致性、逻辑合规性三大评估指标(附Python代码),结合阈值拦截与日志追踪,将幻觉拦截率提升至96%。方案覆盖客服、广告、库存等核心场景,有效降低人工复核工作量70%,为生产级AI应用提供可靠幻觉治理路径。

yuxianq的博客 547

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Spring AI在Alibaba电商系统的实战应用案例

最近在做一个电商推荐系统的项目,正好结合Spring AI和Alibaba的技术栈,分享一下我的实战经验。上开发非常顺畅,特别是它的一键部署功能,让我可以快速把demo部署上线测试效果,省去了很多环境配置的麻烦。数据采集负责收集用户行为数据,算法引擎处理推荐逻辑,业务服务对接前端请求,展示层提供可视化分析。对于想尝试AI推荐系统的开发者来说,这种云端开发环境真的很方便,不需要本地搭建复杂的环境,打开浏览器就能开始coding,还能随时分享项目给同事review。- 特征工程耗时过长,通过预计算优化。

BlackironLynx23的博客 897

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

极致体验!微信小程序离线应用开发实战:iview-weapp缓存架构深度解析

还在为小程序网络不稳定导致用户体验差而烦恼?一文掌握微信小程序离线应用开发的完整解决方案!本文将带你深入解析如何基于iview-weapp构建高性能离线小程序,让你的应用在网络波动时依然流畅运行。 读完本文你将获得: - 微信小程序本地存储机制深度解析 - iview-weapp组件与缓存策略完美结合方案 - 实战案例:构建离线可用的电商小程序 - 性能优化与数据同步最佳实践 ## 微信小程序

gitblog_00344的博客 864

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

AI输出的“质检员”:构建智能体质量评估、异常检测与人工兜底的三层防线

文章摘要: 本文探讨了AI应用中的“幻觉”问题,即模型输出错误但看似自信的信息,尤其在跨境电商场景中可能导致严重后果。为解决这一问题,作者提出了一套三层防护机制: 质量评估(事后分析):通过通用指标(连贯性、流畅度)和业务专属指标(合规性、专业性)评估AI输出,类似于单元测试,确保回答质量。 异常检测(实时监控):利用幻觉检测技术,将回答拆解为原子陈述并逐一验证,发现矛盾或不可验证的内容时触发告警。 人工兜底(闭环处理):当评估或检测不达标时,自动转交人工复核,避免错误信息直接影响业务。 文中提供了代码示例

circuitsosk的博客 180

HarmonyOS 6商城开发学习:优惠券防重复领取——设备标记与本地Pref双重兜底实现

进入页面​ → 先查本地Preferences()→ 已领取直接置灰有网​ → 调同步服务端状态 → 若已标记也置灰并写本地点击领取​ → 调+ 后端发券接口 → 写本地Preferences → UI置灰异常​ → 网络失败给Toast重试,不回滚本地已领取标记核心法则:HarmonyOS 6电商券防重领 ="本地Pref兜底 + 设备标记云端校验"​ 双保险,离线不破防,在线不重复。©著作权归作者所有,如需转载,请注明出处,否则将追究法律责任。

nashane的博客 225

基于Hadoop的电商数据分析系统:从环境搭建到离线数仓实战

大数据技术栈中,离线数仓始终是企业分析历史数据、支撑经营决策的基石。理解分布式存储与并行计算的原理,是掌握Hadoop生态的关键。HDFS负责海量数据的可靠存储,MapReduce提供批处理计算能力,而Hive则通过SQL化抽象降低了离线分析的门槛。在电商业务场景下,订单数据与用户行为日志的采集、清洗、分层建模和指标计算,构成了典型的数据分析闭环。从环境搭建、Sqoop与Flume数据接入,到Hive数仓分层、数据倾斜调优,再到结果可视化,每一步都考验工程实践能力。本文围绕基于Hadoop的电商数据分析系统

weixin_34195364的博客 125

京东零售基于Flink的推荐系统智能数据体系

摘要:本文整理自京东零售技术专家张颖老师,在 Flink Forward Asia 2024 生产实践(二)专场中的分享,介绍了基于Flink构建的推荐系统数据,以及Flink智能体系带来的智能服务功能。内容分为以下六个部分:样本特征可解释指标Tips:关注「公众号」回复 FFA 2024 查看会后资料~京东推荐系统的数据体系极其复杂,从召回、模型到策略和效果评估,每个环节都需要强大的海量数据处理能力支撑。然而,在实际运行中,整个数据链路面临着诸多挑战:如实时与离线数据的埋点口径不一致、数仓模型存在偏差、计

Ververica的博客 484

KaiwuDB 迁移实战 01:MySQL 平滑迁移全套方案(KDTS+DataX+CSV 离线)

本文面向 DBA、后端开发与架构师,完整覆盖 MySQL 迁移至 KaiwuDB 全流程。内容基于 KaiwuDB 企业版关系引擎,拆解模型差异、类型映射、三种迁移工具实操与校验回滚方案。读完可根据网络环境、自动化需求选择适配迁移方案,落地无中断平滑割接。

KaiwuDB 数据库 349

PWA离线能力极致优化:离线缓存策略、后台同步、推送通知、断网业务容错全方案

PWA离线能力优化方案从"可用"到"生产级稳定",聚焦电商、资讯、工具类业务场景,解决缓存失效、后台同步丢失、推送通知失败、断网业务断裂等核心痛点。通过Workbox7+Web API实现分层场景级缓存策略、持久化后台同步、全链路推送容错和多维度业务降级。方案包括: 缓存分层优化:预缓存核心资源,静态资源长期缓存,动态资源弹性兜底; 后台同步持久化:线程级持久化请求队列,智能重试机制; 推送通知容错:兼容iOS限制,处理订阅变更事件; 断网业务降级:区分资源类型定制缓存策略,操作级降级提示。 覆盖React

网络工程师|十多年企业级运维实战|精通 ‌BGP、OSPF、VLAN、SDN、MPLS、ACL、NetFlow、SNMP、 450

电商、社交、工具、企服、平台:五类软件的核心功能地图

通用功能(登录、权限、通知、日志)可以借助开源框架快速搭建。电商的命脉是交易闭环,社交的命脉是关系与内容生态,工具的命脉是任务完成效率,企业服务的命脉是流程管理,平台的命脉是供需撮合。这些功能无法照搬模板,必须围绕业务主轴量身定制。 把市面上的项目归归类,会发现绝大多数落在五种类型里:电商交易类、社交内容类、工具效率类、企业服务类、平台生态类。本文逐一拆解五类项目的核心功能体系、建设节奏和典型技术难点。理解这些差异,是为了在项目第一天就把架构和排期押在正确的地方。

cooldream2009的博客 369
上一篇: 电商数据应用体系建设总结(二)—— 数据应用层架构介绍和规范总结
下一篇: Spark SQL调优脑图
Viking_bird
博客等级 码龄11年 92粉丝 183原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值