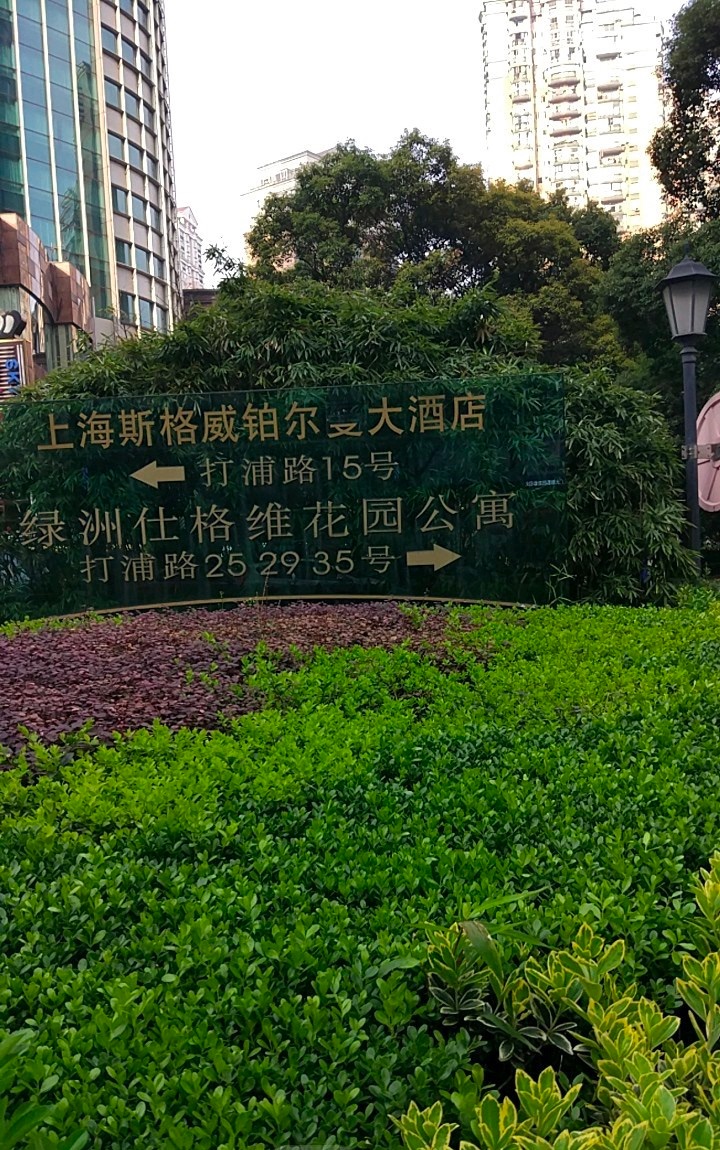
文本检测模块使用教程
一、概述
文本检测模块是OCR(光学字符识别)系统中的关键组成部分,负责在图像中定位和标记出包含文本的区域。该模块的性能直接影响到整个OCR系统的准确性和效率。文本检测模块通常会输出文本区域的边界框(Bounding Boxes),这些边界框将作为输入传递给文本识别模块进行后续处理。
二、支持模型列表
| 模型 | 模型下载链接 | 检测Hmean(%) | GPU推理耗时(ms) [常规模式 / 高性能模式] | CPU推理耗时(ms) [常规模式 / 高性能模式] | 模型存储大小(M) | 介绍 |
|---|---|---|---|---|---|---|
| PP-OCRv5_server_det | 推理模型/训练模型 | 83.8 | 89.55 / 70.19 | 371.65 / 371.65 | 84.3 | PP-OCRv5 的服务端文本检测模型,精度更高,适合在性能较好的服务器上部署 |
| PP-OCRv5_mobile_det | 推理模型/训练模型 | 79.0 | 8.79 / 3.13 | 51.00 / 28.58 | 4.7 | PP-OCRv5 的移动端文本检测模型,效率更高,适合在端侧设备部署 |
| PP-OCRv4_server_det | 推理模型/训练模型 | 69.2 | 83.34 / 80.91 | 442.58 / 442.58 | 109 | PP-OCRv4 的服务端文本检测模型,精度更高,适合在性能较好的服务器上部署 |
| PP-OCRv4_mobile_det | 推理模型/训练模型 | 63.8 | 8.79 / 3.13 | 51.00 / 28.58 | 4.7 | PP-OCRv4 的移动端文本检测模型,效率更高,适合在端侧设备部署 |
测试环境说明:
- 性能测试环境
- 测试数据集:PaddleOCR3.0 全新构建多语种(包含中、繁、英、日),覆盖街景、网图、文档、手写、模糊、旋转、扭曲等多个场景的文本检测数据集,包含2677 张图片。
- 硬件配置:
- GPU:NVIDIA Tesla T4
- CPU:Intel Xeon Gold 6271C @ 2.60GHz
- 其他环境:Ubuntu 20.04 / cuDNN 8.6 / TensorRT 8.5.2.2
- 推理模式说明
| 模式 | GPU配置 | CPU配置 | 加速技术组合 |
|---|---|---|---|
| 常规模式 | FP32精度 / 无TRT加速 | FP32精度 / 8线程 | PaddleInference |
| 高性能模式 | 选择先验精度类型和加速策略的最优组合 | FP32精度 / 8线程 | 选择先验最优后端(Paddle/OpenVINO/TRT等) |
三、快速开始
❗ 在快速开始前,请先安装 PaddleOCR 的 wheel 包,详细请参考 安装教程。
使用一行命令即可快速体验:
paddleocr text_detection -i https://paddle-model-ecology.bj.bcebos.com/paddlex/imgs/demo_image/general_ocr_001.png
您也可以将文本检测的模块中的模型推理集成到您的项目中。运行以下代码前,请您下载示例图片到本地。
from paddleocr import TextDetection
model = TextDetection(model_name="PP-OCRv5_server_det")
output = model.predict("general_ocr_001.png", batch_size=1)
for res in output:
    res.print()
    res.save_to_img(save_path="./output/")
    res.save_to_json(save_path="./output/res.json")
运行后,得到的结果为:
{'res': {'input_path': 'general_ocr_001.png', 'page_index': None, 'dt_polys': array([[[ 75, 549],
        ...,
        [ 77, 586]],

       ...,

       [[ 31, 406],
        ...,
        [ 34, 455]]], dtype=int16), 'dt_scores': [0.873949039891189, 0.8948166013613552, 0.8842595305917041, 0.876953790920377]}}
运行结果参数含义如下: - input_path:表示输入待预测图像的路径 - page_index:如果输入是PDF文件,则表示当前是PDF的第几页,否则为 None - dt_polys:表示预测的文本检测框,其中每个文本检测框包含一个四边形的四个顶点。其中每个顶点都是一个列表,分别表示该顶点的x坐标和y坐标 - dt_scores:表示预测的文本检测框的置信度
可视化图片如下:

相关方法、参数等说明如下:
TextDetection实例化文本检测模型(此处以PP-OCRv5_server_det为例),具体说明如下:
| 参数 | 参数说明 | 参数类型 | 可选项 | 默认值 |
|---|---|---|---|---|
model_name | 模型名称 | str | 所有支持的文本检测模型名称 | 无 |
model_dir | 模型存储路径 | str | 无 | 无 |
device | 模型推理设备 | str | 支持指定GPU具体卡号,如“gpu:0”,其他硬件具体卡号,如“npu:0”,CPU如“cpu”。 | gpu:0 |
limit_side_len | 检测的图像边长限制 | int/None |
| None |
limit_type | 检测的图像边长限制,检测的边长限制类型 | str/None |
| None |
thresh | 输出的概率图中,得分大于该阈值的像素点才会被认为是文字像素点 | float/None |
| None |
box_thresh | 检测结果边框内,所有像素点的平均得分大于该阈值时,该结果会被认为是文字区域 | float/None |
| None |
unclip_ratio | Vatti clipping算法的扩张系数,使用该方法对文字区域进行扩张 | float/None |
| None |
use_hpip | 是否启用高性能推理插件 | bool | 无 | False |
hpi_config | 高性能推理配置 | dict | None | 无 | None |
-
其中,
model_name必须指定,指定model_name后,默认使用 PaddleX 内置的模型参数,在此基础上,指定model_dir时,使用用户自定义的模型。 -
调用文本检测模型的
predict()方法进行推理预测,该方法会返回一个结果列表。另外,本模块还提供了predict_iter()方法。两者在参数接受和结果返回方面是完全一致的,区别在于predict_iter()返回的是一个generator,能够逐步处理和获取预测结果,适合处理大型数据集或希望节省内存的场景。可以根据实际需求选择使用这两种方法中的任意一种。predict()方法参数有input、batch_size、limit_side_len、limit_type、thresh、box_thresh、max_candidates、unclip_ratio和use_dilation,具体说明如下:
| 参数 | 参数说明 | 参数类型 | 可选项 | 默认值 |
|---|---|---|---|---|
input | 待预测数据,支持多种输入类型 | Python Var/str/dict/list |
| 无 |
batch_size | 批大小 | int | 大于0的任意整数 | 1 |
limit_side_len | 检测的图像边长限制 | int/None |
| None |
limit_type | 检测的图像边长限制,检测的边长限制类型 | str/None |
| None |
thresh | 输出的概率图中,得分大于该阈值的像素点才会被认为是文字像素点 | float/None |
| None |
box_thresh | 检测结果边框内,所有像素点的平均得分大于该阈值时,该结果会被认为是文字区域 | float/None |
| None |
unclip_ratio | Vatti clipping算法的扩张系数,使用该方法对文字区域进行扩张 | float/None |
| None |
- 对预测结果进行处理,每个样本的预测结果均为对应的Result对象,且支持打印、保存为图片、保存为
json文件的操作:
| 方法 | 方法说明 | 参数 | 参数类型 | 参数说明 | 默认值 |
|---|---|---|---|---|---|
print() | 打印结果到终端 | format_json | bool | 是否对输出内容进行使用 JSON 缩进格式化 | True |
indent | int | 指定缩进级别,以美化输出的 JSON 数据,使其更具可读性,仅当 format_json 为 True 时有效 | 4 | ||
ensure_ascii | bool | 控制是否将非 ASCII 字符转义为 Unicode。设置为 True 时,所有非 ASCII 字符将被转义;False 则保留原始字符,仅当format_json为True时有效 | False | ||
save_to_json() | 将结果保存为json格式的文件 | save_path | str | 保存的文件路径,当为目录时,保存文件命名与输入文件类型命名一致 | 无 |
indent | int | 指定缩进级别,以美化输出的 JSON 数据,使其更具可读性,仅当 format_json 为 True 时有效 | 4 | ||
ensure_ascii | bool | 控制是否将非 ASCII 字符转义为 Unicode。设置为 True 时,所有非 ASCII 字符将被转义;False 则保留原始字符,仅当format_json为True时有效 | False | ||
save_to_img() | 将结果保存为图像格式的文件 | save_path | str | 保存的文件路径,当为目录时,保存文件命名与输入文件类型命名一致 | 无 |
- 此外,也支持通过属性获取带结果的可视化图像和预测结果,具体如下:
| 属性 | 属性说明 |
|---|---|
json | 获取预测的json格式的结果 |
img | 获取格式为dict的可视化图像 |
四、二次开发
如果以上模型在您的场景上效果仍然不理想,您可以尝试以下步骤进行二次开发,此处以训练 PP-OCRv5_server_det 举例,其他模型替换对应配置文件即可。首先,您需要准备文本检测的数据集,可以参考文本检测 Demo 数据的格式准备,准备好后,即可按照以下步骤进行模型训练和导出,导出后,可以将模型快速集成到上述 API 中。此处以文本检测 Demo 数据示例。在训练模型之前,请确保已经按照安装文档安装了 PaddleOCR 所需要的依赖。
4.1 数据集、预训练模型准备
4.1.1 准备数据集
# 下载示例数据集
wget https://paddle-model-ecology.bj.bcebos.com/paddlex/data/ocr_det_dataset_examples.tar
tar -xf ocr_det_dataset_examples.tar
4.1.2 下载预训练模型
# 下载 PP-OCRv5_server_det 预训练模型
wget https://paddle-model-ecology.bj.bcebos.com/paddlex/official_pretrained_model/PP-OCRv5_server_det_pretrained.pdparams
4.2 模型训练
PaddleOCR 对代码进行了模块化,训练 PP-OCRv5_server_det 识别模型时需要使用 PP-OCRv5_server_det 的配置文件。
训练命令如下:
#单卡训练 (默认训练方式)
python3 tools/train.py -c configs/det/PP-OCRv5/PP-OCRv5_server_det.yml \
    -o Global.pretrained_model=./PP-OCRv5_server_det_pretrained.pdparams \
    Train.dataset.data_dir=./ocr_det_dataset_examples \
    Train.dataset.label_file_list='[./ocr_det_dataset_examples/train.txt]' \
    Eval.dataset.data_dir=./ocr_det_dataset_examples \
    Eval.dataset.label_file_list='[./ocr_det_dataset_examples/val.txt]'

#多卡训练,通过--gpus参数指定卡号
python3 -m paddle.distributed.launch --gpus '0,1,2,3' tools/train.py \
    -c configs/det/PP-OCRv5/PP-OCRv5_server_det.yml \
    -o Global.pretrained_model=./PP-OCRv5_server_det_pretrained.pdparams \
    Train.dataset.data_dir=./ocr_det_dataset_examples \
    Train.dataset.label_file_list='[./ocr_det_dataset_examples/train.txt]' \
    Eval.dataset.data_dir=./ocr_det_dataset_examples \
    Eval.dataset.label_file_list='[./ocr_det_dataset_examples/val.txt]'
4.3 模型评估
您可以评估已经训练好的权重,如,output/PP-OCRv5_server_det/best_accuracy.pdprams,使用如下命令进行评估:
# 注意将pretrained_model的路径设置为本地路径。若使用自行训练保存的模型,请注意修改路径和文件名为{path/to/weights}/{model_name}。
 # demo 测试集评估
python3 tools/eval.py -c configs/det/PP-OCRv5/PP-OCRv5_server_det.yml \
    -o Global.pretrained_model=output/PP-OCRv5_server_det/best_accuracy.pdparams \
    Eval.dataset.data_dir=./ocr_det_dataset_examples \
    Eval.dataset.label_file_list='[./ocr_det_dataset_examples/val.txt]'
4.4 模型导出
python3 tools/export_model.py -c configs/det/PP-OCRv5/PP-OCRv5_server_det.yml -o \
    Global.pretrained_model=output/PP-OCRv5_server_det/best_accuracy.pdparams \
    Global.save_inference_dir="./PP-OCRv5_server_det_infer/"
导出模型后,静态图模型会存放于当前目录的./PP-OCRv5_server_det_infer/中,在该目录下,您将看到如下文件:
./PP-OCRv5_server_det_infer/
├── inference.json
├── inference.pdiparams
├── inference.yml
至此,二次开发完成,该静态图模型可以直接集成到 PaddleOCR 的 API 中。
五、FAQ
- 通过参数
limit_type和limit_side_len来对图片的尺寸进行限制,limit_type可选参数为[max,min],limit_side_len为正整数,一般设置为 32 的倍数,比如 960。 如果输入图形分辨率不大,建议使用limit_type=min和limit_side_len=960节省计算资源的同时能获得最佳检测效果。如果输入图片的分辨率比较大,而且想使用更大的分辨率预测,可以设置limit_side_len为想要的值,比如 1216。
 1605


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言