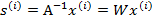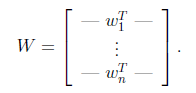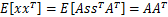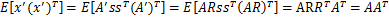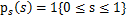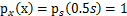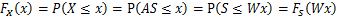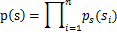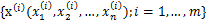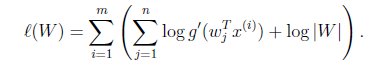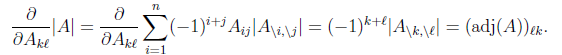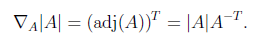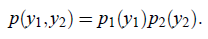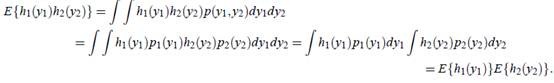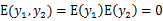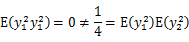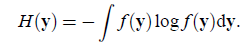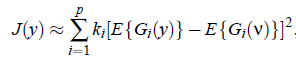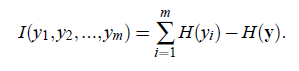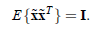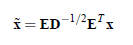独立成分分析(Independent Component Analysis)

独立成分分析ICA系列2:概念、应用和估计原理. 1.概念 独立成分分析是从多元(多维)统计数据中寻找潜在因子或成分的一种方法.ICA与其它的方法重要的区别在于,它寻找满足统计独立和非高斯的成分。这里我们简要介绍ICA的基本概念、应用和估计原理。 1.1 多元数据的线性表示 统计数据处理及相关领域中的一个重要和需要长期研究的问题就是,寻找多元数据一个恰当的表示,使得人们可以获得给定数据的本质特征或者使得数据的结构 阅读详情

独立成分分析(Independent Component Analysis)

1. 问题:

     1、上节提到的PCA是一种数据降维的方法,但是只对符合高斯分布的样本点比较有效,那么对于其他分布的样本,有没有主元分解的方法呢?

     2、经典的鸡尾酒宴会问题(cocktail party problem)。假设在party中有n个人,他们可以同时说话,我们也在房间中一些角落里共放置了n个声音接收器(Microphone)用来记录声音。宴会过后,我们从n个麦克风中得到了一组数据clip_image002,i表示采样的时间顺序,也就是说共得到了m组采样,每一组采样都是n维的。我们的目标是单单从这m组采样数据中分辨出每个人说话的信号。
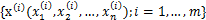
     将第二个问题细化一下,有n个信号源clip_image004,clip_image006,每一维都是一个人的声音信号,每个人发出的声音信号独立。A是一个未知的混合矩阵(mixing matrix),用来组合叠加信号s,那么

     clip_image008

     x的意义在上文解释过,这里的x不是一个向量,是一个矩阵。其中每个列向量是clip_image010,clip_image012

     表示成图就是

     clip_image014

     这张图来自

     http://amouraux.webnode.com/research-interests/research-interests-erp-analysis/blind-source-separation-bss-of-erps-using-independent-component-analysis-ica/

     clip_image033

     clip_image035的每个分量都由clip_image037的分量线性表示。A和s都是未知的,x是已知的,我们要想办法根据x来推出s。这个过程也称作为盲信号分离。

     令clip_image039,那么clip_image041

     将W表示成

     clip_image042

     其中clip_image044,其实就是将clip_image046写成行向量形式。那么得到:

     clip_image048

2. ICA的不确定性(ICA ambiguities)

     由于w和s都不确定,那么在没有先验知识的情况下,无法同时确定这两个相关参数。比如上面的公式s=wx。当w扩大两倍时,s只需要同时扩大两倍即可,等式仍然满足,因此无法得到唯一的s。同时如果将人的编号打乱,变成另外一个顺序,如上图的蓝色节点的编号变为3,2,1,那么只需要调换A的列向量顺序即可,因此也无法单独确定s。这两种情况称为原信号不确定。

     还有一种ICA不适用的情况,那就是信号不能是高斯分布的。假设只有两个人发出的声音信号符合多值正态分布,clip_image050,I是2*2的单位矩阵,s的概率密度函数就不用说了吧,以均值0为中心,投影面是椭圆的山峰状(参见多值高斯分布)。因为clip_image052,因此,x也是高斯分布的,均值为0,协方差为clip_image054。

     令R是正交阵clip_image056,clip_image058。如果将A替换成A’。那么clip_image060。s分布没变,因此x’仍然是均值为0,协方差clip_image062。

     因此,不管混合矩阵是A还是A’,x的分布情况是一样的,那么就无法确定混合矩阵,也就无法确定原信号。

3. 密度函数和线性变换

     在讨论ICA具体算法之前,我们先来回顾一下概率和线性代数里的知识。

     假设我们的随机变量s有概率密度函数clip_image064(连续值是概率密度函数,离散值是概率)。为了简单,我们再假设s是实数,还有一个随机变量x=As,A和x都是实数。令clip_image066是x的概率密度,那么怎么求clip_image066[1]?

     令clip_image039[1],首先将式子变换成clip_image068,然后得到clip_image070,求解完毕。可惜这种方法是错误的。比如s符合均匀分布的话(clip_image072),那么s的概率密度是clip_image074,现在令A=2,即x=2s,也就是说x在[0,2]上均匀分布,可知clip_image076。然而,前面的推导会得到clip_image078。正确的公式应该是

     clip_image080

     推导方法

     clip_image082

     clip_image084

     更一般地,如果s是向量,A可逆的方阵,那么上式子仍然成立。

4. ICA算法

     ICA算法归功于Bell和Sejnowski,这里使用最大似然估计来解释算法,原始的论文中使用的是一个复杂的方法Infomax principal。

     我们假定每个clip_image086有概率密度clip_image088,那么给定时刻原信号的联合分布就是

     clip_image090

     这个公式代表一个假设前提:每个人发出的声音信号各自独立。有了p(s),我们可以求得p(x)
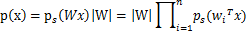
     clip_image092

     左边是每个采样信号x(n维向量)的概率,右边是每个原信号概率的乘积的|W|倍。

     前面提到过,如果没有先验知识,我们无法求得W和s。因此我们需要知道clip_image094,我们打算选取一个概率密度函数赋给s,但是我们不能选取高斯分布的密度函数。在概率论里我们知道密度函数p(x)由累计分布函数(cdf)F(x)求导得到。F(x)要满足两个性质是:单调递增和在[0,1]。我们发现sigmoid函数很适合,定义域负无穷到正无穷,值域0到1,缓慢递增。我们假定s的累积分布函数符合sigmoid函数

     clip_image096

     求导后

     clip_image098

     这就是s的密度函数。这里s是实数。

     如果我们预先知道s的分布函数,那就不用假设了,但是在缺失的情况下,sigmoid函数能够在大多数问题上取得不错的效果。由于上式中clip_image100是个对称函数,因此E[s]=0(s的均值为0),那么E[x]=E[As]=0,x的均值也是0。

     知道了clip_image100[1],就剩下W了。给定采样后的训练样本clip_image002[1],样本对数似然估计如下:

     使用前面得到的x的概率密度函数,得

     clip_image101

     大括号里面是clip_image103。

     接下来就是对W求导了,这里牵涉一个问题是对行列式|W|进行求导的方法,属于矩阵微积分。这里先给出结果,在文章最后再给出推导公式。

     clip_image105

     最终得到的求导后公式如下,clip_image107的导数为clip_image109(可以自己验证):

     clip_image110

     其中clip_image112是梯度上升速率,人为指定。

     当迭代求出W后,便可得到clip_image114来还原出原始信号。

     注意:我们计算最大似然估计时,假设了clip_image116与clip_image118之间是独立的,然而对于语音信号或者其他具有时间连续依赖特性(比如温度)上,这个假设不能成立。但是在数据足够多时,假设独立对效果影响不大,同时如果事先打乱样例,并运行随机梯度上升算法,那么能够加快收敛速度。

     回顾一下鸡尾酒宴会问题,s是人发出的信号,是连续值,不同时间点的s不同,每个人发出的信号之间独立(clip_image086[1]和clip_image120之间独立)。s的累计概率分布函数是sigmoid函数,但是所有人发出声音信号都符合这个分布。A(W的逆阵)代表了s相对于x的位置变化,x是s和A变化后的结果。

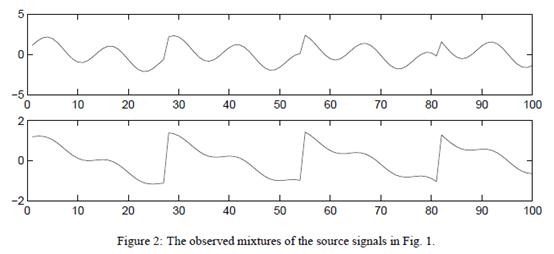
5. 实例

     clip_image122

     s=2时的原始信号

     clip_image124

     观察到的x信号

     clip_image126

     使用ICA还原后的s信号

6. 行列式的梯度

     对行列式求导,设矩阵A是n×n的,我们知道行列式与代数余子式有关,

     clip_image127

     clip_image129是去掉第i行第j列后的余子式,那么对clip_image131求导得

     clip_image132

     adj(A)跟我们线性代数中学的clip_image134是一个意思,因此

     clip_image135


7. ICA算法扩展描述

     上面介绍的内容基本上是讲义上的,与我看的另一篇《Independent Component Analysis:

Algorithms and Applications》(Aapo Hyvärinen and Erkki Oja)有点出入。下面总结一下这篇文章里提到的一些内容(有些我也没看明白)。

     首先里面提到了一个与“独立”相似的概念“不相关(uncorrelated)”。Uncorrelated属于部分独立,而不是完全独立,怎么刻画呢?

     如果随机变量clip_image002和clip_image004是独立的,当且仅当clip_image006。

     如果随机变量clip_image002[1]和clip_image004[1]是不相关的,当且仅当clip_image008

     第二个不相关的条件要比第一个独立的条件“松”一些。因为独立能推出不相关,不相关推不出独立。

     证明如下:
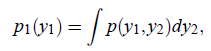
     clip_image009

     clip_image010

     clip_image012

     反过来不能推出。

     比如,clip_image002[2]和clip_image004[2]的联合分布如下(0,1),(0,-1),(1,0),(-1,0)。

     clip_image014

     因此clip_image002[3]和clip_image004[3]不相关,但是

     clip_image016

     因此clip_image002[4]和clip_image004[4]不满足上面的积分公式,clip_image002[5]和clip_image004[5]不是独立的。

     上面提到过,如果clip_image018是高斯分布的,A是正交的,那么clip_image020也是高斯分布的,且clip_image020[1]与clip_image022之间是独立的。那么无法确定A,因为任何正交变换都可以让clip_image020[2]达到同分布的效果。但是如果clip_image018[1]中只有一个分量是高斯分布的,仍然可以使用ICA。

     那么ICA要解决的问题变为:如何从x中推出s,使得s最不可能满足高斯分布?

     中心极限定理告诉我们:大量独立同分布随机变量之和满足高斯分布。
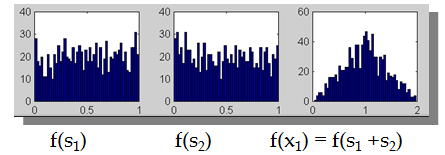
     clip_image023

     我们一直假设的是clip_image020[3]是由独立同分布的主元clip_image018[2]经过混合矩阵A生成。那么为了求clip_image018[3],我们需要计算clip_image018[4]的每个分量clip_image025。定义clip_image027,那么clip_image029,之所以这么麻烦再定义z是想说明一个关系,我们想通过整出一个clip_image031来对clip_image020[4]进行线性组合,得出y。而我们不知道得出的y是否是真正的s的分量,但我们知道y是s的真正分量的线性组合。由于我们不能使s的分量成为高斯分布,因此我们的目标求是让y(也就是clip_image033)最不可能是高斯分布时的w。

     那么问题递归到如何度量y是否是高斯分布的了。

     一种度量方法是kurtosis方法,公式如下:
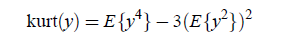
     clip_image034

     如果y是高斯分布,那么该函数值为0,否则绝大多数情况下值不为0。

     但这种度量方法不怎么好,有很多问题。看下一种方法:

     负熵(Negentropy)度量方法。

     我们在信息论里面知道对于离散的随机变量Y,其熵是
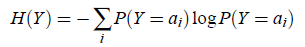
     clip_image035

     连续值时是

     clip_image036

     在信息论里有一个强有力的结论是:高斯分布的随机变量是同方差分布中熵最大的。也就是说对于一个随机变量来说,满足高斯分布时,最随机。

     定义负熵的计算公式如下:
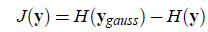
     clip_image037

     也就是随机变量y相对于高斯分布时的熵差,这个公式的问题就是直接计算时较为复杂,一般采用逼近策略。

     clip_image038

     这种逼近策略不够好,作者提出了基于最大熵的更优的公式:

     clip_image039

     之后的FastICA就基于这个公式。

     另外一种度量方法是最小互信息方法:

     clip_image040

     这个公式可以这样解释,前一个H是clip_image042的编码长度(以信息编码的方式理解),第二个H是y成为随机变量时的平均编码长度。之后的内容包括FastICA就不再介绍了,我也没看懂。

 
8. ICA的投影追踪解释(Projection Pursuit)

     投影追踪在统计学中的意思是去寻找多维数据的“interesting”投影。这些投影可用在数据可视化、密度估计和回归中。比如在一维的投影追踪中,我们寻找一条直线,使得所有的数据点投影到直线上后,能够反映出数据的分布。然而我们最不想要的是高斯分布,最不像高斯分布的数据点最interesting。这个与我们的ICA思想是一直的,寻找独立的最不可能是高斯分布的s。

     在下图中,主元是纵轴,拥有最大的方差,但最interesting的是横轴,因为它可以将两个类分开(信号分离)。

     clip_image043

9. ICA算法的前处理步骤

     1、中心化:也就是求x均值,然后让所有x减去均值,这一步与PCA一致。

     2、漂白:目的是将x乘以一个矩阵变成clip_image045,使得clip_image045[1]的协方差矩阵是clip_image047。解释一下吧,原始的向量是x。转换后的是clip_image045[2]。

     clip_image045[3]的协方差矩阵是clip_image047[1],即

     clip_image048

     我们只需用下面的变换,就可以从x得到想要的clip_image045[4]。

     clip_image049

     其中使用特征值分解来得到E(特征向量矩阵)和D(特征值对角矩阵),计算公式为
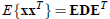
     clip_image050

     下面用个图来直观描述一下:

     假设信号源s1和s2是独立的,比如下图横轴是s1,纵轴是s2,根据s1得不到s2。

     clip_image051

     我们只知道他们合成后的信号x,如下

     image

     此时x1和x2不是独立的(比如看最上面的尖角,知道了x1就知道了x2)。那么直接代入我们之前的极大似然概率估计会有问题,因为我们假定x是独立的。

     因此,漂白这一步为了让x独立。漂白结果如下:

     clip_image053

     可以看到数据变成了方阵,在clip_image045[5]的维度上已经达到了独立。

     然而这时x分布很好的情况下能够这样转换,当有噪音时怎么办呢?可以先使用前面提到的PCA方法来对数据进行降维,滤去噪声信号,得到k维的正交向量,然后再使用ICA。

 
10. 小结

     ICA的盲信号分析领域的一个强有力方法,也是求非高斯分布数据隐含因子的方法。从之前我们熟悉的样本-特征角度看,我们使用ICA的前提条件是,认为样本数据由独立非高斯分布的隐含因子产生,隐含因子个数等于特征数,我们要求的是隐含因子。

     而PCA认为特征是由k个正交的特征(也可看作是隐含因子)生成的,我们要求的是数据在新特征上的投影。同是因子分析,一个用来更适合用来还原信号(因为信号比较有规律,经常不是高斯分布的),一个更适合用来降维(用那么多特征干嘛,k个正交的即可)。有时候也需要组合两者一起使用。这段是我的个人理解,仅供参考。

http://www.cnblogs.com/jerrylead/archive/2011/04/19/2021071.html
【机器学习】独立成分分析的基本概念、应用领域、具体实例(含python代码)以及ICA和PCA的联系和区别 在机器学习中,ICA广泛应用于信号处理、图像分析、生物医学信号处理等领域独立成分分析是一种有用的机器学习技术,用于从混合信号中提取出原始的独立信号。通过适当的预处理和算法选择,ICA可以有效地应用于各种场景,并提高数据的可解释性和分析性能。然而,在使用ICA时,需要考虑其局限性,并采取相应的措施来提高性能和准确性PCA和ICA都是强大的数据降维和特征提取工具,但它们的设计目标和假设不同。选择使用PCA还是ICA取决于具体的数据和应用场景。 阅读详情

相关推荐

【详细版】独立成分分析:算法和应用(一)

在神经网络研究以及许多其他学科中,**一个基本问题是找到合适的多元数据表示形式**,即随机向量。由于计算和概念上的简单性,通常希望将表示形式作为原始数据的线性变换。换句话说,表示的每个组成部分都是原始变量的线性组合。众所周知的线性变换方法包括主成分分析、因子分析和投影追踪(Projection Pursuit)。独立成分分析(ICA)是最近开发的一种方法,其目的是找到非高斯数据的线性表示形式,从而使成分在统计上独立或尽可能独立。这样的表示似乎捕获了许多应用中数据的基本结构,包括特征提取和信号分离。在本文中,

snail9610的博客 4260

独立成分分析(Independent Component Analysis,ICA)详解

独立成分分析(Independent Component Analysis,简称ICA)是一种用于多维信号分离的统计方法,旨在将多个混合信号分解为独立的成分。它能够从混合信号中恢复出原始信号的独立成分,帮助我们理解信号的内在结构和特征。库,我们演示了独立成分分析(ICA)的实现过程,以分离混合信号中的独立成分为例。通过对观测信号进行ICA分析,可以将原始信号中的噪音成分与真实信号成分分离开来,从而实现信号的去噪处理。从绘制的图形中可以看出,分离后的信号与原始信号相似,成功地实现了信号的分离。

深度学习客 1万+

独立成分分析(Independent Component Analysis,ICA)原理及代码实现

过程监控中会用到很多中方法,如主成分分析(PCA)、慢特征分析(SFA)、概率MVA方法或独立成分分析(ICA)等为主流算法。 其中PCA主要多用于降维及特征提取,且只对正太分布(高斯分布)数据样本有效;SFA被用来学习过程监控的时间相关表示,SFA不仅可以通过监测稳态分布来检测与运行条件的偏差,还可以根据时间分布来识别过程的动态异常,多用于分类分析;概率MVA方法,多以解决动力学、时变、非线性等问题。 今天要介绍的是独立成分分析(ICA),由浅入深,细细道来。 此外文末还附有ICA可实现的代码哟~不要错过

车手只需要车和手,压力来自轮胎 1万+

详解独立成分分析

最近在学习数据降维的一些方法(有关数据降维的其他内容请看这篇文章),虽然独立成分分析不算是严格意义上的降维方法,但是它和PCA有着千丝万缕的联系,所以打算专门写一篇文章来学习ICA的相关知识,看了挺多的关于ICA的博文,有些文章讲的比较详细。有句话是这么说的:“论文是详细版的知识讲解”,也就是说如果想深入详细的了解某个知识,那么去读相关论文,所以阅读了一篇经典的ICA论文,作者是A. Hyva¨r...

Tonywu2018的博客 4万+

独立成分分析(Independent Component Analysis, ICA)详解

独立成分分析(ICA)作为一种强大的统计信号处理技术,广泛应用于多个领域,包括信号处理、图像分析、生物医学信号处理和语音分离等。通过从混合信号中提取出相互独立的成分,ICA不仅能够有效地去除噪声和伪影,还能实现盲源分离,帮助我们更好地理解和分析复杂的数据。在本文中,我们通过多个具体项目代码示例,展示了ICA在实际应用中的实现过程和效果。这些示例不仅为读者提供了实用的代码框架,也为深入理解ICA的理论基础和应用场景奠定了基础。

不迁怒,不贰过。小知识,大智慧。 7089

尝试理解ICA(Independent Component Analysis)独立成分分析

1.从鸡尾酒会问题(cocktail party problem)说起 ICA最早是从神经网络领域开始研究的,为了简单,我们这里从一个经典的例子开始——盲源信号分离(blind signal separation)。 假设在一个开party的房间里有两个人同时说话,房间里两个不同的位置上各放个麦克风,记录了两段声音(时间信号),x1(t)和x2(t),这两段声音都记录了两个人说的话,我们怎

ChuanjieZhu 1万+

独立成分分析 Independent Component Analysis

独立成分分析 Independent Component Analysis独立成分分析 Independent Component Analysis一. 问题引入二. ICA -- 最大似然估计2.1 ICA Ambiguities2.2 ICA Algorithm 独立成分分析 Independent Component Analysis 一. 问题引入 盲源分离问题(Blind Source ...

怅惘银河的技术博客 822

脑电独立成分分析(independent component analysis)

相比其它成像方法,EEG更为便捷低价,无论是拿erp成分还是做时频分析,提高信噪比始终是EEG分析的重点。将ICA应用在EEG分析中,可以较好的识别并去掉眼动和其它噪音(heart beat,line noise,muscle noise)。但对ICA分析前的预处理和后期成分的识别,缺少详细的说明。 以下的分析方法主要参考EEGLAB给的非官方说明,tutorial的第九章和第十章,Boy Lu...

weixin_42750769的博客 9531

独立成分分析(Independent Component Analysis, ICA)

 独立成分分析(Independent Component Analysis, ICA)是近年来出现的一种强有力的数据分析工具(Hyvarinen A, Karhunen J, Oja E, 2001; Roberts S J, Everson R, 2001)。1994年由Comon给出了ICA的一个较为严格的数学定义,其思想最早是由Heranlt和Jutten于1986年提出来的。ICA从

bluenight专栏 9262

ICA--独立成分分析(Independent Component Analysis)

ICA--独立成分分析(Independent Component Analysis)

yffhhffv的博客 1342

三维荧光光谱(EEM)散射干扰实战:从识别到精准切除的完整流程

本文详细解析三维荧光光谱(EEM)中散射干扰的识别与精准切除流程,涵盖瑞利散射和拉曼散射的实战处理技巧。通过drEEM工具箱的应用示例和高级场景解决方案,帮助研究者有效消除散射干扰,提升数据准确性,特别适用于环境样品和生物活体样本分析。

weixin_42554042的博客 327

独立成分分析(Independent Component Analysis,ICA)模型介绍

目录独立成分分析(Independent Component Analysis,ICA)模型介绍1 历史背景2 ICA基本模型3 独立与不相关 独立成分分析(Independent Component Analysis,ICA)模型介绍 你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你想学习如何使用Markdown编辑器, 可以仔细阅读这篇文章,了解一下Markdown的基...

weixin_43609115的博客 4667

基于STM32的智能工业机器人臂控制系统

工业机器人臂是智能制造的核心组件,广泛应用于装配、焊接、搬运等任务。基于STM32微控制器的机器人臂控制系统,通过集成伺服电机驱动、运动规划算法和实时通信功能,实现对多轴机械臂的精确控制与路径规划。本设计通过STM32实现了一套智能工业机器人臂控制系统,集成了高效的运动规划算法和实时控制功能。机器人臂系统根据输入的目标位置(如工件坐标),通过运动学计算生成动作轨迹,利用伺服电机驱动器控制关节运动。该系统广泛应用于工业自动化场景,如汽车制造中的零件装配、电子产品生产中的元件焊接以及物流系统中的物料搬运。

stm32d1219的博客 2568

独立成分分析(Independent Component Analysis)开源项目教程

独立成分分析(Independent Component Analysis)开源项目教程 项目介绍 独立成分分析(Independent Component Analysis,简称ICA)是一种用于从混合信号中分离出独立源信号的统计方法。该项目提供了一个基于Python的ICA实现,旨在帮助用户理解和应用ICA技术。项目源码托管在GitHub上,地址为:https://github.com/akc...

gitblog_00983的博客 564

SEED-VIG数据集实战:5步搞定驾驶员疲劳检测模型(附Python代码)

本文提供了一份基于SEED-VIG数据集的驾驶员疲劳检测模型实战指南。通过五个核心步骤——数据准备、特征提取、模型训练、优化评估及部署思路,详细讲解了如何利用脑电信号构建分类器,并附有完整的Python代码,帮助开发者快速上手这一智能座舱关键技术。

w1x2y3的博客 263

RabbitMq安装

本文详细介绍了在CentOS7系统上离线部署RabbitMQ4.3.2的完整流程。主要内容包括:1)准备RabbitMQ安装包、Erlang依赖和socat网络工具;2)安装系统编译依赖并编译安装Erlang;3)部署RabbitMQ服务,配置环境变量和socat依赖;4)启用Web管理插件并创建管理员账号;5)配置防火墙放行端口;6)设置Systemd开机自启服务;7)提供常用运维命令。文档特别强调离线部署注意事项,包括socat依赖、版本兼容性、账号安全及主机名配置等问题,为生产环境部署提供完整解决方案

sinat_25821779的博客 323

什么是独立成分分析(ICA, Independent Component Analysis)

*独立成分分析(ICA, Independent Component Analysis)**是一种用于信号处理的统计技术,旨在将多变量信号分解为统计独立的非高斯信号成分。ICA广泛应用于各类信号处理领域,如脑电图(EEG)、语音信号处理、图像处理等。特别是在盲源分离(Blind Source Separation, BSS)问题中。

GuFrank的博客 986

基于 FPGA Vivado 信号发生器设计(附源工程)

今天给大侠带来基于 FPGA Vivado 信号发生器设计,开发板实现使用的是Digilent basys 3,如有想要入手basys3开发板的,可以联系牛总:18511371833。话不多说,上货。 本篇掌握基于 FPGA Vivado 信号发生器设计(附源工程),掌握基于添加文件和IP的Vivado工程设计流程,掌握基于Tcl的Vivado工程设计流程,学习信号发生器的基本组成结构。获取本篇相关源工程代码,可在公众号内回复“信号发生器设计源工程”。 设计原理 信号发生器...

7990
上一篇: 线性判别分析(Linear Discriminant Analysis)
下一篇: Gradient Boost Decision Tree(模型测试报告)
ffeng271
博客等级 码龄19年 139粉丝 0原创
评论 5
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值