深度解析MobileNetV2:倒置残差与线性瓶颈及PyTorch实现

MobileNetV2:架构创新、结构剖析与代码实现 本文聚焦于 MobileNetV2 卷积神经网络,旨在深入剖析其架构特点与实现细节。首先介绍了 MobileNetV2 提出的背景,指出其是为弥补 MobileNetV1 的不足而设计。接着详细阐述了该网络的创新点,如倒残差结构、Relu6 激活函数等,分析了这些创新对模型性能的提升作用。随后对网络结构进行了说明,解释了架构表中各参数的意义。最后给出了基于 PyTorch 的代码实现,并进行了模型测试。研究表明,MobileNetV2 在轻量性和高性能方面表现出色,为移动设备和嵌入式系统的视觉应用提供了有效 阅读详情
AI摘要

本文深入解析了MobileNetV2的结构特点,包括倒残差模块、深度卷积、逐点卷积及线性瓶颈的概念,并详细介绍了如何使用PyTorch实现MobileNetV2网络。

广告位:

图像拼接论文精读专栏
—— 图像拼接领域论文全覆盖(包含数据集),省时省力读论文,带你理解晦涩难懂的论文算法,学习零散的知识和数学原理,并学会写图像拼接领域的论文(介绍、相关工作、算法、实验、结论、并附有参考文献,不用一篇一篇文章再找)

图像拼接论文源码精读专栏
—— 图像拼接有源码的论文全覆盖(有的自己复现),帮助你通过源码进一步理解论文算法,助你做实验,跑出拼接结果,得到评价指标RMSE、SSIM、PSNR等,并寻找潜在创新点和改进提升思路。

超分辨率重建专栏
—— 从SRCNN开始,带你读论文,写代码,复现结果,找创新点,完成论文。手把手教,保姆级攻略。帮助你顺利毕业,熟练掌握超分技术。

有需要的同学可以点上面链接看看。


文章目录

简介

前言:最近在看EfficientNet,里面用到了与MobileNetV2相似的结构,所以找来看一下并记录。

MobileNetV2是一个轻量化网络,论文题目和地址如下:

论文题目:MobileNetV2: Inverted Residuals and Linear Bottlenecks

论文地址:
https://arxiv.org/abs/1801.04381

重点干货

  1. 倒残差模块/反向残差模块(Inverted Residuals)
  2. 线性瓶颈(Linear Bottleneck)

其中,倒残差模块中还用了
深度卷积(Depthwise Convolution,DW)
和
逐点卷积(Pointwise Convolution,PW)

,我们后续介绍。

倒残差模块/反向残差模块(Inverted Residuals)

深度卷积(Depthwise Convolution,DW)
  • 深度卷积(Depthwise Convolution,DW)
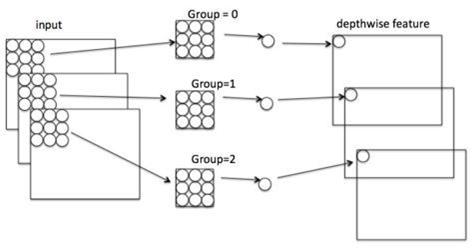
    :完全在二维平面上进行,一个卷积核负责一个通道;一个通道只被一个卷积核卷积。结构如下图:
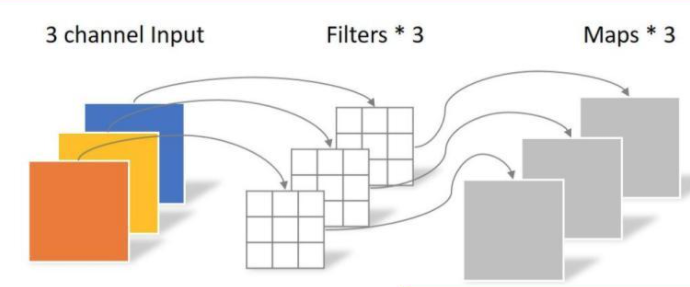
可以看到,DW操作的输入通道数=Feature Map数=输出通道数,且每个通道之间无相互关联,单独进行卷积运算,就相当于分组进行了计算。在Pytorch中可以用nn.Conv2d()实现。

torch.nn.Conv2d(in_channels, out_channels, kernel_size, stride=1, padding=0, dilation=1, groups=1,bias=True)

其中参数含义分别为:(

输入通道

,

输出通道

,卷积核大小,步长,补0,卷积核间隙,

分组

,偏置)。实现倒残差模块应该设置

in_channels=out_channels=groups

由于DW操作每个通道单独操作,没有利用不同通道的feature信息,所以需要PW操作来整合不同通道的信息,产生新的特征

逐点卷积(Pointwise Convolution,PW)
  • 逐点卷积(Pointwise Convolution,PW)
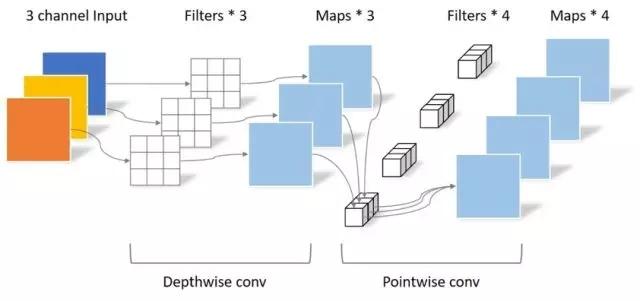
    :卷积核大小为1×1×in_channels,将上一步操作的特征图在通道方向上加权组合,生成新的feature map,大小与输入一致。以较小的计算量进行降维或者升维操作,"混合"通道信息。

就是一个1×1卷积,输出通道数改变。

nn.Conv2d(in_channels,out_channels,kernel_size=1,padding=0,bias=False)

将DW操作和PW操作结合起来,叫
深度分离卷积(Depthwise Separable Convolutions)
,整体结构如下:
  • 倒残差模块
    :输入经过1×1卷积进行通道扩张(通过增加卷积核的个数扩大通道数,文中扩大6倍),然后使用3×3的DW,最后用1×1的PW将通道压缩回去。

线性瓶颈(Linear Bottleneck)

作者的结论:

  1. If the manifold of interest remains non-zero volume after ReLU transformation, it corresponds to a linear transformation
  2. ReLU is capable of preserving complete information about the input manifold, but only if the input manifold lies in a low-dimensional subspace of the input space.

经过一系列特征提取过程后,会产一个兴趣流形,如果它经过ReLU后得到非零结果,那它就对应一个线性变换。ReLU只有当输入流形存在于输入空间低维度时才可以完整保存输入流形的信息。

个人理解:轻量级网络的思想就是降维,减少参数。但是降维的话ReLU会损失更多的信息,而ReLU没有损失的部分就相当于一个线性分类器。所以干脆直接用线性分类器来提高性能。

总结:将PW操作的激活函数由ReLU换成Linear

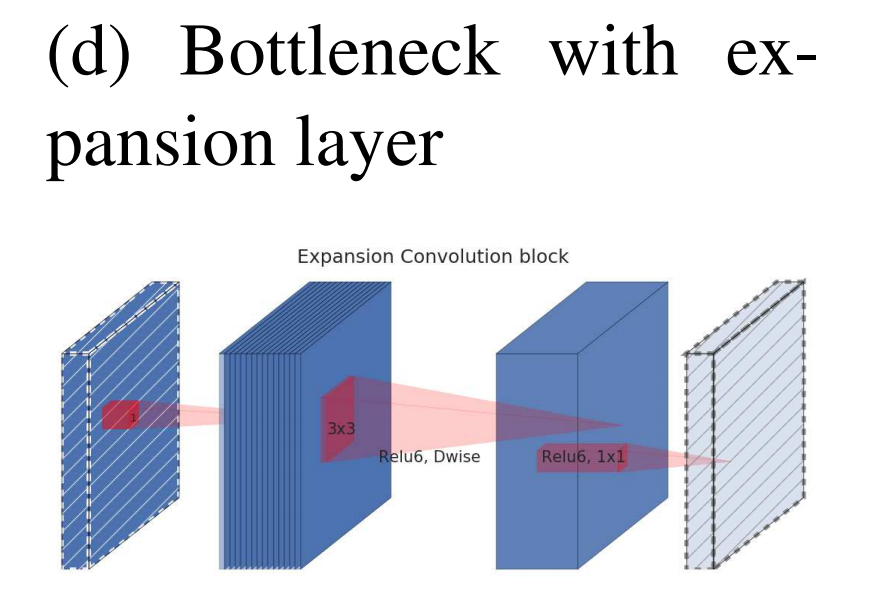
将线性瓶颈应用到倒残差模块中,结构如下:
MobileNetV2整体结构与具体网络参数

MobileNetV2网络的整体结构如下
:
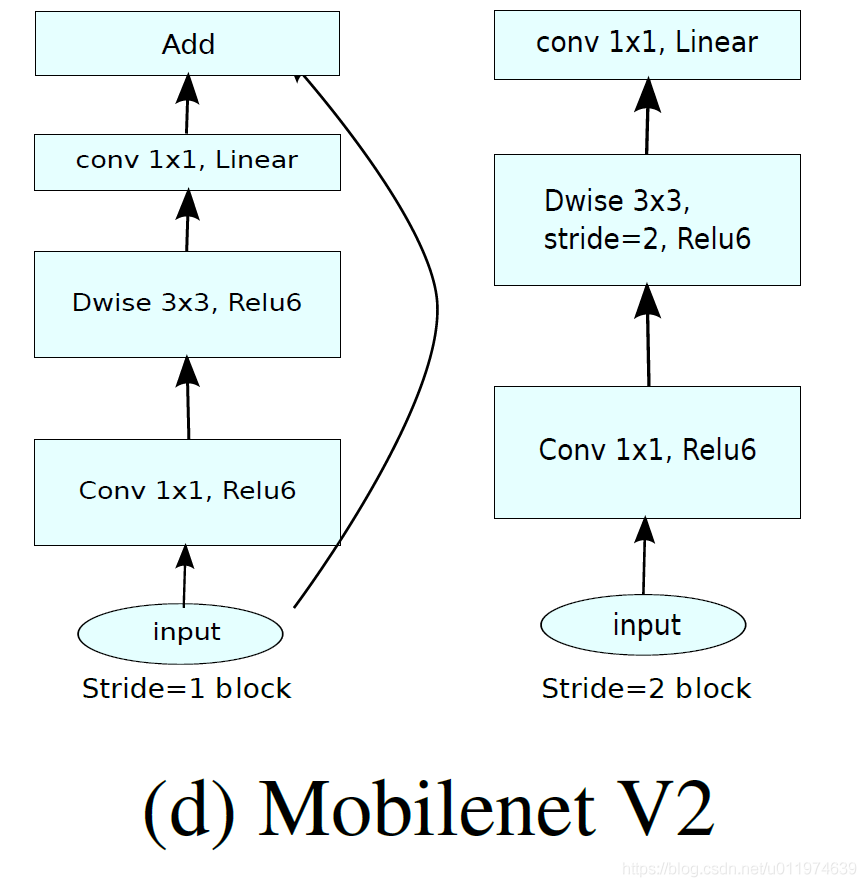
  • stride = 1时,输入先经过一个1×1卷积和ReLU6,再经过一个3×3的DW操作,其中padding=1(保证输入和输出大小相同),再经过一个1×1的PW操作,最后通过shortcut将PW后的结果与初始相加得到最终结果。

只有当步长为1且in_channels!=out_channels时才使用shortcut,否则shortcut无意义

  • stride = 2时,省略shortcut操作

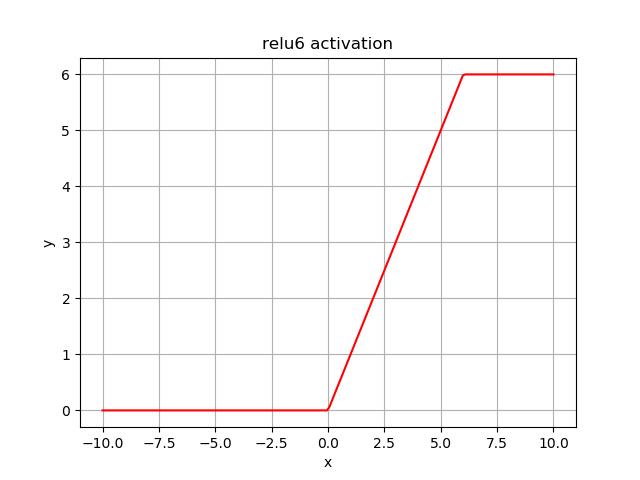
ReLU6:

f

(

x

)

=

m

i

n

(

m

a

x

(

0

,

x

)

,

6

)

f(x) = min(max(0,x),6)

f

(

x

)

=

min

(

ma

x

(

0

,

x

)

,

6

)
具体网络参数如下
:
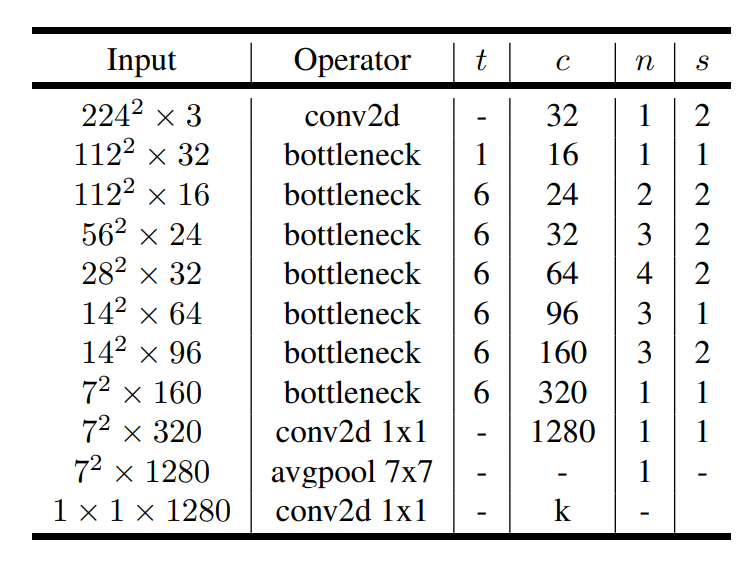
其中,t代表扩张倍数;c代表输出通道数;n代表该层重复n次;s为步长。

注意
:

All layers in the same sequence have the same

number c of output channels. The first layer of each

sequence has a stride s and all others use stride 1.

  • 重复层序列的输出通道数都相同
  • 重复层中的第一层的步长为s,其余均为1

Pytorch实现MobileNetV2

线性瓶颈块:

import torch
import torch.nn as nn

class BottleNeck(nn.Module):
    def __init__(self, in_channels, out_channels, stride, t):
        super().__init__()
        self.conv = nn.Sequential(
            nn.Conv2d(in_channels, in_channels*t, 1, bias=False),
            nn.BatchNorm2d(in_channels*t),
            nn.ReLU6(inplace=True),
            nn.Conv2d(in_channels*t, in_channels*t, 3, stride=stride, padding=1, groups=in_channels*t, bias=False),
            nn.BatchNorm2d(in_channels*t),
            nn.ReLU6(inplace=True),
            nn.Conv2d(in_channels*t, out_channels, 1, bias=False),
            nn.BatchNorm2d(out_channels)
        )
        self.shortcut = nn.Sequential()
        if stride == 1 and in_channels != out_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, 1, bias=False),
                nn.BatchNorm2d(out_channels)
            )
            
        self.stride = stride
    def forward(self, x):
        out = self.conv(x)
        if self.stride == 1:
            out += self.shortcut(x)
        return out

MobileNetV2整体:

class MobileNetV2(nn.Module):
    def __init__(self, class_num=1000):
        #根据自己数据集的分类类别修改class_num
        super().__init__()
        self.conv1 = nn.Sequential(
            nn.Conv2d(3, 32, 3, stride=2, padding=1, bias=False),
            nn.BatchNorm2d(32),
            nn.ReLU6(inplace=True)
        )
        #cin,cout,t,n,s
        self.bottleneck1 = self.make_layer(32, 16, 1, 1, 1)
        self.bottleneck2 = self.make_layer(16, 24, 6, 2, 2)
        self.bottleneck3 = self.make_layer(24, 32, 6, 3, 2)
        self.bottleneck4 = self.make_layer(32, 64, 6, 4, 2)
        self.bottleneck5 = self.make_layer(64, 96, 6, 3, 1)
        self.bottleneck6 = self.make_layer(96, 160, 6, 3, 2)
        self.bottleneck7 = self.make_layer(160, 320, 6, 1, 1)
        self.conv2 = nn.Sequential(
            nn.Conv2d(320, 1280, 1, bias=False),
            nn.BatchNorm2d(1280),
            nn.ReLU6(inplace=True)
        )
        self.avgpool = nn.AdaptiveAvgPool2d(1)
 
        self.linear = nn.Linear(1280, class_num)
        
    def make_layer(self,in_channels, out_channels,t,n,s):
        layers = []
        #第一层
        layers.append(BottleNeck(in_channels, out_channels, s, t))
        while n-1:
        	#其他重复层,输入输出通道相同,步长为1
            layers.append(BottleNeck(out_channels, out_channels, 1, t))
            n -= 1
            
        #layers是所有Bottleneck块列表,每个元素是Bottleneck块,*将layers拆成每个元素
        return nn.Sequential(*layers)
    
    def forward(self, x):
        #2,3,32,32
        x = self.conv1(x)
        #2,3,32,32
        x = self.bottleneck1(x)
        x = self.bottleneck2(x)
        x = self.bottleneck3(x)
        x = self.bottleneck4(x)
        x = self.bottleneck5(x)
        x = self.bottleneck6(x)
        x = self.bottleneck7(x)
        #2,320,4,4
        x = self.conv2(x)
        #2,1280,4,4
        x = self.avgpool(x)
        #2,1280,1,1
        x = torch.flatten(x,1)
        #2,1280
        x = self.linear(x)
        #2,1000
        return x

测试网络结构:

def test():
    net = MobileNetV2()
    x = torch.randn(2,3,32,32)
    y = net(x)
    #print(y.size())
    
test()

没有硬件条件,需要云服务的同学可以扫码看看:

【轻量级网络】MobileNet-v2详解 论文:《Inverted Residuals and Linear Bottlenecks: Mobile Networks for Classification, Detection and Segmentation》 论文链接:https://arxiv.org/abs/1801.04381 前文链接:MobileNet-v1详解 – 概述        MobileNet-v2的主要思想就是在v1的基础上引入了线性瓶颈 (Linea 阅读详情

相关推荐

轻量级网络——MobileNetV2

1.MobileNetV2的介绍 MobileNet v2网络是由google团队在2018年提出的,相比MobileNet V1网络,准确率更高,模型更小。 网络中的亮点 : Inverted Residuals (倒残差结构 ) Linear Bottlenecks(结构的最后一层采用线性层) 2.MobileNetV2的结构 1)Inverted Residuals 在之前的ResNet残差结构是先用1x1的卷积降维,再升维的操作。而在MobileNetV2中,是先升维,在降维的操作。 所以对于

Clichong 4万+

MobileNetV2:Inverted Residuals and Linear Bottlenecks

①本文提出了一种新的移动端架构MobileNet V2,在当前移动端模型中最优;

just 2434

MobileNet系列(2):MobileNet-V2 网络详解

MobileNet-V2论文:Inverted Residuals and Linear Bottlenecks, MobileNet-V2网络是由google团队在2018年提出的,相比MobileNetV1网络,。网络中的亮点Resnet 网络提供的残差结构

@bangbang的博客 1万+

MobileNetV2: Inverted Residuals and Linear Bottlenecks--M Sandler

本文描述了一种新的用于移动和嵌入式设备的架构MobileNetV2,该架构提高了多个任务和基准数据集上以及不同模型尺寸内的最佳性能。MobileNetV2基于倒置的残差结构,残差链接位于窄的瓶颈之间。中间层使用深度可分离卷积进行滤波(提取)特征。此外作者发现去除窄层的非线性对于保持表征能力非常重要然后在ImageNet分类、COCO对象检测、VOC图像分割上进行了性能测试。我们评估了精度和通过乘法加法(MAdd)度量的操作数量,以及实际延迟和参数数量之间的权衡。好!

xu.hyj 1589

从Residual到MBConv:卷积块设计的进化史与性能优化策略

本文深入探讨了卷积神经网络中从Residual到MBConv的卷积块设计演进历程,重点分析了Residual、BottleNeck、Inverted Residual和MBConv等关键技术的数学原理与工程优化。通过PyTorch实现示例和性能对比,揭示了这些设计在提升模型表现、降低计算复杂度和优化内存使用方面的优势,为移动端AI应用提供了实用部署策略。

weixin_29032489的博客 388

【轻量化网络系列(2)】MobileNetV2核心创新:倒残差与线性瓶颈的实战解析与PyTorch实现

本文深入解析MobileNetV2轻量化网络的核心创新——倒残差结构与线性瓶颈层,通过PyTorch代码实现展示其高效特征提取机制。该设计通过升维-卷积-降维的倒置流程,有效解决低维空间信息丢失问题,在移动端设备上实现72%的ImageNet分类准确率,参数量仅3.4M。文章包含完整的网络架构实现和性能对比数据,为轻量化模型开发提供实用参考。

weixin_30732487的博客 211

MobileNetV2实战:用PyTorch从零搭建轻量级CNN(附完整代码)

本文提供了使用PyTorch从零搭建MobileNetV2轻量级卷积神经网络的完整实战指南。文章深入解析了其核心创新——倒置残差与线性瓶颈结构的设计原理,并提供了详尽的代码实现、模型缩放技巧及训练优化策略,帮助开发者高效部署模型至移动端与嵌入式设备。

kotlin6android的博客 656

【人工智能之深度学习】8. 轻量化网络设计:MobileNet V2倒残差结构全解析与部署实战

摘要:随着移动端与嵌入式设备对AI能力的需求激增,轻量化神经网络成为研究热点。MobileNet V2作为轻量化网络的里程碑之作,通过创新的倒残差结构和线性瓶颈理论,在保持较高准确率的同时大幅降低了模型参数量与计算量。本文从数学原理出发,系统拆解倒残差结构的设计逻辑,对比标准残差与倒残差的核心差异;深入解析线性瓶颈理论如何解决ReLU在低维特征空间的信息丢失问题;基于PyTorch实现完整的MobileNet V2模型,并详细讲解每一层的设计细节。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 3375

从代码到部署:MobileNetV2.pytorch实战指南,3行代码实现图像分类

MobileNetV2.pytorch是一个高效的深度学习项目,提供了在ImageNet数据集上准确率达72.8%的MobileNetV2 1.0模型以及一系列预训练模型,帮助开发者轻松实现图像分类功能。 ## 🚀 快速上手:3行代码实现图像分类 想要使用MobileNetV2.pytorch实现图像分类非常简单,只需以下几个步骤: ### 1️⃣ 克隆项目仓库 首先,克隆项目到本地:

gitblog_00171的博客 1343

从零手写PyTorch MobileNetV2:倒残差块与线性瓶颈深度解析

深度可分离卷积是轻量级网络的基石,它通过逐通道与逐点卷积的拆分大幅降低计算量。MobileNetV2在此基础上引入倒残差块与线性瓶颈设计,将特征先升维再降维,并在线性投影中舍弃ReLU,从而减少低维空间的信息损失。这一设计不仅影响模型精度,也直接关系到移动端部署时的显存占用与推理速度。理解其实现原理后,便可将模型灵活改造为检测或分割任务的backbone。针对PyTorch框架,手动重写MobileNetV2能帮助开发者摆脱仅调用接口的局限,深入掌握每一层张量的变化与超参数的作用。与此同时,训练过程中的优化

weixin_33860528的博客 242

MobileNetV2原理与PyTorch实现:从倒残差结构到训练部署全解析

在深度学习中,轻量级神经网络设计旨在平衡精度与计算效率,深度可分离卷积通过将标准卷积分解为逐通道卷积与逐点卷积,显著降低参数量。MobileNetV2引入倒残差结构与线性瓶颈,进一步提升特征表达能力,使其成为移动端与边缘设备上图像分类任务的理想选择。本文基于PyTorch框架,完整解析MobileNetV2的网络结构拆解、关键代码实现、训练配置优化以及常见踩坑问题,涵盖从环境搭建、模型搭建、预训练权重加载到推理加速的工程实践。对于希望将深度学习算法落地到资源受限场景的开发者,这是一份可直接参考的完整指南。

weixin_29031057的博客 310

MobileNetV2倒残差结构详解:从原理到PyTorch实现(附完整代码)

本文深入解析了MobileNetV2的核心创新——倒残差结构。通过对比经典残差结构,详细阐述了其“先扩张后压缩”的设计原理与线性瓶颈层的作用,揭示了其在轻量化网络设计中兼顾效率与精度的优势。文章提供了完整的PyTorch实现代码,帮助开发者从理论到实践全面掌握这一关键技术。

p5l2m9n4o6q的博客 542

利用PyTorch手写MobileNetV2:从倒残差结构到移动端部署实战

轻量级卷积神经网络是边缘计算与移动端视觉推理的重要基础,其核心设计往往围绕卷积算子的高效重构展开。深度可分离卷积将标准卷积分解为逐通道与逐点两步,大幅压缩计算量;而倒残差结构则通过先扩张后压缩的瓶颈设计,在低维空间保留特征信息,避免非线性激活造成不可逆损失。MobileNetV2正是以这两项技术为支柱,以百万级参数量实现接近经典网络的精度,被广泛应用于手机端图像分类、树莓派目标检测等延迟敏感场景。工程实践中,从PyTorch从零搭建模型、调整宽度超参,到加载预训练权重做迁移学习,再到INT8量化与ONNX导

weixin_34221775的博客 610

MobileNetV2实战:如何在树莓派上部署轻量级图像分类模型(附PyTorch代码)

本文详细介绍了如何在树莓派上部署并优化MobileNetV2轻量级图像分类模型。通过解析其倒置残差结构和线性瓶颈层设计,结合模型量化、ARM NEON指令集优化等实战技巧,大幅提升嵌入式设备的推理效率。文章提供了完整的PyTorch代码和部署方案,帮助开发者在资源受限的树莓派上实现实时图像分类应用。

722

PyTorch手写MobileNetV2:倒残差块原理与避坑全解析

轻量级卷积神经网络是移动端视觉识别的重要基础,其核心设计如深度可分离卷积与倒残差结构,能够在控制计算量的同时保持较高精度。理解倒残差块中的线性瓶颈、ReLU6激活以及通道升降维原理,是用PyTorch手写和调优MobileNetV2模型的关键前提。这类网络在模型部署到边缘设备时,常遇到输出维度对齐、BN动量选择、Dropout位置以及ONNX静态校验等工程问题。围绕MobileNetV2从结构配置、前向验证、训练策略到常见踩坑记录,系统梳理完整实现流程与部署细节,帮助开发者快速复现并实际应用移动端图像分类模

weixin_29054245的博客 179

通道翻倍反而更快?MobileNetV2深度可分离卷积与线性瓶颈全解析

卷积神经网络(CNN)的轻量化设计是移动端AI落地的核心挑战。标准卷积同时建模空间与通道相关性,计算量随通道数平方增长;深度可分离卷积将其解耦为逐通道空间滤波与逐点通道混合,在Pytorch中通过groups参数即可高效实现,参数量大幅下降。然而单纯减少计算量会导致信息损失,MobileNetV2以线性瓶颈替代低维空间中的ReLU激活,避免特征流形塌缩,并采用反向残差结构让梯度在窄连接上顺畅回传。这些机制共同构成了高效信息流动的轻量级网络设计范式。在工程实践中,BatchNorm对batch size敏感、

weixin_29084231的博客 208

MobileNetV4 Conv Medium模型架构深度解析:Conv模块与设计哲学

MobileNetV4 Conv Medium是谷歌最新一代移动端视觉模型的代表,专门为移动设备和边缘计算场景优化设计。作为MobileNetV4系列中的中型Conv版本,它在性能和效率之间找到了完美的平衡点,为移动端AI应用提供了强大的图像分类和特征提取能力。 ## 🚀 MobileNetV4 Conv Medium核心特性概览 **模型规格**: - **参数量**:23.6M(百万参数

gitblog_00789的博客 692

autoDL算力云装Xinference[坑与步骤]

在页面直接点击下载会出现下着下载进度条消失,试了几次才出现这个报错,现在我们就继续安装缺少的包吧。这一步成功绕开了系统盘空间限制。先租用一个合适的服务器,建议不要选最新版本,跟我选的一样即可,不然后面会出现。最近在 AutoDL 上尝试部署。🚫 不要直接使用以下命令。点击下面链接即可打开。

ngadminq的博客 2382

手把手教你用PyTorch复现MobileNetV2:从倒残差结构到完整模型搭建

本文详细介绍了如何使用PyTorch复现MobileNetV2轻量级神经网络,重点解析了倒残差结构的实现细节和工程优化技巧。通过代码示例和实战分析,帮助开发者掌握从基础模块构建到完整模型搭建的全过程,适用于移动端CV任务的高效部署。

weixin_29054195的博客 310

SAP ERPsim生产拓展实验报告

ERP课的实验和实践,也是SAP竞赛玩的东西,除了界面不华丽外很像游戏而且是团队型的pvp大乱斗

m0_67262022的博客 2020

基于Qt与PaddleOCR的跨平台OCR工具开发实战

本文详细介绍了基于Qt与PaddleOCR开发跨平台OCR工具的实战经验。通过Qt的跨平台特性和PaddleOCR的高效识别能力,开发者可以快速构建支持Windows、Linux和macOS的OCR工具。文章涵盖了环境配置、核心功能实现、性能优化及打包发布等关键环节,特别针对中文识别、内存管理和多线程处理等常见问题提供了解决方案。

weixin_30296405的博客 89
上一篇: GPT模型背后:数据驱动的人工智能技术揭秘
下一篇: 视觉语言动作模型:从网页知识到机器人控制的实战RT-2
fengbeely
博客等级 码龄2年 957粉丝 108原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值