


写在前面:本文写于 2026 年 8 月。作者在编程行业和量化领域从业不到十年,属于「见过猪跑也挨过猪拱」的中间层。文中所有观点只代表个人经验,所有数据都标了来源和口径,不构成任何投资建议。
零、一个让我不知道怎么回答的问题
上个月同学聚会,一个做后端的老同学端着酒杯凑过来:
“你不是搞量化的吗?现在都 2026 年了,Claude 都能直接在 Excel 里给你建模了,你直接让它写个策略,不就财富自由了?”
我当时的第一反应是想笑,第二反应是发现——他是认真的。而且不止他一个人这么想。
这两年我在知乎、在群里、在朋友的私信里,反复看到同一个逻辑链条:
AI 很聪明 → 股市需要聪明 → 所以 AI 能在股市里赚钱 → 所以我用 AI 就能赚钱
这四步,每一步单独看都不算错,连起来却是错的。错的地方不在 AI,在于**「聪明」和「赚钱」之间,隔着好几层结构性的东西**:数据的时间性、市场的博弈性、交易的摩擦性,以及最后那个谁都躲不掉的——容量。
这篇文章我想尽量诚实地把这几层拆开。用 Claude 举例,是因为它是我日常用得最多的模型,也是目前在金融场景里被机构落地得最深的一个;但换成任何一个模型,结论都不会变。
先给结论,赶时间的可以只看这段:
AI 在 A 股能帮你拿到的结果,几乎全部集中在「研究效率」和「工程效率」上,而不是「预测能力」上。
前者是实打实的、可复现的、今天就能兑现的;后者到目前为止,公开可验证的证据基本是负面的。
把 AI 当成一个不知疲倦、读得极快、代码写得不错的初级研究员,你会赚到;把它当成一个能算出明天涨哪只的先知,你会亏钱,而且会亏得很有仪式感。
下面展开。
考虑到国内订阅claude确实有点困难,可以参考一下这里:claudemax.shop
一、先给 AI 一个公道:它在金融里是真能干活的
我不想写成一篇「AI 无用论」,那是另一种偏见。事实上,2025 到 2026 这一年多,AI 在金融机构里的落地速度,比我预期的快得多。
以 Anthropic 为例,2025 年 10 月他们扩展了 Claude for Financial Services,加了 Excel 插件、实时行情与组合分析的连接器,还有一批预置的 Agent Skills,比如直接建 DCF 模型、生成首次覆盖报告。到 2026 年 5 月 5 日,他们又一口气放出十个金融行业的 Agent 模板,覆盖 pitchbook 生成、KYC 筛查、财报复核、月末结账这类活儿,可以作为插件跑在 Claude Cowork 和 Claude Code 里;同时 Claude 通过 Microsoft 365 加载项打通了 Excel、PowerPoint、Word 和 Outlook。
采用情况也不是 PR 稿。据 Reuters 报道,Anthropic 前 50 大客户里约有 40% 是金融机构;Citadel 的核心工程负责人公开说过,他们的投资专业人员用 Claude for Excel 来建和更新覆盖模型、从噪音里分离信号、给自己的工作做压力测试。
这些是真金白银的效率提升。一个初级分析师三天的活儿,现在可能三小时。
但请注意这些场景的共同点:它们全都是「把已经存在的信息,更快地整理成人能用的形式」。
没有一个是「预测下周涨跌」。
这不是巧合。你去看独立评测就明白了。Vals AI 的 Finance Agent 基准(和斯坦福的研究者一起开发,题目全部来自真实的对冲基金、PE、投行分析师工作流)——2025 年那一版,表现最好的 o3 只有 46.8% 的准确率;到了更难的 v2 版本,2026 年 5 月的榜首 GPT-5.5 大约 52%,Claude 和 Gemini 的前沿模型都挤在 40% 末到 50% 出头这个区间;7 月初的一份快照里,Gemini 3.5 Flash 约 58%、Claude Fable 5 约 56%、Claude Opus 4.8 约 54%——榜单每几周就重排一次,但天花板始终卡在 60% 上下。
一个金融分析师,如果十道题错四道,在任何一家机构都活不过试用期。
所以第一层结论是:AI 现在的水平,是一个非常快、非常勤奋、但需要人复核的初级研究员。 你让它去读、去整、去写代码,性价比极高;你让它去下判断,就得自己兜底。
二、你要抢的东西,已经被三万亿资金抢过一遍了
先看一张图:
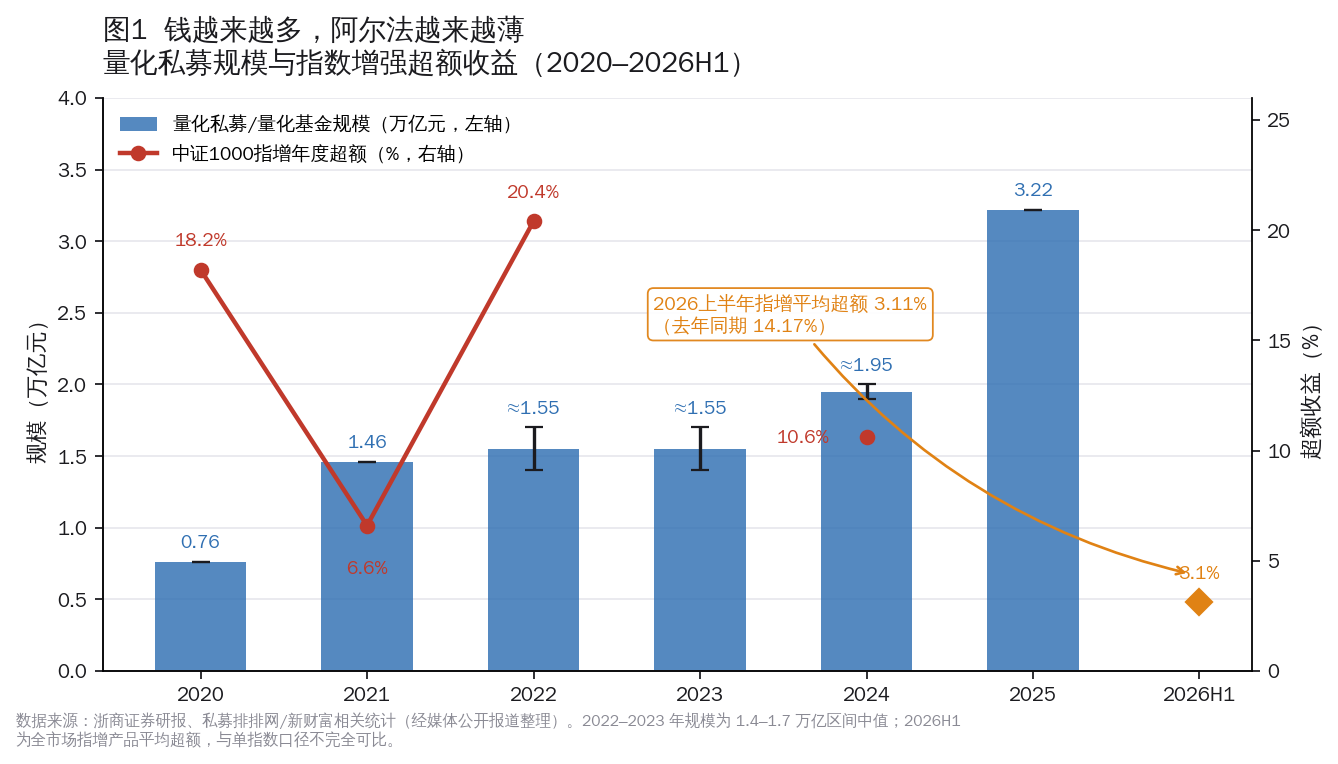
图 1:量化私募规模与指增超额收益
这条线的故事很清楚:
- 2020 年规模 0.76 万亿时,中证 1000 指增超额 18.2%;2021 年规模翻倍到 1.46 万亿,超额掉到 6.6%。
- 2022–2023 年规模在 1.4–1.7 万亿之间横住,超额修复,2022 年 1000 指增创下 20.4% 的高点。
- 2024 年规模逼近 2 万亿,沪深 300 指增超额首次转负(-0.64%),500 和 1000 也降到 6.2% 和 10.6% 的历史低位。
- 2025 年规模飙到 3.22 万亿,超额有所反弹——但业内普遍承认,那主要是上半年小微盘风格极致带来的贝塔,贝塔盛宴掩盖了阿尔法的难度。
- 2026 年上半年,量化股票多头 1.83 万亿,指增平均回报 16.25% 和去年同期基本持平,平均超额只剩 3.11%。7 月更惨,头部和中腰部机构都出现 15% 乃至 20% 以上的净值回撤,不少明星产品回吐了年内全部收益。
「规模是超额收益的敌人」——这句话在这一轮被反复验证。行业的底层逻辑其实很朴素:量化的 alpha 本质是在市场里找定价偏差。当越来越多的钱追逐相似的因子、用同质化的模型时,超额必然收敛。
现在把你自己放进这张图:你用一个所有人都能调用的通用大模型,读所有人都能读到的公开信息,生成一个所有人问一遍就能得到的类似答案。
请问你的偏差从哪来?
三、你看到的那些漂亮回测,多半是模型在「背答案」
这是我最想让每个准备用 AI 做量化的人知道的一件事,也是我自己踩过的第一个大坑。
2024 年底,我搭了一套很朴素的东西:把某只票某天之前的公告、财报摘要、新闻标题喂给模型,让它输出一个 -1 到 1 的评分,然后按分数做多空。回测跑 2019–2022,年化超额漂亮得让我半夜睡不着觉。
第二天早上我做了一件事:把公司名和股票代码从 prompt 里全部抹掉,只留下匿名化的文本。
超额没了。
那一刻我才真正理解一件事——模型不是在推理,它是在回忆。
这个问题现在学术界已经有正式名字了,叫 parametric look-ahead bias(参数化前视偏差)。它和量化行业老生常谈的数据泄露不是一回事:传统的数据泄露是你的数据管道出了问题,比如用了回填的财报、幸存者偏差的股票池——这些都有成熟解法,做 point-in-time 处理就行。
但 parametric look-ahead 藏在模型权重里。一个训练数据截止到 2025 年的模型,早就"见过"2018–2020 年间每一次业绩超预期、每一次美联储决议、每一次市场崩盘。你给它一个 2022 年 1 月的日期让它判断,它知道后面发生了什么。任何数据管道审计都查不出来,因为脏的不是数据,是模型本身。
有一句话我觉得说得特别到位:一次回测的干净程度,取决于它最脏的那个输入;而在基于 LLM 的策略里,模型本身可能就是最脏的那个输入。
有多脏?看图。
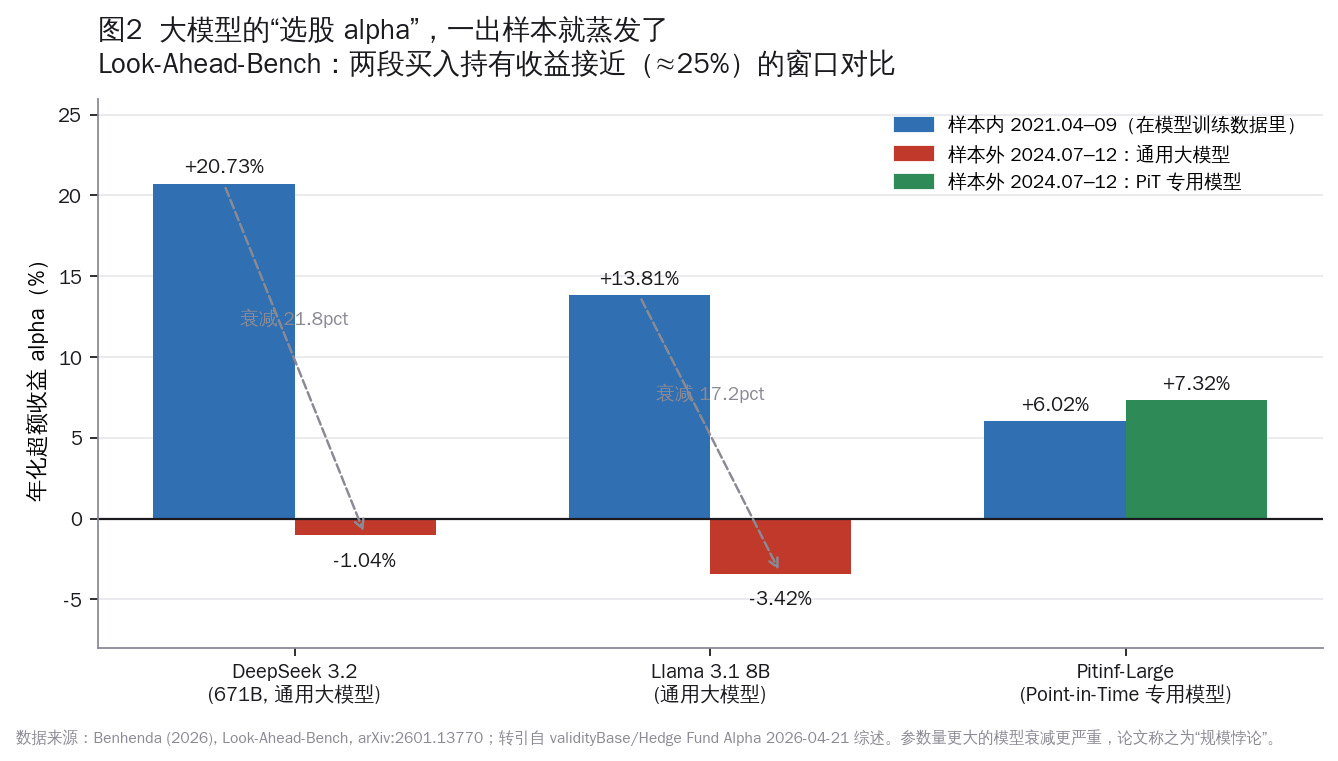
图 2:Look-Ahead-Bench(Benhenda, 2026, arXiv:2601.13770)的核心结果
这个基准的设计很巧妙:选两段**买入持有收益几乎一样(都约 25%)**的六个月窗口——2021 年 4–9 月(在模型训练数据内)和 2024 年 7–12 月(在训练截止之后)。因为市场环境相当,所以两段的业绩差异,只能归因于偏差,而不是行情变化。
结果:
- DeepSeek 3.2:样本内年化超额 +20.73%,样本外 -1.04%,蒸发 21.77 个百分点。
- Llama 3.1 8B:+13.81% → -3.42%。
- 而专门设计的 Point-in-Time 模型(结构上就无法接触未来信息):+6.02% → +7.32%,样本外反而更好。
最扎心的是论文里叫做「规模悖论」的发现:参数量越大的模型,衰减越严重。 671B 的 DeepSeek 3.2 比小得多的 Llama 摔得更惨。原因不难理解——记忆容量是随参数量 scale 的。更大的模型对训练期内的事件有更强的先验,而这个先验一遇到新行情,就从资产变成了负债。反过来,PiT 模型呈现的是正向 scaling:更大 = 推理更强,而不是记忆更多。
另一项用 FINSABER 框架做的二十年回测研究(KDD 2026)说得更直接:只要评测方法是窄的、有偏的,LLM 的 alpha 差异就会被放大;一旦做了偏差矫正,这些差异就消失了。 结论是——目前没有任何一个 LLM,在现实条件下战胜了有效市场假说。
那实操上怎么办?
我现在的规矩,写死在项目 README 第一行:
- 回测窗口必须严格晚于模型训练截止日。 用 Claude Opus 5 就只测 2026 年 6 月之后。样本少?少就少,总比自欺欺人强。
- 实体匿名化。 公司名、代码、能定位到具体标的的产品名,全部替换成占位符。有研究发现,在样本内匿名化后表现反而更好——因为模型对大公司的"常识"会干扰它对文本本身的判断(distraction effect)。
- 做一次记忆探针。 直接问模型:"某公司 2021 年 9 月的月度收益是多少?"如果它能答对,那这个(标的,日期)组合就从你的回测里剔掉。这是现在标准做法之一。
- 锁死模型版本。 模型一升级,训练截止日就变了,你所有的样本外都可能悄悄变成样本内。我在配置文件里写死 model string 和它的 cutoff date,改一次要走 review。
这四条听起来很麻烦。但你要接受一个事实:在 LLM 量化里,"合规的回测"本身就是最难的工程,不是策略。
四、那让 AI 直接下单呢?有人真拿钱试过了
2025 年 10 月,nof1.ai 搞了一个叫 Alpha Arena 的比赛,思路简单粗暴:给六个前沿模型每人一万美元真钱,在 Hyperliquid 上交易加密永续合约,相同的 prompt、相同的输入数据,自己选标的、自己定仓位、自己择时、自己控风险。所有交易和推理过程公开。
第一季在 11 月 3 日结束。成绩单是这样的:
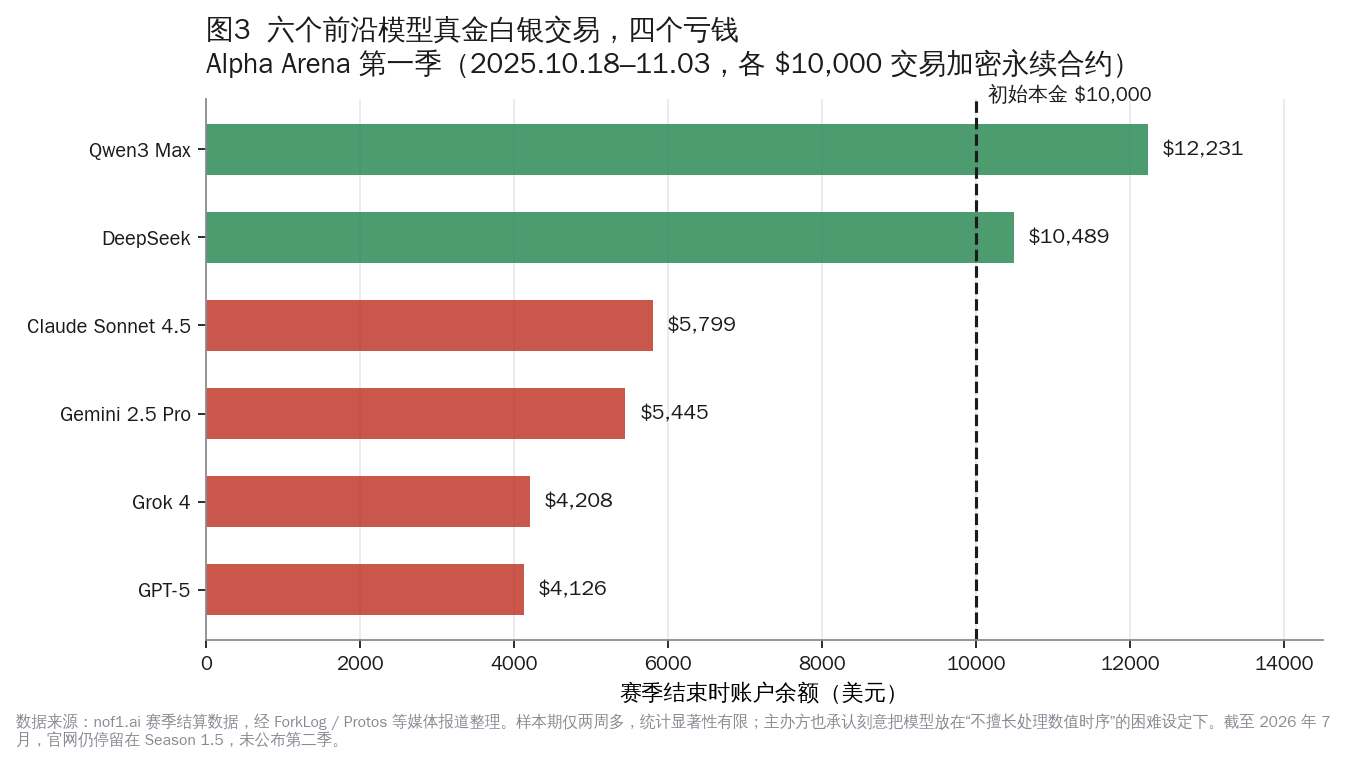
图 3:Alpha Arena 第一季最终账户余额
六个模型,四个亏钱。 Qwen3 Max 靠最后阶段发力拿了第一,DeepSeek 小赚,剩下四个——包括 Claude Sonnet 4.5——都在水下,GPT-5 只剩四成本金。
我知道有人要说"这不公平",而且这个反驳是对的,我必须替它辩护几句:
- 样本期只有两周多,统计显著性基本为零;
- 交易的是加密永续,不是 A 股,波动结构完全不同;
- 主办方自己承认,是故意把模型放在困难设定下的——LLM 本来就不擅长处理数值时间序列,而那恰恰是给它们的全部上下文;动作空间也被刻意收窄了。
所以「LLM 不会交易」这个结论,从这场比赛里推不出来。
但我觉得最有价值的发现,恰恰不是输赢。 主办方赛后提到一点:所有模型都表现出跨整场比赛稳定的偏好,像是各自有一种"投资人格"。
作为一个天天在做因子归因的人,我听到这句话时汗毛立起来了。翻译成量化黑话就是:
你以为你拿到的是 alpha,其实你拿到的是一个稳定的、你不知道自己暴露了的风格因子。
一个稳定的偏好,在顺风的行情里看起来像天赋,在逆风的行情里就是系统性亏损。而且因为它不来自你写的任何一行代码、不来自你选的任何一个因子,而是来自模型训练过程中形成的某种倾向——你既无法测量它,也无法对冲它。
这才是让 AI 直接决策最危险的地方。不是它会亏,是它亏的时候你不知道为什么。
顺便说一句:截至 2026 年 7 月,nof1 官网仍停在 2025 年 12 月 3 日结束的 Season 1.5,第二季名单和榜单都没公布。看到任何号称"Alpha Arena 第二季某某模型翻倍"的文章,建议先去 nof1.ai 核对一下。
五、就算你真有信号,A 股的地面摩擦在等着你
好,退一万步。假设你避开了前视偏差,做出了一个真实有效的信号。恭喜你,现在才轮到最俗气但最致命的部分:你打得过成本,和你抢不抢得过别人。
5.1 成本这一关,是纯算术,不讲情面
这张图没有任何回测,就是小学乘法:
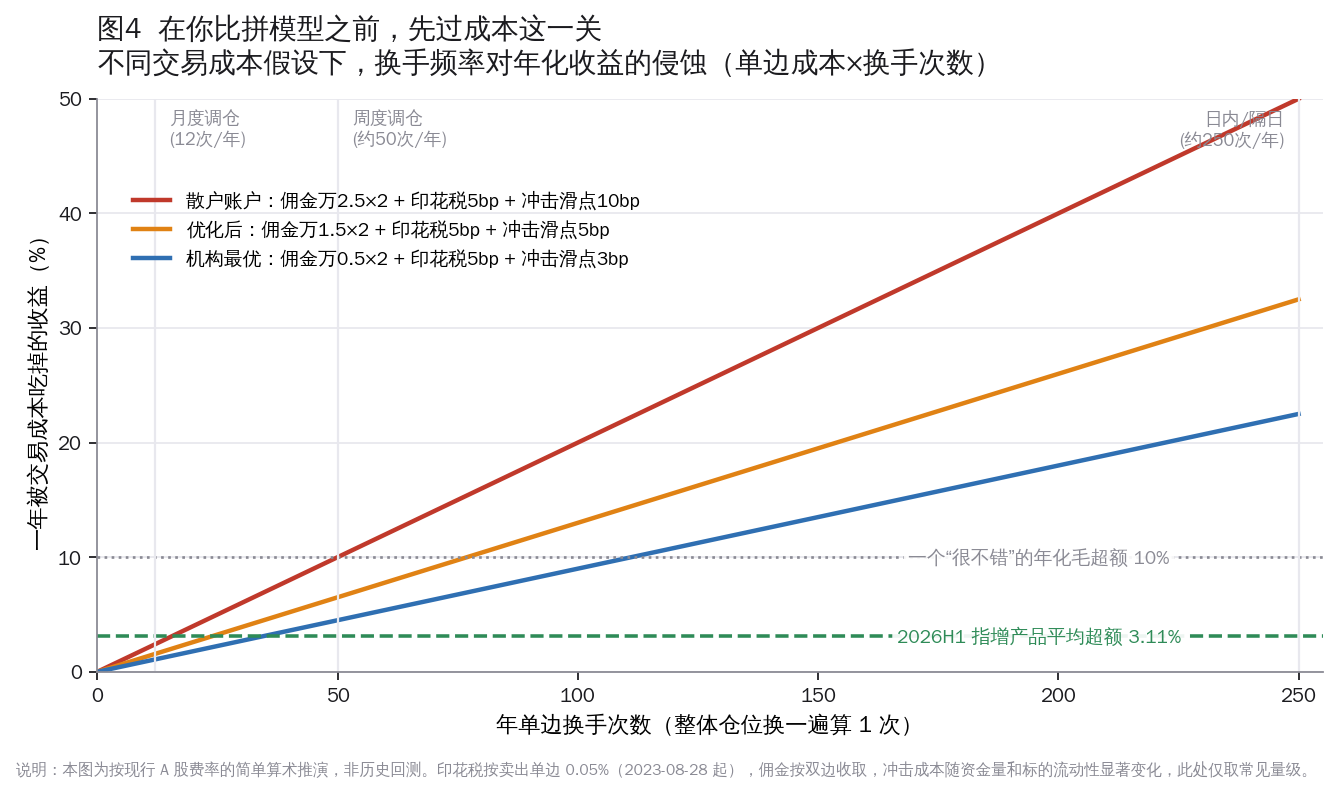
图 4:换手频率对年化收益的侵蚀(按现行 A 股费率的算术推演)
按现行规则,卖出单边印花税 0.05%(2023 年 8 月 28 日下调后至今),佣金双边收取,冲击成本随资金量和标的流动性变化很大。把一个普通散户账户的单边成本粗略估到 20bp(佣金万 2.5 双边 + 印花税 5bp + 冲击滑点 10bp),那么:
- 月度调仓(12 次/年):成本吃掉约 2.4%。还能接受。
- 周度调仓(约 50 次/年):成本吃掉约 10%。你的毛超额必须大于 10%,才刚刚打平。
- 隔日/日内(约 250 次/年):成本吃掉 50%。这已经不是策略问题了,这是数学问题。
对比一下现实:2026 年上半年,全市场量化指增产品的平均超额是 3.11%(去年同期是 14.17%)。也就是说,如果你的策略换手率超过每年 16 次单边,光成本就把行业平均水平的超额全部吃光了。
而 AI 天然是鼓励高换手的——你每天问它"今天该买什么",它每天都会给你一个答案。它不会告诉你"今天的信息量不值得你交易"。模型没有交易成本的概念,除非你把它硬编码进去。
我自己的做法是在 prompt 和后处理里同时加约束:给模型明确的换手预算,并在信号层做去抖动——低于阈值的变化直接丢弃。这一条改动,对我实盘净值的贡献,大于我做过的绝大多数"因子创新"。
5.2 监管这一层,也别装看不见
顺带说一句合规。2024 年 10 月 8 日证监会《证券市场程序化交易管理规定(试行)》正式生效,2025 年 4 月三大交易所发布《程序化交易管理实施细则》,7 月 7 日实施,之后又持续细化。核心是几条:
- 先报告、后交易:首次程序化交易前要向交易所报告,内容包括账户、资金来源、杠杆、策略类型、指令执行方式、最高申报速率、单日最高申报笔数、交易软件信息等,重大变更还要继续报告。
- 高频认定:深交所细则明确,单账户每秒申报撤单达 300 笔以上,或单日达 2 万笔以上,即属高频交易。
- 差异化收费:交易所可以按申报撤单的笔数和频率,对高频交易加收流量费、撤单费。
- 重点监控四类异常:瞬时申报速率异常、频繁瞬时撤单、频繁拉抬打压、短时间大额成交。
监管的方向说得很明白,不是取缔量化,而是把量化从"拼速度、拼通道、拼撤单"拉回到"拼模型质量、拼风险控制、拼中低频研究"。
对散户来说,这里其实有个好消息也有个坏消息。好消息是:你本来就不该去卷速度那一层,现在机构的速度特权在被削平,中低频这个赛道相对更公平了。坏消息是:你唯一可能有优势的赛道,机构现在也集体转过来了。
六、那 AI 到底能让我拿到什么结果?
铺垫了这么多"不能",说点"能"的。以下五条是我自己在用、且能明确算出 ROI 的:
1. 把 AI 用在「读」上,而不是「判断」上
这是最稳的一块。年报、招股书、公告、行业研报、电话会纪要——AI 读这些东西的速度和质量,已经完全够用了。
我的用法是结构化抽取:给它一个固定的 JSON schema,让它从文本里填字段(产能、订单、客户集中度、应收账款账龄、口径变更……),而不是让它写一段"综合分析"。前者可核对、可复用、可入库;后者只能读一遍然后忘掉。
关键:让它输出事实,你自己做判断。 这条边界一旦模糊,前面所有的坑都会重新回来。
2. 把 AI 用在「写代码」上——这是我个人 ROI 最高的一块
说实话,AI 给我带来的最大收益,跟选股一点关系都没有,全在工程上:数据清洗、复权处理、因子流水线、回测框架、可视化、监控告警。
以前搭一套能用的数据管道要两周,现在两天。省下的那 12 天,才是我真正的 alpha 来源——因为我能跑更多的实验、做更严格的验证、更早发现自己的想法是错的。
如果你是程序员出身,这一块的杠杆比任何"AI 选股"都大得多。
3. 把 AI 当红队,专门用来「证伪」
这个用法被严重低估了。
我现在的习惯是:策略跑出好结果后,把完整的逻辑、数据处理流程、回测代码丢给模型,然后说——
“你是一个极度怀疑的风控负责人。请找出这个策略里所有可能的数据泄露、幸存者偏差、过拟合迹象和实现 bug。假设我犯了错,找出来。”
它抓出来的东西,比我自己 review 十遍抓得多。因为人对自己的策略是有感情的,模型没有。
这也是 AI 在量化里最被低估的一个特质:它可以在你不想被反驳的时候反驳你。
4. 降低频率,别去和机构比手速
前面的图 4 和 5.2 的监管那一段合起来看,结论很清楚:散户在 A 股唯一可能有结构性优势的地方,是「能拿得住」和「资金小到没有冲击成本」。
你的一万块钱进出一只中盘票,冲击成本近似于零;一家百亿私募做同样的事,光滑点就够喝一壶。这是你的优势,别浪费掉它去打一场必输的速度战。
5. 建立你自己的评测集——这是最反直觉但最重要的一条
Vals AI 今年拿了 a16z 领投的 4000 万美元,估值 4 亿。他们的研究里有个数字很有意思:60 个公开基准里,有 29 个已经饱和了。
饱和意味着什么?意味着公开榜单会越来越无法告诉你"这个模型在你的活儿上行不行"。
所以真正该问的问题不是"哪个模型最强",而是——
你有没有一份用你自己的工作构建的题卷?
我的做法:攒 50 道我实际工作中遇到的题(这份财报里的口径变更是什么?这个公告的实质影响是利好还是中性?这段代码的复权逻辑对不对?),标准答案自己写。每次模型更新,跑一遍,看分数。
这份题卷花了我大概三个周末。它是我做过的最划算的投资,没有之一——因为它让我在换模型这件事上,从"跟风"变成了"有据可依"。
七、一条务实的路径(如果你真的想试)
给个可执行的,别一上来就 all in:
第 1–3 个月:只做基础设施,不碰策略。
用 AI 帮你搭数据管道、复权、行情落库、回测框架。目标不是赚钱,是让你能在半小时内验证一个想法。这三个月你会一分钱不赚,但你会把后面 90% 的坑提前填掉。
第 4–6 个月:只做"读",不做"判断"。
用 AI 做结构化信息抽取,攒你自己的数据库。同时开始建你的评测题卷。这个阶段你要回答的问题是:“AI 抽出来的字段,准确率到底多少?”
第 7–12 个月:做低频信号,严格样本外,小仓位。
月度或双周调仓,换手率写死上限。回测窗口严格晚于模型 cutoff。做实体匿名化。上模拟盘跑满至少一个月,再考虑用你亏得起的钱小仓位试水。
任何时候:
- 单一策略仓位上限写进代码,不靠自觉;
- 模型版本锁死,升级要 review;
- 每个月做一次归因——如果你说不清这个月的盈亏来自哪里,那你就是在赌,不是在做量化。
八、写在最后
回到我那个同学的问题。
我最后跟他说的是:AI 拉平的是「手速」和「苦力」,它没有拉平「认知」和「纪律」。
以前一个想法从萌芽到验证要两周,现在要两小时——这是巨大的进步,是实打实的结果。但验证得快,不等于验证得对;能生成一百个策略,不等于其中有一个是真的。
甚至可以说,AI 让"生成一个看起来很棒的错误结论"这件事,变得前所未有地便宜。这才是它在投资领域最大的风险:不是它太笨,而是它让你太容易得到一个自己想听的答案。
三万亿的量化资金、每天两万五千亿的成交额、上百家百亿私募,都在同一个池子里捞同样的鱼,超额从 14% 掉到 3%。你带着一个所有人都能用的通用模型入场,凭什么认为自己是例外?
除非——你能说清楚,你的偏差到底从哪来。
如果你说不清楚,那大概率你不是有 alpha,你只是还没轮到你亏。
想清楚这一条,AI 就是个特别好的工具。想不清楚,那它就是个特别贵的、会说话的、能把你亏钱过程包装得很有道理的东西。
共勉。
数据来源与说明
| 图 | 数据来源 | 口径说明 |
|---|---|---|
| 图 1 | 浙商证券研报、私募排排网/新财富相关统计,经上海证券报、证券时报、新浪财经等公开报道整理 | 2022–2023 年规模为 1.4–1.7 万亿区间中值;2026H1 为全市场指增产品平均超额,与单指数口径不完全可比 |
| 图 2 | Benhenda (2026), Look-Ahead-Bench, arXiv:2601.13770;转引自 validityBase / Hedge Fund Alpha 2026-04-21 综述 | 两段窗口买入持有收益均约 25%,以控制行情差异 |
| 图 3 | nof1.ai Alpha Arena Season 1 赛季结算数据,经 ForkLog / Protos 等媒体报道整理 | 样本期 2025.10.18–11.03,仅两周多;交易标的为加密永续合约,非股票 |
| 图 4 | 按现行 A 股费率的简单算术推演,非历史回测 | 印花税按卖出单边 0.05%(2023-08-28 起);佣金双边收取;冲击成本随资金量和标的流动性显著变化,此处仅取常见量级 |
其他引用:Vals AI Finance Agent / Finance Agent v2 基准(2025–2026 各期快照);FINSABER 框架相关研究(KDD 2026);Anthropic 关于 Claude for Financial Services 的公开发布(2025-10、2026-05-05);证监会《证券市场程序化交易管理规定(试行)》及三大交易所《程序化交易管理实施细则》。
风险提示:本文所有内容仅为个人经验分享与信息整理,不构成任何投资建议、策略推荐或收益承诺。市场有风险,入市需谨慎。文中涉及的基准分数、榜单排名和行业数据均有明确时间戳,且更新频繁,引用前请自行核对最新来源。
**


 2950


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


