


前言
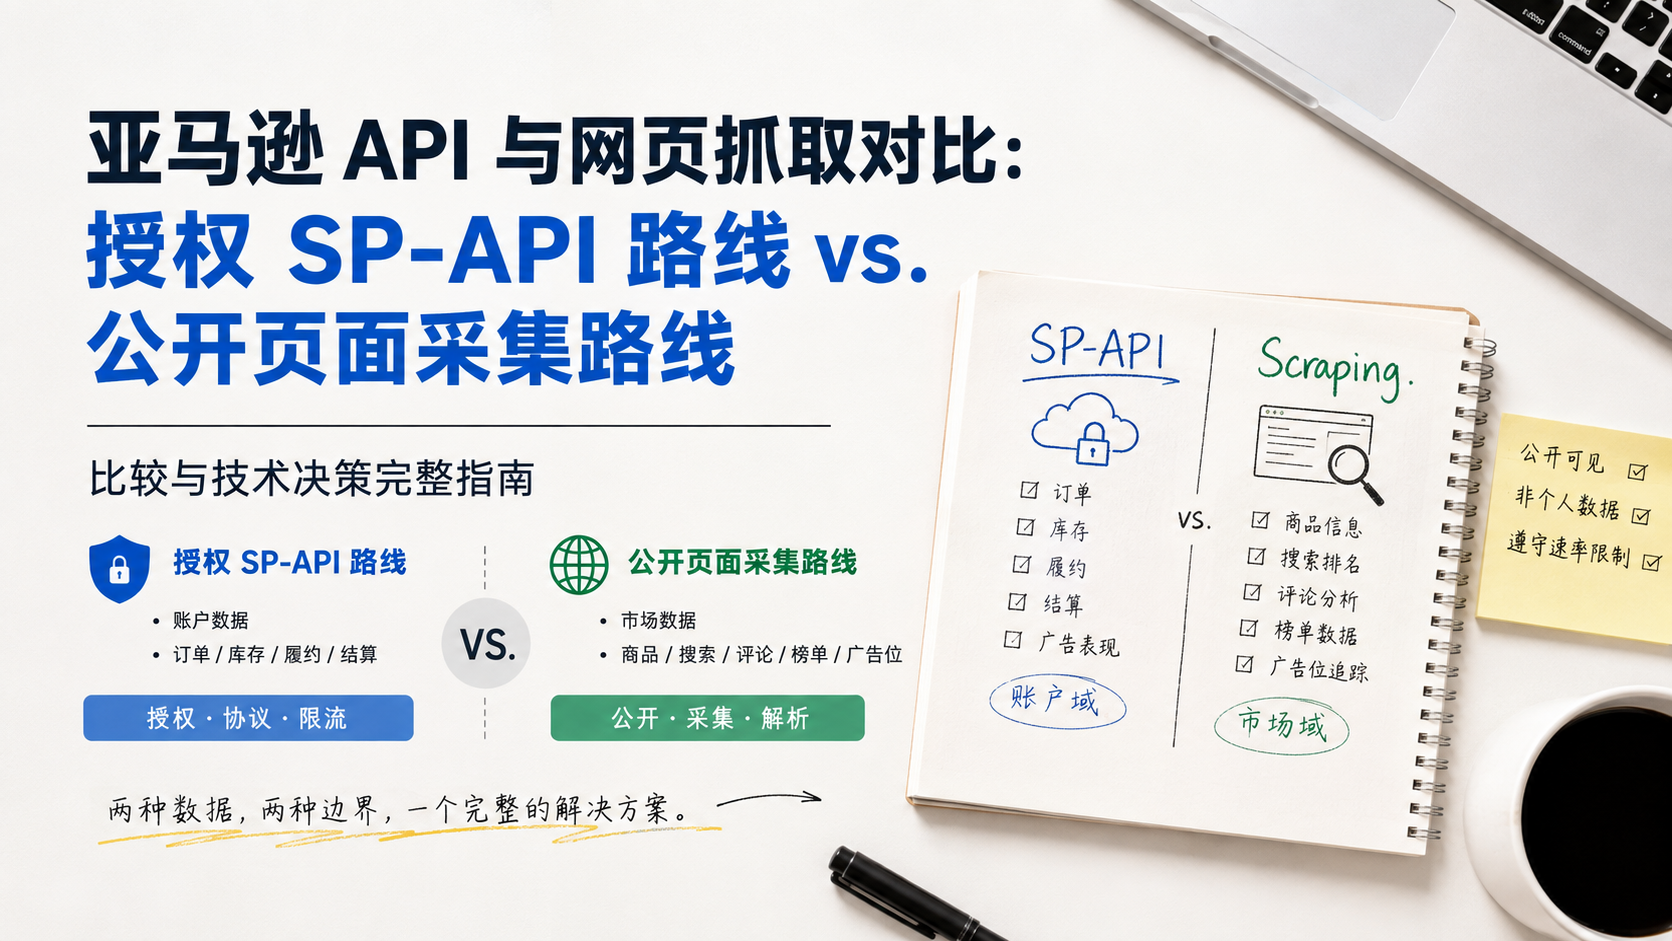
关于"该用亚马逊官方 API 还是网页抓取"这个问题,我在上一篇里给过一个不太一样的答案:这不是二选一,而是两条覆盖不同数据域的通道。官方 SP-API 给你账户域的数据,公开页面采集给你市场域的数据。
道理讲通了,落地还有一堆具体的工程问题:
- SP-API 的令牌桶限流怎么处理?粗暴 sleep 显然不行
- 两条路线的数据字段口径不一致,怎么统一?
- 失败有好几种(限流、被拦截、缺字段),怎么分类告警?
这篇就解决这三件事,附完整可运行代码。
一、先把数据域划清楚
在写代码之前,先明确一件事:路线由数据属性决定,不由你的偏好决定。
| 数据类别 | 属性 | 路线 |
|---|---|---|
| 商品事实(标题、价格、评分、变体、BSR) | 公开可见 | 公开页采集 |
| 搜索与广告(关键词、位次、广告类型) | 公开可见 | 公开页采集 |
| 评论内容(评分、正文、日期、变体) | 公开可见 | 公开页采集 |
| 榜单与类目 | 公开可见 | 公开页采集 |
| 订单与履约 | 账户私有 | SP-API(授权) |
| 买家信息 | 账户私有 + 个人数据 | SP-API(PII 受限角色) |
| 库存与结算 | 账户私有 | SP-API(授权) |
| 自家广告表现 | 账户私有 | SP-API(授权) |
判断标准只有一条:公开可见、非个人 → 可采集;登录可见、含个人信息 → 必须走授权接口。
拿不准的,默认按更严格的一侧处理。
二、SP-API 限流的工程含义
SP-API 采用令牌桶(token bucket)限流模型:每个 API 操作有独立的请求速率(rate)与可用配额(quota),配额按速率持续恢复。部分操作的初始配额与恢复速率还会随卖家业务规模浮动。
三个必须注意的点:
**不同操作的配额互相独立。**这是最常见的设计失误——按"总调用量"估算一定错,getOrders 和 getInventorySummaries 是两套桶,要分别建模。
**被限流不是报错,是正常状态。**高频轮询时限流几乎必然发生,正确做法是排队 + 退避重试,而不是让它抛异常炸掉任务。
**数值会变。**具体配额与速率会随官方调整变化,实施前请在官方文档核对当前值,不要沿用旧文档里的数字。下面代码把速率做成可配置参数,就是为了方便跟着文档调整。
三、代码实现
3.1 令牌桶限流器
按操作维度分别限流,这是整套代码的核心。
import threading
import time
from collections import defaultdict


class TokenBucket:
    """按操作维度限流的令牌桶。

    rate:      每秒恢复的令牌数(对应 SP-API 的 restore rate)
    capacity:  桶容量(对应 SP-API 的 maximum quota / burst)
    """

    def __init__(self, rate: float, capacity: float):
        self.rate = rate
        self.capacity = capacity
        self._tokens = capacity
        self._updated = time.monotonic()
        self._lock = threading.Lock()

    def acquire(self, tokens: float = 1.0) -> float:
        """取用令牌,不足则阻塞等待。返回实际等待秒数。"""
        waited = 0.0
        while True:
            with self._lock:
                now = time.monotonic()
                self._tokens = min(
                    self.capacity,
                    self._tokens + (now - self._updated) * self.rate,
                )
                self._updated = now
                if self._tokens >= tokens:
                    self._tokens -= tokens
                    return waited
                deficit = tokens - self._tokens
                sleep_for = deficit / self.rate
            # 在锁外 sleep,避免阻塞其它线程
            time.sleep(sleep_for)
            waited += sleep_for


class OperationLimiter:
    """为不同 SP-API 操作维护独立的令牌桶。"""

    def __init__(self, config: dict):
        # config 示例:{"getOrders": {"rate": 0.0167, "capacity": 20}, ...}
        self._buckets: dict = {}
        for op, cfg in config.items():
            self._buckets[op] = TokenBucket(cfg["rate"], cfg["capacity"])

    def acquire(self, operation: str) -> float:
        if operation not in self._buckets:
            # 未配置的操作不额外限流,但仍建议显式登记
            return 0.0
        return self._buckets[operation].acquire()
使用方式是把配置与官方文档对齐:
# 数值为示例,请按官方文档当前值填写
SPAPI_LIMITS = {
    "getOrders":              {"rate": 0.0167, "capacity": 20},
    "getOrderItems":          {"rate": 0.5,    "capacity": 30},
    "getInventorySummaries":  {"rate": 0.5,    "capacity": 30},
}

limiter = OperationLimiter(SPAPI_LIMITS)
3.2 带退避重试的调用封装
限流只是第一层,被限流后还需要退避重试。注意区分可重试与不可重试的错误。
import random
import requests

RETRYABLE_STATUS = {429, 500, 502, 503, 504}


def call_sp_api(limiter, operation, url, headers, params, max_retries=3):
    """带令牌桶排队与指数退避的 SP-API 调用。"""
    last_error = None

    for attempt in range(max_retries + 1):
        limiter.acquire(operation)  # 先排队取令牌
        try:
            resp = requests.get(url, headers=headers, params=params, timeout=30)
        except requests.RequestException as exc:
            last_error = f"network: {exc}"
            time.sleep(2 ** attempt + random.uniform(0, 0.5))
            continue

        if resp.status_code == 200:
            return resp.json(), None

        if resp.status_code in RETRYABLE_STATUS:
            # 优先尊重服务端返回的 Retry-After
            retry_after = resp.headers.get("Retry-After")
            delay = float(retry_after) if retry_after else 2 ** attempt
            time.sleep(delay + random.uniform(0, 0.3))
            last_error = f"http {resp.status_code}"
            continue

        # 4xx 且非 429:参数或授权问题,重试无意义
        return None, f"http {resp.status_code} (not retryable): {resp.text[:200]}"

    return None, f"exhausted retries: {last_error}"
关键细节:只对 429 与 5xx 重试。400/401/403 这类是参数或授权问题,重试一百次也不会成功,只会浪费配额。
另外,服务端如果返回了 Retry-After 头,优先用它,比自己的退避算法更准确。
3.3 统一接入层:字段映射与失败分类
两条路线的数据在这里汇合,并做三件事:字段映射、类型校验、失败分类。
from dataclasses import dataclass, field
from typing import Callable


@dataclass
class IngestResult:
    ok: bool = False
    data: dict = field(default_factory=dict)
    failure_type: str = ""     # throttled | blocked | incomplete | request_error
    missing: list = field(default_factory=list)


class UnifiedIngestion:
    """把 SP-API 与公开采集两条路线收敛成同一套内部模型。"""

    def __init__(self, field_map: dict, required_fields: list):
        self.field_map = field_map          # 外部字段 -> 内部字段
        self.required = required_fields

    def normalize(self, payload: dict) -> dict:
        """字段归一:只保留内部模型需要的字段。"""
        out = {}
        for src_key, dst_key in self.field_map.items():
            if src_key in payload and payload[src_key] not in (None, "", [], {}):
                out[dst_key] = payload[src_key]
        return out

    def validate(self, record: dict) -> list:
        """类型强校验 + 必需字段检查,返回缺失字段列表。"""
        return [f for f in self.required if f not in record]

    def ingest(self, fetcher: Callable, **kwargs) -> IngestResult:
        """fetcher 返回 (payload, error);error 非空即请求层失败。"""
        result = IngestResult()
        payload, error = fetcher(**kwargs)

        if error:
            result.failure_type = "throttled" if "429" in str(error) else "request_error"
            return result

        record = self.normalize(payload)
        missing = self.validate(record)

        if missing:
            # 解析成功但字段缺失:这是覆盖问题,不是请求问题
            result.failure_type = "incomplete"
            result.missing = missing
            return result

        result.ok = True
        result.data = record
        return result
这里最重要的设计是失败分三类:
request_error/throttled— 请求层问题,看配额和退避blocked— 拿到 200 但不是正常页面(公开采集侧特有)incomplete— 解析成功但缺字段(覆盖问题)
这三类问题的修法完全不同。混进一个 error 日志,你根本判断不出该去调配额、换代理还是找供应商补字段。
3.4 公开采集侧的 blocked 检测
这是公开采集最容易漏的一环:被拦截的页面同样返回 HTTP 200。
BLOCK_MARKERS = [
    "captcha", "robot check", "enter the characters you see",
    "automated access", "to discuss automated access",
]


def looks_blocked(html: str) -> bool:
    """内容层判断是否被拦截 —— 只看状态码是不够的。"""
    lowered = html[:20000].lower()
    hits = sum(1 for m in BLOCK_MARKERS if m in lowered)
    # 命中标记,或页面过短(正常商品页通常远大于此)
    return hits > 0 or len(html) < 2000
把它接进 UnifiedIngestion,被拦截的响应就会归类到 blocked,而不是伪装成成功数据写进库。
3.5 合规约束要写进代码,而不是写在文档里
很多团队的合规要求停留在 Wiki 上,代码里没有任何强制约束。结果是"文档说不能采,代码里其实一直在采"——这是最尴尬也最难收拾的情况。
建议在接入层就把红线固化成代码:
**字段白名单。**只保留内部模型声明过的字段,其余一律丢弃。这样即使上游某次多返回了个人数据,也不会流进你的库。上面的 normalize() 用的就是白名单思路,而不是黑名单。
**路径约束。**采集任务只允许访问公开路径,遇到账户页、登录跳转等路径直接拒绝并告警。
**请求速率硬上限。**在采集任务层做限制,避免某个失控任务把整体频率拉高,把性质从"读取公开信息"推向"干扰服务"。
**审计日志。**记录每次采集的来源、时间、字段清单,便于事后追溯。留存采集时间戳(fetchedAt)则应设为核心必需字段,缺失即判该条记录不可用。
这几条实现起来都不复杂,但能把合规从"靠人自觉"变成"靠代码保证"。
3.6 完整数据流
把上面的组件串起来,一次典型的数据接入流程是:
- 调度层按冷热分层生成任务——头部商品高频,长尾低频
- 任务按数据域分发:账户域走 SP-API 客户端,市场域走采集客户端
- SP-API 客户端先向
OperationLimiter取令牌,再发起调用;遇到 429/5xx 按Retry-After或指数退避重试 - 采集客户端发起请求,先做 blocked 内容层检测,再做解析
- 两路结果都送进
UnifiedIngestion,做字段归一、类型校验、失败分类 - 结果写入双表:当前快照表 + 历史变更表
- 三类失败分别计数,推到监控看板
第 6 步的双表结构值得强调。只存快照会丢失所有趋势信息,而趋势恰恰是亚马逊数据最有价值的部分——你知道竞品今天降价意义不大,知道他过去 30 天降了 4 次才有价值。
第 7 步的监控也不是可选项。三类失败的占比趋势能提前暴露问题:blocked 上升说明反爬收紧,throttled 上升说明配额不够,incomplete 上升说明覆盖退化。等到业务方来问"数据怎么不对",通常已经晚了。
3.7 什么时候不该建这套东西
说了这么多实现,也要说清楚什么时候不该做。
如果需求只限于自身经营——订单、库存、履约、自家 listing、自家广告表现——那就只用官方 SP-API,不要引入公开采集。上面这套混合架构的复杂度,在这种场景下换不来任何价值,只会增加不必要的合规面积和维护负担。
如果是极小量的一次性需求——比如调研一个品类、导出一份竞品清单——直接用现成的数据服务跑一批,或者手工整理,都比搭一套长期链路划算。
架构的复杂度应该与问题的复杂度匹配。两条数据通道的汇合是有成本的,只有当你的需求确实横跨账户域与市场域时,这笔成本才值得付。
四、常见问题
Q1:配额数值应该写死在代码里吗?
不建议。SP-API 的配额会随官方调整变化,也可能随卖家规模浮动。建议做成配置文件或环境变量,并在官方文档更新时同步核对。代码里的数值只作为占位示例。
Q2:多线程并发时令牌桶还有效吗?
有效,上面的 TokenBucket 用了 threading.Lock,并且 sleep 放在锁外,避免阻塞其他线程。但要注意:令牌桶是进程内的,如果服务是多实例部署,全局速率会是单实例的 N 倍,需要在网关层做全局限流或降低单实例速率。
Q3:字段缺失应该直接丢弃整条记录吗?
看字段重要性。建议把必需字段分为两档:核心字段(缺失即判不可用,如 price、fetchedAt)与可选字段(缺失只记录不影响可用性)。上面的 required 列表应只放核心字段。
Q4:两条路线的时间戳怎么对齐?
统一用带时区的 UTC 时间戳,并在接入层强制校验 fetchedAt 存在。没有抓取时间戳的记录无法进入时间序列,也无法事后追责——建议把它设为核心必需字段。
五、性能优化建议
-
按操作分别建模配额,不要用一个总量估算。这是最容易被忽略也最容易在上线上出问题的点。
-
优先使用服务端
Retry-After,比自定义退避更准确。 -
批量端点优先。网络往返通常是延迟的主要来源,能用批量就别循环单条。
-
冷热分层。头部 20% 的商品贡献 80% 的决策价值,把它们设为高频,长尾低频,成本通常能压掉一半。
-
失败分类要落到监控看板,而不是只写日志。三类失败的占比趋势能提前暴露问题:blocked 上升说明反爬收紧,throttled 上升说明配额不够,incomplete 上升说明覆盖退化。
-
公开采集侧的并发要保守。过高的请求频率不只是技术问题,也会把性质从"读取公开信息"推向"干扰服务"。
补充一点运维经验。
三类失败的占比建议做成趋势图而不是单点数值。单点数值看不出趋势,而退化几乎都是渐进的——blocked 从 2% 爬到 8% 通常需要几周,等某天突然发现"数据不对",其实已经错过了最佳干预窗口。
建议在接入层就把计数器暴露出来(Prometheus 之类的指标即可),配上看板与阈值告警。这个改造成本很小,但能把数据问题从"事后发现"变成"提前预警"。
另外注意:趋势要看占比而不是绝对值。请求量翻一倍时,失败数自然也会上升,看绝对值会误判为质量退化,看占比才能反映真实状况。
总结
混合架构落地的三个关键:
- 令牌桶按操作限流 + 只对可重试错误做退避
- 统一接入层做字段映射、类型强校验、失败分类
- blocked 在内容层检测,不能只看状态码
这三件事做完,官方 API 与公开采集就能在同一套内部模型下稳定共存,而不是两套各跑各的、字段还对不上。
产品层面,市场域的数据可用Pangolinfo Amazon Scraper API 与 Pangolinfo Amazon Review API 获取;Agent 直连走 Amazon Data MCP。可以从 Pangolinfo 控制台拿 Key 免费实测。



 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


