


前言
做 Amazon 数据接入的同学,大概率经历过这种对话:
供应商:我们这个是实时的,成功率很高。
你:具体多少?
供应商:……挺高的。
问题不在于对方想骗你,而在于"实时"和"高成功率"在这个行业里没有统一定义。你说的是请求时按需抓取,他说的可能是每天刷一次的缓存;你说的是解析成功,他说的可能是 HTTP 200。
这篇文章不谈选型哲学,只给一套能跑的东西:用 100 次真实调用,把候选方案的中位延迟、p95 延迟、成功率和字段完整率测出来,然后用这四个数字反推你真正的单价。文末有完整可运行的 Python 脚本,改几行就能用在自己的验收里。
技术原理详解
一、数据链路的四个分层
不管你用哪条路线,数据从 Amazon 页面到你的数据库都要经过这四层:
Amazon 公开页面(商品 / 搜索 / 评论 / 榜单 / 广告位)
        ↓
【采集层】反爬处理 · 浏览器渲染 · 代理与地理 · 重试策略
        ↓
【结构化层】解析 · 字段归一 · 类型契约 · 失败语义
        ↓
【交付层】REST API  ── 或 ──  MCP 工具
        ↓
你的应用 / 数据管道 / AI Agent
四条路线的本质区别,就是这四层里哪几层归你:
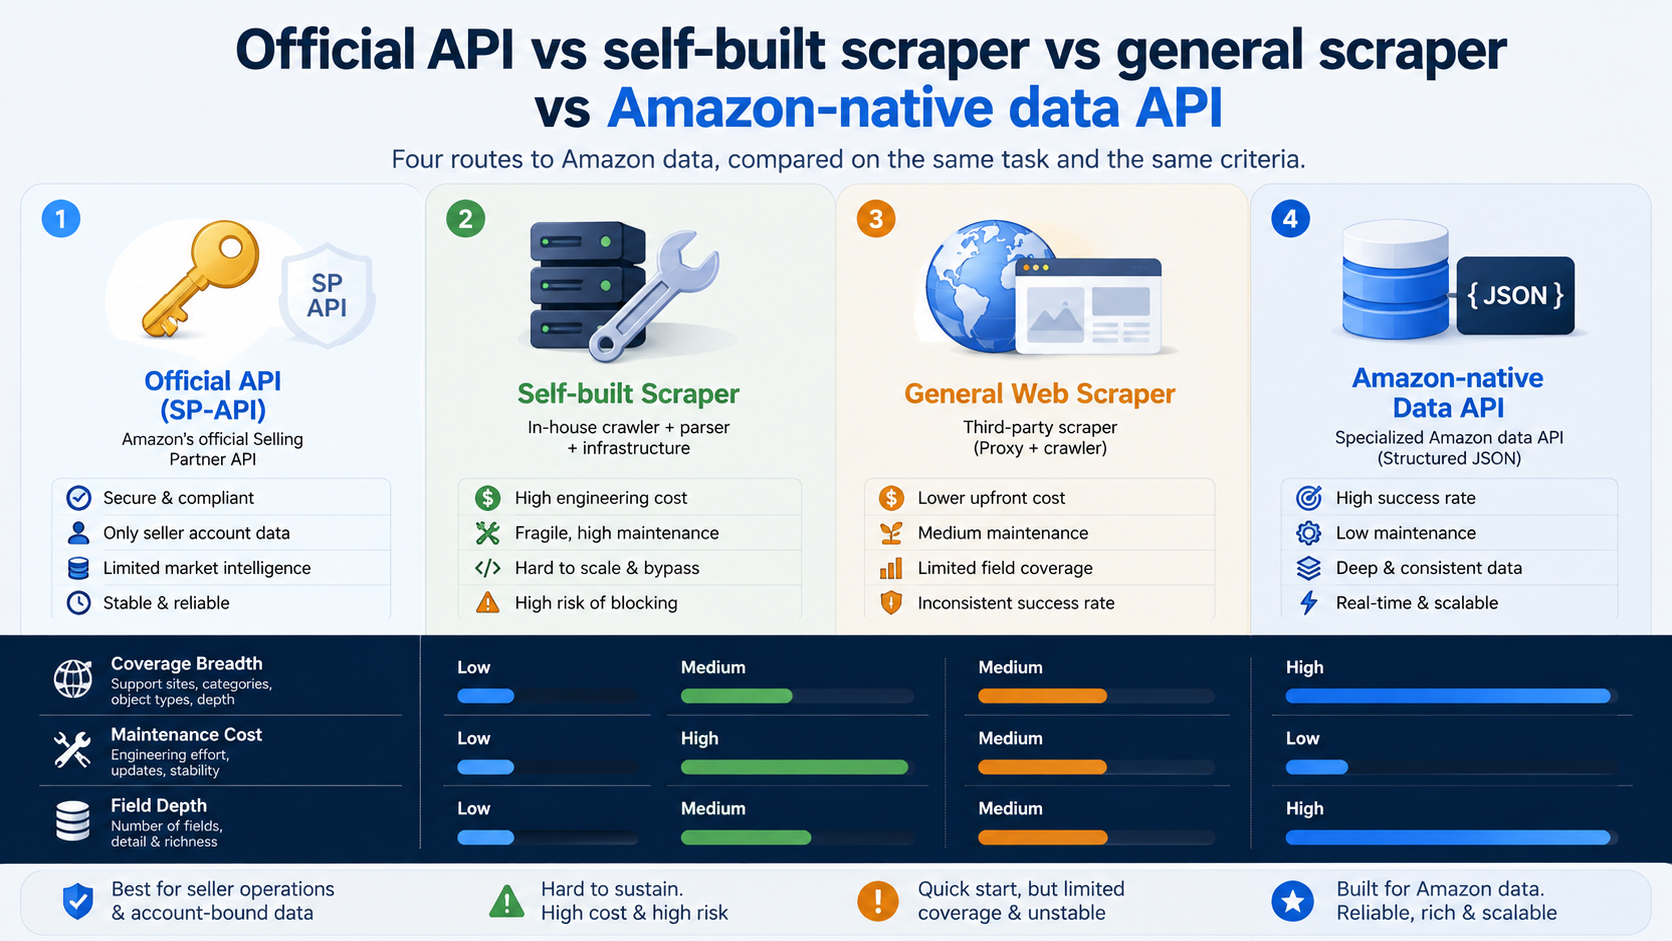
| 路线 | 采集层 | 结构化层 | 交付层 | 你要维护什么 |
|---|---|---|---|---|
| 自建爬虫 | 你 | 你 | 你 | 全部 |
| 通用抓取 API | 供应商 | 你 | 供应商 | 解析、字段漂移 |
| Amazon-native 数据 API | 供应商 | 供应商 | 供应商 | 只管业务逻辑 |
| 官方 SP-API | 供应商 | 供应商 | 供应商 | 配额与授权 |
选型的本质不是选工具,是决定你要拥有哪几层。拥有更多层带来控制力,同时带来维护责任。
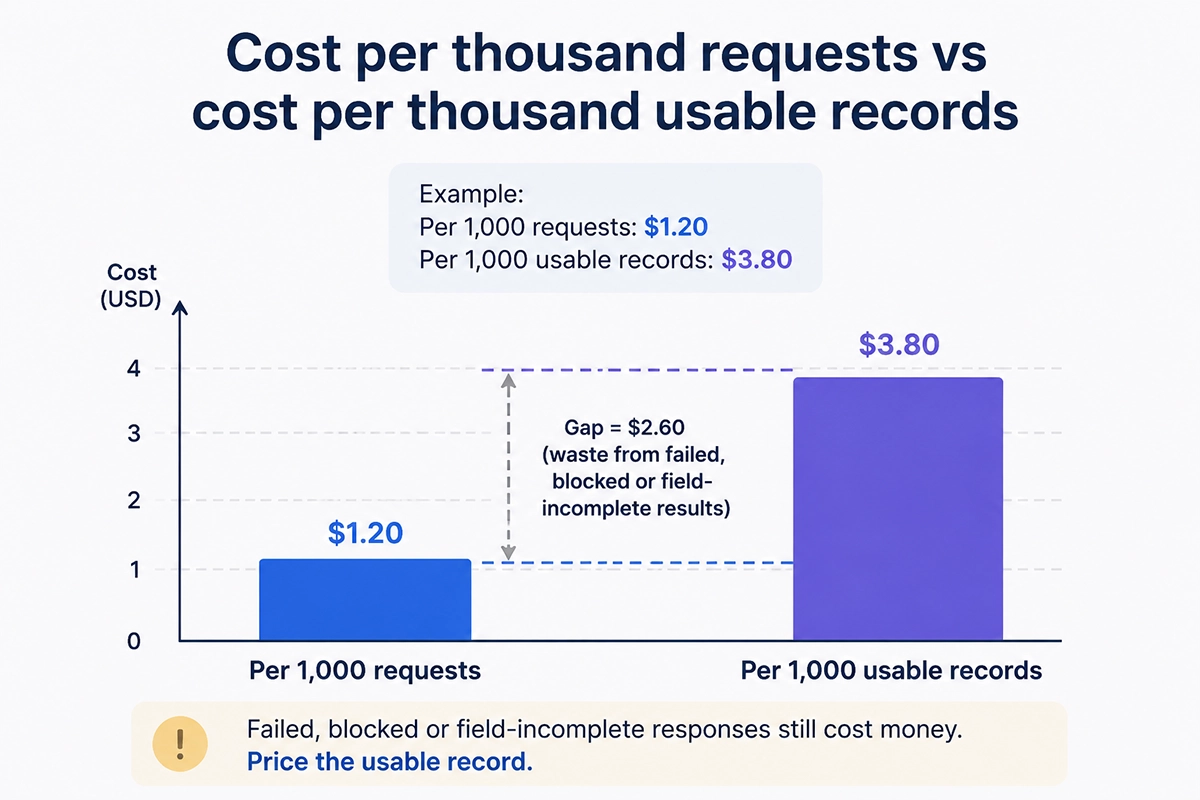
二、为什么"每千次请求"是错误的计价单位
因为这三种情况照样计费:
- 请求失败(超时、连接错误)
- 返回被拦截页面(验证码、机器人检测页)
- 返回成功但缺少你需要的字段
所以正确的单位是:
每千条可用记录成本 =(月度支出 ÷ 含必需字段且解析成功的记录数)× 1000
举例:方案 A 单价 $1.20/千次,成功率 92%、字段完整率 88%,可用比例约 81%,真实成本约 $1.48/千条可用记录。方案 B 单价 $1.60/千次,成功率 99%、字段完整率 98%,可用比例约 97%,真实成本约 $1.65/千条可用记录。
价格表上 A 便宜 25%,真实差距只有 10%。再计入 A 带来的排障工时,排序通常会反转。
三、四个必须测的数字
| 指标 | 定义 | 为什么重要 |
|---|---|---|
| 中位延迟 | 50 分位响应时间 | 代表日常体验 |
| p95 延迟 | 95 分位响应时间 | 代表最坏情况,决定超时设多少 |
| 成功率 | 解析成功 ÷ 总请求(不是 HTTP 200) | 决定真实单价 |
| 字段完整率 | 必需字段齐全的记录 ÷ 成功记录 | 决定数据能不能直接用 |
注意成功率的定义:HTTP 200 不等于解析成功。返回一页验证码也是 200,这是最容易让脏数据流进数据库的地方。
完整代码实现
下面是一个可直接运行的验收脚本。它跨多站点、多对象类型抽样调用,统计上述四个指标。
#!/usr/bin/env python3
"""
Amazon Data API acceptance test.
Samples N calls across marketplaces and object types, then reports
median latency, p95 latency, success rate and field completeness.

Usage:
    export PANGOLINFO_API_KEY="your_key"
    python acceptance_test.py --samples 100 --concurrency 8
"""

import argparse
import os
import statistics
import time
from concurrent.futures import ThreadPoolExecutor, as_completed
from dataclasses import dataclass, field

import requests

API_BASE = "https://api.pangolinfo.com"  # 以实际文档为准

# 你的业务必需字段 —— 改成你自己的清单
REQUIRED_PRODUCT_FIELDS = ["asin", "title", "price", "rating", "bsr", "fetchedAt"]
REQUIRED_SEARCH_FIELDS = ["keyword", "page", "results", "sponsoredCount", "fetchedAt"]

MARKETPLACES = ["amazon.com", "amazon.co.uk", "amazon.de"]
SAMPLE_ASINS = [
    "B0CXYZ1234", "B0ABCDEFGH", "B012345678",
    "B0TEST0001", "B0TEST0002", "B0TEST0003",
]
SAMPLE_KEYWORDS = ["insulated water bottle", "standing desk", "air purifier"]


@dataclass
class CallResult:
    ok: bool = False
    latency_ms: float = 0.0
    fields_ok: bool = False
    missing: list = field(default_factory=list)
    error: str = ""


def check_fields(payload: dict, required: list) -> tuple:
    """返回 (字段是否齐全, 缺失字段列表)。"""
    missing = [f for f in required if f not in payload or payload[f] in (None, "", [], {})]
    return (not missing), missing


def call_product(api_key: str, asin: str, marketplace: str) -> CallResult:
    result = CallResult()
    started = time.perf_counter()
    try:
        resp = requests.get(
            f"{API_BASE}/product",
            params={"asin": asin, "marketplace": marketplace},
            headers={"Authorization": f"Bearer {api_key}"},
            timeout=30,
        )
        result.latency_ms = (time.perf_counter() - started) * 1000

        # 只看 HTTP 200 是不够的:被拦截的页面同样返回 200
        if resp.status_code != 200:
            result.error = f"HTTP {resp.status_code}"
            return result

        payload = resp.json()
        # 供应商通常在 data 里放业务对象,按实际结构调整
        data = payload.get("data", payload)
        result.ok = True
        result.fields_ok, result.missing = check_fields(data, REQUIRED_PRODUCT_FIELDS)
    except Exception as exc:  # noqa: BLE001
        result.latency_ms = (time.perf_counter() - started) * 1000
        result.error = f"{type(exc).__name__}: {exc}"
    return result


def call_search(api_key: str, keyword: str, marketplace: str, page: int) -> CallResult:
    result = CallResult()
    started = time.perf_counter()
    try:
        resp = requests.get(
            f"{API_BASE}/search",
            params={"keyword": keyword, "marketplace": marketplace, "page": page},
            headers={"Authorization": f"Bearer {api_key}"},
            timeout=30,
        )
        result.latency_ms = (time.perf_counter() - started) * 1000
        if resp.status_code != 200:
            result.error = f"HTTP {resp.status_code}"
            return result
        payload = resp.json()
        data = payload.get("data", payload)
        result.ok = True
        result.fields_ok, result.missing = check_fields(data, REQUIRED_SEARCH_FIELDS)
    except Exception as exc:  # noqa: BLE001
        result.latency_ms = (time.perf_counter() - started) * 1000
        result.error = f"{type(exc).__name__}: {exc}"
    return result


def build_tasks(api_key: str, samples: int):
    """交叉生成商品与搜索两类任务,覆盖多站点与多页码。"""
    tasks = []
    for i in range(samples):
        marketplace = MARKETPLACES[i % len(MARKETPLACES)]
        if i % 2 == 0:
            asin = SAMPLE_ASINS[i % len(SAMPLE_ASINS)]
            tasks.append(("product", call_product, (api_key, asin, marketplace)))
        else:
            keyword = SAMPLE_KEYWORDS[i % len(SAMPLE_KEYWORDS)]
            page = (i % 3) + 1  # 1..3,顺便验证深页是否可用
            tasks.append(("search", call_search, (api_key, keyword, marketplace, page)))
    return tasks


def percentile(values: list, pct: float) -> float:
    if not values:
        return 0.0
    ordered = sorted(values)
    idx = min(int(len(ordered) * pct / 100), len(ordered) - 1)
    return ordered[idx]


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--samples", type=int, default=100)
    parser.add_argument("--concurrency", type=int, default=8)
    args = parser.parse_args()

    api_key = os.environ.get("PANGOLINFO_API_KEY")
    if not api_key:
        raise SystemExit("请先设置环境变量 PANGOLINFO_API_KEY")

    tasks = build_tasks(api_key, args.samples)
    results: list = []

    with ThreadPoolExecutor(max_workers=args.concurrency) as pool:
        futures = [pool.submit(fn, *params) for _, fn, params in tasks]
        for future in as_completed(futures):
            results.append(future.result())

    latencies = [r.latency_ms for r in results]
    succeeded = [r for r in results if r.ok]
    complete = [r for r in succeeded if r.fields_ok]

    total = len(results)
    success_rate = len(succeeded) / total * 100 if total else 0
    completeness = len(complete) / len(succeeded) * 100 if succeeded else 0
    usable_rate = len(complete) / total * 100 if total else 0

    print("\n=== Amazon Data API 验收结果 ===")
    print(f"样本数          : {total}")
    print(f"中位延迟        : {statistics.median(latencies):.0f} ms")
    print(f"p95 延迟        : {percentile(latencies, 95):.0f} ms")
    print(f"最大延迟        : {max(latencies):.0f} ms")
    print(f"成功率(解析成功): {success_rate:.1f}%")
    print(f"字段完整率      : {completeness:.1f}%")
    print(f"可用比例        : {usable_rate:.1f}%")

    missing_counter: dict = {}
    for r in succeeded:
        for field_name in r.missing:
            missing_counter[field_name] = missing_counter.get(field_name, 0) + 1
    if missing_counter:
        print("\n缺失字段统计(按出现次数):")
        for field_name, count in sorted(missing_counter.items(), key=lambda x: -x[1]):
            print(f"  {field_name}: {count}")

    errors: dict = {}
    for r in results:
        if r.error:
            key = r.error.split(":")[0]
            errors[key] = errors.get(key, 0) + 1
    if errors:
        print("\n错误分布:")
        for key, count in sorted(errors.items(), key=lambda x: -x[1]):
            print(f"  {key}: {count}")

    print(f"\n提示:把「可用比例」代入公式,即可得到你的真实单价:")
    print(f"  每千条可用记录成本 = 月度支出 ÷ 可用记录数 × 1000")
    print(f"  当前可用比例 {usable_rate:.1f}%,即标价需上浮 {100/usable_rate:.2f} 倍才是真实成本\n")


if __name__ == "__main__":
    main()
跑起来之后你会得到类似这样的输出:
=== Amazon Data API 验收结果 ===
样本数          : 100
中位延迟        : 2980 ms
p95 延迟        : 5240 ms
最大延迟        : 8120 ms
成功率(解析成功): 99.0%
字段完整率      : 98.0%
可用比例        : 97.0%
拿到"可用比例"之后,把它代进公式,就能算出真实单价。这四个数字建议每周复测一次——稳定性漂移是渐进的,单次测试发现不了。
四、字段矩阵:验收清单从哪来
上面脚本里的 REQUIRED_PRODUCT_FIELDS 不是随便写的,它应该来自一张字段矩阵。下面这张表列出 Amazon 公开页面能结构化的主要对象,以及每类对象最容易缺失的字段——缺失项就是你要在验收里重点盯的地方。
| 数据对象 | 关键字段 | 常见缺失 / 坑 |
|---|---|---|
| 商品 Product | ASIN、标题、品牌、价格、评分、BSR、库存、变体 | 变体维度不全;父子 ASIN 关系丢失;促销价与标价混用 |
| 搜索 Search | 关键词、页码、自然位次、广告位次、是否 Sponsored | 广告与自然结果混淆;深页(第 7 页后)被截断 |
| 评论 Review | 评分、标题、正文、日期、是否验证购买、变体、有用票数 | 只抓摘要页导致正文截断;缺少变体归属 |
| 报价 Offers | 卖家名、价格、配送方式、Buy Box 归属、库存 | Buy Box 判定口径不一致;多卖家报价只返回首个 |
| 榜单 Best Sellers | 类目、排名、ASIN、变动幅度 | 类目树版本变化未标注;历史快照不连续 |
| 卖家 Seller | 卖家 ID、名称、评分、在售商品数 | 卖家与品牌关联弱;跨站点 ID 不统一 |
| 类目 Category | 类目树、节点 ID、筛选条件、商品数 | 节点 ID 随站点变化;筛选条件枚举不完整 |
| 广告位 Sponsored | 广告类型(SP/SB/SD)、位置、排名、素材 | 广告与自然结果未区分;素材字段缺失 |
用法是把最后一列当成面试题库,逐条问供应商。能清楚回答"深页支持到第几页"“Buy Box 怎么判定”"变体维度最多几层"的供应商,通常比给你一页漂亮字段表的更靠谱。
这里有两个字段值得单独拎出来说。
**fetchedAt 不能省。**没有抓取时间戳,这份数据做不了任何时间序列,也追不了责——三个月后某个价格异常,你无法判断是当时就错了还是后来处理错了。
**搜索结果里 isSponsored 和 adType 必须分开。**很多抓取结果只给一个位次列表,自然排名和广告混在一起。后果是"关键词排名"这个指标被广告污染:你以为自己排第 3,实际上前两位是广告,真正的自然位次是第 1。基于这个做的优化决策,方向可能完全相反。
五、选型决策树:三步定位
脚本能测出数字,但不能替你决定路线。三步定位法:
**第一步:数据是否只与自有卖家账户相关?**是 → 直接用官方 SP-API,不需要第三方。这一点值得说得很直接,因为这个场景下推荐任何付费方案都是不负责任的。否 → 第二步。
**第二步:是否需要竞品、类目、搜索或广告位这类公开市场事实?**不需要 → 重新审视需求,大概率不需要采购。需要 → 第三步。
**第三步:是否有工程团队能长期承担反爬、渲染、解析的维护?**没有 → 选 Amazon-native 的专用数据 API。有 → 把工程工时折算成钱,和采购价在「每千条可用记录」这个口径上比,谁低选谁。
第三步最容易出错的地方是只比现金。把维护工时按团队真实成本折进去,很多"自建更省"的直觉会当场反转。
常见问题与解决方案
Q1:p95 延迟很高,但中位数正常,要紧吗?
要紧。p95 决定你的超时时间和重试策略该设多少。如果 p95 是 5 秒,超时设 3 秒就会白白浪费一部分成功请求;设 10 秒则会拖慢整条流水线。建议超时设为 p95 的 1.5 倍,并对超时请求做有上限的重试(2 次足够,再多通常说明对方在限流)。
Q2:成功率看着挺高,但字段完整率只有 80%,问题出在哪?
通常是供应商对某些类目或某些站点支持不完整。看脚本输出的"缺失字段统计",如果缺失集中在某一个字段(比如 bsr 或 variants),说明这个字段在你的目标类目上覆盖不足,需要单独向供应商确认,而不是笼统地砍掉整个方案。
Q3:深页(第 3 页之后)成功率明显下降怎么办?
这是常见现象。很多方案只稳定支持前 1–2 页。脚本里我特意让 page 在 1–3 之间轮换,就是为了暴露这个问题。如果你的业务依赖深页排名追踪,务必单独测第 7 页之后的表现,并要求供应商明确深页支持范围。
Q4:多线程并发跑,会不会触发限流导致数据失真?
会。验收时建议先用低并发(4–8)跑一轮建立基线,再用生产预期的并发跑第二轮,对比两者的成功率差异。差异明显说明有限流,需要和供应商确认配额。
性能优化建议
-
把必需字段清单收敛到 15–30 个。 字段越多,完整率天然越低,单价越贵。只请求你真正会写进库的字段。
-
区分冷热数据分层拉取。 头部 20% 的 ASIN 贡献 80% 的决策价值,把它们设为小时级,长尾设为日级,成本通常能降一半以上。
-
缓存 + 条件更新。 对变化慢的字段(品牌、类目、变体维度)做本地缓存,只高频刷新价格、库存、BSR、广告位。
-
批量接口优先于单条循环。 如果供应商提供 batch 端点,优先用;网络往返通常是延迟的主要来源。
-
为失败语义建独立通道。 把解析失败、字段缺失、超时分别打标并计数,不要混在一个 error 日志里——否则你无法定位到底是反爬、限流还是字段问题。
六、一次完整的验收要花多久
很多团队担心验收会拖慢进度,实际上这套测试的时间成本很低。
搭脚本大概半天——文末那段改改字段清单就能直接用。跑 100 次抽样在 8 并发下通常 5 到 10 分钟。连续观察一周是为了看稳定性漂移,这段时间可以并行做其他集成工作,不需要专门等。
真正花时间的是最前面那步:把字段清单收敛到 15–30 个。这一步需要业务方和工程方坐下来对齐——哪些字段真的会参与计算,哪些只是"看着有用"。通常要一到两天,但它决定了后面所有数字的口径。跳过这一步直接测,你会拿到一份漂亮但无法指导决策的测试报告。
总结
选型 Amazon 数据 API,核心不是比价格表,而是把供应商的每一个承诺变成可验证的数字:
- 用 100 次抽样测出中位延迟、p95 延迟、成功率、字段完整率;
- 用 可用比例把标价换算成「每千条可用记录」的真实单价;
- 用 每周复测捕捉稳定性漂移。
这套方法一个下午就能落地,但它能帮你避开绝大多数的口头承诺陷阱。
产品层面,Pangolinfo Amazon Scraper API覆盖商品、搜索、榜单、类目与广告位;Pangolinfo Amazon Review API 负责评论与消费者声音;需要 Agent 直接调数走 Pangolinfo Amazon Data MCP。可以先免费在Pangolinfo 控制台拿个 Key 跑一遍上面的脚本。



 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


