企业AI Agent权限管理全流程:动作矩阵、回滚审计、生产级落地方案

企业级AI Agent三层权限体系:分级授权、凭证隔离与签名许可 在人工智能与大模型技术加速落地的今天,权限管理已成为企业系统安全的核心议题。传统访问控制模型基于固定执行路径,而AI Agent以意图驱动方式自主调用工具与API,其动态行为使得“最小权限”原则的落地面临全新挑战。企业级应用若缺乏清晰的权限边界,可能导致越权访问、凭证泄露甚至恶意操作。围绕分级授权、凭证隔离、签名许可三层机制,构建覆盖“能力边界—身份隔离—操作留痕”的完整安全闭环,能够有效管控Agent的每一步行为。在实际场景中,知识库查询、工单处理等典型应用,正需要基于角色和资源粒度的权限配置,结合动态短 阅读详情

在这里插入图片描述

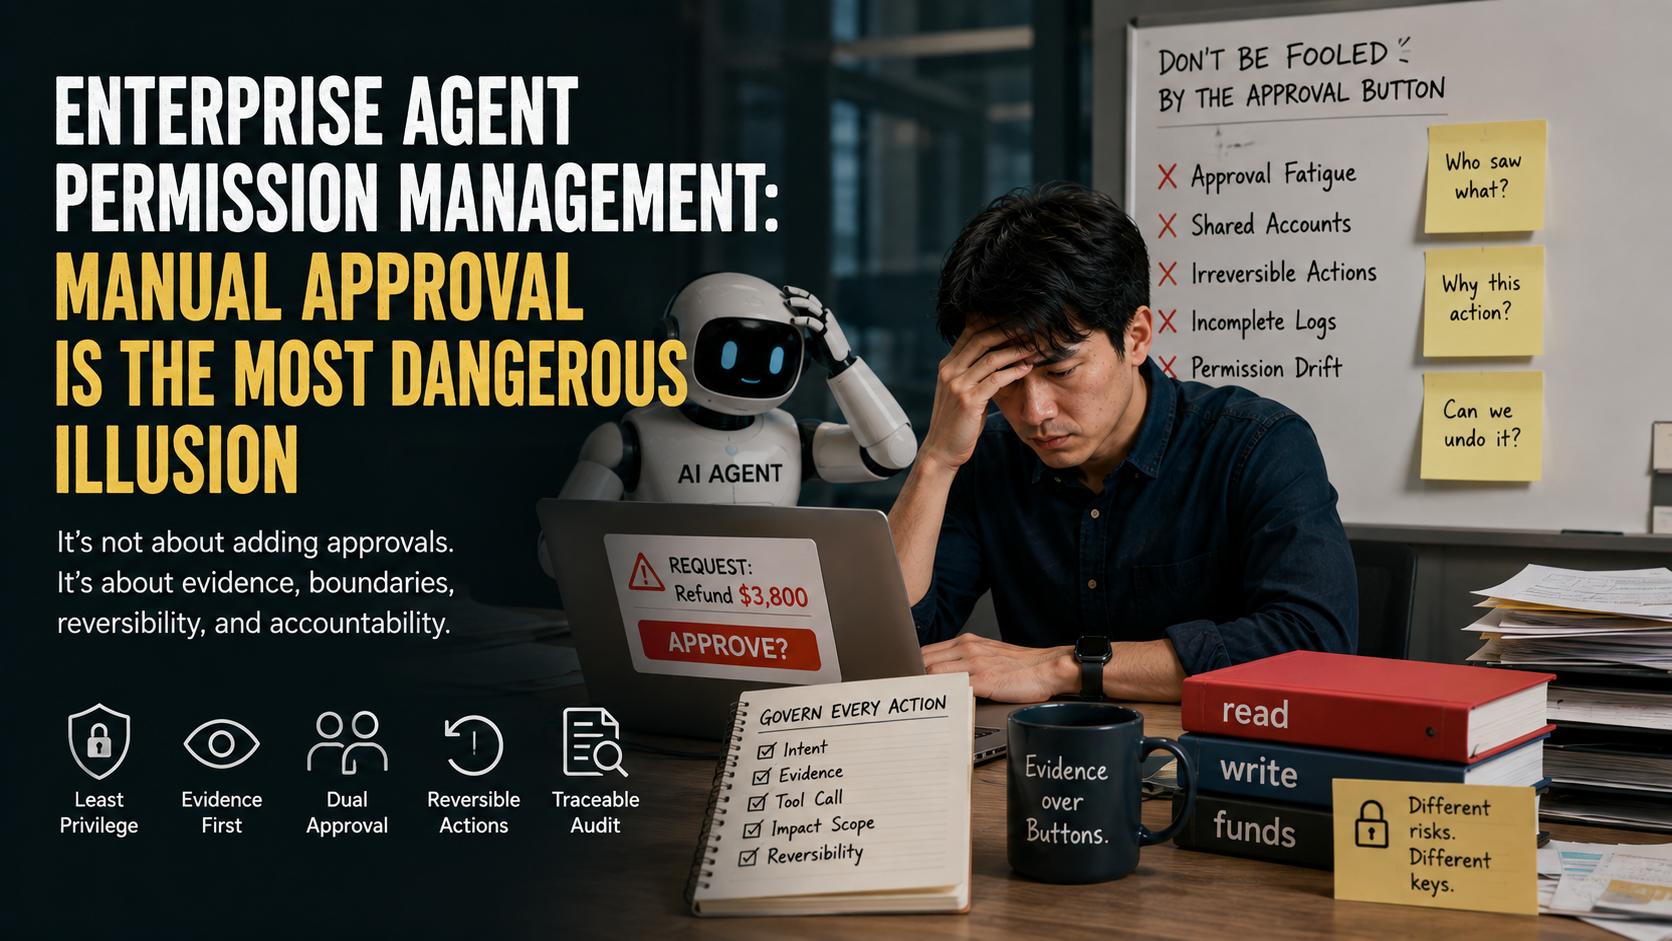
本文手把手讲清楚:为什么"加个审批按钮"不等于安全治理,以及如何用最小权限 + 动作矩阵 + 审计回滚,给 Agent 真正装上护栏。适合正在落地 AI Agent 的工程师和负责人。

前言:一个被高估的"安全按钮"

很多团队做完 Agent,最后一步是:“高风险动作加个人工审批,完事。”

听起来稳妥,实际上埋雷。我们见过最典型的事故:一个退款 Agent,审批流看着很完善,结果上线后审批人疲劳盲签,一笔 ¥3,800 的错退就出去了。复盘时审批人说:“我以为系统已经筛过风险了。”

这句话值得贴在每一个做 Agent 权限的人工位上:审批不会思考,它只是把责任从系统推给了一个正在赶工的人。

真正的企业 Agent 权限管理,要让审核人看到证据、意图、工具调用、影响范围和可逆性,同时把 Agent 能看的数据和能动的动作都框死。下面按步骤来。

步骤一:把权限拆成读 / 写 / 资金三把锁

这是最基础也最常被忽略的一条。

  • 读(read):查订单、看政策。错了顶多答错,代价≈0。
  • 写(write):改状态、建工单。错了人工可改回。
  • 资金(fund):退款、改预算。错了钱出去了。

错误做法:一个 token 同时有 orders:read 和 refund:issue,理由是"都要用"。正确做法:三个独立 token,Agent 按动作挑对应的用。

read_token:  [orders:read, policy:read]
write_token: [ticket:create, status:update]
fund_token:  [refund:issue]  # 必须带 approver_id + idempotency_key

步骤二:把权限写进工具签名,不写进提示词

提示词是给人看的,工具签名才是系统执行的边界。这是最小权限能不能落地的分水岭。

@tool(scope="read-only", market="US")
def lookup_refund_policy(order_id: str): ...

@tool(scope="fund", required=["approver_id", "idempotency_key"])
def issue_refund(order_id, amount, approver_id, idempotency_key): ...

即使模型被越狱,issue_refund 缺参直接拒绝。工具层不依赖模型乖不乖。

步骤三:分阶段发 token,先只读两周

最稳的节奏:

  1. Phase 1 只读:只发 read_token,Agent 跑两周,把"想做的动作"记成 proposed 日志,不落库。
  2. Phase 2 受限写:逐个开 write_token,每个动作配审批档。
  3. Phase 3 资金:最后开 fund_token,强制双签 + 幂等。

跳过 Phase 1 直接全开,然后用审批兜底,是事故的起点。

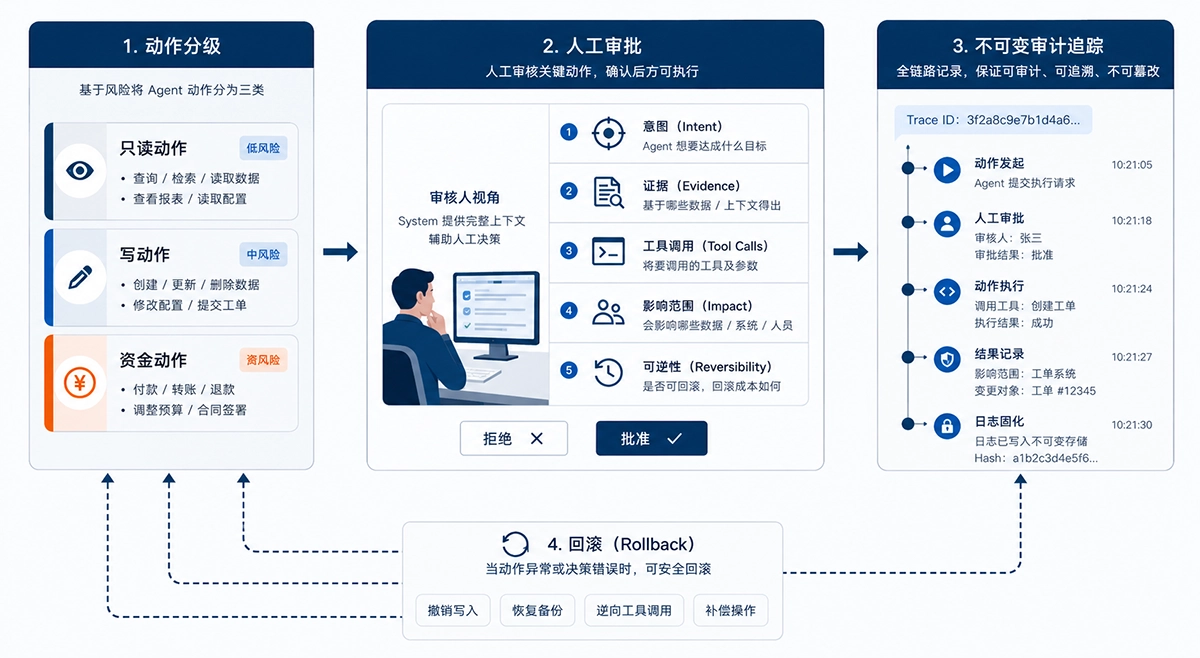
步骤四:动作分三档
在这里插入图片描述

按"是否可逆 + 金额上限"分:

  • 自动档:查询、草稿、建工单。错了重来。
  • 单人审批档:改状态、非资金通知、低风险设置。可逆。
  • 双人审批档:退款、改预算、删数据、跨市场写。资金或不可逆,四眼原则。

判断标准一句话:做错了 5 分钟内能否无损撤回?不能就别自动跑。

提醒:改广告预算比一次退款更隐蔽。退款立刻报警,预算被悄悄改可能三天后才露馅。资金边界不能只看"是否直接转账"。

步骤五:审批页渲染五类证据

有效的企业 Agent 权限管理,审批页要一次性给审核人:

  1. 意图:哪条消息/政策触发?
  2. 证据:看了哪些数据,可点溯源?
  3. 工具调用:调哪个工具、传什么参数?
  4. 影响范围:动多少钱、几个订单、哪个市场?
  5. 可逆性:点批准之后还能撤吗、怎么撤?

缺一样就是盲签。审批质量取决于喂了多少证据,不是加了多少按钮。

步骤六:四道防线 deny / retry / rollback / audit

def execute(action):
    if not has_evidence(action):        # deny
        raise Denied()
    if action.idempotency_key in seen:  # retry 安全
        return seen[action.idempotency_key]
    result = call_tool(action)
    seen[action.idempotency_key] = result
    audit.log(trace_id=action.trace_id, approver=action.approver_id)  # audit
    return result

def rollback(trace_id):
    compensations[trace_id]()           # reverse / snapshot / soft-delete
  • deny:证据不足/超权限,系统直接拦。
  • retry:幂等键防重复副作用。
  • rollback:退款冲正、预算快照、删除软删+回收站。
  • audit:每次调用带 trace_id,串起决策/参数/审批人/时间。

没有幂等键的 retry 是灾难,没有快照的 rollback 是空话,没有 trace_id 的 audit 是甩锅。

步骤七:用动作矩阵沉淀权限

动作分级角色上限证据审批幂等键回滚
查询订单读Agent无无系统query_id无
生成建议读(出)Agent无政策版本系统draft_id无
创建工单写Agent低订单+原因系统ticket_id关工单
修改状态写Agent+1中原/新+依据单人op_id还原
发起退款资金Agent+2≤¥500单/>¥500双订单+政策+时效+确认双人refund_id冲正
改广告预算资金Agent+2日预算封顶旧/新+理由双人budget_id快照还原

每周复盘:审批人离职?上限半年没调?动作从"单人"偷升"自动"?

步骤八:避开五个失效模式

  • 审批疲劳:高低风险混排,真人变橡皮图章。
  • 共享账号:一群 Agent 共用 admin token,出事分不清谁。
  • 不可回滚:删库、发外邮、改全局,点了不可逆。
  • 日志不全:只记"调了什么",不记"凭什么、谁批的"。
  • 权限漂移:业务变了权限没变,临时写权限忘了收。

独家观点:治理最小单位是动作,不是模型

行业谈治理总盯"模型安不安全"。但企业真正要审计的是动作——它看了什么、调了什么、改了什么、能否恢复。沙盒里对答如流 vs 能改你广告预算,风险不在一个量级。决定量级的是动作不是模型。把治理下沉到动作层,每个动作配齐角色/上限/证据/审批/幂等键/回滚,模型再抽风也被框在小格子里。

亚马逊场景提示

运营 Agent 能碰查 BSR、改竞价、调预算、读评论、代发邮件。建议:

  • 实时数据(价格/排名/广告位/评论)交给 Amazon Data API 提供"看"的事实;
  • 任何改后台的动作走最小权限 token + 双人审批 + 幂等键 + 回滚。

亚马逊政策随市场/季节/类目剧烈变化,外部事实统一从可信数据层拉,至少"基于哪版政策决策"可追溯,避开权限漂移。

第二现场:被悄悄改掉的广告预算

退款事故一眼就能看见,因为它立刻报警。更隐蔽的是预算被悄悄改。

有个团队把"改广告预算"分级在"写"而不是"资金",理由是"只是调个数字,不直接转账"。结果一次策略误判,把某 ASIN 日预算从 ¥200 顶到 ¥2000,连烧三天才在周报发现。三天 × ¥1800 ≈ ¥5400 无声损耗,还不算转化浪费。

两个教训:第一,资金边界不能只看"是否直接转账",任何"会烧钱"的动作都要双签 + 回滚;第二,不可回滚动作靠审批追不回来,必须靠快照分钟级止损。把预算当"写"是第二常见的权限事故源。

90 天落地排期(照抄可用)

  • 第 1–2 周(只读):只发 read_token,Agent 跑 proposed 日志,不落库。看清它想碰什么。
  • 第 3–6 周(受限写):逐个开 write_token,配审批档与五证据审批页。先开可逆动作。
  • 第 7–10 周(资金 + 回滚):开 fund_token,强制双签 + 幂等键 + 回滚,trace id 串全链路。
  • 第 11–12 周(周审):动作矩阵进周会,清离职审批人、收临时写权限。

把前 6 周压成"上线即全开",等于把事故也压进了前 2 周。

自检清单(上线前 10 问)

  1. 读/写/资金是三个 token 吗?
  2. 权限在工具签名还是只在提示词?
  3. 第一阶段只读吗?
  4. 每动作审批档写清了吗?
  5. 审批页展示意图/证据/调用/影响/可逆性了吗?
  6. 每动作有幂等键吗?
  7. 每可逆动作有回滚吗?
  8. 每次调用有 trace id 吗?
  9. 有不可回滚动作混进自动档吗?
  10. 动作矩阵本周复盘了吗?

答不上 3 个,先别让 Agent 碰资金。

成本账

5 万咨询量/月的运营,盲签导致 10% 误动作,5% 变 ¥50 投诉 = ¥12,500/月、¥150,000/年;加 10 复核人力 ¥500 万。治理代价 = 一个兼职 owner + 周脚本。放任才是最贵的方案。

五个误区

  • “有审批就安全”——审批是责任转移,不是边界。
  • “模型乖就不会乱动”——边界在工具层,不靠模型。
  • “预算不是资金”——会烧钱必须进资金档。
  • “记了调用就够了”——还要证据、审批人、trace id。
  • “配一次永久有效”——权限会漂移,必须周审。

强监管行业额外要求

金融/医疗/政务还要两层:职责分离(SoD)有书面留痕,审计师逐项核;外部实时事实来自可信数据层,不让 Agent 自己抓网页猜政策。像 Amazon Data API 这种实时数据层,价值是把"基于哪版政策决策"变成可举证事实。

治理健康度看什么

别只看"有没有审批"。盯五个数:审批拒绝率(长期 0 说明形同虚设)、平均审批耗时(过长=证据不够)、不可回滚动作占比(趋近 0)、trace id 覆盖率(必须 100%)、权限漂移次数(周审问题数)。这五个比"我们加了审批"诚实得多。

审批页前后对比:同一笔退款,两种页面

坏的页面:“Agent 请求退款 ¥3,800,是否批准?” 好的页面:意图(买家说货损)、证据(订单 A 已签收;政策 v2025 30 天窗口可退)、工具调用(issue_refund 3800 市场 US)、影响范围(1 单 ¥3,800)、可逆性(24h 内可冲正)。同一个动作,两种决策。坏页面产出盲签,好页面产出真实判断,也常常产出证据不足时的果断"拒绝"。

反模式清单

  • 审批人写进提示词:软请求,模型可忽略。
  • 共享 admin token:出事分不清谁。
  • 日志只记动作名:不记证据、审批人、trace id。
  • “模型拒绝了"当"安全”:拒绝 ≠ 已验证边界。
  • 小额定额自动批:仍在训练盲签习惯。

人的一面:让审批人买账

最快毁掉治理的是淹没审批人。两招:把"影响范围"高亮,让高危动作从安全动作里跳出来;把"拒绝"做成一键。审批人相信页面给了该看的东西,审批质量才上得去、疲劳才下得来。治理是人际系统,为人而设计。

把治理写进 PRD:给工程团队的最小检查单

上面这些机制如果只存在文档里,上线一周就走样。落地最稳的办法是把它写进 PRD,变成工程团队改不掉的硬约束。我们给客户的 PRD 模板里永远有一节"权限与回滚",强制填四项:① 这个 Agent 第一次上线只允许 read_token,写与资金权限默认关闭;② 每个会改业务状态的动作,必须写出它的证据字段、审批档、幂等键与回滚函数,缺一项 PRD 打回;③ 外部事实(政策版本、价格、排名)统一来自可信数据层,禁止 Agent 自己抓网页;④ 周审动作矩阵进迭代评审,每次发版前确认没有权限漂移。

这节最大的好处是"甩锅"变"对账"。出了问题,翻开 PRD 就知道是设计漏了回滚,还是上线偷偷开了自动档,而不是互相猜。它也让新人或外包接入时,按同一套语言讨论权限,不至于每人一套"我的 Agent 我信任"标准。治理真正落地,靠的是把边界写进 PRD 这种无聊的地方,而不是靠谁在会上拍胸脯说"我信它"。

落地小结:治理不是按钮,是系统

把上面这些串起来,企业 Agent 权限管理就是一套可重复的机制:分级的动作、每次审批都亮证据、每个动作带幂等键、每个可逆动作有回滚、每次调用有 trace id,并且每周复盘一次。它不是一个"批准"按钮,而是一套让"批准"这两个字终于有意义的系统。做到这些,Agent 才从玩具变成能托付业务的同事。

总结

企业 Agent 权限管理治的是"责任",不是"开关"。当"批准"不再是盲签、出错一定能撤、出事查得到谁,Agent 才从玩具变同事。

系列前作:客服 Agent 拒答能力、端到端集成、Agent 不是交付单位、项目管理 Agent 系统集成、AI 转型 SOP 还是进入流程、企业 AI 知识库为什么会失效。有疑问欢迎评论区交流。

OpenClaw本地AI工作流:零代码部署飞书Agent全指南 AI Agent 是一种能自主感知、决策与执行的智能体,其核心在于将大模型能力嵌入具体业务流程。OpenClaw 作为典型的本地化AI Agent框架,不依赖云端服务,而是基于Node.js在Win/Mac本地运行,通过OAuth2.0安全对接飞书API,实现消息处理、文档生成、日程协调等自动化任务。它强调数据主权与合规可控,适用于对隐私敏感、需规避数据出境的企业场景。技术价值体现在‘零代码封装’与‘七层穿透式集成’——从本地运行时、反向代理、权限沙盒到上下文注入和审计网关,形成端到端可追溯的AI工作流。本 阅读详情

相关推荐

Agent Suite办公智能体套件:低代码搭建企业数字员工

智能体(AI Agent)正从概念走向企业办公的日常实践。与传统聊天机器人仅停留在“问答”不同,智能体通过感知、规划、调用工具与执行反馈的循环,直接完成任务交付。RAG(检索增强生成)与低代码工作流编排,让企业无需从零搭建即可构建具备记忆与协作能力的数字员工。在销售周报自动化、员工服务台、客服知识库等场景中,智能体正显著降低重复劳动成本。腾讯推出的Agent Suite办公智能体套件,正是这类能力的集成交付形态:它向下连接大模型,向上打通企业微信、腾讯文档等办公入口,以低代码方式实现从自然语言到可落地任务流

aoe41606的博客 430

构建企业级AI Agent:从核心能力到工程落地的全栈指南

AI Agent作为智能体技术,其核心原理在于通过大型语言模型(LLM)理解任务意图,并结合规划、工具调用与记忆等能力,将复杂流程自动化。这项技术的核心价值在于将不确定的业务流程转化为确定、可管理的自动化服务,从而在客户服务、数据分析和内部审批等企业场景中释放生产力。要实现从‘玩具’到‘生产力’的跨越,关键在于满足企业级应用对稳定性与安全性的严苛要求。本文聚焦于如何构建真正可落地的企业级Agent,深入探讨了其必须具备的可靠性、智能性、连接性与可管理性四大核心能力矩阵,并提供了涵盖架构设计、技术栈选型、安全

weixin_30696427的博客 369

AGI定义之争:OpenAI年底目标背后的技术信号与开发者指南

通用人工智能(AGI)一直是人工智能领域的终极愿景,但业界对其定义与实现路径众说纷纭。OpenAI提出五级能力体系,将AGI具象化为“能像中等水平同事一样独立完成复杂任务的智能体”,并预计年底前实现其定义的AGI。从ChatGPT Agent到开源Codex harness,从多模态模型到API生态,技术信号表明AI正从“对话生成”走向“任务自主执行”。这一转变对开发者意味着应用范式从调用模型转向编排行为,Agent工程、可观测性和安全设计成为新焦点。本文深入解析AGI定义背后的技术逻辑,帮助开发者理解并应

aoe41606的博客 388

腾讯Agent Suite办公智能体实战:从连接到编排的企业AI落地指南

智能体(AI Agent)正从单纯的问答机器人向能够真正执行任务的办公自动化工具演进。其核心原理在于将自然语言意图映射为一系列可调用的系统动作,通过连接器打通企业微信、腾讯会议、腾讯文档等高频办公应用,实现从信息检索到业务流程闭环的跨越。这种技术价值尤为体现在“最后一公里”的打通上:当模型负责理解与拆解,编排层负责串联与审计,智能体便能自主完成会议纪要生成、待办提取、文档归档甚至审批触发等跨系统协作任务。在企业AI落地场景中,无论是人力资源的入职流程、客服工单的自动处理,还是项目周会后的任务分发,办公智能体

weixin_33525298的博客 139

企业级Web系统六大生存原则:约束先行、数据契约、错误常态、部署即验、权限光谱、文档呼吸

在企业级Web系统开发中,稳定性与可维护性远比功能堆砌更重要。本文围绕‘约束管理’‘数据契约’‘错误处理’‘部署验证’‘权限控制’‘文档协同’六大核心概念展开,深入解析其底层原理——如约束如何定义技术边界的刚性阈值,数据契约如何解耦前后端演进节奏,ABAC模型如何替代RBAC应对复杂授权场景。这些并非理论空谈,而是源于37个中大型项目沉淀的工程实践方法论,具备强落地性:支持YAML化约束确认、OpenAPI驱动契约开发、E码体系错误分级、四重门自动化部署验证、OPA策略引擎集成、Git托管文档活性监控。适用

weixin_34327223的博客 344

企业级技术交付的五位一体闭环方法论

企业数字化转型中,‘系统建得出来’不等于‘用得好、管得住、传得下’。本文聚焦技术交付的完整生命周期,从开发实现、架构设计、运维管理、能力培训到解决方案落地,系统阐述如何构建可验证、可传承、可演进的企业技术资产。核心围绕‘架构锚点前置’‘管理即代码(MaaC)’‘场景化能力认证’三大实践原则,解决开发与架构脱节、管理与执行割裂、培训脱离真实故障等典型顽疾。内容深度融合DevOps、GitOps、混沌工程、可观测性等现代工程实践,面向CTO、交付负责人及技术管理者,提供经12个真实项目验证的 checklist

dingguayi7025的博客 506

企业部署 AI 员工,先补控制面,不要只扩员工数

Grok Bot 企业版更新的重点不是多开 Bot,而是访问、网络与审计控制。本文结合这次更新,梳理企业部署 AI 员工时最容易被忽视的“权限债务”问题,并给出一套可落地的四层控制面:组织规则、岗位权限、动作审批、证据回执,以及新岗位的四级放行流程和一份上线前检查表。

nagualky123的博客 263

【信息科学与工程学】【数据中心】第二十三篇 DDC网络-满足大规模训练、推理、存储区网络(Roce2组网)-第四篇 跨地域互联(管理区和推理区)

智算中心互联

weixin_49199313的博客 782

企业级Agent平台落地实践:从超级个体到超级团队

智能体(Agent)已成为企业数字化转型的热门方向,但许多团队在落地时发现,单纯依赖大模型能力并不能解决实际问题。企业级Agent平台的核心价值在于将对话式AI升级为可管控的业务执行单元,通过身份权限、技能工具、知识库、工作流编排、审计日志等能力,实现从个体效率工具到团队协作基础设施的跨越。权限治理与流程管控是决定Agent能否在企业内长期稳定运行的关键,而灰度发布与可观测性则保障了系统的安全与可控。本文从工程实践角度,剖析企业级Agent平台的关键能力、配置要点与常见陷阱,结合腾讯云WorkBuddy E

weixin_34074740的博客 425

408计算机复试专业课问答汇总

408计算机复试专业课问答汇总

weixin_45930223的博客 3698

VS Code 配置 LaTeX 写作环境完全指南

本文详细介绍了如何在 VS Code 中配置 LaTeX 写作环境,涵盖了从安装必备组件到高级功能的全面指南。首先,用户需要安装 LaTeX 发行版(如 TeX Live 或 MiKTeX)和 VS Code 插件(如 LaTeX Workshop)。接着,通过修改 settings.json 和 keybindings.json 文件,用户可以自定义编译、查看快捷键等基础配置。文章还提供了高效写作技巧,如使用代码片段和多文件项目管理,并介绍了高级功能如反向同步、公式预览和参考文献管理。此外,针对常见问题(

weixin_70043030的博客 1984

企业级Agent落地指南:从超级个体到超级团队的架构、能力与避坑经验

Agent智能体正从个人效率工具走向企业生产系统,二者之间的分水岭并非模型能力,而是工程化、组织化与安全治理体系。个人场景下,Prompt编写与知识库管理可依赖人肉纠错;团队场景则需面对多角色、多权限、多系统的复杂环境,核心是把Agent作为组织资产进行生命周期管理。一个成熟的企业Agent平台,应涵盖构建层、运行层与治理层,并重点解决知识库私域接入、工具注册与权限编排、多Agent协作等关键问题。真正卡住企业落地的四项能力是记忆分层、技能沉淀、评估体系与安全治理。实际推进时,建议从知识问答、内容生产、数据

weixin_34248023的博客 362

51单片机也能玩转GC9A01彩屏?超详细移植指南与性能优化技巧

本文详细介绍了如何在51单片机上高效驱动GC9A01彩屏,包括硬件连接优化、SPI模拟驱动、内存管理策略及高级刷新技术。通过分段缓冲、颜色压缩和差异化刷新等技巧,显著提升显示性能,使51单片机也能流畅运行240x240分辨率的彩色TFT屏幕。

hp777的博客 189

PolarDB Agent Express:无代码构建企业级AI智能体的数据库原生方案

AI智能体是当前企业智能化升级的核心载体,其本质是将业务规则、知识库与决策逻辑封装为可调度、可审计、可集成的服务单元。传统方案依赖LangChain等框架编写复杂链路,而真正落地需兼顾确定性、可控性与运维友好性。PolarDB Agent Express以数据库为底座,通过向量化引擎、SQL-to-NL推理层和智能体即服务(AaaS)抽象,实现‘上传知识—定义触发—配置输出’的极简范式。它天然支持行级权限、全链路TraceID追踪、SQL级故障定位,让AI能力具备DBA可管、可观、可溯的工程属性。本文聚焦电

weixin_29070721的博客 119

【本体】Protege高效批量导入实例(Individuals)的自动化实践

本文详细介绍了在Protege中高效批量导入实例(Individuals)的自动化实践方法。通过分析Protege本体文件结构,提供Python脚本示例,帮助用户快速处理大规模数据导入,显著提升知识图谱构建效率。特别适合需要处理数千个实例的医疗、制药等领域应用。

weixin_30275415的博客 408

独立游戏之路:Tap篇 -- 个人开发者上架TapTap步骤和注意事项

作为一名游戏开发者,将自己的独立游戏上架到 TapTap 平台是一个不错的选择。TapTap 是一个拥有大量用户的游戏社区平台,上架游戏可以让更多的玩家发现和体验你的游戏。TapTap 是一个游戏社区平台,用户可以在平台上下载和分享游戏。TapTap 拥有大量的用户,并且用户活跃度高,这为独立游戏开发者提供了一个很好的展示和推广平台。进入TapTap开发者服务后台。

陈言必行 -- Unity游戏开发领域优质博主 6404

WorkBuddy Enterprise:企业级AI Agent平台实战指南

企业级AI平台正从概念走向生产落地,核心已不再是大模型能力本身,而是如何构建可嵌入业务系统、满足合规要求、具备确定性输出的智能体(Agent)协同体系。其本质是将AI转化为业务神经末梢——依赖结构化感知、DSL编排决策、系统级执行三层解耦架构,解决ERP/MES/CRM等异构系统间的数据孤岛与流程断点。技术价值体现在低幻觉推理、高可靠执行、零信任安全与等保三级适配,广泛应用于制造设备预测性维护、供应链根因分析、质量追溯等强规则、高时效、严审计场景。WorkBuddy Enterprise正是这一演进路径的典

weixin_33907511的博客 163

【教程4>第1章>第12节】通过Verilog读取txt格式数据进行测试并将结果导入到matlab

我们在verilog的testbench中,调用txt文件,将上述正弦样本数据作为测试激励输入到verilog模块中。通过这个方法,可以将一些较为复杂的数据导入到verilog中,进行FPGA数据处理模块的开发。即通过w方式打开一个新的txt文件,然后将verilog的输出保存到XY1.txt文件中。这个部分是txt文件的路径,实际使用时,修改为您自己的路径,或者将txt文件放在和我一样的路径中。这个是数据长度,matlab产生的txt多少长度,这个参数就修改为多少长度。这个txt就是保存这段数据的文件。

FPGA/MATLAB学习教程/源码/项目合作开发 1374

2026企业AI平台选型指南:通用与垂直平台的全面对比

随着大模型能力的商品化,企业AI平台选型已从“有没有”转向“选哪个”。基座模型在通用任务上的差距快速收窄,真正拉开距离的是平台层的模型管理、数据接入、Agent编排与私有化部署能力。通用平台擅长提供统一底座与生态协同,适合知识库问答、办公助手等横切场景;垂直平台则深耕行业Know-how,在金融风控、工业质检、医疗辅助诊断等场景中具备难以复制的模板与资质壁垒。面对混合部署、MCP开放协议等新趋势,企业需从业务场景、数据主权、团队能力、成本模型与迁移风险五个维度建立评估框架,并通过设计有效的POC让数据辅助决

weixin_33806914的博客 366

手把手教你学simulink实例--基于Simulink的航空航天器飞行轨迹规划与仿真详细介绍

航空航天器飞行轨迹规划是实现高效、安全和精确飞行的关键技术。通过Simulink进行航空航天器飞行轨迹规划与仿真,可以验证控制算法的有效性、优化飞行路径,并降低开发成本。以下是如何在MATLAB和Simulink中设计并仿真一个航空航天器飞行轨迹规划系统的详细步骤。通过上述步骤,我们成功设计并实现了基于Simulink的航空航天器飞行轨迹规划与仿真系统。该系统能够根据实时环境变化动态调整飞行轨迹,从而提高飞行效率、降低燃料消耗并提升安全性。

MHD0815的博客 388

目标检测YOLO实战应用案例100讲-【目标检测】缺陷检测(二)

在工业生产中总是经常遇到裂痕、划痕等产品的表面缺陷问题,机器视觉行业对于表面检测相比前几年已经有很大的突破,对于产品表面的划伤、污迹等检测已经不再是难点。在金属、玻璃、手机屏幕、液晶板等行业表面检测上应用广泛。但由于该类缺陷形状不规则、深浅对比度低,而且往往会被产品表面的自然纹理或图案所干扰。因此,表面划痕缺陷检测对于正确打光、相机分辨率、被检测部件与工业相机的相对位置、复杂的机器视觉算法等要求非常高。

qq_36130719的博客 728

AI智能体的评估体系:怎么知道你的Agent到底行不行?

AI智能体评估体系与实践指南 本文系统构建了一套AI智能体的科学评估框架,针对传统主观评测的不足,提出模块化评估方案。核心内容分为: 评估维度:将智能体能力拆解为五大可测量模块(推理规划、工具调用、记忆管理、任务完成、安全合规),每个维度下设具体指标,如工具调用准确率、任务成功率等。 评测方法组合: 离线基准测试(日常快速验证) 仿真沙箱环境(模拟真实交互) LLM辅助评估(开放性问题评分) 红队对抗测试(安全边界检测) 电商客服案例实践: 构建200个覆盖核心场景的测试任务集 采用多阶段评测组合

2601_96632650的博客 669

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

Agent-S3:首个超越人类性能的计算机交互智能体框架实战指南

在计算机交互智能体领域,技术团队长期面临着一个核心挑战:如何构建能够像人类一样理解和操作计算机系统的AI助手?传统的自动化脚本缺乏适应性,而基于规则的GUI自动化工具又难以处理复杂多变的真实环境。Agent-S3作为首个在OSWorld基准测试中超越人类表现的开源智能体框架,为这一技术难题提供了革命性的解决方案。Agent-S3通过创新的统一架构设计和行为最优N次策略,在复杂GUI交互任务中实现了

gitblog_00505的博客 1207

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

AI作为认知基础设施:从执行工具到决策协作者的范式跃迁

人工智能正经历从‘自动化执行’向‘认知协同’的本质升级,其核心已不再是算力或模型参数,而是软件系统对人类意图的理解、可信决策的生成与跨系统闭环执行的能力。这一转变直指当前AI落地的关键瓶颈:意图建模缺失导致功能碎片化、可信度机制缺位引发专业场景拒用、连接权垄断加剧数据主权让渡。面向教育、医疗、政务、制造等高价值领域,真正可用的AI系统必须具备可溯源的知识整合能力、可审计的推理过程、可验证的意图闭环,以及对现实世界服务链路(如API、政策、硬件)的深度编排能力。本文聚焦于将大模型能力转化为稳定生产力的工程化路

android_mylove的专栏 343

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

用AI打造高品质Web应用:完整工程链路与落地实践

人工智能辅助软件开发正从代码补全走向全流程工程化。其核心原理并非让AI自由生成代码,而是通过清晰的任务描述与上下文管理,将稳定性、安全性、可观测性等工程标准转化为模型可执行的约束。这种模式显著提升了Web应用的交付效率,同时在测试、性能、安全加固和部署监控等环节形成新的实践路径。在企业内部管理系统、数据面板等典型场景中,借助Django、Redis、Docker等主流技术栈,AI已能支撑从需求拆解到上线运维的完整链路。本文基于实际项目经验,梳理AI辅助开发高品质Web应用的工程方法与取舍。

weixin_34212762的博客 278

AI智能体不是高级仪表盘,数据团队该用“数字员工”思维重构数据价值

在数字化转型浪潮中,数据分析正从“被动看板”走向“主动执行”。传统仪表盘擅长呈现数据,却无法驱动决策与动作;而AI智能体以模型推理、工具调用和工作流编排为技术底座,能够自动完成归因分析、方案生成甚至业务动作触发,本质上是具备闭环能力的数字员工。其技术价值在于将数据、动作、反馈三支柱贯通,让结论直接转化为可执行结果。从指标异常归因到自动补货建议,智能体已在电商、运营等场景落地。数据团队若想让智能体真正创造价值,应摆脱报表惯性,按“数字员工”而非“高级仪表盘”来设计,才能从“看数”跨越到“做事”的新阶段。

weixin_33816946的博客 291
上一篇: 企业 AI 知识库为什么会失效?从“能搜到“到“能证明“的治理实践
下一篇: 1. 亚马逊品牌运营驾驶舱搭建教程|BSR / 价格 / 关键词 / 评论全监控
devnullcoffee
博客等级 码龄1年 165粉丝 107原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值