用python+BeautifulSoup爬百度知道的答案

手把手教你用Python爬取百度搜索结果并保存 回复“书籍”即可获赠Python从入门到进阶共10本电子书 今 日 鸡 汤 朝辞白帝彩云间,千里江陵一日还。 一、前言 大家好,我是崔艳飞。众所周知,百度上直接搜索关键字会出来一大堆东西,时常还会伴随有广告出现,不小心就点进去了,还得花时间退出来,有些费劲。 最近群里有个小伙伴提出一个需求,需要获取百度上关于粮食的相关讲话文章标题和链接。正好小编最近在学习爬虫,就想着拿这个需求来练练手。我们都知道,对Python来说,有大量可用的库,实现起来并不难,动手吧。最后,如果你的时间不是很紧张,并且又想快速的提高, 阅读详情

因需要一些资料,就写了个爬虫爬取百度知道前N页的所有答案
不过鉴于百度知道的回答质量(你懂得。。。。),爬取的内容仅供参考

替换一下url_root和file_name基本就能通用了
注:每个网站使用的标签不一样,代码仅适用于百度知道,其他网站自行修改
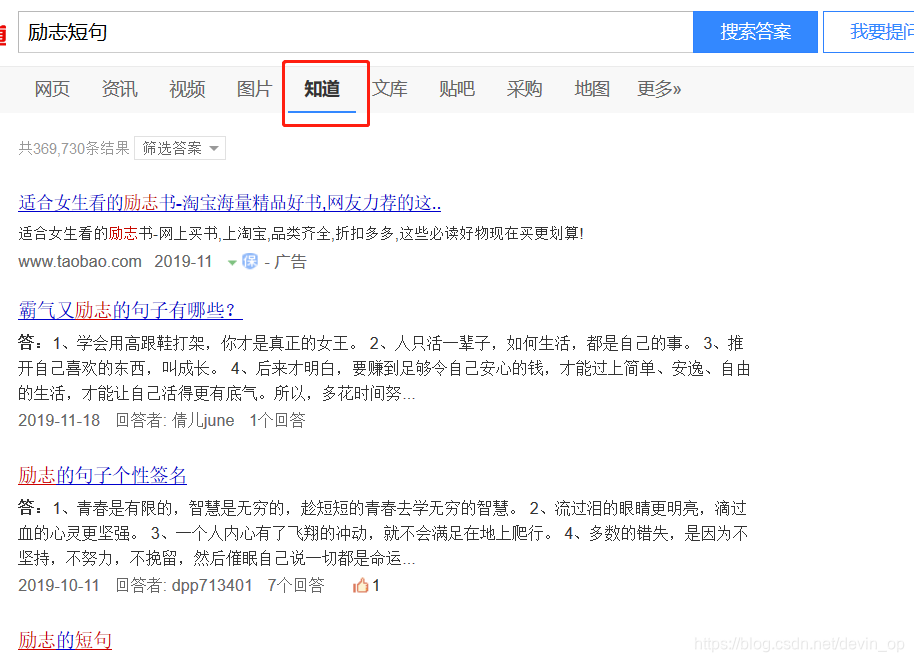
在这里插入图片描述

# -*- coding: utf-8 -*-
import requests
from bs4 import BeautifulSoup
import lxml


url_root = 'https://zhidao.baidu.com/search?word=%C0%F8%D6%BE%B6%CC%BE%E4&ie=gbk&site=-1&sites=0&date=0&pn=0'
file_name = 'C:\\Users\\username\\Desktop\\sort_statement.txt'


# 获取下一页的url
def get_next(url):
    strhtml = requests.get(url)
    soup = BeautifulSoup(strhtml.text, 'lxml')
    source = soup.find_all('a', class_='pager-next')
    return "https://zhidao.baidu.com" + source[0]['href']


# 获取当前页的所有问答详情页url
def get_page(url):
    strhtml = requests.get(url)
    soup = BeautifulSoup(strhtml.text, 'lxml')
    source = soup.find_all('a', class_='ti')
    url_list = []
    for row in source:
        url_list.append(row['href'])
    return url_list


# 获取问题答案
def get_answer(url):
    strhtml = requests.get(url)
    strhtml.encoding = 'gbk'
    new_html = strhtml.text.replace('<br />', '\n').replace('<p>', '\n').replace('</p>', '\n').replace('<br>', '\n')
    soup = BeautifulSoup(new_html, 'lxml')
    source = soup.find_all('div', attrs={'accuse': 'aContent'})
    with open(file_name, 'a', encoding='utf-8') as file_object:
        for row in source:
            file_object.write(row.text + '\n')


for i in range(1, 11):
    url_root = get_next(url_root)
    for url in get_page(url_root):
        get_answer(url)


运行结果截图:
在这里插入图片描述
PS:
玩爬虫需谨慎,别IP被封了就不好了,可以在代码中添加sleep等措施来避免,如下图,应该是被网站认为成攻击行为了,抛出了10054异常
在这里插入图片描述

我的第一个爬虫项目---关于知道的爬虫和心得 最近在浏览百度知道的时候,突然间想将百度知道的问题和答案爬取下来,以便分析知道上大家关注的重点是哪些。 文章目录 python版本 运行环境 前期准备工作 3.1 抓包工具 3.2 请求库 3.3 解析库 大致流程 分析网站及主要代码 运行结果 GitHub地址 后记 一、python版本 使用的是python 3.6 二、运行环境 MAC OS 10.13 三、前期准备工作 3.1 抓包... 阅读详情

相关推荐

Python使用webdriver爬取百度文库

前言 不知道大家有没有过这样的经历,当你写论文搜索资料时,好不容易搜到一篇好文章准备往自己论文里复制时发现复制不了,所以只能硬着头皮把那段话又一个字一个字敲出来(大多数百度文库就是这样)。这样其实很费时间的。那有没有什么好办法啊?我的答案是 当然有啊。接下来就给大家献上我的方法。 1 准备工作 当然干这种事并不是那么简单的,还要做准备工作。记得我之前也写过一个爬虫,但是用我之前写得爬虫去爬取百度...

Funny 657

python初学者是怎么写爬虫的?(16行代码爬百度),深入理解JVM的核心知识点

现在能在网上找到很多很多的学习资源,有免费的也有收费的,当我拿到1套比较全的学习资源之前,我并没着急去看第1节,我而是去审视这套资源是否值得学习,有时候也会去问一些学长的意见,如果可以之后,我会对这套学习资源做1个学习计划,我的学习计划主要包括规划图和学习进度表。class为’result-op c-container xpath-log’的为百度自家的内容(可以按需筛选)class为’result c-container '的为非百度,非广告的内容(我们需要的内容),即进入百度,随便搜索什么,我这里用。

m0_61369275的博客 757

python爬虫之爬取百度音乐的实现方法

今天小编就为大家分享一篇python爬虫之爬取百度音乐的实现方法,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧 在上次的爬虫中,抓取的数据主要用到的是第三方的Beautifulsoup库,然后对每一个具体的数据在网页中的selecter来找到它,每一个类别便有一个select方法。对网页有过接触的都知道很多有用的数据都放在一个共同的父节点上,只是其子节点不同。在上次爬虫中,每一类...

python爬虫开发教程 4735

python练习踩得坑-爬取百度页面

python爬取百度网页时,无法显示中文的问题

m0_52150351的博客 633

用python如何获取批量下载百度知道的回答内容

在上面的代码中,使用requests库发起HTTP请求,获取百度知道的搜索结果页面。然后使用正则表达式匹配回答内容,并使用findall()函数返回所有匹配的结果。如果要批量下载百度知道的回答内容,可以使用爬虫程序来自动抓取。希望上面的示例代码能够帮助你实现批量下载百度知道的回答内容。注意:爬虫程序需要遵守网站的使用规则,不得进行非法抓取。

zhangzhechun的专栏 1110

python如何用seleinum 搜索下载百度知道的回答内容

下载驱动:请到 Microsoft Edge 官网下载最新版本的驱动,https://developer.microsoft.com/en-us/microsoft-edge/tools/webdriver/以上代码实现了以下流程:创建浏览器驱动对象、访问百度知道、定位搜索框并输入关键字、提交搜索请求、定位回答内容并获取、关闭浏览器。注意:请确保安装了 Microsoft Edge 最新版本,并且选择了合适的驱动版本。安装浏览器驱动:下载并安装相应的浏览器驱动,如 ChromeDriver。

zhangzhechun的专栏 551

Python中的爬虫实战:百度知道爬虫

在这里,我们需要爬取的是每一个问题和对应的最佳答案。通过查看百度知道的源代码,我们可以发现每个最佳答案都有其独立的classID,我们可以根据这个选择对应的内容。我们学习了如何使用requests和urllib库发送请求,使用BeautifulSoup库解析网页,及如何保存爬取的结果到csv文件中。百度知道是提供了大量知识问答的网站,本文介绍在python中实现百度知道爬虫的方法。由于百度知道上的每一个问题URL的后缀都是不同的,因此我们需要通过字符串的格式化来自动生成需要爬取的网页地址。

wx_19970108018的博客 2434

BaiduZhidaoSpider:百度知道爬虫,爬取问答对

QA 问答系统,目前还只针对百度知道 QA系统使用说明 1.数据库说明: 数据库中的字段跟师兄给我的一样,只有两个评论字段没有下载。 另外为了实现师兄所说的多线程下载,我在query表,qapair_resultslist表中添加了finished字段,用来表示该条记录是否已经下载过,为1时表示已经下载过,该记录的所对应的网页都已下载到本地,只要调用相应的分析程序即可;为0表示还没有下载。 系统使用说明: 可以有两个方法来执行该程序。 1)运行Main函数(该函数在com.hitsz.main中) 只要数据库中的query表中有查询问句,并且finished字段为0,该函数就会将query中的问句列表逐一的去下载,并将网页结果保存到本地,将分析结果保存到数据库中。中间不需要任何干预,除非出现了还没有考虑到的错误。 整个系统目前使用的还是单线程,因此在下载网页时可能会比较慢,为了防止由于频繁

python数据采集百度知道

dom解析,用的是BeautifulSoup 还有小小的bug,因为百度知道的标签太混乱了 url还好,都是连续的http://zhidao.baidu.com/question/ + 问题的id def parseHtml(resultHtml,questionid): soup = BeautifulSoup(resultHtml) if( soup.fin

crystal_tyan 1474

python爬取知乎答案.py

python爬取知乎问题下的所有回答,只要输入问题的问题号就能对应爬取内容并进行提取保存成csv文件

AVL_Cruise_interface\Simulink联合仿真

分享了AVL_Cruise通过interface模块与Simulink进行联合仿真的过程

qq_64735036的博客 2678

python 爬取百度知道_python3爬取百度知道的问答并存入数据库(MySQL)

一、链接分析:以"Linux"为搜索的关键字为例:首页的链接为:https://zhidao.baidu.com/search?lm=0&rn=10&pn=0&fr=search&ie=gbk&word=linux第二页的链接为:https://zhidao.baidu.com/search?word=linux&ie=gbk&site=-1...

weixin_39687990的博客 1328

Dify与钉钉轻量级集成:打造企业内部AI助手

企业级聊天机器人开发已成为提升内部协同效率的关键技术。其核心原理在于通过API集成,将AI模型能力与即时通讯平台无缝连接,实现智能问答与自动化流程。从技术价值看,这种集成方案能够显著降低AI应用落地门槛,将前沿的AI能力快速转化为实际生产力。在应用场景上,它尤其适用于HR答疑、IT技术支持、产品知识库等高频内部服务场景。本文聚焦于Dify与钉钉的轻量级集成方案,通过Stream模式实现高效消息处理,并利用AI卡片支持流式输出,为企业构建体验自然的智能机器人提供了完整实践路径。该方案特别强调配置简化与部署便捷

weixin_27155667的博客 698

python利用百度知道求答题答案

import json import requests from bs4 import BeautifulSoup as BS from urllib import parse #解析问题和答案 def open_question(): with open("tounao.txt","r",encoding="utf-8") as f: res = f.read(...

sf131097的专栏 660

瑞萨单片机,把CS文件转换为CC

1、打开CC的软件: 点击坐上角的"START" 点击"Create New Project"的"GO": 导入工程: 如下图设置后,点击"Create" 2、进入到CC的开发界面: 可以看到原启动库文件以asm文件的方式直接出现在工程中: 删除新生成的main.c,保留导入的r_main.c(以你自己的代码为准): 注意添加所有的头文件路径: 点击"...

weixin_37611121的博客 1228

手把手带你搭建一个语音对话机器人:5分钟定制个人AI小助手

通过本文的简单步骤,你已经掌握了如何用 Python 搭建一个语音对话机器人。我们使用了实现语音识别,利用 OpenAI API 生成对话内容,并通过gTTS将文本转换为语音。整个流程非常简洁,你可以根据自己的需求进一步扩展机器人功能,甚至将其集成到实际的应用场景中。

小蜗牛的珍贵百宝箱 4806

Python2 爬取百度知道问题对

不包含保存部分 主要参考 https://github.com/Lenswill/BaiduZhidao 功能包括提取最佳答案,若无最佳答案则遍历所有其他回答。 未包含保存部分。 #!/usr/bin/env python2 # -*- coding: utf-8 -*- """ Created on Wed Jul 12 16:12:28 2017 @author: azurew

sudsn的博客 1995

爬虫Incapsula reese84加密案例:Etihad航空

声明:该文章为学习使用,严禁用于商业用途和非法用途,违者后果自负,由此产生的一切后果均与作者无关。

老衲爱洗头的博客 2430

根据关键词爬取 百度知道 问答内容

利用了BeautifulSoup+CSS选择器, 代码如下 import requests from bs4 import BeautifulSoup import pandas as pd import csv import time #获取URL的函数 def get_url(url): wb_data = requests.get(url) wb_data.encoding...

weixin_45112546的博客 1444

第 9 篇:TMC2240 速度调节实战|STEP 信号生成 + 平滑调速算法(无抖动)

摘要:本文详细介绍了TMC2240电机调速方案,重点解决调速时电机抖动、丢步等问题。核心原理是通过STEP信号频率控制转速,结合平滑加减速算法避免电流冲击。文章从速度与STEP频率的数学关系入手,提供了定时器生成固定频率STEP信号的实现代码,并给出不同转速下的频率参数表。针对42步进电机+256微步细分场景,详细讲解了定时器初始化、中断处理及固定转速设置方法,帮助开发者实现稳定调速。全文包含可直接复用的代码片段,适合嵌入式开发者快速实现电机平滑调速功能。

BackCatK Chen的博客 1035

Python全栈入门到实战【基础篇 05】核心基础:Python的2种运行模式(交互式+命令行式)

Python代码运行模式详解:交互式与命令行式对比 摘要: Python提供两种核心运行模式:交互式(REPL)和命令行式(脚本式)。交互式模式适合快速测试语法,即时反馈结果,通过终端输入python启动,特点是无需保存、临时执行,适合验证小段代码逻辑。命令行式模式需将代码保存为.py文件后运行,适合开发完整程序,可重复执行和修改。两种模式各有优势:交互式便于学习调试,命令行式适合实际开发。掌握两种模式的使用场景和切换方法,是Python入门的关键技能,能显著提升学习效率。

那些看似不起波澜的日复一日,会在某天让你看到坚持的意义 4563

python爬取百度搜索答案题目和摘要

url就自行构造吧 # coding:utf-8 import urllib2 import re from bs4 import BeautifulSoup url = 'http://www.baidu.com/s?ie=utf-8&f=8&rsv_bp=1&rsv_idx=1&tn=baidu&wd=johnkey&oq=john&rsv_pq=88bbfd7700

u014737266的博客 3959

WPS访问权限不足怎么解决??具体怎么操作?

🏆本文收录于 《全栈 Bug 调优(实战版)》 专栏。专栏聚焦真实项目中的各类疑难 Bug,从成因剖析 → 排查路径 → 解决方案 → 预防优化全链路拆解,形成一套可复用、可沉淀的实战知识体系。无论你是初入职场的开发者,还是负责复杂项目的资深工程师,都可以在这里构建一套属于自己的「问题诊断与性能调优」方法论,助你稳步进阶、放大技术价值。

**My Coding Family** 4171

python答题系统的代码,python基于题库答题器

文字识别后,白色框里面的字也会和红色框里的字一同被识别,并以json形式输出,这些信息对我们就是干扰信息,所以,我通过建立了初始化方法里titleregular1、titleregular2、answerregular1 这三个标准进行判定,白色框里的文字与对应,如果判断包含的话,就不添加到题目中或者答案中。print("======================答案区======================\n")

阿发狗伪原创 1790

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

爬虫应用开发:用BeautifulSoup解析数据

BeautifulSoup 是一个强大的 Python 库,用于解析 HTML/XML 文档,支持标签选择、属性获取和文本提取等操作。它提供了 `find_all()`、`find()` 等方法选择器,以及 CSS 选择器,能够快速定位目标元素。通过关联选择,还可以获取父子节点、兄弟节点等关系数据。文章以中国大学排名和百度新闻爬取为例,展示了其在网页数据抓取中的高效性和灵活性。通过发送请求获取网页内容,使用 `find_all()` 等方法提取数据,并将结果保存为 CSV 文件,充分体现了 Beautifu

2502_92785476的博客 2105

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

python3爬取百度知道的问答并存入数据库(MySQL)

一、链接分析: 以"Linux"为搜索的关键字为例: 首页的链接为:https://zhidao.baidu.com/search?lm=0&amp;rn=10&amp;pn=0&amp;fr=search&amp;ie=gbk&amp;word=linux 第二页的链接为:https://zhidao.baidu.com/search?word=linux&amp;ie=gbk&...

cjhjy520的博客 794

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

上一篇: GREENPLUM 5.17 centos 6.10 详细安装步骤
下一篇: 使用手工生成的sql plan baseline,在不改变sql文本的情况下调整其执行计划
devin_op
博客等级 码龄9年 0粉丝 3原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
