Embedding 向量嵌入:语义空间、相似度与模型选择

4、Embedding基础:Embedding 与向量数据库 Qdrant(读作:quadrant /'kwɑdrənt/ n. 象限;象限仪;四分之一圆)是一个向量相似度搜索引擎。它提供了一个生产就绪的服务,具有方便的 API 来存储、搜索和管理点 - 带有附加载荷的向量。专门支持扩展过滤功能,使其对各种神经网络或基于语义的匹配、分面搜索和其他应用非常有用。以下展示了如何使用与向量数据库相关的功能。有各种运行的模式,取决于所选择的模式,会有一些细微的差异。选项包括:本地模式,无需服务器Qdrant 云请参阅安装说明。 阅读详情

一句话怎样变成一串数字

计算机很容易比较数字,却不能直接理解“如何启动服务”和“服务的启动步骤”表达了相近含义。Embedding 模型解决的正是这个问题:它把文本、图片或音频映射成一组稠密向量,让语义关系能够通过数学距离来比较。

“如何启动服务”
        ↓ Embedding 模型
[0.12, -0.31, 0.08, 0.44, ...]

语义相近的内容在向量空间中通常更靠近,语义无关的内容则更远。RAG 因此可以把用户问题与所有知识片段放到同一个空间中,寻找最近的若干片段。
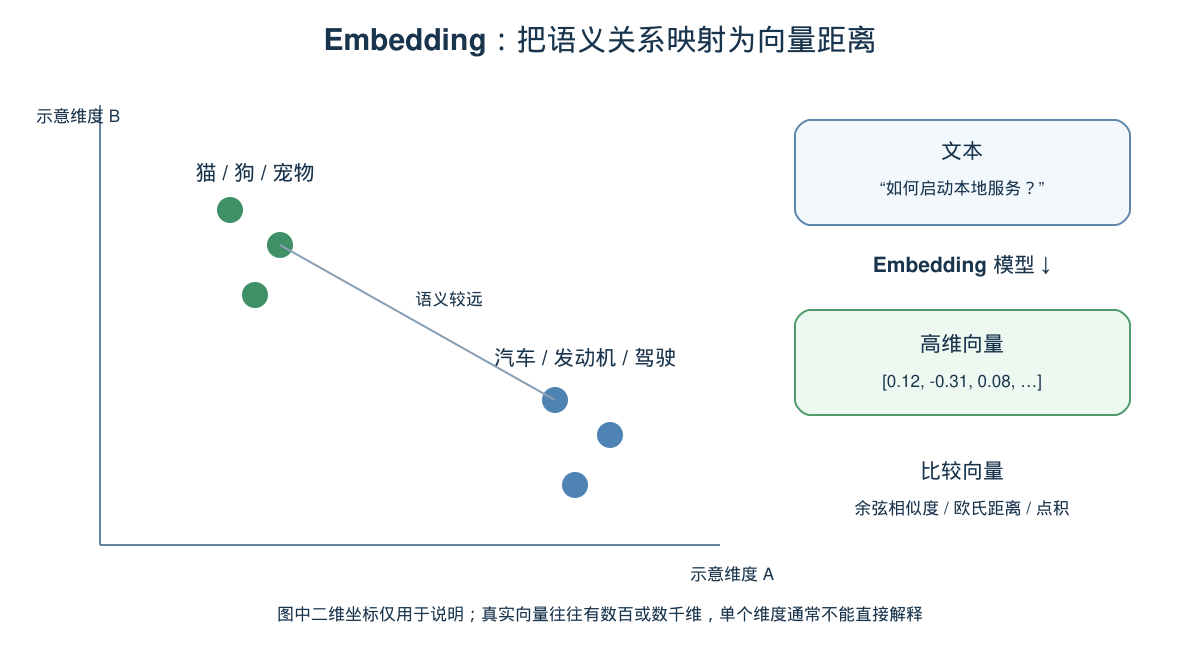
在这里插入图片描述

图中的两个维度只用于直观说明。真实 Embedding 往往有数百或数千维,单个维度通常不能被直接解释成“动物程度”或“技术程度”。模型学习的是大量维度共同构成的关系。

稠密向量与独热编码有什么不同

传统独热编码会为词表中的每个词分配一个位置:

猫 = [1, 0, 0, 0]
狗 = [0, 1, 0, 0]
车 = [0, 0, 1, 0]

在这种表示下,猫与狗和猫与车的距离没有体现语义差别。Embedding 则把信息分散在多个连续数值中,使猫和狗更可能接近,汽车落在另一个区域。这种表示称为稠密向量。

早期的 Word2Vec 主要学习词级关系,现代 Embedding 模型可以直接编码句子、段落甚至文档。有些多模态模型还会把文字与图片对齐到同一个空间,但这必须是模型训练时明确具备的能力,不能假设任意文本模型都能处理图片。

三种常见的相似度计算

余弦相似度

余弦相似度比较两个向量方向是否接近:

cos(a, b) = (a · b) / (||a|| × ||b||)

它对向量长度不敏感,在文本语义检索中非常常见。值越大,通常表示方向越接近。

欧氏距离

欧氏距离计算空间中的直线距离。值越小,两个向量越接近。它同时受到方向和向量长度影响。

点积

点积同时反映方向和模长。若向量已做 L2 归一化,点积与余弦相似度会得到相同的排序;未归一化时,两者不能混为一谈。

下面用 NumPy 直观看三种结果:

import numpy as np

a = np.array([0.2, 0.8, 0.1])
b = np.array([0.3, 0.7, 0.2])

cosine = np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
euclidean = np.linalg.norm(a - b)
dot_product = np.dot(a, b)

print("cosine:", cosine)       # 越大越相似
print("euclidean:", euclidean) # 越小越相似
print("dot:", dot_product)     # 解释取决于模型与归一化方式

选择哪种距离不能只凭习惯。Embedding 模型通常会在文档中说明推荐的相似度与是否需要归一化,向量数据库的索引配置必须与之保持一致。

查询与文档必须使用同一套表示

建立知识库时,文档片段由一个 Embedding 模型生成向量;查询时也必须使用兼容的模型和相同预处理方式。

# 建库
doc_vectors = embed_model.encode(chunks, normalize=True)
vector_db.upsert(chunks, doc_vectors)

# 查询
query_vector = embed_model.encode([question], normalize=True)[0]
hits = vector_db.search(query_vector, top_k=5)

如果建库后更换模型,新旧向量并不处在同一个语义空间,必须重新生成全部文档向量。即使模型名称相同,若升级版本改变了维度或表示方式,也要先验证兼容性。

有些模型区分“查询”和“文档”的输入前缀,例如要求加上 query:、passage:,或使用不同的编码方法。这不是多余格式,而是训练方式的一部分,遗漏后可能明显降低召回效果。

如何选择 Embedding 模型

排行榜可以作为参考,却不能代替业务测试。选型时至少要看以下方面。

语言和领域

中文、跨语言、代码和专业术语对模型的要求不同。一个通用英文模型即使在综合榜单上成绩很好,也未必适合中文企业文档。

输入长度

模型能接收多长文本,会限制 Chunk 上限。超过限制时,有的 SDK 报错,有的会截断;静默截断最危险,因为向量可能根本没有编码后半段答案。

向量维度与成本

更高维度会增加存储、网络传输和索引内存,但不自动意味着检索更准。云端模型还要评估调用价格与数据合规,本地模型则要考虑显存、吞吐和部署维护。

真实检索表现

准备一组“问题—正确片段”对,然后计算 Recall@K、MRR 或 nDCG。至少要与关键词检索基线比较,因为产品编号、错误码和人名等精确词,往往是关键词方法更擅长。

本地调用示例

许多本地模型服务会提供 OpenAI 兼容的 Embedding 接口。假设服务运行在 localhost:1234,可以这样请求:

curl http://localhost:1234/v1/embeddings \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-embedding-model",
    "input": ["技术课程", "怎样构建本地知识库"]
  }'

返回结果通常包含每条输入对应的向量:

{
  "data": [
    {"index": 0, "embedding": [0.012, -0.083, 0.041]},
    {"index": 1, "embedding": [-0.022, 0.017, 0.096]}
  ]
}

示例省略了大部分维度。生产环境还要设置批量大小、超时、重试与缓存,并记录模型名称和版本,保证索引可以重建。

可视化能告诉我们什么

TensorFlow Embedding Projector 可以用 PCA、t-SNE 或 UMAP 等方法把高维向量投影到二维或三维,用于观察聚类和异常点。

但投影会损失信息。二维图上看似靠近的点,在原始高维空间中不一定同样接近。因此,可视化适合发现线索,不适合代替检索指标。

常见误区

第一个误区是把相似度当成事实正确性。向量只能告诉我们两段文字“像不像”,不能证明内容真实或最新。

第二个误区是只使用向量检索。对错误码、订单号、专有名词等查询,关键词检索往往更可靠。把稠密向量与 BM25 等关键词方法结合,再做重排,通常更稳健。

第三个误区是只看模型,不检查数据。若原文解析顺序错误或 Chunk 缺少标题,再强的 Embedding 也无法恢复已经丢失的语义。

小结

Embedding 是 RAG 中连接自然语言与数学检索的桥梁。它把查询和知识片段映射到同一向量空间,再通过余弦、欧氏距离或点积寻找相近内容。

Embedding 与向量数据库 Qdrant(读作:quadrant /'kwɑdrənt/ n. 象限;象限仪;四分之一圆)是一个向量相似度搜索引擎。它提供了一个生产就绪的服务,具有方便的 API 来存储、搜索和管理点 - 带有附加载荷的向量。专门支持扩展过滤功能,使其对各种神经网络或基于语义的匹配、分面搜索和其他应用非常有用。以下展示了如何使用与向量数据库相关的功能。有各种运行的模式,取决于所选择的模式,会有一些细微的差异。选项包括:本地模式,无需服务器Qdrant 云请参阅安装说明。 阅读详情

相关推荐

腾讯WeMM-Embedding:多模态向量嵌入模型实战解析

随着数据形态日益多样,文本、图片、视频、文档等异构数据的语义检索成为企业应用中的基础需求。多模态向量嵌入技术应运而生,它通过统一的向量空间将不同模态映射为可计算的向量表示,实现跨模态的语义匹配与相似度检索。其核心原理基于对比学习,让语义相近的图文、视频与文档在向量空间中对齐,从而支持混合检索。该技术可广泛应用于电商图文互检、企业知识库RAG检索、视频行为语义定位等场景。腾讯开源的WeMM-Embedding正是这样一个覆盖四模态的统一嵌入模型,据实测,基础版本在16G显存的显卡上即可运行,为中小团队提供了低

weixin_34274029的博客 492

Embedding 与向量检索原理:从文本到语义空间的完整技术指南

> 本文是 Datawhale easy-vibe 项目附录《人工智能》章节的技术导读。计算机只认识数字、不认识文字,Embedding(嵌入)正是把"猫和狗很像、和汽车不像"这类人类直觉翻译给机器的核心技术。读完本文,你将理解 Embedding 的本质与三大特性、掌握余弦相似度与欧氏距离等核心度量方法、看懂向量索引如何让百万级数据检索降到毫秒级,并建立起从"文本 → 向量 → 存储 → 查询"

gitblog_00689的博客 981

使用 Postgres Embedding 实现高效向量相似度搜索

使用 HNSW 算法进行精确和近似最近邻搜索L2 距离计算与 PostgreSQL 深度集成,可以利用 PostgreSQL 的强大功能高效的近似最近邻搜索,适用于大规模向量数据支持exact和approximate搜索模式,可以根据需求平衡精度和速度Postgres Embedding 为向量相似度搜索提供了一个强大而灵活的解决方案。通过结合 PostgreSQL 的功能和 HNSW 算法,它能够高效地处理大规模向量数据。

mmlihaio的博客 802

【AI大模型】Embedding模型解析 文本向量知识库的构建和相似度检索

在大模型中,"embedding"指的是将某种类型的输入数据(如文本、图像、声音等)转换成一个稠密的数值向量的过程。这些向量通常包含较多维度,每一个维度代表输入数据的某种抽象特征或属性。Embedding 的目的是将实际的输入转化为一种格式,使得计算机能够更有效地处理和学习在这里插入图片描述文本Embedding在自然语言处理(NLP)中,文本embedding是一个常见的概念。是将文字或短语转换成数值向量的过程。这些向量捕捉了单词的语义特征,例如意义、上下文关系等。

生活需要深度 2578

【软件逆向】带壳带反调试找flag教程(VMProtect3.0+X64dbg+ScyllaHide)

【软件逆向】带壳带反调试找flag教程(VMProtect 3.0+X64dbg+ScyllaHide)

zhangjiuding的博客 7504

UniApp消息推送进阶:不用插件实现动态语音播报(含保活策略)

本文详细介绍了在UniApp中实现动态语音播报的进阶方案,无需依赖第三方插件。核心采用透传消息传递动态数据,结合本地TTS引擎合成语音,并针对不同安卓厂商提供了深度通道配置与差异化保活策略,有效解决了App退至后台或被清理后语音播报失效的难题。

weixin_29224309的博客 486

PyTorch使用embedding对特征向量进行嵌入

词向量嵌入 在NLP中,一个最基本的问题就是如何在计算机中表示一个单词。一般我们用含有N个单词的词汇表来对单词进行编码,例如词表{“hello”: 0, “world”: 1, “nice”:2, “to”:3, “see”:4, “you”:5 }中只有6个单词,那么nice的编码就是2,但是一篇文章有成百上千甚至更多的词汇时,这就需要embedding操作将词向量进行压缩,用更小的维度去表示大量的词汇空间。 根据语言学的单词分布假说,出现在相似语境中的词在语义上是相互关联的。如果仅仅使用一个数字来表示一

theVicTory的博客 7818

SpringBoot项目启动后ShardingSphere5.0首次SQL查询慢?这个预热技巧帮你搞定

本文针对SpringBoot项目集成ShardingSphere 5.0后首次SQL查询慢的问题,深入剖析了其根源在于SQL解析引擎的懒加载与缓存初始化。文章提供了三种有效的预热技巧,包括精准的SQL解析引擎预热、简单查询触发全链路预热以及可配置的生产级方案,帮助开发者将初始化成本提前至应用启动阶段,从而消除性能毛刺,提升用户体验与系统稳定性。

chair的专栏 1062

Easy-Vibe 附录精讲:Embedding 与向量检索原理——从文本到语义空间的完整链路

> 本文是 Datawhale easy-vibe 开源课程「附录 · 人工智能」章节中 [embedding-vector-retrieval.md](https://link.gitcode.com/i/c2875290c9779d89945f3bf69481131b) 的深度扩展版本,同步覆盖 [ar-sa 阿拉伯语版](https://link.gitcode.com/i/329ab300

gitblog_00074的博客 618

Django 前后端分离实战:网络设备运维系统 - 从登录认证到业务模块

这篇文章分享了Django+Vue前后端分离开发网络设备运维系统的实战经验,重点介绍了登录认证、全局布局和设备管理三大模块的实现。文章包含以下核心内容: 登录模块实现:包括表单验证、Token认证、记住密码功能,以及美观的UI设计(渐变背景、毛玻璃效果) 全局布局架构:采用侧边栏+顶部导航的响应式设计,支持菜单权限控制和多设备适配 业务功能开发:详细展示了设备分类和部门管理的CRUD功能实现,包括列表展示、搜索过滤、分页等功能 常见问题解决:提供了5个开发中常见问题的解决方案,如Vue Router警告、C

qq_16766705的博客 525

SAP期初库存导入 (1)

LSMW

IT养家 7188

嵌入层(Embedding Layer)与词向量(Word Embedding)详解

文章目录常见的语言表示模型词向量与Embedding区分Embedding层——keras中的one-hot映射为 向量的层;词向量(word embedding)——一种语言模型表示方法分布式表示(distributed representation)word2vec[More-类似查表操作,区别 W和词向量](https://spaces.ac.cn/archives/4122)More-mo...

少年初心的博客 1万+

Triton server的部署、构建、backend插件机制代码梳理、模型加载、自定义C++backend流程

Triton inference server的部署、构建、backend机制代码详细梳理、模型加载过程、自定义C++backend流程.

C/C++、嵌入式开发、深度学习算法、模型部署与推理优化 471

一文搞懂什么是向量嵌入Embedding?

本文探讨了如何将文字转换为向量进行数学运算,以解决"诸葛亮穿越到《水浒传》会变成谁"的问题。通过词向量模型(word2vec)将词语转换为数字向量后,语义相关程度可量化为向量空间中的距离。文章详细介绍了词向量模型的训练原理(CBOW和Skip-Gram方法),并通过代码演示了如何计算词语间的余弦相似度。实验结果表明,模型能准确识别语义相关的词语分组。最后,通过向量运算"诸葛亮+水浒传-三国演义"得出最可能的结果是晁盖,展示了词向量在跨文本分析中的应用潜力。

m0_59485658的博客 916

大模型实战—通义千问大模型微调

这个参数仅针对 llama 类型的模型结构,默认勾选的是 q_proj 和 v_proj,具体的名词不容易理解,我就不多说了,可以简单的认为是对模型的理解能力进行优化,一般这两个就够了。当这个值较高时,适应新任务的能力会增强,但是对基础模型的影响会比较大,有过拟合的风险,尤其是在数据量有限的情况下。为了方便测试,我在云环境也创建了一个镜像,相关的环境都配置好了,可以直接使用几个国内开源的大语言模型,比如清华智谱的ChatGLM3-6B、零一万物的Yi-34B,还有最近阿里云开源的Qwen1.5-32B。

7万+

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

FreeToken 本地多模态:在消费级 GPU 上跑通 Qwen3-VL 与 Gemma-4 的图像对话

FreeToken 是一个面向桌面场景的 MoE 推理引擎,它把图像理解做成推理引擎的一等能力:Qwen3-VL、Gemma-4、MiniMax-M3 等视觉模型可以直接在本地接收图片并对话,不需要云端 API。本文覆盖从安装启动到图像在引擎内部的完整处理路径,并给出你最可能需要调整的启动参数与常见报错的处理方式。 ## 最短上手路径 先装依赖,`accel` 是带加速后端的可选包: ```

gitblog_00634的博客 741

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Embedding与向量解密:构建高效AI系统的基石

随着 AI 应用的持续火热,许多并不了解 AI 技术的人可能会被众多专业术语搞得一头雾水。相信大家经常会听到「嵌入(embedding)」和「向量(Vector)」这几个词。那么,这些术语到底是什么意思呢?在与我的产品经理交流时,我发现他对这些概念仍然处于似懂非懂的状态。本文将深入探讨这些概念,帮助大家更好地理解它们在 AI 应用中的重要性。Embedding 是一种将高维数据(如文本、图像等)映射到低维空间的技术。具体来说,embedding 是将文本嵌入到向量空间中,用向量来表示文本的含义。

2401_84495872的博客 1135

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Qwen3-Embedding-4B一文详解:4B嵌入模型在中文语义空间的覆盖密度

本文介绍了如何在星图GPU平台上自动化部署Qwen3-Embedding-4B(Semantic Search)镜像,并利用该模型构建智能语义搜索服务。该服务能将文本转化为高维向量,通过计算语义相似度,实现从海量文档中精准检索相关信息,可应用于智能客服、内容推荐等场景,提升信息获取效率。

weixin_36122351的博客 1004

向量嵌入Embedding深度解析:一篇文章彻底理解!

一起来开个脑洞,如果诸葛亮穿越到《水浒传》的世界,他会成为谁?武松、宋江、还是吴用?这看似是一道文学题,但我们可以用数学方法来求解:诸葛亮 + 水浒传 - 三国演义 =?文字本身无法直接运算,但是如果把文字转换成数字向量,就可以进行计算了。而这个过程,叫做“向量嵌入”。因为具有语义意义的数据(如文本或图像),人类可以分辨它们的相关程度,但是无法量化,更不能直接计算。例如,对于一组词“诸葛亮、刘备、关羽、篮球、排球、羽毛球”,我们可能会把“诸葛亮、刘备、关羽”分成一组,“篮球、排球、羽毛球”分成另外一组。

m0_65555479的博客 916

LLM应用中的向量化技术:从Embedding到相似度搜索的完整实现

在当今的大语言模型(LLM)应用中,向量化技术是连接文本与AI理解的核心桥梁。本文将带您探索从文本嵌入(Embedding)到高效相似度搜索的完整实现路径,掌握这项让AI真正"读懂"文本的关键技术。 ## 什么是文本嵌入(Embedding)? 文本嵌入是将人类可读的文本转换为机器可理解的数字向量的过程。这些向量捕捉了文本的语义含义,使计算机能够通过数学方式比较文本之间的相似性。在项目中,我们

gitblog_00367的博客 475

Quaterion进阶教程:用Embedding Confidence让相似度模型输出可信的向量嵌入

在相似度学习中,模型输出的**向量嵌入(Embedding)**是否可信,直接决定了召回、检索和去重的质量。Quaterion 作为专注于相似度学习模型微调的高性能框架,提供了一套优雅的解决方案——**Embedding Confidence(嵌入置信度)**机制。本文带你快速理解这一进阶技巧,学会让模型不仅给出向量,还能告诉你它对每个特征有多"有把握",从而构建更可靠的语义搜索、推荐系统和异常检

gitblog_00439的博客 453
上一篇: RAG 应用链路:查询检索、提示词增强、生成与 Dify 实践
下一篇: 向量数据库入门:记录结构、索引、检索与选型
jinyishu_
博客等级 码龄1年 53粉丝 82原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值