Spark-Streaming基础

Spark Streaming总结 一、本质 Spark Streaming是Spark核心API的一个扩展,可以实现高吞吐量的、具备容错机制的实时流数据的处理 二、Spark Streaming和Spark Core 2.1 逻辑关系: 2.2 物理关系: 1) DStream:Spark Streaming提供了表示连续数据流的、高度抽象的被称为离散流的DStream 2) 任何对DStream的操作都会转变... 阅读详情

SparkStreaming原理

  • 客户端提交作业后启动Driver,Driver是spark作业的Master。
  • 每个作业包含多个Executor,每个Executor以线程的方式运行task,Spark Streaming至少包含一个receiver task。
  • Receiver接收数据后生成Block,并把BlockId汇报给Driver,然后备份到另外一个Executor上。
  • ReceiverTracker维护Reciver汇报的BlockId。
  • Driver定时启动JobGenerator,根据Dstream的关系生成逻辑RDD,然后创建Jobset,交给JobScheduler。
  • JobScheduler负责调度Jobset,交给DAGScheduler,DAGScheduler根据逻辑RDD,生成相应的Stages,每个stage包含一到多个task。
  • TaskScheduler负责把task调度到Executor上,并维护task的运行状态。
  • 当tasks,stages,jobset完成后,单个batch才算完成

SparkStreaming相关的API

典型使用

  • 构建一个Spark StreamingContext
        time_step = 300##单位为秒。
        sc = SparkContext(appName='gdl')
        ssc = StreamingContext(sc, time_step)
               payload = []
        zkQuorum = '10.5.144.164:2181,10.5.144.165:2181,10.5.144.166:2181'
        topic1 = 'GDL'
        gdlStream = KafkaUtils.createStream(ssc,zkQuorum,"falcon1",{topic1:12})
        pos_dict = {}
        lines_gdl_ori = gdlStream.map(lambda x: json.loads(x[1]))
        lines_gdl = lines_gdl_ori.filter(lambda x: (x.get('adept') in airport_list or x.get('adest') in airport_list) and x.get('type') == 'GDL' and x.get('lon') not in['', None] and x.get('lat') not in ['', None])
        lines_adsb_p = lines_adsb.map(lambda x: (x.get('flightno'), find_selected_airport((float(x.get('lon')), float(x.get('lat'))), pos_dict))).filter(lambda x: x[1] is not None).map(lambda x: (x[1], x[0], 1))
        datapoint_count_adsb = lines_adsb_p.map(lambda x: (x[0], 1)).reduceByKey(lambda a, b: a + b)
        flight_count_adsb = lines_adsb_p.map(lambda x: (x[0], x[1])).groupByKey().mapValues(lambda x: list(set(x))).mapValues(lambda x: len(x))
        datapoint_count_adsb.foreachRDD(process_datapoint_to_payload)
        flight_count_adsb.foreachRDD(process_flightcount_to_payload)
        ssc.start()

DStream

DStream是一组连续的RDD序列,这些RDD中的元素的类型是一样的。DStream是一个时间上连续接收数据但是接受到的数据按照指定的时间(batchInterval)间隔切片,每个batchInterval都会构造一个RDD一个batch产生一个RDD,因此,Spark Streaming实质上是根据batchInterval切分出来的RDD串,想象成糖葫芦,每个山楂就是一个batchInterval形成的RDD。
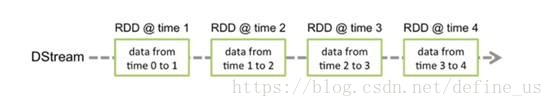
在这里插入图片描述

MAP

源 DStream的每个元素通过函数func返回一个新的DStream。

filter

在源DSTREAM上选择Func函数返回仅为true的元素,最终返回一个新的DSTREAM 。

union

返回一个包含源DStream与其他 DStream的元素合并后的新DSTREAM。

groupByKeyAndWindow

和groupByKey类似,只不过是在一个滑动窗口上完成该操作。

性能参数

在SparkStreaming的监控UI上,我们可以看到下列指标。下面的APP每五分钟处理一个batch,每个batch的处理时间一般52S。是正常的。如果batch的处理时间过高,那么就会导致batch积压,无法正常处理。
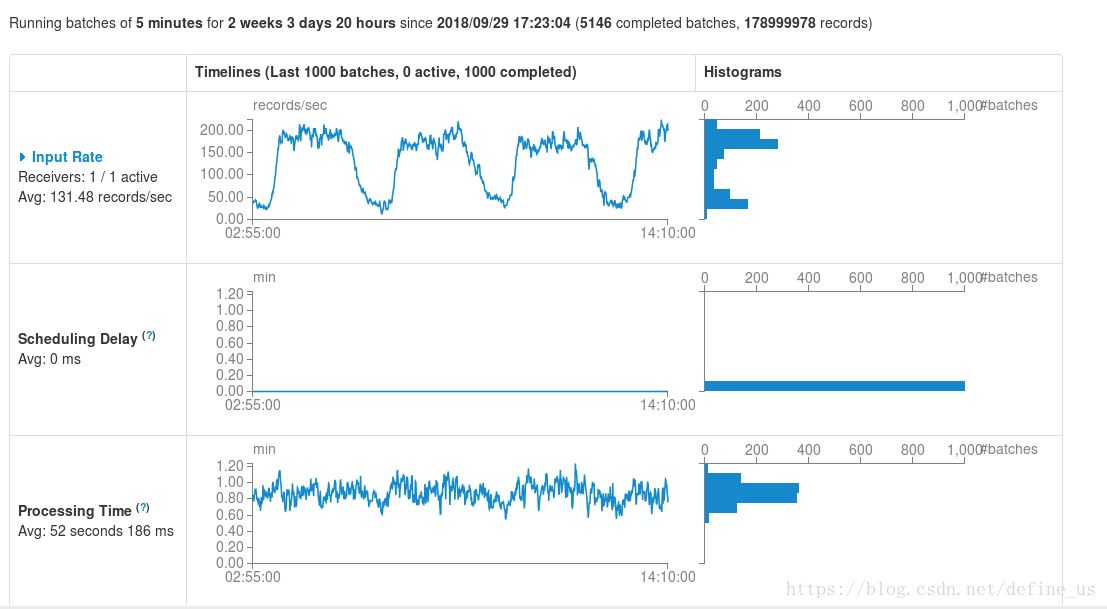
Scheduling Delay :一个batch从入队到出队的延迟。

每个Batch Duration时间去提交一次job,如果job的处理时间超过Batch Duration,会使得job无法按时提交,随着时间推移,越来越多的作业被拖延,最后导致整个Streaming作业被阻塞,无法做到实时处理数据

性能调优

Spark Structed Streaming的一些主要特性及与Spark Streaming之间的对比 Spark Streaming 众所周知,Spark Streaming中的数据结构是Dstream,是对RDD的进一步的封装。 Spark Structed Streaming 对比 阅读详情

相关推荐

基于PySpark整合Spark Streaming与Kafka

本文介绍了基于PySpark整合Spark Streaming和Kafka实现实时消息处理的方案。首先搭建了单机Kafka环境(版本2.11-2.4.0),配置了Zookeeper和Kafka服务,并测试了消息生产消费功能。然后详细说明了Spark Streaming连接Kafka所需的两个关键JAR包,给出了PySpark程序示例,演示了如何通过KafkaUtils.createDirectStream接口实时消费Kafka消息并进行单词计数。程序采用Direct API模式,每5秒统计一次单词频率并输出

pysense的博客 9277

Spark入门实战系列--7.Spark Streaming(上)--实时流计算Spark Streaming原理介绍

1、Spark Streaming简介 1.1 概述 Spark Streaming 是Spark核心API的一个扩展,可以实现高吞吐量的、具备容错机制的实时流数据的处理。支持从多种数据源获取数据,包括Kafk、Flume、Twitter、ZeroMQ、Kinesis 以及TCP sockets,从数据源获取数据之后,可以使用诸如map、reduce、join和window等高级函数进行复杂算

yyy 1404

第16章:Spark Streaming与Structured Streaming

摘要: Spark Streaming采用微批处理模式,通过DStream将实时数据流切分为RDD序列进行处理,支持无状态和有状态转换(如窗口操作),但存在处理时间语义单一、API不统一等局限。Structured Streaming基于Spark SQL引擎,将流数据视为无限表,提供统一的DataFrame API、事件时间处理(支持Watermarking解决乱序问题)及端到端精确一次语义,支持多种输出模式(Append/Complete/Update)。示例展示了从Kafka读取JSON数据,通过Wa

1372

DStream相关操作

DStream相关操作DStream上的操作与RDD的类似,分为Transformations(转换)和Output Operations(输出)两种,此外转换操作中还有一些比较特殊的操作,如:updateStateByKey()、transform()以及各种Window相关的操作。1、Transformations Transformation 含义 map(func) 对DStr

Running_Tiger的博客 5714

Spark Streaming简介

Spark Streaming 是 Spark 核心 API 的一个扩展,可以实现高吞吐量的、具备容错机制的实时流数据的处理。 Spark Streaming 支持从多种数据源获取数据,包括 Kafka、Flume、Twitter、ZeroMQ、Kinesis 以及 TCP Sockets。从数据源获取数据之后,可以使用诸如 map、reduce、join 和 window 等高级函数进行复杂算...

大数据基础学习 2934

Spark核心之Spark Streaming

前面说到Spark的核心技术的时候,有和大家说过,有五大核心技术,不知道大家还记不记得; 给大家回忆下,这五大核心技术:分布式计算引擎Spark Core 、基于Hadoop的SQL解决方案SparkSQL 、可以实现高吞吐量、具备容错机制的准实时流处理系统Spark Streaming、分布式图处理框架Spark GraphX和构建在Spark上的分布式机器学习库Spark MLlib,现在应该有个印象了吧,其它的我就不多说了,今天主要是对Spark Streaming做个简单介绍,以便理解。 Sp

zp17834994071的博客 1887

代码世界中的Lambda

Lambda表达式基于数学中的λ演算得名,可以看作是匿名函数,可以代替表达式,函数,闭包等,也支持类型推论,可以远离匿名内部类。Lambda的目的是让程序员能够对程序行为进行抽象,把代码行为看作数据。Java、Python和大数据云计算中的Lambda分别是什么样的?

我相信...... 4450

Spark Streaming开发基础

大数据实验教学系统Spark Streaming开发基础Spark Core它的核心就是RDD,对于Spark Streaming来说,它的核心是DStream,DStream类似于RDD,它实质上一系列的RDD的集合,DStream可以按照秒数将数据流进行批量的划分。首先从接收到流数据之后,将其划分为多个batch,然后提交给Spark集群进行计算,最后将结果批量输出到HDFS或者数据库以及前端页面展示等等。图2 Spark Streaming原理   Spark Streaming有以下特点:   1、

需要远程指导仿真实验、代码有问题的,请后台私信或者关注公众号 862

Structured Streaming 和 Spark streaming的区别

我先简单的说一下Spark streaming,然后在想对比的说一下Structured Streaming Spark streaming的概述 Spark Streaming是一个基于Spark Core之上的实时计算框架,可以从很多数据源消费数据并对数据进行实时的处理 Spark Streaming类似于Apache Storm,用于流式数据的处理。 根据其官方文档介绍...

MannerXu的博客 5998

K8S证书过期解决办法之替换证书

k8s证书过期解决方案之替换证书

q_hsolucky的博客 1万+

systermverilog中for循环中的fork join执行情况分析

仅为本人学习记录,如有错误感谢指正!

qq_63807221的博客 1461

【Spark Streaming】Spark Streaming的使用

一、Spark Streaming引入 集群监控 一般的大型集群和平台, 都需要对其进行监控的需求。 要针对各种数据库, 包括 MySQL, HBase 等进行监控 要针对应用进行监控, 例如 Tomcat, Nginx, Node.js 等 要针对硬件的一些指标进行监控, 例如 CPU, 内存, 磁盘 等 Spark Streaming介绍 官网:http://spark.apac...

依旧的博客 5216

深入了解torch框架

大国的游戏,政府支持到位,是未来;AI : Artificial Intelligence,旨在研究、开发能够模拟、延伸和扩展人类智能的理论、方法、技术及应用系统,是一种拥有自主学习和推理能力的技术。它模仿人类大脑某些功能,包括感知、学习、理解、决策和问题解决。AI本质​ NLP(说话,听)、CV(眼睛)、自动驾驶、机器人(肢体动作)、大模型三要素:数据、网络、算力① 神经网络:找到合适的数学公式;② 训练:用已有数据训练网络,目标是求最优解;③ 推理:用模型预测新样本;PyTorch,简称Torch

qq_74732076的博客 1135

Spark 以及 spark streaming 核心原理及实践

Spark引进了弹性分布式数据集RDD (Resilient Distributed Dataset) 的抽象,它是分布在一组节点中的只读对象集合,这些集合是弹性的,如果数据集一部分丢失,则可以根据“血统”(即充许基于数据衍生过程)对它们进行重建。已经成为广告、报表以及推荐系统等大数据计算场景中首选系统,因效率高,易用以及通用性越来越得到大家的青睐,我自己最近半年在接触spark以及spark streaming之后,对spark技术的使用有一些自己的经验积累以及心得体会,在此分享给大家。

2301_82041400的博客 2065

华为OD机试 - 最快到达医院的方法(Python/JS/C/C++ 2024 E卷 100分)

刷的越多,抽中的概率越大,私信哪吒,备注华为OD,加入华为OD刷题交流群,每一题都有详细的答题思路、详细的代码注释、发现新题目,随时更新,全天优快云在线答疑。

学Java,找哪吒 2169

[系统安全] 三十二.恶意代码检测(2)常用技术详解及总结

前文从产业界和学术界分别详细讲解恶意代码攻击溯源的相关知识,在学术界方面,用类似于综述来介绍攻击追踪溯源的不同方法;在产业界方面,主要参考李东宏老师从企业恶意样本分析的角度介绍溯源工作。这篇文章将详细总结恶意代码检测技术,包括恶意代码检测的对象和策略、特征值检测技术、校验和检测技术、启发式扫描技术、虚拟机检测技术和主动防御技术。希望这篇文章对您有所帮助,如果文章中存在错误、理解不到位或侵权的地方,还请告知作者与海涵。且看且珍惜,加油~

杨秀璋的专栏 1万+

Spark入门(五)——Spark Streaming

Spark Streaming学习 Spark流计算

17611119847 2万+

QCC304x系列开发教程(实战篇)之5.2 QCC3040之提示音

earbud_init.c中,初始化table中UiPrompts_Init /*! \brief Table of initialisation functions */ static const init_table_entry_t appInitTable[] = { ......... {UiPrompts_Init, 0, NULL}, ......... } ui_prompts.c中是提示音音处理的主要逻辑和配置源文件 函数static void uiPro...

心跳包的博客 2392

Structured Streaming && Spark Streaming

第一件事儿先贴官方文档,由此可见,英文的重要性啊,哈哈... structured streaming :http://spark.apache.org/docs/latest/structured-streaming-programming-guide.html spark Streaming :http://spark.apache.org/docs/latest/streamin...

阿尼古 1421

【OpenClaw企业级智能体实战】第11篇:制造业设备预测性维护实战——OpenClaw+DeepSeek+Prometheus从零搭建(附完整代码)

本文聚焦制造业设备预测性维护的核心痛点,基于OpenClaw v2026.2.1、DeepSeek智能诊断、Prometheus监控等工具,拆解“设备状态监控→智能故障诊断→预测性维护”三大核心场景。从技术原理、算法构建、实操流程到完整代码实现,提供“数据采集→模型训练→智能调度→自动处置”的全链路方案。方案遵循工业安全规范,采用“只读优先、权限最小化”原则,适配中小制造企业落地需求。通过虚拟案例验证,可使设备非计划停机时间下降65%、平均修复时间缩短47%,既适合新手快速入门,也为进阶读者提供架构优化思路

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 606

uniapp(全端兼容) - 最新详细实现瀑布流列表及布局设计,uni-app全平台兼容的瀑布流示例,view容器自适应瀑布流布局,图片瀑布流布局、图像+文字卡片式瀑布流,类似小红书(详细示例代码)

uni-app,瀑布流,安卓app,苹果app,微信小程序,移动端,H5网页,手机网站,微信小程序、支付宝小程序,手机app端,nvue,瀑布流布局,如何实现图片瀑布流,怎么做文字+图像瀑布流,uniapp仿小红书笔记瀑布流效果,uniAPP仿快手抖音布局列表,瀑布流列表详细教程,编译所有平台都能用的瀑布流列表,商品瀑布流列表,图文列表,小程序瀑布流,页面触底懒加载,瀑布流插件,详细示例代码教程,uni-app H5实现瀑布流效果,uniapp小程序做瀑布流,纯css瀑布流,用uniapp写瀑布流商品列表,

✅ 精选推荐文章 1万+

Spark Streaming基础概论

Spark Streaming 是 Apache Spark 的一个扩展模块,专门用于处理实时数据流。它通过将数据流切分为一系列小批次(微批次)进行处理,使得开发者能够使用与批处理相同的 API 来处理流数据。这种微批处理的架构允许 Spark Streaming 高效地处理实时数据,并且提供了高容错性和可扩展性。

hello.reader 1528

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Spark Streaming

目录1 简介2 实例3 架构与抽象4 转化操作5 输出操作6 输入源7 24/7不间断运行 1 简介 许多应用需要即时处理收到的数据,例如用来实时追踪页面访问统计的应用、训练机器学习模型的应用,还有自动检测异常的应用。Spark Streaming 是Spark为这些应用而设计的模型。Spark Streaming使用离散化流作为抽象表示,叫做DStream。DStream可以从各种输入源创建,比如Flume、Kafka或者HDFS。创建出来的DStream支持两种操作,一种是转化操作(transforma

BGoodHabit的博客 1771

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Spark Streaming的操作实践

实验内容与要求: 1. Spark Streaming基本知识总结 2. Spark Streaming的操作实践: 2.1 SparkStreaming的workCount案例 2.2 Spark Streaming与Flume和Kafka 的整合实践 1. Spark Streaming基本知识的总结 Spark Streaming 是Spark软件栈中一个用于流计算的组件,它将数据流沿时间轴分片,再交给Spark对分片的数据进行批处理,所以SparkStreaming并没有真正地实现流计算,但也能满

YTLDSS的博客 5756

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

[Spark、hadoop]spark Streaming的核心DStream

1.SparkStreaming提供了一个高级抽象的流,即DStream(离散流)。 2.DStream的内部结构是由一系列连续的RDD组成,每个RDD都是一小段由时间分隔开来的数据集。

m0_57781407的博客 2491

Spark Streaming与Structured Streaming区别解析

特性维度编程接口低级 API:DStream(离散化流,Discretized Stream)高级 API:DataFrame / Dataset处理模型微批次(Micro-Batch)1. 微批次(默认)2. 连续处理(实验性)API 类型过程式(如何做)声明式(做什么)时间语义处理时间为主,事件时间支持较弱原生支持事件时间(Event Time)、处理时间、注入时间容错机制基于 WAL(Write-Ahead Log)和 RDD 血统(Lineage)

ITHomeZSL的博客 862
上一篇: 数据库中事务基本原理和概念(单机)
下一篇: YARN
define_us
博客等级 码龄14年 157粉丝 531原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值