机器学习中的数学(1)-回归(regression)、梯度下降(gradient descent)

数学建模常用模型——回归 今天我们来介绍一下回归。回归在百度百科里面的定义是:回归是一种数学模型,研究一组随机变量(Y1 ,Y2 ,…,Yi)和另一组(X1,X2,…,Xk)变量之间关系的统计分析方法,又称多重回归分析。通常Y1,Y2,…,Yi是因变量,X1、X2,…,Xk是自变量。回归主要的种类有:线性回归、曲线回归、logistic回归等等。下面我们简单叙述一下这几种回归。 线性回归/曲线回归 一元: 对于一元线性回归而言,本质都是依据最小二乘法原理,拟合得到函数y=ax+b的参数a和b,使其值与实际 阅读详情

版权声明:

   本文由LeftNotEasy所有,发布于http://leftnoteasy.cnblogs.com。如果转载,请注明出处,在未经作者同意下将本文用于商业用途,将追究其法律责任。

前言:

   上次写过一篇关于贝叶斯概率论的数学,最近时间比较紧,coding的任务比较重,不过还是抽空看了一些机器学习的书和视频,其中很推荐两个:一个是stanford的machine learning公开课,在verycd可下载,可惜没有翻译。不过还是可以看。另外一个是prml-pattern recognition and machine learning, Bishop的一部反响不错的书,而且是2008年的,算是比较新的一本书了。

   前几天还准备写一个分布式计算的系列,只写了个开头,又换到写这个系列了。以后看哪边的心得更多,就写哪一个系列吧。最近干的事情比较杂,有跟机器学习相关的,有跟数学相关的,也有跟分布式相关的。

   这个系列主要想能够用数学去描述机器学习,想要学好机器学习,首先得去理解其中的数学意义,不一定要到能够轻松自如的推导中间的公式,不过至少得认识这些式子吧,不然看一些相关的论文可就看不懂了,这个系列主要将会着重于去机器学习的数学描述这个部分,将会覆盖但不一定局限于回归、聚类、分类等算法。

回归与梯度下降:

   回归在数学上来说是给定一个点集,能够用一条曲线去拟合之,如果这个曲线是一条直线,那就被称为线性回归,如果曲线是一条二次曲线,就被称为二次回归,回归还有很多的变种,如locally weighted回归,logistic回归,等等,这个将在后面去讲。

   用一个很简单的例子来说明回归,这个例子来自很多的地方,也在很多的open source的软件中看到,比如说weka。大概就是,做一个房屋价值的评估系统,一个房屋的价值来自很多地方,比如说面积、房间的数量(几室几厅)、地段、朝向等等,这些影响房屋价值的变量被称为特征(feature),feature在机器学习中是一个很重要的概念,有很多的论文专门探讨这个东西。在此处,为了简单,假设我们的房屋就是一个变量影响的,就是房屋的面积。

   假设有一个房屋销售的数据如下:

   面积(m^2)  销售价钱(万元)

   123            250

   150            320

   87              160

   102            220

   …               …

   这个表类似于帝都5环左右的房屋价钱,我们可以做出一个图,x轴是房屋的面积。y轴是房屋的售价,如下:

   image

   如果来了一个新的面积,假设在销售价钱的记录中没有的,我们怎么办呢?

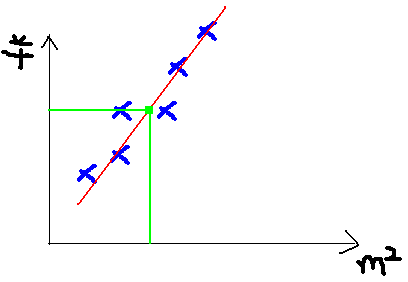
   我们可以用一条曲线去尽量准的拟合这些数据,然后如果有新的输入过来,我们可以在将曲线上这个点对应的值返回。如果用一条直线去拟合,可能是下面的样子:
    image

   绿色的点就是我们想要预测的点。

   首先给出一些概念和常用的符号,在不同的机器学习书籍中可能有一定的差别。

   房屋销售记录表 - 训练集(training set)或者训练数据(training data), 是我们流程中的输入数据,一般称为x

   房屋销售价钱 - 输出数据,一般称为y

   拟合的函数(或者称为假设或者模型),一般写做 y = h(x)

   训练数据的条目数(#training set), 一条训练数据是由一对输入数据和输出数据组成的

   输入数据的维度(特征的个数,#features),n

   下面是一个典型的机器学习的过程,首先给出一个输入数据,我们的算法会通过一系列的过程得到一个估计的函数,这个函数有能力对没有见过的新数据给出一个新的估计,也被称为构建一个模型。就如同上面的线性回归函数。


   image

    我们用X1,X2..Xn 去描述feature里面的分量,比如x1=房间的面积,x2=房间的朝向,等等,我们可以做出一个估计函数:

image

    θ在这儿称为参数,在这儿的意思是调整feature中每个分量的影响力,就是到底是房屋的面积更重要还是房屋的地段更重要。为了如果我们令X0 = 1,就可以用向量的方式来表示了:

image

    我们程序也需要一个机制去评估我们θ是否比较好,所以说需要对我们做出的h函数进行评估,一般这个函数称为损失函数(loss function)或者错误函数(error function),描述h函数不好的程度,在下面,我们称这个函数为J函数

    在这儿我们可以做出下面的一个错误函数:

image 

    这个错误估计函数是去对x(i)的估计值与真实值y(i)差的平方和作为错误估计函数,前面乘上的1/2是为了在求导的时候,这个系数就不见了。

    如何调整θ以使得J(θ)取得最小值有很多方法,其中有最小二乘法(min square),是一种完全是数学描述的方法,在stanford机器学习开放课最后的部分会推导最小二乘法的公式的来源,这个来很多的机器学习和数学书上都可以找到,这里就不提最小二乘法,而谈谈梯度下降法。

    梯度下降法是按下面的流程进行的:

    1)首先对θ赋值,这个值可以是随机的,也可以让θ是一个全零的向量。

    2)改变θ的值,使得J(θ)按梯度下降的方向进行减少。

    为了更清楚,给出下面的图:

image    这是一个表示参数θ与误差函数J(θ)的关系图,红色的部分是表示J(θ)有着比较高的取值,我们需要的是,能够让J(θ)的值尽量的低。也就是深蓝色的部分。θ0,θ1表示θ向量的两个维度。

    在上面提到梯度下降法的第一步是给θ给一个初值,假设随机给的初值是在图上的十字点。

    然后我们将θ按照梯度下降的方向进行调整,就会使得J(θ)往更低的方向进行变化,如图所示,算法的结束将是在θ下降到无法继续下降为止。

image     当然,可能梯度下降的最终点并非是全局最小点,可能是一个局部最小点,可能是下面的情况:

image

   上面这张图就是描述的一个局部最小点,这是我们重新选择了一个初始点得到的,看来我们这个算法将会在很大的程度上被初始点的选择影响而陷入局部最小点  

   下面我将用一个例子描述一下梯度减少的过程,对于我们的函数J(θ)求偏导J:(求导的过程如果不明白,可以温习一下微积分)

   image

    下面是更新的过程,也就是θi会向着梯度最小的方向进行减少。θi表示更新之前的值,-后面的部分表示按梯度方向减少的量,α表示步长,也就是每次按照梯度减少的方向变化多少。

image     一个很重要的地方值得注意的是,梯度是有方向的,对于一个向量θ,每一维分量θi都可以求出一个梯度的方向,我们就可以找到一个整体的方向,在变化的时候,我们就朝着下降最多的方向进行变化就可以达到一个最小点,不管它是局部的还是全局的。

    用更简单的数学语言进行描述步骤2)是这样的:

   image    倒三角形表示梯度,按这种方式来表示,θi就不见了,看看用好向量和矩阵,真的会大大的简化数学的描述啊。

总结与预告:

    本文中的内容主要取自stanford的课程第二集,希望我把意思表达清楚了:)本系列的下一篇文章也将会取自stanford课程的第三集,下一次将会深入的讲讲回归、logistic回归、和Newton法,不过本系列并不希望做成stanford课程的笔记版,再往后面就不一定完全与stanford课程保持一致了。


李宏毅机器学习笔记(3)—Gradient Descent Gradient Descent 的技巧 下图是对偏微分的书写形式的补充说明,可以用倒三角来表示偏微分组成的向量,也就是梯度。所以下图左侧的式子可以写成下图右侧的式子。这种使用某一字符代表向量的写法可以大大简化书写,倒三角表示偏微分向量也能够简化书写。 Tip 1: Tuning your learning rates 第一个技巧也就是改变 learning rates 的速率。可以预见的是过小... 阅读详情

相关推荐

机器学习发展历史及现状(重要的期刊,会议,大牛总结)

1 引言 机器学习是指通过计算机学习数据中的内在规律性信息,获得新的经验和知识,以提高计算机的智能性,使计算机能够像人那样去决策。随着各行业对数据的需求量增多,对处理和分析数据的效率要求变高,一系列机器学习算法应运而生。机器学习算法主要是指通过数学及统计方法求解最优化问题的步骤和过程。针对不同的数据和不同模型需求,选择和使用适当的的机器学习算法可以更高效地解决一些实际问题。本文将从机器学习的起源...

Oscar2018的博客 5万+

【机器学习】详解回归(Regression)

回归问题

高朗的博客 2221

3D Slicer:从入门到精通(二)——入门指南

本篇文章包含开始使用3D Slicer所需的信息,包括如何安装和快速开始使用基本功能,以及在哪里找到更多信息。

walt3433的博客 2万+

word2vec源码解析之word2phrase.c

最近研究了一下google的开源项目word2vector,http://code.google.com/p/word2vec/。 其实这玩意算是神经网络在文本挖掘的一项成功应用。 word2vec.c是核心代码,不过感觉先读word2phrase.c代码,再读前者比较好。 一来word2phrase.c算法简单点,容易理解, 二来word2phrase.c里面有些函数在word2vec.c会用到,读完word2phrase.c有助于读word2vec.c。

linger(心怀梦想,活在当下,知乎ID:linger liu) 1万+

保姆级避坑指南:在Ubuntu 18.04上搞定速腾Helios雷达驱动与fast-LIO2的完整配置流程

本文提供了一份详细的速腾Helios雷达与fast-LIO2在Ubuntu 18.04上的配置避坑指南,涵盖驱动安装、数据格式转换到建图全流程。特别针对常见编译错误和数据转换问题提供了解决方案,帮助开发者高效完成环境搭建与建图任务。

weixin_27252001的博客 113

【AutoSAR】【BootLoader】AutoSAR Bootloader 原理与流程

目录 一、HIS规范 二、BOOTLOADER软件架构 三、烧写流程 一、HIS规范 国外整车厂意识到在线刷新ECU的重要性,由奥迪公司、宝马公司、戴姆勒公司、保时捷公司、大众公司成立一个委员会,名为HIS委员会,专门负责帮助汽车制造商掌握微处理器控制单元软件和质量保证领域的原理和方法; HIS Bootloader的主要功能是通过标准的通信接口对ECU进行再编程 。 HIS Bootloader的软件设计基于AUTOSAR体系架构、ISO14229、ISO15765-2、HI...

专注汽车软件开发、AutoSAR、车载以太网、SOA、EE架构。 5248

【转载】机器学习中的数学(1)-回归(regression)、梯度下降(gradient descent)

1、在网上看到了这篇文章:《随机梯度下降法》 作者:大愚若智_ **地址:**https://blog.youkuaiyun.com/zbc1090549839/article/details/38149561 2、我对于他文章里面的图片,来源感兴趣,然后看到了这个: 标题:《梯度下降法》 转载者:淡定云天 地址: https://blog.youkuaiyun.com/woxincd/article/details/7...

weixin_42362903的博客 290

.net core 下的PostgreSQL 异常排查—— Exception while reading from stream (0x80004005)

最近以PostgreSQL为存储介质,实现了分布式缓存的一个组件开发,在经过开发环境的测试后,顺利推送到产品组的手里,经过开发环境的验证后,终于发布到测试环境了,但问题来了,产品组反应频繁出现访问异常,返回的信息大致是:Exception while reading from stream … (0x80004005) ????欢迎点赞 :???? 收藏 ⭐留言 ???? 如有错误敬请指正,赐人玫瑰,手留余香! ????本文作者:由webmote 原创,首发于 【优快云】 ????作者格言: 生活在

网尘的技术专栏 5842
上一篇: OpenCV在Android平台上的应用
下一篇: 机器学习中的数学(2)-线性回归,偏差、方差权衡
xdyang
博客等级 码龄17年 1913粉丝 21原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值