AWS高级解决方案架构师黄海波:GenAI 时代非结构化数据处理的实践与趋势洞察

在接到这个分享主题之前,我一直在思考 GenAI 时代非结构化数据处理这个课题。就个人经历而言,我并未选择学术道路,而是更多专注于软件工程领域的应用实践。由于我所在的团队聚焦于 AWS 生态,我们的工作也更多围绕生态层面展开。

我今天分享的内容核心会聚焦在数据处理的应用落地实践上。首先,我会聊聊非结构化数据这一话题,以及其处理过程中的技术理念;接着分享两个我在工作中与客户共同完成的实践案例;最后,谈谈非结构化数据的未来趋势及我个人的一些思考。
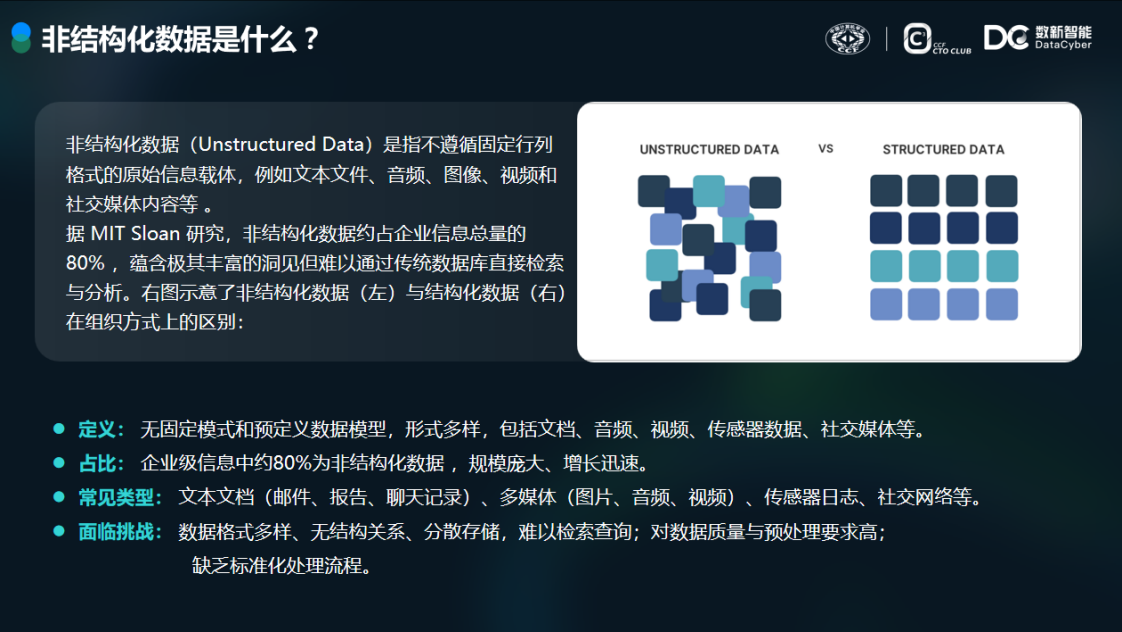
根据 MIT Sloan的研究,在企业的全部数据资产中,非结构化数据占比约 80%,部分企业甚至更高。这类数据在企业数据资产中占比极高,若能有效盘活企业内部的非结构化数据,对企业的信息化进程与数字化转型而言,都具有重要意义。非结构化数据有诸多特点。如前面提到的,多模态数据中大部分都属于非结构化数据,涵盖文件、音频、图像等多种形式。那么,这些数据的核心特征是什么?我们又该如何借助大模型对其实现高效生成,乃至最终的有效执行?

在企业场景中,非结构化数据既没有固定格式,也缺乏配套的数据模型。这使得非结构化数据的处理工作极为复杂,检索与查询也面临很大挑战。

在利用非结构化数据时,我们会遇到不少挑战,主要集中在这几个方面:数据格式多样、没有明确的结构关系、存储分散,检索查询困难。

比如常见的非结构化数据,像图像、Word 文档、PDF 文件这些,它们自身的结构关系并不清晰。这和我们设计系统时处理结构化数据的情况完全不同 ,做结构化数据时,我们会先做数据建模,梳理出核心的实体,再给这些实体设定相应的属性。这个梳理和定义的过程,其实就是把非结构化数据转化为结构化数据的关键步骤。结构化数据最终会存入数据库进行操作,整个处理流程也有很多成熟的标准。

举个例子,在数据库领域,结构化数据有明确的应用场景和成熟的检索方法来提高效率;但非结构化数据在这方面,不管是处理标准还是检索逻辑,都还没有清晰的定义。

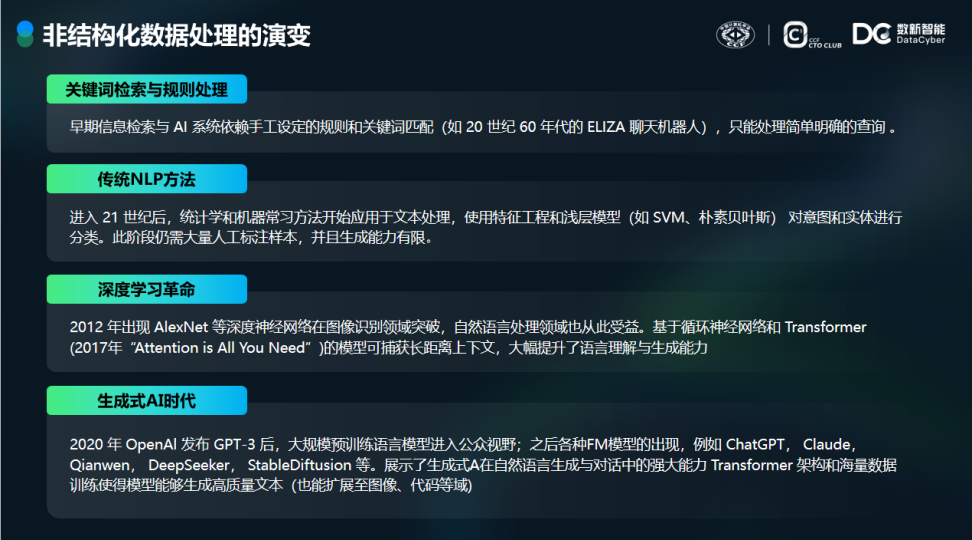
结合我自己的经验,非结构化数据的处理其实有个发展过程。

早期做非结构化数据处理时,大多靠关键词搜索或者规则匹配。我以前做研发,现在更偏向应用场景,比如大家日常检索数据,其实就是非结构化数据向结构化数据转化的一种体现。那时候的检索处理很直接:一个需求就得编一套规则,而且只能应对简单明确的查询。

后来机器学习发展起来,我们开始琢磨:能不能用模型来处理文本?比如要对文本做简单分类,是不是可以用样本数据训练模型?这样一来,就算是领域外的其他数据,也能做类似处理,不用再写那么多规则。

机器学习再继续发展,就出现了一些更前沿的模型。比如处理图片时,我们先标注图片内容来训练模型,之后模型就能自己识别图片里的内容并做标注了。

到了生成式 AI 阶段,大规模预训练模型开始进入大众视野,之后各种基础模型(FM)也陆续出现。其实这些模型在架构上差异不大,但参数量和训练数据的体量却在急剧增长,最终形成了语言、图像等不同类别的大模型。而这两年多模态大模型兴起后,不同模态的模型开始呈现融合趋势,这一点我在后面的案例讲解中也会具体提到。
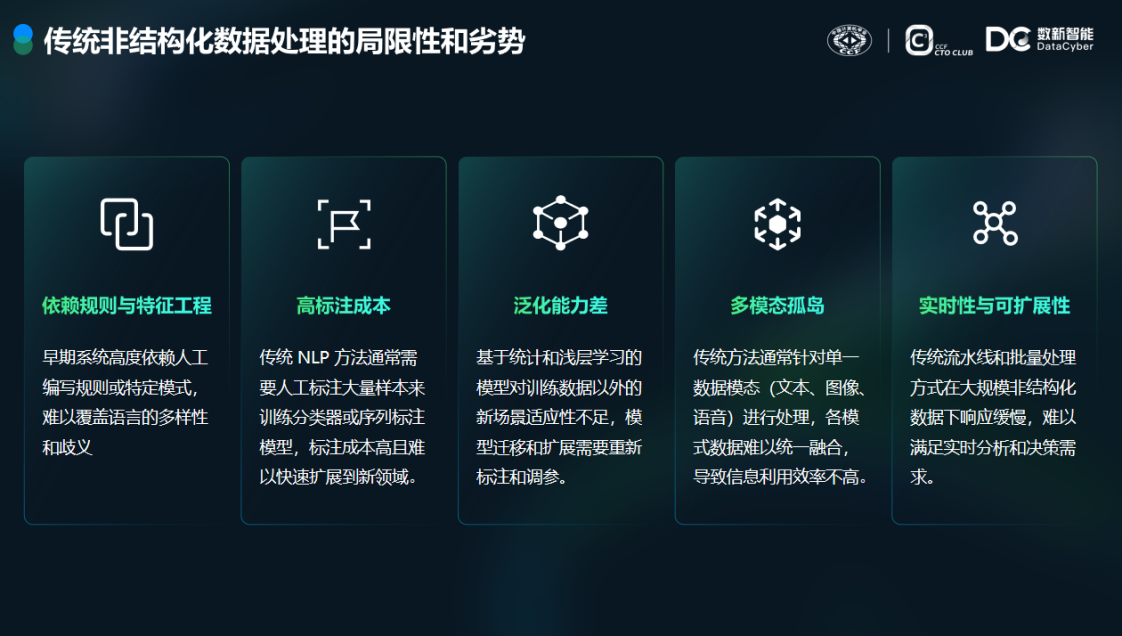
传统非结构化数据处理存在不少局限性,具体可以从这几个方面来看:

一是过度依赖定制化规则与特征实现。要获取数据时,不同类型的数据需要用不同的规则来处理,这些规则往往不统一,还需要额外协调适配,难以覆盖语言的多样性,灵活性很低。

二是标注成本居高不下。传统 NLP 方法通常需要人工标注大量样本,用来训练分类器或序列标注模型,不仅耗费大量人力物力,标注过程本身也很繁琐,成本高。

三是泛化能力弱。在某个场景下完成数据标注和模型训练后,一旦场景发生变化(比如数据分布、业务需求调整),模型就难以适配,往往需要重新标注数据、调整模型,复用性很差。

四是多模态数据形成 “孤岛”。早期处理视频、音频、文字等多模态数据时,核心难题是如何让它们之间实现融合 , 这些数据往往各自独立,缺乏有效的联动机制。不过这两年,多模态融合的趋势已经逐渐显现,而且越来越明显了。

五是实时性与可扩展性不足。传统的流水线式和批量处理方式,在面对大规模非结构化数据时响应很慢,很难满足实时分析和快速决策的需求,扩展性也跟不上业务增长。
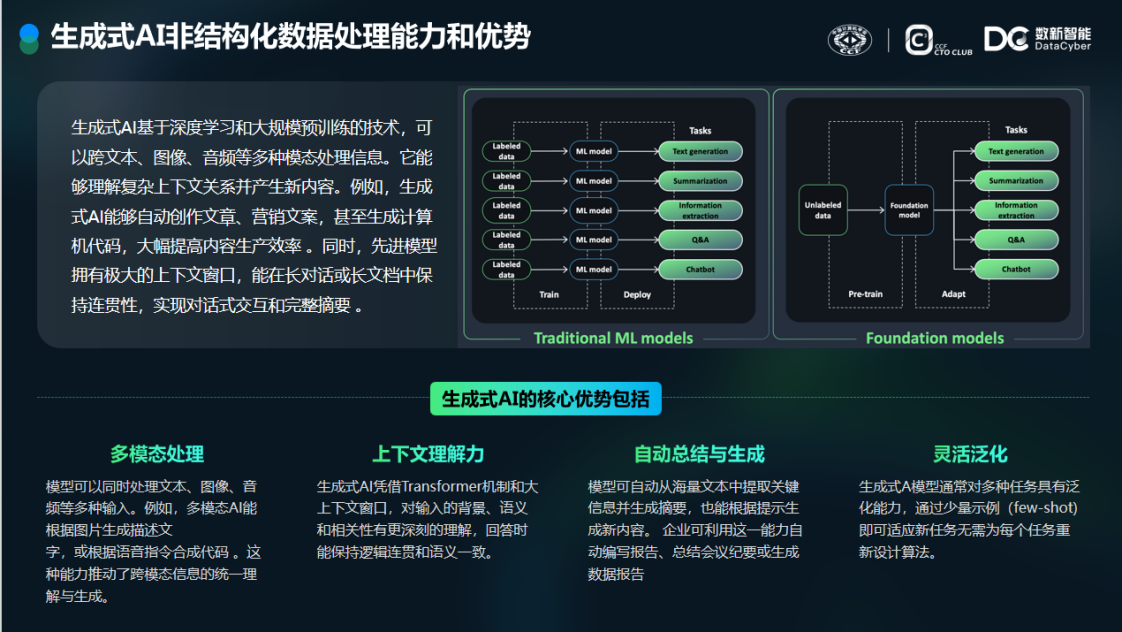
接下来我们聊聊,生成式 AI 能为非结构化数据处理带来哪些改变。这里有两张图,展示的是传统机器学习模型与主流预训练模型的差异。

就像我刚才提到的,传统机器学习模型在处理非结构化数据的分析时,其实还处于比较早期的阶段。我把时间主要放在案例实际应用中上,这样大家会有直观的认识。我简单列了一下我想到的场景,实际的应用场景远不止这些。
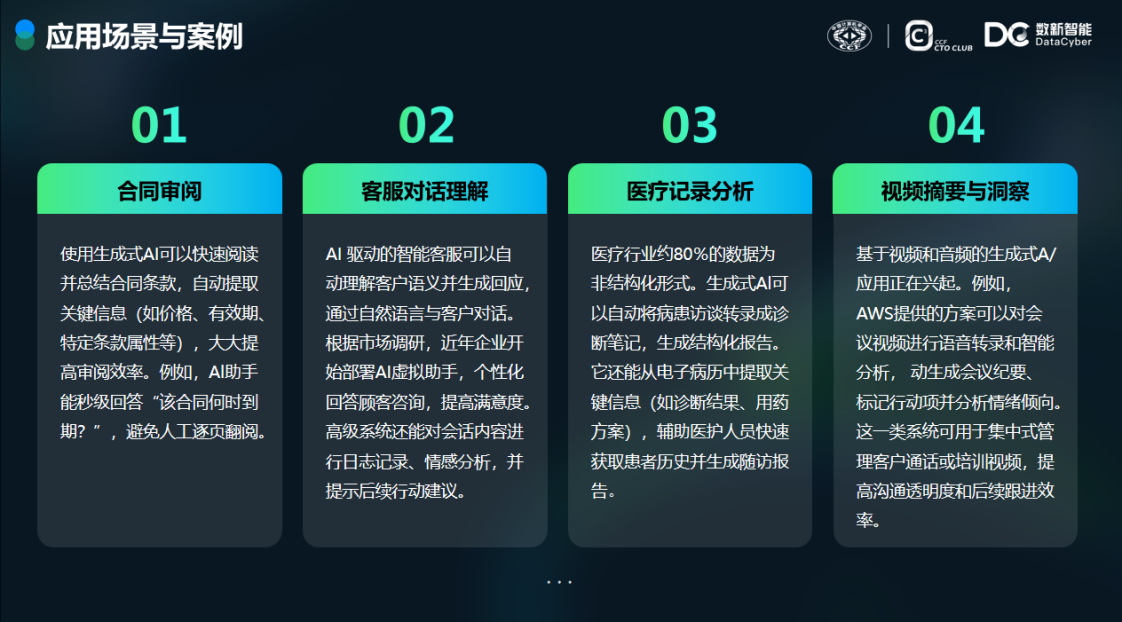
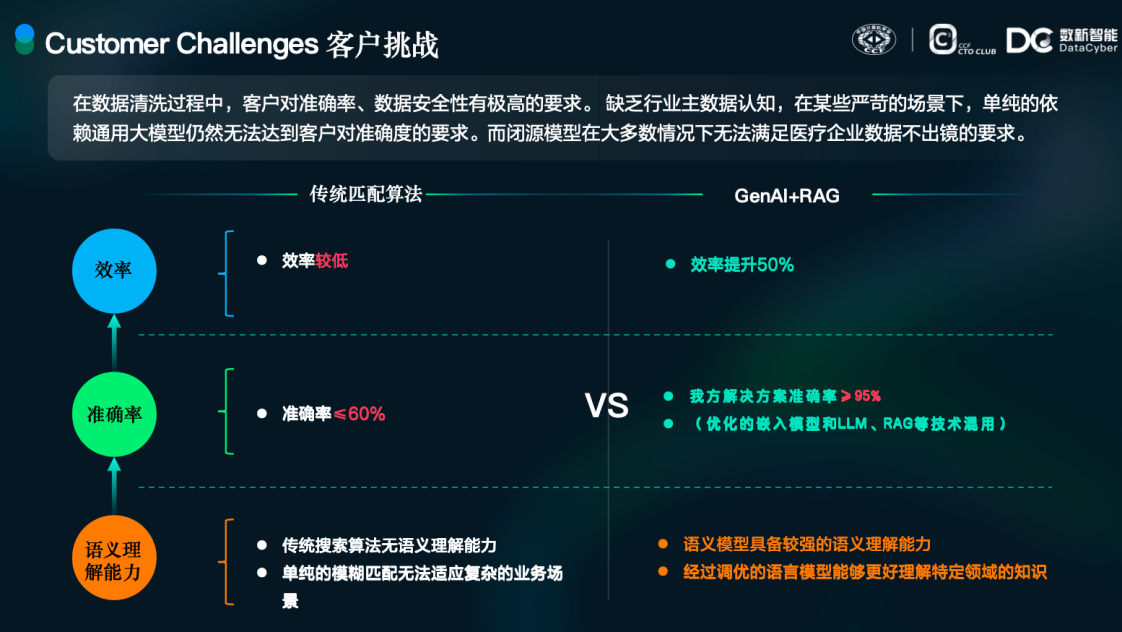
这是一个医药行业的真实案例:很多药企在销售药物时,会通过多种渠道进行售卖, 比如药店、医院、经销商等。为此,企业搭建了一套数据流向系统,专门用于追踪和分析药物的销售路径,明确每批药物是通过哪个渠道最终到达消费者手中的。

收集这些流通环节的数据,对企业后续的运营至关重要:基于这些数据,企业可以开展生产计划优化、仓储管理升级、供应链协同等多维度的数据分析与预测,从而提升整体运营效率。

不过,目前这套系统存在一个明显的低效环节:从各渠道收集到的 “流通证据” 大多是非结构化数据。比如常见的 Excel 表格,里面的数据格式往往不规范,如果直接用简单的规则将这些数据存入数据库,后续很难对其进行有效分析,也难以通过数据认证来确保信息的准确性。

当时我们协助他们开发的一个产品,核心是围绕 “机构” 展开的。这里的 “机构” 指的是他们的各类售卖渠道,只是暂时统一用这个名称来指代。但问题在于,这些渠道的信息记录很不统一。举个具体的例子:上海市第九人民医院,在数据里的名称就各式各样,有时写作 “九院”,有时是 “上海第九医院”,还有其他不同的表述,但实际上都指向同一家医院。

这种情况下,如果不做数据清洗,这些数据的价值会大打折扣, 因为基于这样的数据得出的结果,很可能不符合预期,甚至出现错误。因此,他们在前期必须进行数据清洗。那么,他们采用的清洗方式是什么呢?

他们的清洗手段其实很直接,主要靠匹配方法。具体来说,他们有一个全国标准的机构信息数据库,清洗时就用传统的匹配算法,把数据里的机构名称和数据库里的标准名做比对匹配。但这种匹配方式问题不少。比如 “九院”,全国叫这个简称的医院有很多,甚至有的会写成数字 “9 院”,算法很难准确区分,结果就是匹配完还得靠大量人力来审核、校对、修正。我们对比过这个环节优化前的情况:匹配准确率还不到 60%,即便匹配完,还是得投入大量人力做复审,而且复审效率特别低。

后来大模型兴起后,我们建议他们试试用大模型的语义理解能力来优化, 借助模型对语义的深层理解,既能减少人工复审的压力,也能让数据清洗更精准。所以当时我们设计了一套简单的外部架构方案:基于原有数据构建一个简易知识库,让所有经过清洗的数据,最终都能精准指向标准的机构信息。

这个方案的效果很明显:匹配准确率从原来的不到 60% 大幅提升至 95%,同时处理效率提高了 50%。更重要的是,原本花在数据清洗上的员工,现在可以转去做其他更有价值的工作,对团队整体效能来说也是很大的提升。
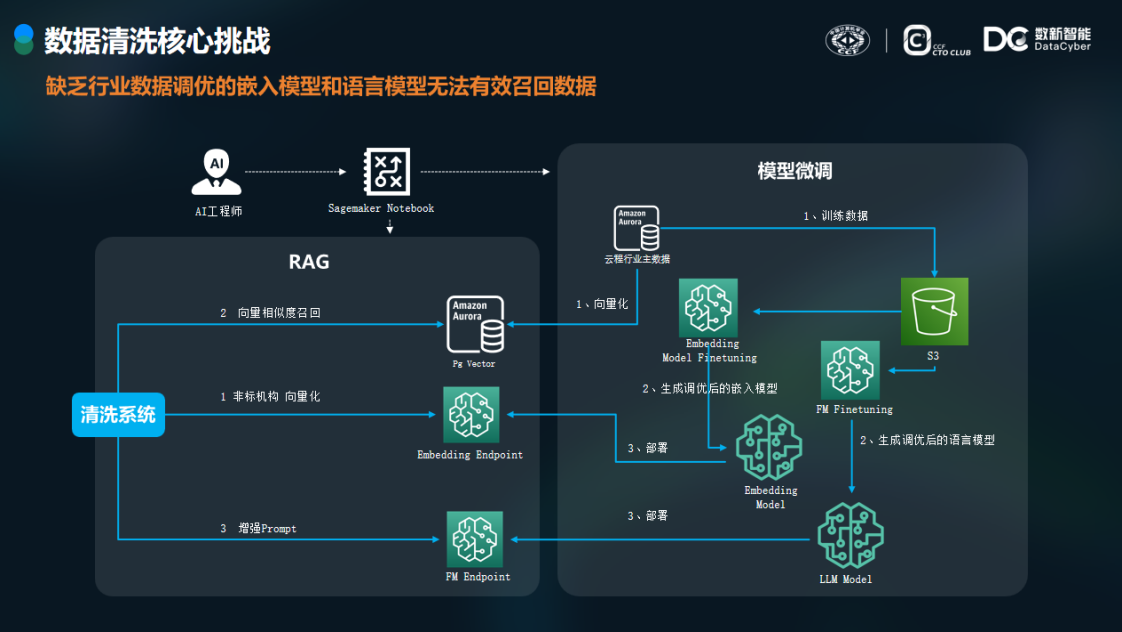
这就是当时用的一个简单架构。不过,医药企业对合规性的要求比较高,他们不愿意调用外部模型, 因为外部调用很难满足他们的合规标准。所以我们的方案做了两方面调整:一方面,用企业现有的数据对模型做了一轮调优;另一方面,也针对性调整了我们的模型。毕竟这个领域有很多专业内容,模型如果不专门优化,可能理解不到位,输出的结果自然也不够好。

为此,我们还做了两次数据清理。最终形成的架构大概是这样:不仅对他们原有的订单模型做了调整,还对嵌入的数据重新做了优化。通过这些调整,最终达到了我们预期的效果。
Amazon

第二个案例,是我们和另一家客户合作的。这是一家电商公司,从 2016 年就开始做 VOC相关的业务,这个场景在产品销售的后端其实非常重要。现在很多客户会通过电商平台、抖音、小红书这些渠道购买商品,买完之后可能会在社交媒体上发表评论,或者如果在使用中遇到问题,也可能直接在电商平台上和客服沟通。对企业来说,收集这些反馈里的负面信息并分析,不管是对产品迭代还是服务优化,都有很大帮助。

但这里有个问题:这些数据大多是非结构化的,比如用户的评论、对话记录,很难直接丢给大模型就得到能用的结果。我们最终还是得在结构化数据的基础上做进一步分析。

举个例子,我们需要明确一条评论是正面还是负面;如果是负面,还要区分是对产品本身不满,还是对物流配送、售后服务不满。所以必须通过一些手段给这些数据分类、打标签,后续的分析也都是基于这些标签化的结构化数据展开,最后才能得出有价值的结论。

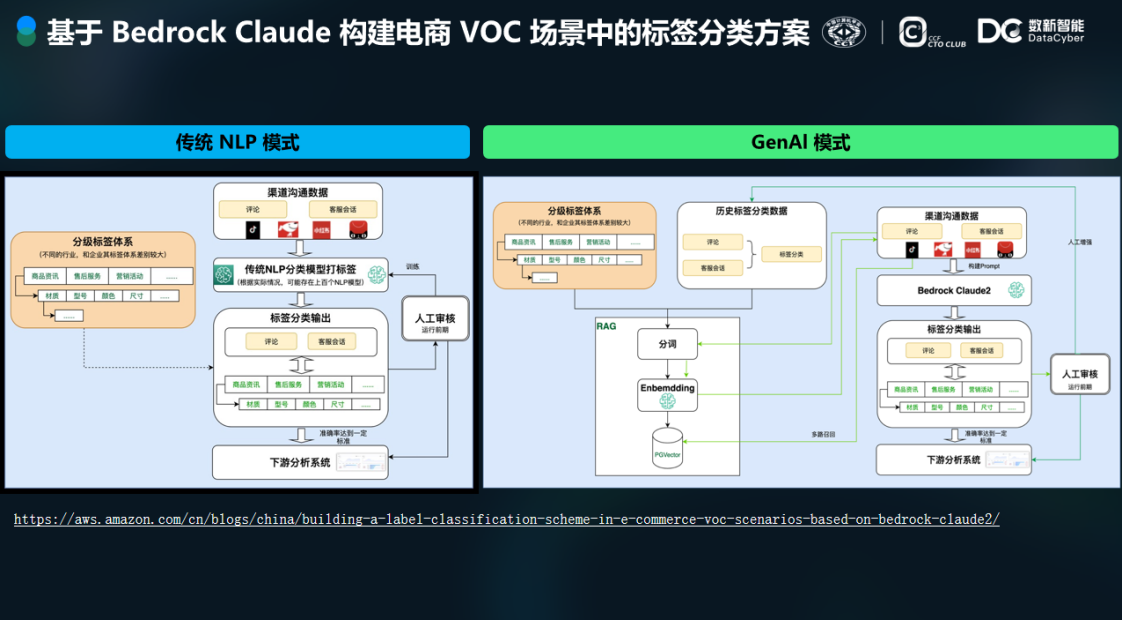
在这个过程中,打标签是个核心功能。这家公司 2016 年成立时,还没有大模型,他们就用传统 NLP 的方式做标签化:先对大量客户数据做人工标注,再用这些标注数据训练 NLP 模型,然后用模型处理新数据。但这就带来了一个问题:每个客户的产品不同,单一模型很难通用,比如 A 客户的模型,很难直接用到 B 客户身上。所以当时他们得维护几百个模型,专门用来做标签分类(PPT 左侧就是他们原来的做法)。

前年 ChatGPT 3 出来的时候,我们跟他们聊起这件事,提出能不能用大模型这种具备强大语义分析能力的工具来解决小模型的局限。所以当时就想到,用大模型来解决打标签的问题。

图片右侧是我们和他们一起商量出的解决方案,其实就是基于大语言模型(LLM)的方案。做 POC 的时候,我们试着用标签让大模型通过简单对话来打标。打标效果还算可以,准确率大概在 80%-90%,但还不够理想。其实直接用大模型,对照我们的需求给一段评论或对话打标,准确率也差不多是这个水平。但当时考虑到成本问题:客户的标签体系很复杂,分了二级、三级,要是把这么复杂的标签体系全作为上下文传给大模型处理,成本会很高。

后来我们想了个办法:把历史标注数据和现有标签数据整合起来,做成一个类似知识库的东西。之后在处理新的对话、进行打标时,会先做一轮 “召回”, 也就是查找历史记录里有没有类似的评论,看看当时给这些评论打的是什么标签。把这些相似评论和对应标签找出来后,再交给大模型,让它在这个限定范围内选择合适的标签进行标注。

这个方案在开发过程中,准确率就达到了 90% 以上。后来我们又做了优化:针对可能有问题的标签,增加了人工审核环节,审核起来效率很高。就这样,他们最终采用了这种模式,替代了原来需要维护几百个模型的旧方式。
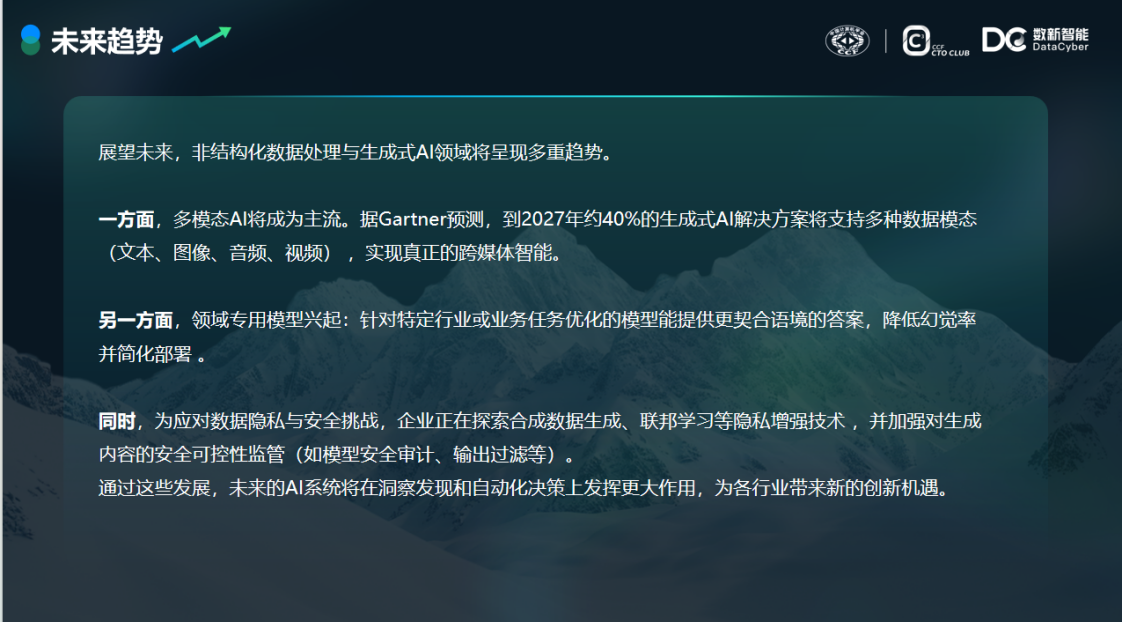
我简单梳理一下这部分的思考:多模态 AI 会逐渐成为主流:面对不同模态的数据,可能只需要一个模型就能解决你想解决的问题。根据 Gartner 的预测,到 2027 年,大概 40% 的解决方案都会支持多模态。

不过,另一方面,可能有人会觉得未来会有一个超强大的模型 “一统天下”,但我们公司内部并不这么认为,没有哪个模型是万能的,能解决所有问题。

从我个人经验来看,通用模型的训练数据大多来自公开资源,或者是花钱购买的部分内部数据。但很多企业的内部数据,其实并没有被纳入大模型的训练中。尤其是在垂直领域或特殊行业,这些未被大模型训练过的内部数据,会导致通用模型在这些场景下的表现并不好,当然,这一问题未来可能会通过各种技术手段逐步解决。

我们认为,在医疗、金融等垂直领域,如果企业想让内部的非结构化数据得到有效处理(甚至转化为结构化数据),可能需要在现有基础模型(FM)的基础上,针对性训练出专业模型。这样做的核心目的之一,是降低模型的 “幻觉”。

大模型比如 ChatGPT,往往需要通过 API 接口调用,这背后其实存在数据隐私与安全方面的挑战。

另外,实际场景中,很多客户的真实数据量并不多,而用少量数据去训练大模型,很难达到理想效果。所以我们会帮客户基于他们的业务场景合成数据,再通过反馈机制或强化学习的方式,让模型逐步理解该领域内的知识体系。

此外,安全审计、输出内容过滤这些环节也需要持续强化,尤其在安全合规要求高的业务场景中,这些都是必不可少的。

相关推荐

企业出海,如何构建支撑全球业务的数据与 AI 平台?

当企业业务进入不同国家和地区,数据与 AI 能力也需要随之布局:当地业务产生的数据需要及时处理,AI 应用需要连接相应的数据与计算资源;总部则需要掌握全局资产、统一关键标准,并组织跨区域协作。近年来受到关注的“主权 AI”(Sovereign AI),进一步凸显了企业对 AI 部署与运行的需求。企业在建设 AI 平台时,需要统筹考虑数据管理、访问权限、治理规则、基础设施与运营管理,明确。集散架构,正是围绕这组需求展开的一种架构选择。

datacreating的博客 236

拿什么拯救你 我的画布

链路越长,人工比对的成本越高。可当这张网被放进浏览器或 App,规模一大,画布就开始吃力:打开要等,拖一下卡住,松手之后画面才缓慢跟上,内存占用也一路上涨。通过展开、拖动和搜索定位,用户可以在同一张图上从全局看到细节,不必把业务拆成多张局部图,再来回切换、拼接关系。这五层中,基础层提供页面运行和计算所需的能力,工具库层负责画布与布局,引擎层处理流程图和血缘图各自的业务规则,应用层最终呈现为项目、运维和血缘三类画布。大图性能的价值,就是让用户留在同一张图上,把整体关系看全,把关键链路看完,把具体问题查清。

datacreating的博客 236

告别“数据沼泽”,拥抱“活水湖”:数新智能基于CyberEngine与Apache Paimon的新一代数据湖仓架构

数据不再只是静态存储,它正在变成流动的“水”。今天,我们正式向大家介绍基于CyberEngine大数据平台的新一代数据湖解决方案,它为企业构建灵活、实时、统一的“活水湖”数据底座。本期聚焦基于 CyberEngine 与 Apache Paimon 的新一代数据湖仓架构,解析其如何告别数据沼泽、实现实时入湖与跨存储自由,为企业构建“活水湖”提供实践参考。在CyberEngine的加持下,基于Paimon构建的数据湖成为了一汪真正的“活水湖”,既拥有数据湖的灵活性,又具备数据仓库的高性能与事务能力。

datacreating的博客 287

DataX 深度解析:异构数据同步的核心设计与实现原理

本期我们将深度解构数新智能「开源技术」系列之——开源离线数据同步工具 DataX,其他相关文章可移步专栏合集查看。作为大数据体系建设的基础工具,DataX 以 Framework+Plugin 核心设计破解异构数据源同步的 N*N 链路难题,是企业数据治理的重要抓手。本文将从架构设计、执行流程、插件开发等维度拆解其技术内核,提炼实操要点,为技术从业者提供可落地的参考思路。

datacreating的博客 458

赋能某跨境智慧物流:基于 AWS Graviton 的全栈数据平台实现 25% 成本节省

数新智能通过将 自研的云原生数据底座CyberEngine 与 业界领先的 AWS Graviton 自研芯片 进行全栈深度集成,不仅解决了客户在成本与性能上的燃眉之急,更为其构建了面向未来的数据核心竞争力。这为整个平台奠定了高性价比的基石。我们深信,真正的技术价值,在于将底层硬件的强大潜力,通过领先的软件平台转化为切实的业务成果。数新智能的解决方案核心,是将 AWS Graviton 处理器的原生优势 与 CyberEngine 数据底座的云原生能力进行深度耦合,实现从硬件到软件的全栈协同优化。

datacreating的博客 576

数新智能 CyberData 现已全面支持 AWS Graviton 处理器

重要提示: 无论客户使用的是传统 x86 架构实例还是新一代 ARM 架构的 Graviton 实例,CyberData 都能提供完全相同的功能特性和用户体验,确保服务的一致性和可靠性。通过此次架构升级,我们能够利用 Graviton 处理器带来的卓越性价比和能效,这不仅提升了服务的整体性能,也使我们能够更可持续地运营,并长期致力于为客户提供更优质的服务。发布同步性: 所有新版本、新功能及漏洞修复均同步发布至 x86 和 ARM 架构,不存在任何发布时间差异。起始支持版本:CyberData 5.4.1。

datacreating的博客 175

CyberData 数据平台版本升级:信创深化、安全升级与全链路智能管控革新

为响应国家信创战略部署,满足企业数字化转型中的数据安全与高效管理需求,数新智能 CyberData 数据平台完成核心能力迭代升级。本次升级聚焦国产化适配深化、数据安全防护强化、建模能力拓展、标准管控智能化及资产体系重构五大核心方向,同步优化多维度操作体验,为企业提供更安全、高效、灵活的数据全生命周期管理解决方案。01 强化国产化适配,拓宽生态支持边界CyberData 持续深化与国产数据库的融合适配,完成平台信创化升级,进一步拓宽生态支持范围:· 核心数据库信创化落地:将业务底层数据库全面替换为国产主流数据

datacreating的博客 449

CyberEngine 在云上大数据计算降本方面的实践和能力

随着云计算与大数据技术的深度融合,越来越多企业选择将大数据计算负载迁移至云端,以享受弹性扩展、按需使用的核心优势。但随之而来的,是云上资源配置不当、闲置浪费导致的成本高企问题,成为制约企业数字化转型效益的关键瓶颈。作为深耕大数据与云计算领域的技术服务商,数新智能依托自研 CyberEngine 产品,构建了一套通过资源优化实现云上大数据计算降本增效的标准化能力,无需定制开发即可适配各类企业场景,本文将深度拆解其核心产品化策略与实践逻辑。

datacreating的博客 614

数新智能 CyberEngine 大数据引擎管理平台焕新升级

在平台易用性上,对平台的日志管理、资源管理等模块进行了“重组”,更加贴合运维人员使用习惯,提供便捷清爽的使用体验,另外,CyberEngine平台从诞生之日起就为国内的信创用户提供了良好的支持能力,除了支持国产的ARM架构CPU机型外,对国产的操作系统和中间件也都进行了充分的适配,此次的发布信创能力又进一步得到了提升;基于AWS平台的弹性伸缩能力:支持绑定和管理EKS集群,对EKS集群的弹性伸缩能力支持,根据业务的资源使用需求快速的完成Node的弹性扩缩容,极大的优化企业用户对于资源的利用效率。

datacreating的博客 697

倒计时3天,四大行业嘉宾携出海解决方案重磅来袭

背景亮点:曾就职于新加坡科技,康柏电脑,通用汽车,爱立信,诺基亚,Linaro 非营利组织 (Linux for ARM),Ubuntu,Vantiq 等企业。:曾就职于新加坡科技,康柏电脑,通用汽车,爱立信,诺基亚,Linaro 非营利组织 (Linux for ARM),Ubuntu,Vantiq 等企业。1 月 24 日,由数新智能、CCF、华为云联合主办「智联生态 智启全球 —— 数据为帆,AI 为舵,共创出海新路径」Data+AI 技术出海主题论坛,热度再升级!:高金 数新智能解决方案总监。

datacreating的博客 904

倒计时 5 天!Data+AI 技术赋能零售出海主题峰会嘉宾重磅官宣

本次演讲将聚焦 OceanBase 如何助力中国企业应对全球化挑战,实现高效、安全的跨境数据管理,实现降本增效、提升运维效率、保障业务连续性,同时更好的满足 AI 智能业务需求,为企业在国际市场的开拓筑牢数据根基。1 月 24 日,由数新智能、CCF、华为云联合主办「智联生态 智启全球 —— 数据为帆,AI 为舵,共创出海新路径」Data+AI 技术出海主题峰会,将落地杭州东新瑞莱克斯酒店!陈燕,亿企赢海外税产品总监,从事海外税十余年,曾实施过多家上市公司海外税,范围覆盖亚洲、美洲、澳洲等。

datacreating的博客 387

CyberScheduler —— 打破数据调度边界的核心引擎

作为数新智能 CyberData 产品的调度引擎, CyberScheduler 以“全场景适配、全链路可控、全架构兼容”为设计理念,从触发机制、依赖管理、统一编排、部署能力到高可用架构,构建了一套覆盖企业数据调度全生命周期的解决方案。当前,企业采用多云(阿里云、华为云、谷歌云、AWS云、私有云等)和多计算引擎(Spark、Flink、Doris、ClickHouse、MaxCompute等)架构已成常态,但不同云厂商、不同引擎的调度工具碎片化,导致数据管理效率低下、运维成本高企。

datacreating的博客 783

Compaction in Apache Iceberg

iceberg的有一个好处是,通过快照可以做 time-travel,verion rolback, 快照中的 manifest files不会被删除。job、task执行失败,可能会导致写入了部分数据,这些数据没有任何关联任何快照,因此也不能用正常的方式删除他们,因为没有任何关联关系。但流写入时,会出现很多新的小文件,删除过期文件可以将这些文件数据删除,但是处理不了 manifest 文件。除了压缩小文件,还做了排序,这意味着最小/最大过滤的好处将会更大(扫描的文件越少,速度越快)

datacreating的博客 831

CyberAI多模态数据平台焕新升级!七大核心功能解锁高效管理新体验

数新智能一站式多云AI原生数智平台升级,新增多模态数据管理功能。

datacreating的博客 848

The Life of a Read/Write Query for Apache Iceberg Tables

本文以读写查询生命周期为核心,解析 Iceberg 表的处理逻辑。当前快照中已经存在的 manifest file,跟新的一起,写入到 manifest list中,以及manifest file 的路径和统计信息。在这个 manifest list中,包含了所有 manifest file 的路径,以及每个文件的信息,如每个分区的 lower和upper等。merge-on-read,生成新的更新/删除/插入 数据文件,读取时会忽略旧的文件,只有更新的数据在内存中,占用内存会减少。

datacreating的博客 1207

Data engineering at Meta

揭秘 Meta 如何通过 UPM 流水线管理、分析库集成及自动化监控,构建支撑千亿级日活的高效数据链路,展现湖仓架构、流批融合及云原生设计的工程化落地经验,为企业数据智能建设提供可复用的技术蓝图。facebook 每天会产生 几百P 的数据,用户行为,代码变更,这个框架就用来实时分析这种变化,并提供开发人员展示。每个表都按照 ds 分区,也就是 YYYY-MM-DD 分区的,一般是数据产生的时间,也有其他方式分区的。内部维护了一个分支,做了一些定制化修改,也会定期合并开源分支,同时也会提交修改到开源。

datacreating的博客 891

Data Ingestion: Architectural Patterns

在数据驱动的时代,数据摄取是构建高效数据生态系统的基石。Data Integration Challenges,因为是一个数据库来管理 OLAP、OLTP,如果数据源种类很多,就不好处理,需要跨数据源查询,带来复杂度。Handling Push Failures,pull失败了只要重试即可,但是push失败了 分析平面感知不到,需要设计高可用,高并发的 push流系统。本质上来说,data ingestion 就是把运营平面的数据,同步到 分析平面中,这样就可以解锁 分析平面的所有能力了。

datacreating的博客 1156

“数”风流人物|从手搓Hadoop到智能数据平台构建,数新智能CTO原攀峰的“自我突破”

本文是数新智能 CTO 原攀峰接受 IT168 专访的完整内容,字里行间藏着我们对 “智能数据平台” 的核心思考与落地答案。无论你是正在搭建数据平台的技术管理者,还是想探索 AI 时代数据价值的从业者,这篇深度访谈都值得一读。

datacreating的博客 163

BTrace

从动态追踪工具如 Btrace、Arthas 的 retransform 能力,到 JDB 调试,再到 JDK 内置的 VisualVM、JFR,以及 JProfiler、MAT 等性能分析工具,还有分布式监控工具、火焰图等,它们共同助力开发者高效定位问题、优化系统性能。· arthas 使用了:Instrumentation.retransformClasses(),会替换整个类,风险高。· btrace 使用了:java.lang.instrument,只是在关键函数中注入了额外信息,风险低。

datacreating的博客 479

云环境中的日志收集和处理方案

在云环境中,高效的日志收集与处理是系统监控和运维的关键。本文围绕《云环境中的日志收集和处理方案》展开,先介绍日志收集的两种方式,再聚焦处理环节,探讨写入 kafka、共享存储、S3 等路径,分析使用 raft 组日志集群及 NewSQL 的方案,最后结合 Spark 端调度进行总结,为云日志管理提供多维度技术参考。SPARK_EXECUTOR_ID ,driver端需要手动设置,executor 是自动设置上的。根据当前的节点 hash,定位到环的一个为止,然后顺时针处理,这样每段由不同节点处理。

datacreating的博客 776

PyTorch

在深度学习领域,PyTorch 以动态图机制和简洁易用的特性,成为科研与工程落地的热门框架。本文围绕《PyTorch》展开,从基础操作切入,通过 numpy 与 tensor 实例演示数据处理核心逻辑,深入解析 Torchvision 数据加载、图像处理及常用功能。结合卷积原理、损失函数设计、梯度计算等关键模块,详解网络构建与优化方法,搭配可视化工具与分布式训练技巧,为读者呈现从基础语法到高阶应用的完整知识图谱,助力快速掌握 PyTorch 核心技术栈。

datacreating的博客 912

OpenLDAP研究

在企业目录服务领域,OpenLDAP凭借开源、灵活的特性备受青睐。本文围绕《OpenLDAP研究》,从剖析其底层架构入手,详解实用命令与核心配置信息,展示web控制台便捷管理方式,还会梳理相关文档资源,助你全面掌握OpenLDAP的运行逻辑与使用技巧。这里存储的 kerberos 的 keytab 实际是。经过了 ASN.1 加密,包含了一些其他信息。树状的层级结构,比如组织的划分。按照 DNS 来划分层次。OpenLDAP系列文档。再做了 base64。

datacreating的博客 596

LevelDB SSTable模块

如果写成功,则将 pending_index_entry 设置为true,后面再写新的块,Add 流程的时候就会用到这个变量。匹配的话,则读取这个数据块,跳转到对应的位置,具体处理逻辑是一个回调函数,回调函数内处理 key,value。上一个块的最后一个 key,和当前要写入的(也就是后面一个块的第一个 key),计算这两个 key非分割。先 new 一个固定大小的buffer,然后读进去,再 CRC检查,并确定压缩类型,看是否要解压。分割的key就是 “the r”,正好比"the qu…

datacreating的博客 583

Agent 狂飙时代,真正的 “限速器” 藏在数据里:为何说Data&AI 数据基础设施是泥泞路到高速路的密钥

打造面向业务的数据服务与资产门户: 构建数据中台体系,将底层数据加工为易用的主题数据模型和数据服务,建立数据资产门户,为业务方提供数据目录、自助分析工具和统一的数据服务出口,赋能业务团队进行探索式分析和数据创新,真正实现数据驱动的业务增长。同时,高质量、易访问的数据资产更好地赋能了业务团队的自助分析和精细化运营,直接推动了海外业务收入的增长。为落实集团数字化战略,打破内部数据壁垒,充分挖掘数据价值,并通过数据赋能业务增长,集团构建了中心化的一站式数据开发治理平台,以支撑战略目标的实现。

datacreating的博客 674

LevelDB 辅助工具类

如果编码值 1 « 7 <= v < 1 « 14,需要两个字节编码,第一个字节使用1 + v的低7位,表示需要查看下一个字节,下一个字节使用0 + v的高7位,表示不需要查看下一个字节;首先调用 Add,将 key进去,将所有的key直接拼在一起,比如 aa、bb、cc、dd,拼在一起就是aabbccdd,中间没有分割。如果小于等于1KB,则分配一个4KB的块,插入到vector中,从4KB的块上分配相应的内存;一开始的插入会放到 lru 链表中,如果 ref++,则会放到 in_use 链表中。

datacreating的博客 789

LevelDB 多版本和压缩

VersionSet是一个版本集,里面保存了Version的一个双链表,其中有一个Version是当前版本,因为只有一个实例,还保存了其它的一些全局的元数据,Dummy Version是链表头;最后利用两层的输入文件,在不扩大level i+1输入文件的前提下,查找level i层的有key重叠的文件,结果为蓝线标准的文件,构成最终的输入文件;利用level i层的输入文件,在level i+1层找寻有key重叠的文件,结果为绿线标注的文件,构成level i,i+1层的输入文件;

datacreating的博客 578

哈尔滨工业大学教授苗东菁:AI Agent 与多模数据库

在这种方式下,我们认为随着智能体服务的实例越来越多,有7千个、8千个、1万个、100万个,数据更新的压力以及多模型的更新的压力,跟现在会是大不相同的,因为现在很多场景人工去生成数据的速度肯定不如智能体的速度。在这里面,还有在我们看到的是文档还有订单的表达的数据,还有在智能体的经验里检索的时候,有RAG的数据,同时在智能体工作的时候,还会有对这些数据反向的更新。我们在调研中看到一些资料,举一个非常有意思的真实的例子,尽管它从某种意义上来讲,还不算是特别理想的智能体,更多的还是智能工作流。

datacreating的博客 830

Building An Elastic Query Engine on Disaggregated Storage

本文探讨了在分离式存储架构上构建弹性查询引擎的关键技术。针对传统shared-nothing架构的资源利用率低、弹性不足等问题,提出了基于云环境的存储计算分离方案。系统采用四层架构:中心化服务层、计算层、分布式临时存储层和持久数据存储层。重点研究了临时存储系统设计(采用内存-SSD两级缓存)、资源弹性策略(延迟一致性hash)及多租户支持方案。实验数据显示75%的只读查询缓存命中率超过80%,验证了架构有效性。文章还讨论了未来优化方向,包括更细粒度的资源调度和多租户隔离机制。该研究为云环境下的弹性数据查询提

datacreating的博客 833

中国计算机学会杭州分部副主席朱霖潮:多模态大模型的研究进展与未来

这种交互模式本质上构建了一个动态演进的Token处理体系:环境状态被编码为输入Token,模型生成的行动指令作为输出Token,而环境反馈又形成新的输入Token,构成持续流动的交互流。技术演进表明,新一代模型正从早期的单一能力专精(如GPT系列的语言理解、DALL·E的图像生成)发展为多模态协同的智能体系,其核心优势在于实现了意图理解与内容创作的无缝衔接。相较于单模态的理解或生成任务,这种多智能体协作系统需要处理更复杂的时空约束和资源分配问题,其技术难点主要在于实时决策的准确性和多主体协调的一致性保障。

datacreating的博客 1049

华为云云服务高级顾问叶正晖:华为对多模态大模型的思考与实践

我们大模型的架构的趋势,还是要从以前的单一模态走向多模态大一统,在未来的趋势下,从2021年的Vision Transformer到2022年的Whisper大模型再到2024年的Sora,整个过程里面从以前的视觉到语音到混合,再到生成大模型的一个统一。我们把视觉认知专项打开看一下,其实视觉认知专项在原来的基础多模态大模型中,经过海量的数据的训练,10000+通用及行业实用标签,包括场景标签,关系标签、行为标签都在这里面。华为的盘古多模态大规模的模型,它是一个层次融合的一个架构。三是全模态的大模型。

datacreating的博客 1003
上一篇: “多模态数据融合技术创新与落地实战”活动于数新智能圆满收官,产学研共探智能时代新路径
下一篇: 数新智能 CTO 原攀峰:DataCyber 面向 AI 时代的多模态数据湖设计与实践
数新智能
数新智能 数新智能官方账号 数新智能官方账号
博客等级 码龄5年 407粉丝 110原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值