Andrew Ng机器学习课程笔记(十三)之无监督学习之EM算法

Jensen‘s inequality(詹森不等式) 在凸函数的情况下,线性组合的函数值不大于函数值的线性组合。换句话说,如果你在凸函数的图像上取两点,然后画一条直线连接这两点,那么这条直线将始终位于这两点之间图像的上方或与之重合。换成期望值的语境,就是随机变量经过凸函数的期望不小于随机变量期望的函数值。Jensen’s inequality(詹森不等式)是数学中的一条重要不等式,由丹麦数学家Johan Jensen于1906年提出。直观上说,这意味着在凸函数的图形上,任意两点间的线段总是位于函数图形的上方或与之重合。是凸的,如果对于所有的。 阅读详情

Preface

Jensen’s Inequality(Jensen不等式)
Expectation-Maximization Algorithm(EM算法)

Jensen’s Inequality

对于凸函数

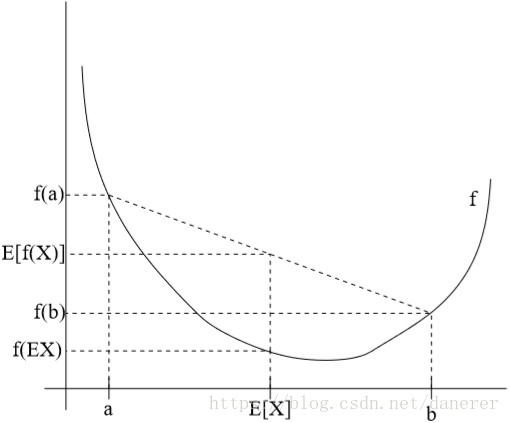
令 f(x) f ( x ) 为一个凸函数,且如果它有二阶导数,其二阶导数恒大于等于0( f(x)′′≥0 f ( x ) ″ ≥ 0 )。令 x x 为一个随机变量,那么:

E[f(x)]≥f(EX)

这个不等式的含义如下图所示:
这里写图片描述
我们可以进一步推导出,如果 f(x)′′>0 f ( x ) ″ > 0 ,即 f(x) f ( x ) 为一个严格的凸函数。那么:

E[f(x)]=f(EX)⟺x为常量的概率为1⟺X=EX的概率为1 E [ f ( x ) ] = f ( E X ) ⟺ x 为常量的概率为1 ⟺ X = E X 的概率为1

对于凹函数

如果 f(x)′′≤0 f ( x ) ″ ≤ 0 ,即 f(x) f ( x ) 为一个凸函数。那么:

f(EX)≥E[f(x)] f ( E X ) ≥ E [ f ( x ) ]

Expectation-Maximization Algorithm

问题定义

假设训练集 {x(1),x(2),...,x(m)} { x ( 1 ) , x ( 2 ) , . . . , x ( m ) } 是由m个独立的无标记样本构成。我们有这个训练集的概率分布模型 p(x,z;θ) p ( x , z ; θ ) ,但是我们只能观察到 x x 。我们需要使参数θ的对数似然性最大化,即:

argmaxθl(θ)=argmaxθ∑mi=1logp(x(i);θ)=argmaxθ∑mi=1log∑zp(x(i),z(i);θ) arg max θ l ( θ ) = arg max θ ∑ m i = 1 l o g p ( x ( i ) ; θ ) = arg max θ ∑ m i = 1 l o g ∑ z p ( x ( i ) , z ( i ) ; θ )

形式化过程

EM算法的过程大致如下:

首先,初始化 θ(0) θ ( 0 ) ,调整 Q(z) Q ( z ) 使得 J(Q,θ(0)) J ( Q , θ ( 0 ) ) 与 θ(0) θ ( 0 ) 相等,然后求出 J(Q,θ(0)) J ( Q , θ ( 0 ) ) 使得到最大值的 θ(1) θ ( 1 ) ;固定 θ(1) θ ( 1 ) ,调整 J(Q,θ(1)) J ( Q , θ ( 1 ) ) ,使得 J(Q,θ(1)) J ( Q , θ ( 1 ) ) 与 θ(1) θ ( 1 ) 相等,然后求出 J(Q,θ(1)) J ( Q , θ ( 1 ) ) 使得到最大值的 θ(2) θ ( 2 ) ;……;如此循环,使得 l(θ) l ( θ ) 的值不断上升,直到k次循环后,求出了 l(θ) l ( θ ) 的最大值 l(θ(k)) l ( θ ( k ) ) 。
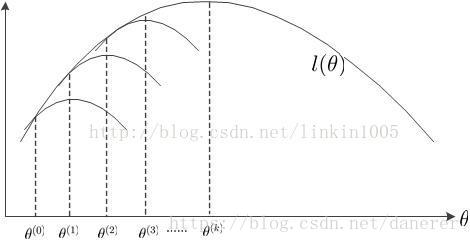
这里写图片描述

推导过程

在问题定义中我们知道:

argmaxθl(θ)=argmaxθ∑mi=1logp(x(i);θ)=argmaxθ∑mi=1log∑zp(x(i),z(i);θ) arg max θ l ( θ ) = arg max θ ∑ m i = 1 l o g p ( x ( i ) ; θ ) = arg max θ ∑ m i = 1 l o g ∑ z p ( x ( i ) , z ( i ) ; θ )

接下来我们正式开始EM算法的推导:

假设每一个 z(i) z ( i ) 的分布函数为 Qi Q i 。故有 ∑ZQi(z)=1,Qi(z)≥0 ∑ Z Q i ( z ) = 1 , Q i ( z ) ≥ 0 。所以:

l(θ)=∑ilog∑z(i)p(x(i),z(i);θ)=∑ilog∑z(i)Qi(z(i))p(x(i),z(i);θ)Qi(z(i))≥∑i∑z(i)Qi(z(i))logp(x(i),z(i);θ)Qi(z(i))(1)(2)(3) l ( θ ) = ∑ i l o g ∑ z ( i ) p ( x ( i ) , z ( i ) ; θ ) ( 1 ) = ∑ i l o g ∑ z ( i ) Q i ( z ( i ) ) p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) ) ( 2 ) ≥ ∑ i ∑ z ( i ) Q i ( z ( i ) ) l o g p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) ) ( 3 )

对于上述公式中的第(2)步到第(3)步的理解:

  1. 首先由于数学期望公式 Y=g(X),g(X)为连续函数;E(Y)=E(g(x))=∏∞k=1g(xk)pk Y = g ( X ) , g ( X ) 为 连 续 函 数 ; E ( Y ) = E ( g ( x ) ) = ∏ k = 1 ∞ g ( x k ) p k ,
    ∑z(i)Qi(z(i))p(x(i),z(i);θ)Qi(z(i)) ∑ z ( i ) Q i ( z ( i ) ) p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) ) 可以看做随机变量为 Qi(z(i)) Q i ( z ( i ) ) 概率分布函数为 p(x(i),z(i);θ)Qi(z(i)) p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) ) 的期望,即为:
    ∑z(i)Qi(z(i))p(x(i),z(i);θ)Qi(z(i))=E(p(x(i),z(i);θ)Qi(z(i))) ∑ z ( i ) Q i ( z ( i ) ) p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) ) = E ( p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) ) )
  2. 由Jensen不等式,且 f(x)=logx,f′′(x)=−1x2<0 f ( x ) = l o g x , f ″ ( x ) = − 1 x 2 < 0 ,所以:
    f(Ez(i)∼Qi[p(x(i),z(i);θ)Qi(z(i))])≥Ez(i)∼Qi[f(p(x(i),z(i);θ)Qi(z(i)))] f ( E z ( i ) ∼ Q i [ p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) ) ] ) ≥ E z ( i ) ∼ Q i [ f ( p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) ) ) ]

所以参数 θ θ 的对数似然性就有了一个下界,我们回想在EM算法的形式化过程中的不断推进得到的下界不断上升的过程,在这里我们也希望得到一个更加紧密的下界,也就是使等号成立的情况。
根据Jensen不等式,所以有:

p(x(i),z(i);θ)Qi(z(i))=c(c为常数) p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) ) = c ( c 为 常 数 )

所以:
Qi(z(i))=c∗p(x(i),z(i);θ)(c为常数) Q i ( z ( i ) ) = c ∗ p ( x ( i ) , z ( i ) ; θ ) ( c 为 常 数 )

因为 ∑ZQi(z)=1,Qi(z)≥0 ∑ Z Q i ( z ) = 1 , Q i ( z ) ≥ 0 ,所以:
∑ZQi(z(i))=∑Zc∗p(x(i),z(i);θ)=1(c为常数) ∑ Z Q i ( z ( i ) ) = ∑ Z c ∗ p ( x ( i ) , z ( i ) ; θ ) = 1 ( c 为 常 数 )

所以:
c=1∑Zp(x(i),z(i);θ)(c为常数) c = 1 ∑ Z p ( x ( i ) , z ( i ) ; θ ) ( c 为 常 数 )

所以:
Qi(z(i))=p(x(i),z(i);θ)∑zp(x(i),z;θ)=p(x(i),z(i);θ)p(x(i);θ)=p(z(i)|x(i);θ) Q i ( z ( i ) ) = p ( x ( i ) , z ( i ) ; θ ) ∑ z p ( x ( i ) , z ; θ ) = p ( x ( i ) , z ( i ) ; θ ) p ( x ( i ) ; θ ) = p ( z ( i ) | x ( i ) ; θ )

EM算法

EM算法主要有两个步骤,EM算法的具体内容如下:、
Repeat until convergence{

  1. (E-step) for each i, set
    Qi(z(i)):=p(z(i)|x(i);θ) Q i ( z ( i ) ) := p ( z ( i ) | x ( i ) ; θ )
  2. (M-step) set
    θ:=argmaxθ∑i∑z(i)Qi(z(i))logp(x(i),z(i);θ)Qi(z(i)) θ := arg max θ ∑ i ∑ z ( i ) Q i ( z ( i ) ) l o g p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) )

}

收敛性证明

我们可以定义一个优化目标

J(Q,θ)=∑i∑z(i)Qi(z(i))logp(x(i),z(i);θ)Qi(z(i)) J ( Q , θ ) = ∑ i ∑ z ( i ) Q i ( z ( i ) ) l o g p ( x ( i ) , z ( i ) ; θ ) Q i ( z ( i ) )

使用Jensen不等式,我们可以推导出:
l(θ)≥J(Q,θ) l ( θ ) ≥ J ( Q , θ )

回顾前面所学的知识,EM 可以看作是函数 J 的坐标上升法,E步固定θ优化Q,M 步固定Q优化θ。 再利用相关知识便可以证明。

【机器学习】Andrew Ng——01概述 机器学习的概述 阅读详情

相关推荐

斯坦福大学公开课 :机器学习课程(Andrew Ng)——12、无监督学习:Factor Analysis

1)问题描述 2)协方差矩阵的限制 3)多元高斯分布的边缘分布和条件分布 4)因子分析的例子 5)因子分析模型 6)因子分析的EM估计‘ 7)简单总结 1)问题描述    之前我们考虑的训练数据中样例的个数m都远远大于其特征个数n,这样不管是进行回归、聚类等都没有太大的问题。    然而当训练样例个数m太小,甚至m变成奇异阵(),也就是说不存在,根

mmc2015的专栏 2801

琴生不等式(Jensen Inequality)

琴生不等式以丹麦技术大学数学家John Jensen命名,它给出了积分的凸函数值和凸函数的积分值间的关系。又称詹森不等式。 若

qq_32515081的博客 3万+

斯坦福大学公开课 :机器学习课程(Andrew Ng)——9、无监督学习:K-means Clustering Algorithm

1)K-means聚类算法(K-means Clustering Algorithm)描述 2)2-means聚类算法(K-means Clustering Algorithm)效果展示图片 3)k-means聚类算法(K-means Clustering Algorithm)收敛性简述 4)支持k-means聚类算法(K-means Clustering Algorithm)有效性的...

mmc2015的专栏 3159

【机器学习】琴生不等式(Jensen's inequality)

琴生不等式的概述: 在数学上 1、若f(x)是区间(a,b)上的凸函数,则对任意的x1,x2,x3, ......,xn∈(a,b)x_1,x_2,x_{3,\ }......,x_n\in(a,b)x1​,x2​,x3, ​......,xn​∈(a,b),有不等式: f(x1+x2+x3+......+xnn)≤f(x1)+f(x2)+f(x3)+......+f(xn)n...

lyn0402的博客 7507

斯坦福大学公开课 :机器学习课程(Andrew Ng)——10、无监督学习:Mixture of Gaussians and the EM Algorithm

1

mmc2015的专栏 2082

【人工智能的数学基础】琴生不等式(Jenson’s Inequality)

于1906年证明。该不等式描述了凸函数中的不等式关系,有着广泛的应用。

AI天才研究院 5252

琴生不等式 (Jensen‘s Inequality)

琴生不等式(Jensen's Inequality)

老哥的博客 2678

Andrew Ng机器学习课程13

Andrew Ng机器学习课程13 引言:主要从一般的角度介绍EM算法及其思想,并推导了EM算法的收敛性。最后用一般的EM算法回顾了混合高斯模型的求解过程,并推导了通过EM算法求解混合高斯模型参数的过程。视频笔记会通过增补内容加以补充。

ZhangPY的专栏 2024

斯坦福大学Andrew Ng教授主讲的《机器学习》公开课观后感

近日,在网易公开课视频网站上看完了《机器学习》课程视频,现做个学后感,也叫观后感吧。  学习时间 从2013年7月26日星期五开始,在网易公开课视频网站上,观看由斯坦福大学Andrew Ng教授主讲的计算机系课程(编号CS229)《机器学习》(网址http://v.163.com/special/opencourse/machinelearning.html)(注:最早是在新浪公开课

lotus___的专栏 7万+

Andrew Ng机器学习课程12

Andrew Ng机器学习课程12 引言:主要讲述了batch learning和online learning的区别,然后介绍了经典的非监督算法:k-means算法。然后介绍了混合高斯模型以及求解时采用的EM算法。本文是基于lecture notes进行的总结,等上完视频课,会通过12课补充来丰富这些内容。

ZhangPY的专栏 1912

经典EM算法介绍-由浅入深

这几天把EM算法(Expectation Maxinum)反复琢磨了几遍,经过几次讨论,对EM算法的数学模型有了比较深入的理解。考虑到: 1. 这个算法在Machine Learning中极其重要,也是进行Machine Learning深入研究的一个重要阶梯 2. 这个算法确实需要一定的概率和数学基础 3. 中文或翻译的教材似乎没有很好的解释清楚这个算法 于是我根据Pattern Recogition and Machine Learning一书相关章节的内容,结合自己的理解,写了一套中文的EM算法介绍和分析。又混合高斯模型开始,由浅入深,逐步讲解了EM算法在混合高斯模型应用和一般化描述。自己感觉还是比较容易理解的。 如果发现pdf中有什么问题,或有什么错误,请直接与我联系,欢迎讨论。 要下载最新的版本请到http://glatteis.spaces.live.com

【人工智能基础学习】Andrew Ng-机器学习基础笔记

深入探讨了机器学习的基础概念,尤其是监督学习和无监督学习。我们将重点介绍两种主要的机器学习方法——线性回归和梯度下降,帮助初学者理解这些基本算法及其应用。在具体讨论线性回归时,我们会详细讲解模型的表示、代价函数的计算及其直观理解。此外,我们还会深入探讨梯度下降算法,包括其直观解释和在实际问题中的应用。

忆_恒心的博客 1535

Jensen不等式

Jensen不等式的说明 本文主要参考《Convex Optimization》一书 [1]。 给定函数 f (x) : Rn → R,当它满足如下条件时,它就是凸函数。

【原】斯坦福大学Andrew Ng教授主讲的《机器学习》公开课观后感

近日,在网易公开课视频网站上看完了《机器学习》课程视频,现做个学后感,也叫观后感吧。 [size=medium][b][color=blue]学习时间[/color][/b][/size] 从2013年7月26日星期五开始,在网易公开课视频网站上,观看由斯坦福大学Andrew Ng教授主讲的计算机系课程(编号CS229)《机器学习》(网址[url]http://v.163.com/spe...

iteye_19939的博客 874

一文帮你彻底搞懂ARM Debug Interface之SWD(转)

ARM的文档写的已经很好了,但是关于上电以后的第一时间应该怎么操作,依然写的不够清晰,导致我第一次用的时候还是费了一些周折。今天做一个详细的梳理,希望能够帮助到更多的朋友。BTW, ARM_Cortex-M0/3 DesignStart系列会持续更新,只是中间可能会穿插其他知识点。SWD是Serial Wire Debug的简称,翻译成中文是”串行线调试”。

2302_79847220的博客 6861

Jetson Orin NX系统克隆术:如何快速备份与还原你的开发环境(附完整命令行)

本文详细介绍了Jetson Orin NX系统克隆的完整流程,这是一种超越简单备份的完整镜像方案。通过命令行操作,可实现开发环境(包括引导程序、内核、根文件系统及所有配置)的快速备份与还原,确保批量部署时环境的完全一致性与高效性,尤其适合机器人、边缘AI等项目的团队协作。

weixin_29191081的博客 157

Andrew Ng-机器学习基础笔记(上)-Python实现代码

目录 1.引言: 1.1Welcome: 1.2机器学习是什么? 1.3监督学习 1.4无监督学习: 总结: 2.线性回归 单变量的线性回归 2.1模型表示 2.2代价函数 2.3代价函数的直观理解: 2.4 代价函数的直观理解 2.5 梯度下降(Gradient descent) 2.6 梯度下降的直观理解 2.7梯度下降的线性回归 3、线性代数回顾 3.1 矩阵和向量 3.2 加法和标量陈发 3.3 矩阵向量乘法 3.4 矩阵乘法 3.5 矩阵乘法的性质 3.

忆_恒心的博客 2535

从CTF到实战:Frida Hook无导出SO函数的3种特殊姿势

本文深入探讨了在移动安全逆向工程中,如何利用Frida Hook无导出SO函数的三种高级技巧:字符串引用定位法、调用栈回溯法和内存特征码扫描。针对安卓So层加固和混淆场景,文章结合CTF赛题与实战案例,详细解析了每种方法的原理、实现步骤与适用场景,为安全研究人员提供了从理论到实践的完整解决方案。

jenkins8butler的博客 516

Andrew Ng机器学习课程总结

Andrew Ng机器学习课程总结 Andrew Ng的机器学习课程讲授的详尽而又易于理解,适合初学者。相关资源见斯坦福公开课与Ng的主页,英文不好的同学推荐网易公开课。Ng的课件关于理论介绍的很好,这里只做摘要,具体参见其课件。 主要知识点:线性回归梯度下降最小二乘似然估计 logistic回归感知器  1)回归:对连续变量的预测。 2)线性回归(Linear Regression):假

彼岸花 2205

LaTeX双栏浮动结构实战:用dblfloatfix解决跨栏图表排版难题

本文深入探讨了LaTeX双栏浮动结构在学术论文排版中的常见问题,特别是IEEE会议论文中的跨栏图表定位难题。通过介绍dblfloatfix包的整合解决方案,帮助用户实现精准的底部定位和浮动顺序保持,提升排版效率与质量。

weixin_30872499的博客 442

[AHK] 自动化获取通达信股票代码:从消息钩子到数据提取

本文详细介绍了如何使用AHK(AutoHotkey)通过Windows消息钩子技术自动化获取通达信股票代码,实现高效数据提取和交易自动化。文章涵盖消息机制原理、AHK脚本开发、性能优化及安全注意事项,为股票交易者提供了一套完整的解决方案。

weixin_42614269的博客 617

Andrew Ng机器学习课程笔记(十五)之无监督学习之混合贝叶斯模型与EM算法

Preface Jensen’s Inequality Expectation-Maximization Algorithm Preface Jensen’s Inequality(Jensen不等式) Expectation-Maximization Algorithm(EM算法) Jensen’s Inequality Expectation-Maximizati...

danerer的专栏 4799

2025年普通人转向人工智能运维(AIOps)学习建议(附最新技术实践与资源)

AIOps不仅是技术的叠加,更是运维流程的重构。建议通过“学习-实践-反馈”循环,逐步从工具使用者成长为解决方案设计者。如需完整资源链接,可访问上述推荐的优快云博客及GitHub仓库。

资深全栈架构师,乐于在 优快云 分享技术见解,与大家携手共进,共攀技术巅峰! 3096
上一篇: Andrew Ng机器学习课程笔记(十二)之无监督学习之K-means聚类算法
下一篇: Andrew Ng机器学习课程笔记(十四)之无监督学习之混合高斯模型与EM算法
danerli
博客等级 码龄12年 36粉丝 40原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值