干货 | 性能提升400%,ClickHouse在携程酒店数仓的实践

DB::Exception: Too many parts (300)解决方法 clickhouse批量插入数据时出现DB::Exception: Too many parts (300)通常是因为ClickHouse在插入数据时生成了太多的parts文件,而这些文件合并的速度跟不上插入的速度,导致超过了默认的parts_to_throw_insert值,即300个parts。以上方案,仅供参考。 阅读详情

作者简介


小琴,携程高级数据经理,负责酒店BI、数仓工作,专注于大数据应用领域多年。

一、背景

随着时间推移和业务的快速发展,携程酒店数据累积越来越多。目前流量日数据在3T左右,再加上各种订单、价、量、态等数据更是庞大。现有Hive(Spark引擎)执行速度虽然相对较快,但在国际化发展背景下,一些海外业务由于时差问题,数据需要比国内提前数小时完成,性能提升迫在眉睫。2020年初,我们开始研究ClickHouse在数据仓库领域应用。

本文将从技术方案选型、集成开发环境封装、ClickHouse代码优化技巧、异常问题处理、服务器故障处理五个方面分享ClickHouse实践,希望给关注同样问题的同学有所启发。

二、技术预研与技术方案选型

1)公司内部有无ClickHouse集群使用环境。经过了解知晓,原ClickHouse验证集群正准备下线,无可用环境;

2)办公电脑通过Vmware搭建ClickHouse集群,部分同学基于单机练习ClickHouse语法以及验证各项ClickHouse特性,部分专攻ClickHouse集群搭建及各项配置、集成开发环境的封装等底层功能。

3)2020年3月,Vmware搭建ClickHouse集群基本完成各项验证,同时4台物理服务器(配置:内存-256G,CPU-40core,硬盘-3.5T)到位。为保证对生产平稳过渡(不给生产DB造成额外压力),我们从Hive ODS层同步数据至ClickHouse ODS层,技术方案如下图1(橙色部分是ClickHouse实现部分):
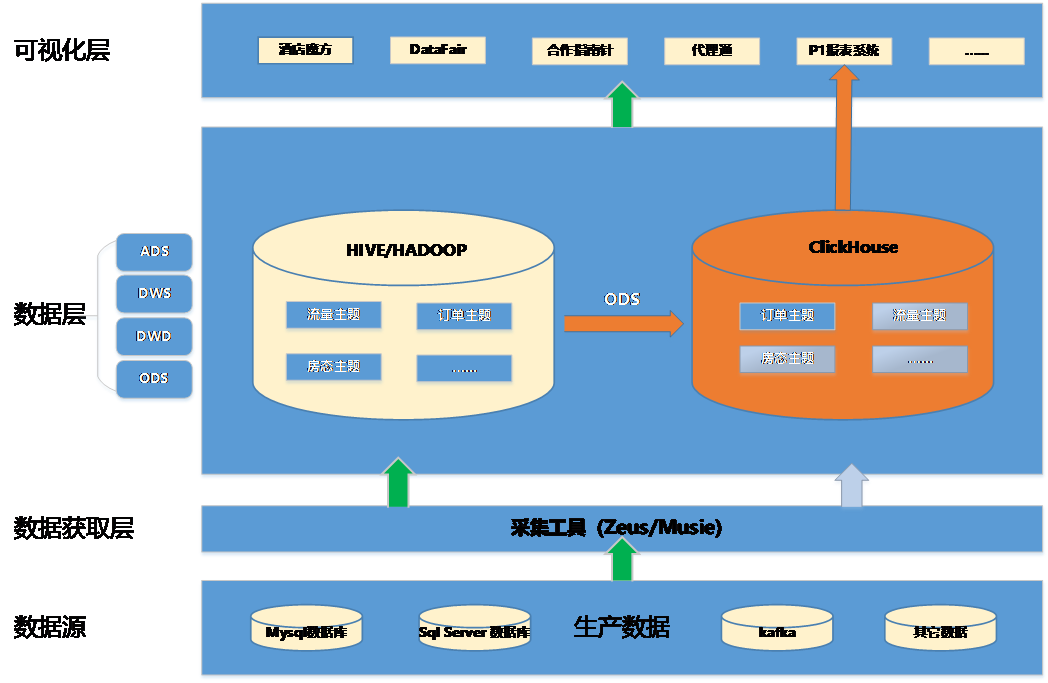
图1

三、集成开发环境封装

1)数据同步工具封装

我们发现消耗在数据同步上的时间太多,是数据计算时间的十几倍。于是开始研究ClickHouse数据导入方式,其中一种如下:

cat filename.orc | clickhouse-client -- query="INSERTINTO some_table FORMAT ORC"

在此基础上通过缓存、批处理等机制封装成新的orc2ck.sh同步工具,使同步速度比原先工具的性能提高500%以上。

2)集成开发工具封装

为了提高开发效率,减少代码冗余,我们封装了ClickHouse代码执行工具ck.sh,执行环境如下图2(橙色部分是应用代码部分,红色框部分是封装工具及参数)。

图2

四、ClickHouse代码优化技巧

1)小表置于join右侧降低内存消耗

2)用in替代join提高执行速度

3)减少数据扫描提高执行速度

通过增加过滤逻辑可以减少数据扫描,达到提高执行速度及降低内存消耗的目的。

五、异常问题处理

Code: 252, e.displayText() = DB::Exception: Too many parts (301) . Merges are processing significantly slower than inserts.

解决这个问题需要先分析Merge过程,如下图所示:

Merge过程是异步的,插入速度过快会导致以上错误,一般建议速度100w/s。

Code: 241, e.displayText() = DB::Exception: Memory limit (for query) exceeded

这种错误是请求内存高于系统分配内存导致,解决这类问题可以从两方面入手:

  • 在服务器内存充裕的情况下增加内存配额,一般通过max_memory_usage来实现;

  • 在服务器内存不充裕的情况下,建议将超出部分内容分配到系统硬盘上,但会降低执行速度;一般通过max_bytes_before_external_group_by 、max_bytes_before_external_sort参数来实现。

如果以上方法仍然无法解决问题,需要检查代码是否合理,从代码角度去优化(参考代码优化技巧部分)。

六、服务器故障处理

故障背景:故障演练导致ClickHouse服务器被强行重启,ClickHouse服务无法正常启动。

解决办法:根据ClickHouse错误日志 (clickhouse-server.err.log) 定位问题,发现ClickHouse服务启动时无法加载表的元数据,处理方式有两种:

1)删除或移走该表对应数据文件(本次故障使用了该方式,下图为错误日志)。

2)重建该表元数据(此方式更为合理)。

七、小结

截止2020年上半年,携程酒店订单主题以及P1体系报表已经全部实现完毕,大部分性能提升在200%以上,整体性能提升平均在400%左右,基本解决大部分应用场景的问题,后期我们将整合更多主题入仓,充分发挥ClickHouse的性能优势,进一步提升效率。此外,我们也在研究Flink+ClickHouse技术,推进实时数仓建设。

【推荐阅读】

“携程技术”公众号后台回复“新书”,

可免费获得两本书的试读样章~

《携程架构实践》

京东

当当

《携程人工智能实践》

京东

当当

 “携程技术”公众号

  分享,交流,成长

dataX 迁移 mysql2clickhouse 报Too many parts错误 【dataX 】【非spark】迁移 mysql2clickhouse 报Too many parts (301). Merges are processing significantly slower than inserts.错误 阅读详情

相关推荐

ClickHouse 问题总结(持续更新)

Too many parts(XXX). Merges are processing significantly slower than inserts. Memory limit (for query) exceeded:would use 10.01GiB (attempt to allocate chunk of 386,753,325 bytes), maximum: 8.00 GiBCan’t get data for node /clickhouse/tables/XXX。

qq_40694671的博客 3975

ClickHouse-优化(建表、配置)

1.数据类型 1.1时间字段的类型 建表时能用数值型或日期时间型表示的字段就不要用字符串,全 String 类型在以 Hive为中心的数仓建设中常见,但 ClickHouse 环境不应受此影响。 虽然 ClickHouse 底层将 DateTime 存储为时间戳 Long 类型,但不建议存储 Long 类型,因为 DateTime 不需要经过函数转换处理,执行效率高、可读性好。 CREAT...

qq_38304392的博客 1487

VScode - 从入门到精通:高效开发环境搭建指南

本文是一份全面的VSCode高效开发环境搭建指南。从选择理由、安装配置、核心插件推荐到个性化设置与高效技巧,详细讲解了如何将这款轻量级编辑器武装成强大的开发工具。重点介绍了GitLens、Prettier、Live Server等必备插件,以及通过用户设置、代码片段和快捷键打造专属高效工作流的方法,帮助开发者从入门到精通。

weixin_27734811的博客 426

clickhouse报错---Code: 252, e.displayText() = DB::Exception: Too many parts (311). Merges are processi

clickhouse报错—Code: 252, e.displayText() = DB::Exception: Too many parts (311). Merges are processing significantly slower than inserts, Stack trace (when copying this message, always include the lines below): 解决方案一: 1、 一般Too many parts (311) 小于350不用处理,观察一段

w_yq111的博客 3592

电力市场小白必看:手把手教你用Matlab实现市场出清电价计算(附完整代码)

本文为电力市场初学者提供了使用Matlab计算市场出清电价的完整指南。通过Yalmip和Matpower工具包,详细讲解了从环境配置到模型构建、求解及结果分析的整个过程,帮助读者快速掌握节点电价计算的核心技术。

weixin_30379531的博客 73

通义千问语言模型Qwen2.5架构详解

此外,将基于API的模型 Qwen-Plus 与领先的专有和开源模型进行了对比,包括 GPT4-o、Claude-3.5-Sonnet、Llama-3.1-405B和DeepSeek-V2.5。Qwen2.5-Math-72B-Instruct的整体性能超越了Qwen2-Math-72B-Instruct和GPT4-o,甚至是非常小的专业模型如 Qwen2.5-Math-1.5B-Instruct也能在与大型语言模型的竞争中取得高度竞争力的表现。近来也出现了明显的转向小型语言模型(SLMs)的趋势。

搏博的专栏 1万+

clickhouse 航空数据_ClickHouse 系列报错

1. ClickHouse 查询时,报错:Memory limit (for query) exceeded: would use 9.38 GiB (attempt to allocate chunk of 135439453 bytes), maximum: 9.31 GiB1.1 ClickHouse 环境1.2 报错原因默认情况下,ClickHouse会限制group by使用的内存量(它...

weixin_34163098的博客 1661

快手极速版抓包实战:安卓/iOS双端获取client_salt全流程解析(避坑指南)

本文详细解析了在安卓和iOS平台上获取快手极速版关键参数`client_salt`的全流程,包括环境配置、抓包工具使用、参数识别与转换等实战技巧。特别针对双端差异和反抓包机制提供了避坑指南,帮助开发者高效安全地完成数据获取任务。

weixin_29021195的博客 711

clickhouse join_干货 | 性能提升400%,ClickHouse在携程酒店数仓的实践

作者简介小琴,携程高级数据经理,负责酒店BI、数仓工作,专注于大数据应用领域多年。一、背景随着时间推移和业务的快速发展,携程酒店数据累积越来越多。目前流量日数据在3T左右,再加上各种订单、价、量、态等数据更是庞大。现有Hive(Spark引擎)执行速度虽然相对较快,但在国际化发展背景下,一些海外业务由于时差问题,数据需要比国内提前数小时完成,性能提升迫在眉睫。2020年初,我们开始研究...

weixin_39550258的博客 2371

Android Profiler实战:如何用CPU分析工具揪出卡顿元凶(附线程状态解读)

本文深入解析Android Profiler中的CPU分析工具,重点聚焦线程活动监控。通过解读线程状态时间轴上的绿、黄、灰三色含义,并结合实战案例,指导开发者精准定位导致界面卡顿的CPU密集型或I/O阻塞代码,有效提升应用性能与用户体验。

weixin_29197699的博客 372

Python赋能,洞见先机:构建基于异步爬虫与流处理的实时舆情监控系统

我们将从核心概念入手,逐步搭建一个集。.option("es.resource", "public-opinion-%s" % time.strftime("%Y-%m-%d")) \ # 按日期分索引。| 数据采集层 |----->| 消息队列层 |----->| 流处理与分析层 |----->| 存储与可视化层 |:使用Spark Streaming的状态操作或Flink的CEP库,检测更复杂的模式,如“某关键词的负面舆情在1小时内激增500%”。

2201_76125261的博客 433

clickhouse join_干货 | ClickHouse在携程数仓实践

作者简介小琴,携程高级数据经理,负责酒店BI、数仓工作,专注于大数据应用领域多年。一、背景随着时间推移和业务的快速发展,携程酒店数据累积越来越多。目前流量日数据在3T左右,再加上各种订单、价、量、态等数据更是庞大。现有Hive(Spark引擎)执行速度虽然相对较快,但在国际化发展背景下,一些海外业务由于时差问题,数据需要比国内提前数小时完成,性能提升迫在眉睫。2020年初,我们开始研究...

weixin_39630410的博客 555

习题加餐4. 冒险者工会

这个问题通过贪心算法解决,展示了贪心算法在解决一些优化问题中的强大能力。关键在于如何识别贪心选择的性质,并通过数学证明确保这种方法能够达到全局最优解。通过对问题的深入理解和逻辑推理,我们可以设计出有效的算法来解决问题,同时也需要注意代码实现中的细节,如排序和双指针的使用,以确保算法的效率和正确性。贪心算法的应用这个问题展示了贪心算法在实际问题中的应用。贪心算法通过在每一步选择当前最优的解决方案,期望最终达到全局最优解。该问题中,每次选择能力最接近但足以完成最难任务的冒险者,就是贪心选择的体现。

tang7mj的博客 1349

Memory Overcommit

Memory Overcommit 1.什么是OverCommit Memory? Memory Overcommit:操作系统承诺给进程内存大小超过了实际可用的内存。一个保守的操作系统不会允许memory overcommit,有多少就分配多少,再申请就没有了,这其实有些浪费内存,因为进程实际使用到的内存往往比申请的内存要少,比如某个进程malloc()了200MB内存,但实际上只用到了100MB,按照UNIX/Linux的算法,物理内存页的分配发生在使用的瞬间,而不是在申请的瞬间,也就是说未用到的100

wll1228的博客 920

基于BEV(鸟瞰图)的3D检测:PointPillars与CenterPoint

基于BEV(鸟瞰图)的3D检测:PointPillars与CenterPoint​ ,人工智能,计算机视觉,大模型,AI,本文围绕基于BEV的3D检测,解析了PointPillars与CenterPoint两种算法。PointPillars用点柱特征编码网络处理点云,通过2D卷积网络提取特征,检测头为解耦头;CenterPoint将三维物体表为点,分两阶段检测,先找中心点及属性,再细化预测。两者都可借特定骨干网生成BEV特征图且基于BEV检测,但检测头设计和物体表示方式不同。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 27万+

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

趣头条基于ClickHouse玩转每天1000亿数据量

本文根据dbaplus社群第199期线上分享整理而成,文末还有直播回放~王海胜趣头条数据中心大数据开发工程师8年互联网工作经验,曾在eBay、唯品会、趣头条等公司从事大数据开发相关工作,...

杨建荣的学习笔记 4230

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Windows系统内存计数器理解解析

为什么80%的码农都做不了架构师?>>> ...

weixin_34056162的博客 289

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

ClickHouse性能优化

列式存储是一种数据库存储技术,它将数据按列而不是按行存储。这意味着每一列的数据都存储在一起,而不是每一行的数据存储在一起。这种存储方式对于联机分析处理(OLAP)非常有用,因为它可以避免读取不必要的列,从而避免昂贵的磁盘读取操作。此外,将同一列的不同值存储在一起通常会导致更好的压缩比率(与行式系统相比),因为在实际数据中,相邻行的同一列通常具有相同或不太多的不同值。在ClickHouse中,主键和索引的定义对查询性能有很大影响。你可以在创建表时使用`CREATE TABLE`语句来定义主键和索引。

lang830349821的博客 2713

干货 | 携程ClickHouse日志分析实践

作者简介Gavin Zhu,携程软件技术专家,负责监控系统运维开发、ES系统运维及Clickhouse技术应用推广及运维工作。ElasticSearch是一种基于Lucene的分布式全...

携程技术 9480

clickhouse 关联查询_从携程性能测试case中重新认识clickhouse

测试开始之前我们先看结果:携程的case:clickhouse 版本:18.12.13服务器配置:参数配置CPU40c内存128g硬盘SSD虚拟内存禁用数据:表数据量A1000wB2000wC6000wD2.4亿测试场景:case时间A + B +C 三表关联聚合查询190msB + D 关联聚合查询390msA + B +D 三表关联聚合查询640ms根据携程给的一份查询统计数据来看他们基于cl...

weixin_31140863的博客 507

ClickHouse实时数仓:流批一体数据处理架构

你是否还在为实时数据处理与批量数据分析难以兼顾而困扰?是否在流处理系统与批处理平台间重复构建数据链路?ClickHouse® 作为开源的大数据分析型数据库管理系统,通过流批一体架构设计,让你无需在实时性与分析深度间妥协。本文将详解ClickHouse如何实现流批统一处理,从架构设计到实操案例,帮助你构建高效数据平台。 ## 核心架构:流批一体的技术基石 ClickHouse的流批一体能力源于其...

gitblog_00105的博客 1261

数据仓库之ClickHouse

这种列式存储的特点使得ClickHouse在查询时可以只读取和处理所需的列数据,减少了不必要的数据读取和处理开销,提高了查询性能。你可以使用多种方式将数据加载到ClickHouse中,如使用ClickHouse提供的命令行工具、使用ClickHouse的客户端驱动程序编写自定义的数据导入脚本,或者使用ETL工具等。它可以处理海量的数据,并提供快速的查询和聚合功能,以支持复杂的数据分析任务。ClickHouse提供了近实时的数据处理和查询能力,可以在数据不断写入时进行并行的数据分析和查询操作。

CherryXieのblog 1244

深入理解 ClickHouse 的性能调优与最佳实践

ClickHouse是一款由 Yandex 开发的开源列式数据库,专为在线分析处理(OLAP)场景设计。它以极高的查询性能著称,尤其适用于大规模数据的快速聚合和分析。自发布以来,ClickHouse 在多个行业中得到了广泛应用,例如日志分析、监控系统、用户行为分析、广告监控等。ClickHouse 的核心优势在于其列式存储架构高效的数据压缩、以及分布式处理能力。这些特性使得它能够在处理 TB 甚至 PB 级别的大数据时,依然保持快速的响应时间。

hello.reader 3734

【最佳实践】携程ClickHouse日志分析实践

ElasticSearch是一种基于Lucene的分布式全文搜索引擎,携程用ES处理日志,目前服务器规模500+,日均日志接入量大约200TB。随着日志量不断增加,一些问题逐渐暴露出来:一方面ES服务器越来越多,投入的成本越来越高;另一方面用户的满意度不高,日志写入延迟、查询慢甚至查不出来的问题一直困扰着用户;而从运维人员的角度看,ES的运维成本较高,运维的压力越来越大。 1.为什么选择ClickHouse ClickHouse是一款高性能列式分布式数据库管理系统,我们对ClickHouse进行了测试,

天天新知 2782

【最佳实践】ClickHouse在携程酒店数仓的实践

一、背景 随着时间推移和业务的快速发展,携程酒店数据累积越来越多。目前流量日数据在3T左右,再加上各种订单、价、量、态等数据更是庞大。现有Hive(Spark引擎)执行速度虽然相对较快,但在国际化发展背景下,一些海外业务由于时差问题,数据需要比国内提前数小时完成,性能提升迫在眉睫。2020年初,我们开始研究ClickHouse在数据仓库领域应用。 本文将从技术方案选型、集成开发环境封装、ClickHouse代码优化技巧、异常问题处理、服务器故障处理五个方面分享ClickHouse实践,希望给关注同样问题

天天新知 4519

用TensorFlow预测纽约市AirBnB租赁价格

作者|TIMOTHY102 编译|VK 来源|Analytics Vidhya 介绍 Airbnb是一个在线市场,允许人们将自己的房产或空余房间出租给客人。每预订3位客人,收取12%和6%的佣金。 该公司自2009年成立以来,已从每年帮助2.1万名客人找到住处,发展到每年帮助600万人度假,目前在90个不同国家的34000个城市列出了惊人的80万套房产。 在本文中,我将使用Kaggle-newyorkcityairbnb开放数据集,尝试用TensorFlow建立一个神经网络模型来进行预测。 目标是建立一个合

TensorFlowNews 1243
上一篇: 干货 | 携程如何基于ARIMA时序分析做业务量的预测
下一篇: 干货 | IAST安全测试如何防止数据污染
携程技术
博客等级 码龄10年 3715粉丝 324原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值