大数据之Spark Streaming调优

网约车大数据分析实战:基于Spark的数据处理、建模与性能调优 大数据处理的核心在于如何高效、可靠地从海量数据中提取价值。Apache Spark作为主流的分布式计算框架,凭借其内存计算、批流一体和丰富的生态,成为处理复杂业务场景的首选。其技术价值在于能够将数据处理的性能提升数个量级,同时通过SQL、DataFrame等高级API降低开发门槛。在应用场景上,Spark尤其适合处理像网约车这类数据规模大、实时性要求高、分析维度多的业务,例如进行供需分析、用户画像和需求预测。本文以网约车大数据分析项目为例,深入剖析了如何利用Spark构建从数据采集、实时处理、ETL清洗到机 阅读详情

减少批数据的执行时间

在Spark中有几个优化可以减少批处理的时间:
① 数据接收的并行水平

通过网络(如kafka,flume,socket等)接收数据需要这些数据反序列化并被保存到Spark中。如果数据接收成为系统的瓶颈,就要考虑并行地接收数据。注意,每个输入DStream创建一个receiver(运行在worker机器上)接收单个数据流。创建多个输入DStream并配置它们可以从源中接收不同分区的数据流,从而实现多数据流接收。例如,接收两个topic数据的单个输入DStream可以被切分为两个kafka输入流,每个接收一个topic。这将在两个worker上运行两个receiver,因此允许数据并行接收,提高整体的吞吐量。多个DStream可以被合并生成单个DStream,这样运用在单个输入DStream的transformation操作可以运用在合并的DStream上
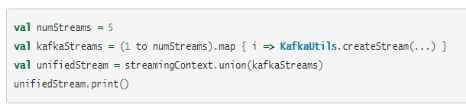
在这里插入图片描述
② 数据处理的并行水平

如果运行在计算stage上的并发任务数不足够大,就不会充分利用集群的资源。默认的并发任务数通过配置属性来确定spark.default.parallelism。

③ 数据序列化

可以通过改变序列化格式来减少数据序列化的开销。在流式传输的情况下,有两种类型的数据会被序列化

  • 输入数据
  • 由流操作生成的持久RDD
    在上述两种情况下,使用Kryo序列化格式可以减少CPU和内存开销

kryo
spark 支持使用kryo序列化类库来进行序列化
比java序列化机制更快,且占用数据空间更小,比Java序列化数据占用空间小10倍。

如何使用kryo序列化机制
(1)设置spark conf
bin/spark-submit will also read configuration options from conf/spark-defaults.conf, in which each line consists of a key and a value separated by whitespace. For example:

spark.master spark://5.6.7.8:7077
spark.executor.memory 4g
spark.eventLog.enabled true
spark.serializer org.apache.spark.serializer.KryoSerializer

(2)使用kryo时,要求需要序列化的类,提前进行注册,以获得高性能。
conf.registerKryoClasses(Array(classOf[String],classOf[Student],classOf[Integer]))

kryo类库的优化

(1)优化缓存大小
如果注册的序列化的自定义类型,本身特别大,比如包含了超过100个字段。就会导致序列化的对象过大。
此时需要对kryo本身进行优化。因为kryo本身内部缓存可能不能存放这么大的class对象。
需要设置:
spark.kryoserializer.buffer.max 64m 将其调大

Maximum allowable size of Kryo serialization buffer.
This must be larger than any object you attempt to serialize.
Increase this if you get a “buffer limit exceeded” exception inside Kryo.

(2)预先注册自定义类型
conf.registerKryoClasses(Array(classOf[String],classOf[Student],classOf[Integer]))
推荐预先注册要序列化的自定义类型。

设置正确的批容量

为了Spark Streaming应用程序能够在集群中稳定运行,系统应该能够以足够的速度处理接收的数据(即处理速度应该大于或等于接收数据的速度)。这可以通过流的网络UI观察得到。批处理时间应该小于批间隔时间。

根据流计算的性质,批间隔时间可能显著的影响数据处理速率,这个速率可以通过应用程序维持。可以考虑WordCountNetwork这个例子,对于一个特定的数据处理速率,系统可能可以每2秒打印一次单词计数(批间隔时间为2秒),但无法每500毫秒打印一次单词计数。所以,为了在生产环境中维持期望的数据处理速率,就应该设置合适的批间隔时间(即批数据的容量)。

找出正确的批容量的一个好的办法是用一个保守的批间隔时间(5-10,秒)和低数据速率来测试你的应用程序。

内存调优

它们可以减少Spark Streaming应用程序垃圾回收的相关暂停,获得更稳定的批处理时间。

  • Default persistence level of DStreams:和RDDs不同的是,默认的持久化级别是序列化数据到内存中(DStream是StorageLevel.MEMORY_ONLY_SER,RDD是StorageLevel.MEMORY_ONLY)。即使保存数据为序列化形态会增加序列化/反序列化的开销,但是可以明显的减少垃圾回收的暂停

  • Clearing persistent RDDs:默认情况下,通过Spark内置策略(LUR),Spark Streaming生成的持久化RDD将会从内存中清理掉。如果spark.cleaner.ttl已经设置了,比这个时间存在更老的持久化RDD将会被定时的清理掉。正如前面提到的那样,这个值需要根据Spark Streaming应用程序的操作小心设置。然而,可以设置配置选项spark.streaming.unpersist为true来更智能的去持久化(unpersist)RDD。这个配置使系统找出那些不需要经常保有的RDD,然后去持久化它们。这可以减少Spark RDD的内存使用,也可能改善垃圾回收的行为

  • Concurrent garbage collector:使用并发的标记-清除垃圾回收可以进一步减少垃圾回收的暂停时间。尽管并发的垃圾回收会减少系统的整体吞吐量,但是仍然推荐使用它以获得更稳定的批处理时间


大数据面试全面重点讲解课程 课程目录 1、大数据面试导学 2、课程目录 3、HDFS架构详解 4、图解HDFS核心组件的职责 5、图解HDFS写数据流程 6、图解HDFS读数据过程 7、HDFS HA架构 8、彩蛋之HA真的有用吗 9、为什么会有小文件 10、小文件给Hadoop集群带来的瓶颈问题 11、大数据学习方法论的思考 12、课程目录 13、业界常见SQL on Hadoop框架概述 14、行式存储vs列式存储 15... 阅读详情

相关推荐

【Spark 实战系列】sparkstreaming 任务出现堆积如何优化?(流量突然大增资源不够怎么办?)

在日常的生产中,什么情况下会出现数据堆积呢?

JasonLee实时计算 1326

SparkStreaming性能调优

前言: 前方高能预警,因为都是文字,可能会比较枯燥,主要是从cpu以及内存两大方面来介绍的,希望大家能耐心一些看看,可能对大家会有所帮助哈~ 一、设置合理的cpu资源数 很多情况下Streaming程序需要的内存不是很多,但是需要的CPU要很多。在Streaming程序中,CPU资源的使用可以分为两大类: 1)用于接收数据; 2)用于处理数据。 我们需要设置足够的CPU资源,使得有足够的CPU资源...

墨殇 2887

大数据Spark “蘑菇云”行动第77课:Spark Streaming性能调优思考和实践方法,发现磁盘空间没有了,怎么办

大数据Spark “蘑菇云”行动第77课:Spark Streaming性能调优思考和实践方法 Spark使用一段时间后,发现磁盘空间没有了,尤其是运行SparkStreaming Spark streaming在不断的写日志,日志将磁盘撑满了。无论磁盘空间多大,都会撑破的。有时运行一个晚上,有时运行一个上午,磁盘写满了。 1、配置log最大的保存文件大小!!最多保存多少文件! 2、配置每

大模型与Agent智能体 1316

sparkstreaming优化

一、合理的Kafka拉取量:设置Spark Streaming最大数据接收率 - 如果运行Streaming应用程序的资源不是很多,数据处理能力跟不上接收数据的速率,可以为应用程序设置一个每秒最大接收记录数进行限制。对于Receiver模式的应用,设置spark.streaming.receiver.maxRate,对于Direct Kafka模式,设置spark.streaming.kafka.

gongpulin的博客 1311

大数据教育平台数仓实时计算实现 附安装包与脚本

数据倾斜为在shuffle过程中,必须将各个节点上相同的key的数据拉取到某节点的一个task来进行,此时如果某个key对应的数据量特别大的话,就会发生数据倾,某个task耗时非常大,那么一个stage的耗时由最慢的task决定,从而导致整个Spark Streaming任务运行非常缓慢。当设置此参数后,Spark Streaming程序在接收到kill命令时,不会立马结束程序,Spark会在JVM关闭时正常关闭Spark Streaming,而不是是立马关闭,即保证当前数据处理完后再关闭。

悦分享 1545

基于Spark的外卖大数据分析平台毕设实战项目

本文还有配套的精品资源,点击获取 简介:本项目面向计算机专业毕业设计与课程实践,构建了一个完整的外卖行业大数据分析系统,采用Apache Spark作为核心计算引擎,涵盖数据采集、清洗、存储、批处理、实时流分析及机器学习建模全流程。项目深度融合Spark核心组件(RDD、DataFrame、Spark SQL、Spark Streaming、MLlib),结合真实外卖业务场景(如订单分析、用户行为挖掘、商家画像、销量预测等),提供可运行代码与完整开发文档,助力学生掌握大数据平台搭建、性能优化与业

weixin_30299319的博客 318

【大数据】Spark性能优化和故障处理

第一章Spark性能调优 1.1常规性能调优 1.1.1常规性能调优一:最优资源配置 Spark性能调优的第一步,就是为任务分配更多的资源,在一定范围内,增加资源的分配与性能的提升是成正比的,实现了最优的资源配置后,在此基础上再考虑进行后面论述的性能调优策略。 资源的分配在使用脚本提交Spark任务时进行指定,标准的Spark任务提交脚本如代码清单2-1所示: 代码清单2-...

weixin_34320159的博客 676

保姆级教程:用GD32F470的EXMC Bank0 Region0与FPGA实现16位并行通信(附完整代码)

本文详细介绍了如何利用GD32F470的EXMC Bank0 Region0与FPGA实现16位并行通信,涵盖硬件连接、寄存器配置、时序优化及FPGA接口设计等关键步骤。通过实例代码和调试技巧,帮助开发者快速掌握高效数据交互技术,提升嵌入式系统设计能力。

weixin_26918763的博客 226

Spark组件(sql,streaming)及spark优化

appName("udf自定义函数")//当你配置了hdfs等一些配置文件,那么默认读取路径是hadoop的,否则是本地.load("/bigdata30/students.csv")//读取路径是hadoop// df1.select($"id",$"name",concat(expr("'数加:'"),$"name") as "new_name").show()// concat(expr("'数加:'"),$"name")//对姓名做拼接。

2403_83630621的博客 2024

UOS忘记密码别慌!用LiveCD工具5分钟搞定,附命令行救援模式详细步骤

本文详细介绍了UOS系统密码遗忘时的两种解决方案:图形化LiveCD工具和命令行救援模式。针对普通用户,LiveCD工具提供5分钟快速重置密码的便捷操作;而技术人员可通过命令行深度解析系统分区挂载与密码修改流程。文章还包含安全加固建议,帮助用户预防类似问题发生。

weixin_27032989的博客 591

MathType 7.4保姆级安装教程:从下载到Word/WPS完美加载(附常见问题解决)

本文提供MathType 7.4的详细安装教程,涵盖从下载到Word/WPS完美加载的全过程,并附常见问题解决方案。特别针对科研写作中的公式编辑需求,介绍如何避免安装陷阱、配置Office集成及高效排版技巧,帮助用户快速掌握这一公式编辑神器。

weixin_29200741的博客 4360

大数据(5.3)Spark Streaming核弹级调优:从数据丢失血案到万亿级实时处理(附毫秒级延迟调优手册+容灾演练全流程)

某金融支付平台因Spark Streaming窗口操作配置错误,导致‌双11期间20亿交易流水5%数据丢失‌,实时风控失效造成千万级损失。本文基于日均处理‌12万亿条实时数据‌的生产实战,揭秘Spark Streaming的‌八大致命深坑‌、‌Checkpoint黑洞陷阱‌,提供‌军工级调优模板‌、‌亚秒级延迟优化方案‌,并开源‌StreamGuard实时容灾系统‌。

优快云博客专家,领域包括但不限于:AI、大数据、Python、架构师,有合作、课程、问题、疑惑请私信博主 1250

Gradle进阶:4:结合Sonarqube进行代码审查

作为代码质量检查的流行工具,比如Sonarqube能够检查代码的“七宗罪”,跟代码结合起来能够更好地提高代码的质量,这篇文章将会介绍如何结合gradle和sonarqube对代码质量与测试覆盖率进行分析。

知行合一 止于至善 1万+

2025大数据实战突围:零基础7天通关Hadoop与Spark核心应用

你是否还在为大数据项目无从下手而焦虑?面对Hadoop生态复杂组件望而却步?本文将通过**场景化实战**,带您从零构建分布式数据处理系统,7天后即可独立完成企业级数据分析任务。读完本文你将掌握:HDFS分布式存储架构设计、MapReduce并行计算模型应用、Spark Streaming实时数据处理全流程,以及10个工业级调优技巧。 ## 项目准备与环境搭建 ### 开发环境快速部署 首先通过...

gitblog_00552的博客 1191

AAC编解码器在实时通信中的性能对比与应用选择

本文深入分析了AAC编解码器在实时通信中的性能优化,重点对比了faac、faad2与fdk-aac三大开源方案在WebRTC场景下的表现。通过实测数据揭示其在延迟、音质和资源消耗等关键指标的差异,并提供场景化选型建议与调优技巧,帮助开发者提升实时音视频通信质量。

weixin_29210727的博客 389

半导体工艺仿真:离子注入工艺仿真_(8).损伤和缺陷仿真

离子注入工艺在半导体制造中是一个重要的步骤,用于在半导体材料中引入特定的掺杂剂。然而,离子注入过程中不可避免地会产生损伤和缺陷,这些损伤和缺陷会直接影响器件的性能和可靠性。因此,对离子注入工艺中的损伤和缺陷进行仿真研究是必不可少的。本节将详细介绍如何使用仿真软件对离子注入过程中的损伤和缺陷进行建模和分析。

2401_87715305的博客 1339

微服务架构下的数据处理终极指南:探索awesome-bigdata框架的核心能力

在当今数据驱动的时代,微服务架构已成为构建灵活、可扩展系统的首选方案。而**awesome-bigdata**作为一个精心策划的开源项目,汇集了海量分布式数据处理框架、工具和资源,为微服务环境下的大数据处理提供了完整的技术栈支持。本文将带你深入了解这个项目如何解决微服务架构中的数据挑战,以及如何快速上手使用这些强大的工具。 ## 为什么选择awesome-bigdata?微服务数据处理的核心痛点

gitblog_01225的博客 598

南京理工大学计算机预推免面试(双非重点关注)

南京理工大学总体来说对双非学校比较友好,上岸率比较高,而且面试形式是线上,在预推免的过程中,可以作为重点关注的学校,但是一定要注意南理报名截止的时间,部分学校可能保研名额公示的比较晚,对于保研边缘人来说很可能会错过,我的建议是,即使不确定能否拿到保研名额,先查一下截止时间,先在系统上报名!!一旦拿到了offer,就是铁的,保底专硕,而且有很大的技巧性,一定要认真看哈!!!每个人的情况可能都不一样,如果有需要帮忙可以私我~~~

D1379951481的博客 2020

Spark学习路线

准备 编程语言介绍 scala、java、python、R都有spark对应的api,但如果想深入理解spark还是需要学习scala的。(scala中隐式转换特性可以很大程度提高spark开发效率); Scala(FP+OP面向对象和函数式编程混合语言)优势在于函数式编程; scala是在java之外套了一层壳,编译之后还是.class,运行在jvm,所以java语言在学习大数据组建中也特别重要...

JINGXI的博客 2864

华为OD机试2025C卷-双十一最大花费金额[100分](Java_Python3_C++_C语言_JsNode_Go)实现100%通过率

双十一最大花费金额 - 动态规划解法 摘要:本文介绍了华为OD机试中"双十一最大花费金额"问题的动态规划解法。该问题要求在给定N件商品价格和优惠券面额X的情况下,选择若干商品使总花费不超过X且尽可能大。核心解法采用布尔型动态规划数组,记录每个金额是否可被拼出。算法时间复杂度为O(N*X),空间复杂度为O(X)。通过倒序遍历避免重复选择同一商品,最后从X向下查找第一个可达金额作为答案。文中提供了C++和Java的实现代码,并解释了与经典0-1背包问题的关系。 关键点: 问题本质是0-1背包/子集和问题的变体

2503_91057718的博客 46

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Spark在环保大数据中的高效应用与实践

分布式计算框架Spark凭借其内存计算优势,在环保大数据领域展现出显著的技术价值。通过弹性分布式数据集(RDD)和DAG执行引擎,Spark能高效处理时序数据和空间拓扑关系,相比传统MapReduce可实现10-100倍的性能提升。在环保监测场景中,Spark Structured Streaming支持实时数据流处理,结合MLlib机器学习库可构建空气质量预测模型,而GraphX组件则适用于污染扩散模拟。典型应用包括:基于滑动窗口计算的PM2.5移动平均分析、使用GeoSpark进行空间范围查询等。通过合

benben 371

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

spark streaming + kafka实战

1.接收数据 用spark streaming流式处理kafka中的数据,第一步当然是先把数据接收过来,转换为spark streaming中的数据结构Dstream。接收数据的方式有两种:1.利用Receiver接收数据,2.直接从kafka读取数据。 1.1基于Receiver的方式 这种方式利用接收器(Receiver)来接收kafka中的数据,其最基本是使用Kafka高阶用户API接...

Luis的博客 665

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

大数据Spark 面经

所以兄弟们可以看到,说白了,我们进行spark的编程的时候,就是基于RDD的,然后和算子一起,把RDD当作点,这些算子当成边,不就构建成了我们的这个有向无环图(DAG) 嘛;大家可以想想,这个spark的RDD 也是基于内存的计算,如果一个任务一直这样计算下去,比如算到90%的时候,机器突然宕机了,任务全部失败了,是不是又得重新计算,所以我们就要进行个中间数据的备份嘛,比如算完了一个stage的数据,先把它存储到外部系统,这样就不怕任务突然中断了;这两个算子分区内的逻辑和分区间的逻辑都是一致的;

weixin_41188932的博客 1084

实战指南:构建Flume到Spark Streaming的实时数据管道

本文详细介绍了如何构建Flume到Spark Streaming的实时数据管道,涵盖环境配置、数据采集、Spark集成及性能调优等关键步骤。通过实战案例分享,帮助开发者高效处理TB级实时数据,特别适合电商、金融等需要实时分析的场景。重点解析了Flume与Spark Streaming的版本兼容性、Avro数据传输优化等核心技术难点。

weixin_28221501的博客 173

Kafka - 在大数据场景中的应用:与Hadoop、Spark集成

本文探讨了Apache Kafka与Hadoop、Spark在大数据生态系统中的集成应用。Kafka作为数据总线,能够高效连接数据源和处理引擎,实现实时数据流处理与批处理的协同工作。文章详细介绍了Kafka与Hadoop通过Kafka Connect HDFS Connector的集成方式,包括配置示例和实际应用场景,如日志分析和数据湖构建。同时阐述了Kafka与Spark Streaming的集成方案,展示如何构建端到端的流处理管道。通过具体代码示例,演示了从数据生产到存储分析的完整流程,为构建高效大数据

千淘万漉虽辛苦,吹尽狂沙始到金 2万+

Java工具18-Java构建大数据应用:使用Apache Spark

Apache Spark是一个开源的分布式计算框架,旨在提供高效、通用的大数据处理能力。它最初由加州大学伯克利分校的AMPLab开发,并于2010年开源,2013年成为Apache软件基金会的顶级项目。Spark的核心设计理念是“速度、易用性和通用性”。与传统的批处理框架如Hadoop MapReduce相比,Spark最大的优势在于其基于内存的计算模型。Spark将中间计算结果存储在内存中,避免了频繁的磁盘I/O,从而显著提升了处理速度。

千淘万漉虽辛苦,吹尽狂沙始到金 2万+
上一篇: 大数据之Spark Streaming(二)
下一篇: Bigdata_Elasticsearch
晟翊zzZ
博客等级 码龄7年 4粉丝 52原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
