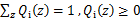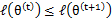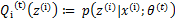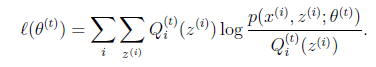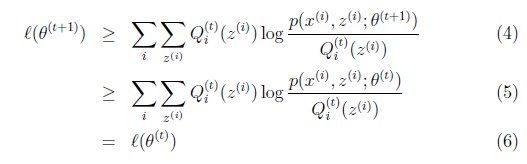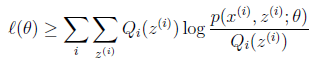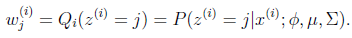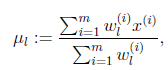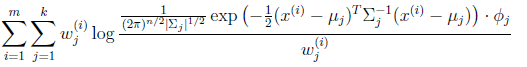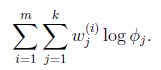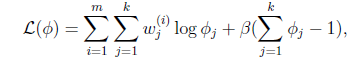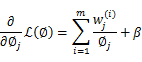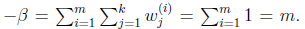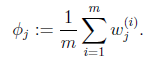EM 期望最大化算法

【大道至简】机器学习算法之EM算法(Expectation Maximization Algorithm)详解(附代码)---通俗理解EM算法。 通过上面的分析,我们终于可以总结一下EM算法啦!总的来说,EM算法分为E步和M步:(1)给参数θ即第0步赋初值;(2)如果是第一轮迭代,那么令θ=来计算Q函数;如果是>1轮迭代,则θ的值由上一次M步计算出的θ值决定。由于E步时θ已知,所以只需要计算Q,公式如下:也就是给定θ和已知的观测数据x的条件下,求一下隐变量z的条件概率。(3)根据E步计算出来的Q,按如下公式计算θ:也就是固定Q(z也固定)和已知的观测数据x,算一下θ。(4)重复(3)和(4)直至收敛。 阅读详情

(EM算法)The EM Algorithm

      EM是我一直想深入学习的算法之一,第一次听说是在NLP课中的HMM那一节,为了解决HMM的参数估计问题,使用了EM算法。在之后的MT中的词对齐中也用到了。在Mitchell的书中也提到EM可以用于贝叶斯网络中。

下面主要介绍EM的整个推导过程。

1. Jensen不等式

      回顾优化理论中的一些概念。设f是定义域为实数的函数,如果对于所有的实数x,clip_image002,那么f是凸函数。当x是向量时,如果其hessian矩阵H是半正定的(clip_image004),那么f是凸函数。如果clip_image006或者clip_image008,那么称f是严格凸函数。

      Jensen不等式表述如下:

      如果f是凸函数,X是随机变量,那么

      clip_image010

      特别地,如果f是严格凸函数,那么clip_image012当且仅当clip_image014,也就是说X是常量。

      这里我们将clip_image016简写为clip_image018。

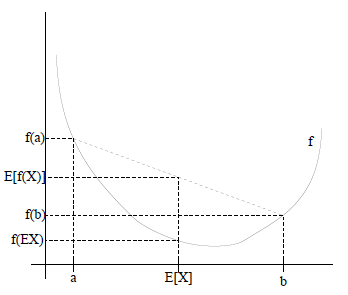
      如果用图表示会很清晰:

      clip_image019

      图中,实线f是凸函数,X是随机变量,有0.5的概率是a,有0.5的概率是b。(就像掷硬币一样)。X的期望值就是a和b的中值了,图中可以看到clip_image010[1]成立。
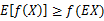
      当f是(严格)凹函数当且仅当-f是(严格)凸函数。

      Jensen不等式应用于凹函数时,不等号方向反向,也就是clip_image021。
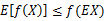
2. EM算法

      给定的训练样本是clip_image023,样例间独立,我们想找到每个样例隐含的类别z,能使得p(x,z)最大。p(x,z)的最大似然估计如下:

      clip_image024

      第一步是对极大似然取对数,第二步是对每个样例的每个可能类别z求联合分布概率和。但是直接求clip_image026一般比较困难,因为有隐藏变量z存在,但是一般确定了z后,求解就容易了。

      EM是一种解决存在隐含变量优化问题的有效方法。竟然不能直接最大化clip_image028,我们可以不断地建立clip_image030的下界(E步),然后优化下界(M步)。这句话比较抽象,看下面的。

      对于每一个样例i,让clip_image032表示该样例隐含变量z的某种分布,clip_image032[1]满足的条件是clip_image034。(如果z是连续性的,那么clip_image032[2]是概率密度函数,需要将求和符号换做积分符号)。比如要将班上学生聚类,假设隐藏变量z是身高,那么就是连续的高斯分布。如果按照隐藏变量是男女,那么就是伯努利分布了。

可以由前面阐述的内容得到下面的公式:

      clip_image035

      (1)到(2)比较直接,就是分子分母同乘以一个相等的函数。(2)到(3)利用了Jensen不等式,考虑到clip_image037是凹函数(二阶导数小于0),而且

      clip_image038

      就是clip_image039的期望(回想期望公式中的Lazy Statistician规则)

      设Y是随机变量X的函数clip_image041(g是连续函数),那么

      (1) X是离散型随机变量,它的分布律为clip_image043,k=1,2,…。若clip_image045绝对收敛,则有

      clip_image047

      (2) X是连续型随机变量,它的概率密度为clip_image049,若clip_image051绝对收敛,则有

      clip_image053

      对应于上述问题,Y是clip_image039[1],X是clip_image055,clip_image057是clip_image059,g是clip_image055[1]到clip_image039[2]的映射。这样解释了式子(2)中的期望,再根据凹函数时的Jensen不等式:

      clip_image060

可以得到(3)。

      这个过程可以看作是对clip_image028[1]求了下界。对于clip_image032[3]的选择,有多种可能,那种更好的?假设clip_image026[1]已经给定,那么clip_image028[2]的值就决定于clip_image057[1]和clip_image062了。我们可以通过调整这两个概率使下界不断上升,以逼近clip_image028[3]的真实值,那么什么时候算是调整好了呢?当不等式变成等式时,说明我们调整后的概率能够等价于clip_image028[4]了。按照这个思路,我们要找到等式成立的条件。根据Jensen不等式,要想让等式成立,需要让随机变量变成常数值,这里得到:

      clip_image063

      c为常数,不依赖于clip_image065。对此式子做进一步推导,我们知道clip_image067,那么也就有clip_image069,(多个等式分子分母相加不变,这个认为每个样例的两个概率比值都是c),那么有下式:

      clip_image070

      至此,我们推出了在固定其他参数clip_image026[2]后,clip_image072的计算公式就是后验概率,解决了clip_image072[1]如何选择的问题。这一步就是E步,建立clip_image028[5]的下界。接下来的M步,就是在给定clip_image072[2]后,调整clip_image026[3],去极大化clip_image028[6]的下界(在固定clip_image072[3]后,下界还可以调整的更大)。那么一般的EM算法的步骤如下:

循环重复直到收敛 {

      (E步)对于每一个i,计算

                  clip_image074

      (M步)计算

                  clip_image075

      那么究竟怎么确保EM收敛?假定clip_image077和clip_image079是EM第t次和t+1次迭代后的结果。如果我们证明了clip_image081,也就是说极大似然估计单调增加,那么最终我们会到达最大似然估计的最大值。下面来证明,选定clip_image077[1]后,我们得到E步

      clip_image083

      这一步保证了在给定clip_image077[2]时,Jensen不等式中的等式成立,也就是

      clip_image084

      然后进行M步,固定clip_image086,并将clip_image088视作变量,对上面的clip_image090求导后,得到clip_image092,这样经过一些推导会有以下式子成立:

      clip_image093

      解释第(4)步,得到clip_image092[1]时,只是最大化clip_image090[1],也就是clip_image095的下界,而没有使等式成立,等式成立只有是在固定clip_image026[4],并按E步得到clip_image097时才能成立。

      况且根据我们前面得到的下式,对于所有的clip_image097[1]和clip_image026[5]都成立

      clip_image098

      第(5)步利用了M步的定义,M步就是将clip_image088[1]调整到clip_image100,使得下界最大化。因此(5)成立,(6)是之前的等式结果。

      这样就证明了clip_image102会单调增加。一种收敛方法是clip_image102[1]不再变化,还有一种就是变化幅度很小。

      再次解释一下(4)、(5)、(6)。首先(4)对所有的参数都满足,而其等式成立条件只是在固定clip_image026[6],并调整好Q时成立,而第(4)步只是固定Q,调整clip_image026[7],不能保证等式一定成立。(4)到(5)就是M步的定义,(5)到(6)是前面E步所保证等式成立条件。也就是说E步会将下界拉到与clip_image102[2]一个特定值(这里clip_image088[2])一样的高度,而此时发现下界仍然可以上升,因此经过M步后,下界又被拉升,但达不到与clip_image102[3]另外一个特定值一样的高度,之后E步又将下界拉到与这个特定值一样的高度,重复下去,直到最大值。

      如果我们定义
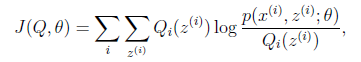
      clip_image103

      从前面的推导中我们知道clip_image105,EM可以看作是J的坐标上升法,E步固定clip_image026[8],优化clip_image107,M步固定clip_image107[1]优化clip_image026[9]。

3. 重新审视混合高斯模型

      我们已经知道了EM的精髓和推导过程,再次审视一下混合高斯模型。之前提到的混合高斯模型的参数clip_image109和clip_image111计算公式都是根据很多假定得出的,有些没有说明来由。为了简单,这里在M步只给出clip_image113和clip_image115的推导方法。

E步很简单,按照一般EM公式得到:

      clip_image116

      简单解释就是每个样例i的隐含类别clip_image055[2]为j的概率可以通过后验概率计算得到。

      在M步中,我们需要在固定clip_image072[4]后最大化最大似然估计,也就是

      clip_image118

      这是将clip_image120的k种情况展开后的样子,未知参数clip_image122和clip_image124。

      固定clip_image126和clip_image128,对clip_image130求导得

      clip_image131

      等于0时,得到

      clip_image132

      这就是我们之前模型中的clip_image115[1]的更新公式。

      然后推导clip_image126[1]的更新公式。看之前得到的

      clip_image133

      在clip_image113[1]和clip_image115[2]确定后,分子上面的一串都是常数了,实际上需要优化的公式是:

      clip_image134

      需要知道的是,clip_image126[2]还需要满足一定的约束条件就是clip_image136。

      这个优化问题我们很熟悉了,直接构造拉格朗日乘子。

      clip_image137

      还有一点就是clip_image139,但这一点会在得到的公式里自动满足。

      求导得,

      clip_image141

      等于0,得到

      clip_image142

      也就是说clip_image143再次使用clip_image136[1],得到

      clip_image144

      这样就神奇地得到了clip_image146。

      那么就顺势得到M步中clip_image126[3]的更新公式:

      clip_image147

      clip_image111[1]的推导也类似,不过稍微复杂一些,毕竟是矩阵。结果在之前的混合高斯模型中已经给出。

4. 总结

      如果将样本看作观察值,潜在类别看作是隐藏变量,那么聚类问题也就是参数估计问题,只不过聚类问题中参数分为隐含类别变量和其他参数,这犹如在x-y坐标系中找一个曲线的极值,然而曲线函数不能直接求导,因此什么梯度下降方法就不适用了。但固定一个变量后,另外一个可以通过求导得到,因此可以使用坐标上升法,一次固定一个变量,对另外的求极值,最后逐步逼近极值。对应到EM上,E步估计隐含变量,M步估计其他参数,交替将极值推向最大。EM中还有“硬”指定和“软”指定的概念,“软”指定看似更为合理,但计算量要大,“硬”指定在某些场合如K-means中更为实用(要是保持一个样本点到其他所有中心的概率,就会很麻烦)。

      另外,EM的收敛性证明方法确实很牛,能够利用log的凹函数性质,还能够想到利用创造下界,拉平函数下界,优化下界的方法来逐步逼近极大值。而且每一步迭代都能保证是单调的。最重要的是证明的数学公式非常精妙,硬是分子分母都乘以z的概率变成期望来套上Jensen不等式,前人都是怎么想到的。

      在Mitchell的Machine Learning书中也举了一个EM应用的例子,明白地说就是将班上学生的身高都放在一起,要求聚成两个类。这些身高可以看作是男生身高的高斯分布和女生身高的高斯分布组成。因此变成了如何估计每个样例是男生还是女生,然后在确定男女生情况下,如何估计均值和方差,里面也给出了公式,有兴趣可以参考。


转载自:http://www.cnblogs.com/jerrylead/archive/2011/04/06/2006936.html#2831962

【机器学习】期望最大化(EM)算法 EM算法是一种从不完全数据或有数据丢失的数据集(存在隐变量)中求解概率模型参数的最大似然估计方法。第一步求隐变量的期望(E)第二步求似然函数极大(M)EM算法在一般情况是收敛的,但是不保证收敛到全局最优,即有可能进入局部的最优。应用到的地方:混合高斯HMM模型、隐马尔科夫模型、混合朴素贝叶斯模型等。 阅读详情

相关推荐

EM算法详解

EM算法详解1 摘要2 EM算法简介3 预备知识3.1 极大似然估计3.2 Jenson不等式4 EM详解4.1 问题描述4.2 EM算法推导流程4.3 EM算法流程5. EM算法的收敛性思考5.1 对EM算法的初始化研究5.2 EM算法能保证收敛吗?5.3 EM算法能保证收敛到全局最大值吗?6. EM算法的一些思考7. EM算法在非监督学习中的应用 1 摘要 EM算法是最常见的隐变量估计方法,常...

weixin_41838371的博客 1200

如何通俗理解EM算法

如何通俗理解EM算法 前言 了解过EM算法的同学可能知道,EM算法是数据挖掘十大算法,可谓搞机器学习或数据挖掘的基本绕不开,但EM算法又像数据结构里的KMP算法,看似简单但又貌似不是一看就懂,想绕开却绕不开的又爱又恨,可能正在阅读此文的你感同身受。 一直以来,我都坚持一个观点:当你学...

结构之法 算法之道 16万+

EM期望最大化算法

EM(Expectation-Maximization)算法是一种迭代优化算法,通常用于在含有隐变量的概率模型中估计参数。它通过反复执行两个步骤:期望步骤(E步)和最大化步骤(M步),逐步优化模型参数的极大似然估计。 EM工作流程 - 初始化

qq_41476714的博客 1152

EM算法原理详解

http://blog.youkuaiyun.com/pipisorry/article/details/42550815EM算法有很多的应用,最广泛的就是GMM混合高斯模型、聚类、HMM、基于概率的PLSA模型等等。本文详细讲述EM算法的由来、EM算法的实现思路、EM算法解决PLSA和LDA的方法。概述、EM是一种解决存在隐含变量优化问题的有效方法。EM的意思是“Expectation Maximizati

皮皮blog 5万+

期望最大化(EM)算法:从理论到实战全解析

本文深入探讨了期望最大化(EM)算法的原理、数学基础和应用。通过详尽的定义和具体例子,文章阐释了EM算法在高斯混合模型(GMM)中的应用,并通过Python和PyTorch代码实现进行了实战演示。

2401_85325519的博客 1582

期望最大化算法、EM算法及其在Python中的应用

EM算法是一种迭代优化算法,通过交替进行两个步骤:E步(Expectation Step)和M步(Maximization Step),以最大化似然函数。在实际应用中,EM算法被广泛应用于含有隐变量的概率模型的参数估计。通过Python代码示例,我们演示了EM算法在混合高斯模型中的应用,展示了如何使用EM算法对数据进行拟合和预测。接下来,在M步中,我们通过最大化Q函数来更新参数的估计值,即求解θ^(t+1) = argmaxQ(θ|θ^t)。下面我们以混合高斯模型为例,展示EM算法在Python中的应用。

ByteLegend的博客 172

EM(期望最大化)聚类算法详解

参考:https://blog.youkuaiyun.com/eternity1118_/article/details/51516497 一、简介 之前介绍过K-Means聚类,尽管这个算法很常用,但可能会遇到像聚类重叠,或聚类的形状不是圆形等问题。今天来学习一个新的聚类算法,叫EM聚类,这个算法本质上来说跟K-Means很像,但比K-Means全面更深入的描述一个聚类,因为除了利用均值(质心),还有方差(为了得到椭圆聚类),以及权重(聚类的size)。 为了更好地学习EM,先来举个例子:假设我们从一所高.

lemonxiaoxiao的博客 1万+

The EM Algorithm and Extensions:EM算法及其扩展.pdf

The EM Algorithm and Extensions:EM算法及其扩展.pdf

第八讲:期望最大化算法(EM algorithm)

在前面的若干讲义中,我们已经讲过了期望最大化算法(EM algorithm),使用场景是对一个高斯混合模型进行拟合(fitting a mixture of Gaussians)。在本章里面,我们要给出期望最大化算法(EM algorithm)的更广泛应用,并且演示如何应用于一个大系列的具有潜在变量(latent variables)的估计问题(estimation problems)。我们的讨论...

xyk_hust的博客 2167

Unity3D实战:5分钟搞定RTSP监控视频播放(附完整代码)

本文提供了一套在Unity3D中快速集成RTSP监控视频播放的实战方案。通过采用LibVLCSharp for Unity这一成熟稳定的跨平台中间件,开发者可以轻松实现RTSP流的解码与渲染,并附有完整的C#代码示例,帮助用户在5分钟内完成集成,适用于智慧园区、安防监控等3D可视化场景。

weixin_29001655的博客 191

【openEuler容器镜像部署指南】

【代码】【List集合排序 】

weixin_43878094的博客 1111

EM算法(期望最大化)详细推导

版权声明:博主原创文章,转载请注明来源,谢谢合作!!

halxp的博客 1464

华为防火墙双线路配置实战:5分钟搞定主备自动切换(含健康检查避坑指南)

本文详细介绍了华为防火墙双线路配置实战,包括主备自动切换和健康检查机制的优化技巧。通过智能健康检查机制,华为防火墙能实现毫秒级故障自动切换,确保网络高可用性。文章提供了从架构设计到实战配置的全流程指南,并分享了常见配置误区与解决方案,帮助中小企业快速搭建稳定可靠的网络架构。

weixin_30872337的博客 604

期望最大化算法(EM算法)举例加推导详解

极大似然估计 (MLE) 是一种非常有效的参数估计方法,但当分布中有多余参数或数据为截尾或缺失时,其 MLE 的求取是比较困难的。Dempster 等人于 1977 年提出了 EM 算法,它是寻找具有潜变量的概率模型的最大似然解的一种通用方法。其出发点是把求 MLE 的过程分两步走,第一步求期望,以便把多余的部分去掉,第二部分求极大值。............

qq_39645262的博客 1039

GEE进行Theil-Sen Median斜率估计和Mann-Kendall检验

Python实现Theil-Sen Median斜率估计和Mann-Kendall检验// 定义时间范围//NDVI图像集合// 定义每年的开始和结束日期// 加载NDVI数据集,按日期过滤,并计算最大值.max()}));// 计算Sen斜率并剪裁// 可视化Sen斜率Map.addLayer(senSlope.select('slope'), vis, "Sen斜率 ");// MK检验// 创建一个列表,包含年度NDVI图像的list。

qq_44894692的博客 965

Python-Opencv中的膨胀和腐蚀

Python-Opencv中的膨胀和腐蚀 腐蚀和膨胀是对白色部分(高亮部分)而言的,不是黑色部分。 膨胀就是图像中的高亮部分进行膨胀,“邻域扩张”,效果图拥有比原图更大的高亮区域。腐蚀就是原图中高亮部分被腐蚀,“邻域被蚕食”,效果图拥有比原图更小的高亮区域。 1.膨胀 膨胀过程是有一个结构元素或者模板去在原图像素比对,当比对过程中,中心像素位置的值根据其八邻域取或运算,或运算为1就取自己的中心值,...

qq_44262417的博客 1万+

期望最大化算法 EM

本篇文章我们来介绍一种适用范围非常广泛的机器学习算法——期望最大化算法(Expectation Maximization,之后简称EM)。吴军老师在其著作《数学之美》中将其称为“上帝的算法”,因为该算法过程和原理非常简洁易懂,只要我们手头有足量的数据,再定义一个要最大化的目标函数,通过计算机把相关参数训练出来,即可得到想要的模型,非常美妙。 EM算法主要分为两个步骤:E-step(求期望步骤,用来求出当前迭代轮次所要最大化的期望的表达式)以及M-step(最大化期望步骤,通过令偏导为0的形式求出该轮次使得期

thequitesunshine007的博客 568

Claude skill-creator插件深度解析:从创建到优化的完整技能工程化体系

摘要:skill-creator是Anthropic推出的Claude技能开发插件,提供从创建到优化的全流程工程化支持。其核心架构采用渐进式披露机制和多Agent协作模式,包含Grader、Analyzer等专业评估组件。该插件支持自动化评测系统,通过测试用例管理、并行执行和结果聚合实现技能验证;提供迭代优化算法,基于数据驱动改进技能性能。典型应用场景包括标准化技能开发、自动化测试验证和触发优化,显著降低开发门槛并提升技能质量。

虚心若愚 988

高斯混合模型(GMM)与期望最大化算法(EM)

详细解读了EM算法原理以及GMM的优化过程。

生活就像海洋 8427

CloudCompare 和 PCL:点云网格化分析与处理

点云网格化是将点云数据转化为规则网格的过程,其主要思想是将离散的点云投影到一个平面上,然后对该平面进行划分,形成一系列小区域。在点云网格化方面,PCL 提供了各种算法和工具,可以实现高效的点云网格化操作。以上示例代码中,首先加载了输入的点云数据,然后通过设置合适的网格化算法参数,如搜索半径和最大三角形边长等,执行了网格化操作,最后将网格化结果保存到输出文件中。以上示例代码中,首先加载了输入的点云数据,然后通过设置合适的网格化参数,如分辨率等,执行了网格化操作,最后将网格化结果保存到输出文件中。

TechPulseZ的博客 1291

一张图看懂 ABAP CDS 两大子语言:CDS DDL 与 CDS DCL 以及缺席的 DML

ABAP CDS 的核心设计思想围绕语义数据模型(DDL)与数据访问控制(DCL)展开,而非单纯作为SQL查询工具。其DDL通过声明式语法定义业务导向的数据视图,强调模型稳定性与复用性;DCL则将访问控制逻辑下沉到模型层,实现行级权限过滤。ABAP CDS刻意剥离DML功能,交由ABAP SQL处理数据变更,形成清晰的分层架构。这种设计使数据定义、访问控制与应用逻辑解耦,为现代ABAP应用提供更安全、可维护的数据治理方案。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 975

【EM算法】期望最大化算法

【摘要】 EM(Expectation-Maximum)算法也称期望最大化算法,曾入选“数据挖掘十大算法”中,可见EM算法在机器学习、数据挖掘中的影响力。EM算法是最常见的隐变量估计方法,在机器学习中有极为广泛的用途,例如常被用来学习高斯混合模型(Gaussian mixture model,简称GMM)的参数;隐式马尔科夫算法(HMM)、LDA主题模型的变分推断等等。本文就对EM算法的原理做一个详细的总结。 【扩展阅读】数据挖掘中十大算法论文: Wu X, Kumar V, Quinlan J R, et

学渣的博客 2万+

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

EM(Expectation Maximization 期望最大化)算法和GMM算法

EM(Expectation Maximization 期望最大化) 是一种迭代算法,用于含有隐变量的概率模型参数的极大似然估计,或极大后验概率估计。其每次迭代由E、M两步构成。 EM算法是在概率模型中寻找参数最大似然估计或者最大后验估计的算法,其中概率模型依赖于无法观测的隐含变量。 它经过两个步骤交替进行计算: 计算期望(E步),基于现有的模型参数(或者随机初始化的模型)对隐含变量的值进行...

qq_44318499的博客 906

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

高斯混合模型GMM及期望最大化EM算法详解

与假设球形簇的k-means不同,由于协方差分量,gmm可以适应椭球形状。这使得gmm能够捕获更多种类的簇形状。由于使用协方差矩阵和混合系数,可以处理不同大小的聚类,这说明了每个聚类的分布和比例。GMM提供了属于每个簇的每个点的概率(软分配),这可以在理解数据时提供更多信息。可以处理重叠的集群,因为它根据概率而不是硬边界为集群分配数据点。易于解释聚类结果,因为每个聚类都由具有特定参数的高斯分布表示。除了聚类,GMM还可以用于密度估计和异常检测。需要提前指定分量(簇)的数量。

酒酿小圆子呀~ 5883

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

EM (期望最大化) 算法与 GMM (高斯混合模型) 聚类算法公式推导及Python实现

本文介绍了期望最大化(Expectation-Maximization,EM)算法的公式推导,K-Means聚类算法的缺陷及改进策略,K-Means与EM算法的关系,高斯混合模型(Gaussian Mixed Model,GMM)聚类算法的公式推导。

全性保真,不以物累形。 3240

【机器学习】第二章——EM(期望最大化)算法

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 例如:第一章 Python 机器学习入门之pandas的使用 提示:写完文章后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录系列文章目录一、背景介绍二、Jessen不等式EM算法推导过程总结 一、背景介绍 当有数据确实的时候,EM算法能够迭代地做参数估计 两个关键步骤: 1. 期望步(Expectation) 2. 最大化步(Maximization) 可以解决大量实际问题 二、Jessen不等

TommyGong08的博客 875
上一篇: K-means聚类算法
下一篇: HMM 隐马尔科夫模型
crazyhacking
博客等级 码龄15年 299粉丝 148原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值