


文章目录
Mybatis学习
Mybatis介绍:
1 MyBatis 本是apache的一个开源项目ibatis, 2010年这个项目由apache 迁移到了google code,并且改名为MyBatis
2 MyBatis 是一款优秀的持久层框架
3 MyBatis 避免了几乎所有的 JDBC 代码和手动设置参数以及获取结果集的过程
4 Mybatis官方文档 : http://www.mybatis.org/mybatis-3/zh/index.html
5 GitHub : https://github.com/mybatis/mybatis-3
1数据库前期工作
本次练习使用MySQL 8作为数据库:
CREATE DATABASE `mybatisdemo`;
USE `mybatisdemo`;
DROP TABLE IF EXISTS `user`;

CREATE TABLE `user` (
`id` int(20) PRIMARY KEY,
`name` varchar(30) DEFAULT NULL,
`pwd` varchar(30) DEFAULT NULL,
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

INSERT into user(id,name,pwd) values(1,'狂神',123456),(2,'老邓','asdfgh'),(3,'Jack','qwerty');
ps:MySQL Administrator建数据库的时候,表缺省是InnoDB类型。(InnoDB是一种数据库存储引擎)
InnoDB,MyISAM 两种类型的区别:MyISAM类型不支持事务处理等高级处理,而InnoDB类型支持。 MyISAM类型的表强调的是性能,其执行数度比InnoDB类型更快,但是不提供事务支持,而InnoDB提供事务支持,外键等高级数据库功能。
2Mybatis使用示例1
1、导入依赖,设置导出所有描述文件
先在父pom.xml中导入依赖(主要是:mybatis 和 mysql-connector-java )
然后导出所有描述文件(主要是com.kuang.dao下的XxMapper.xml )
<dependencies>
    <dependency>
        <groupId>org.projectlombok</groupId>
        <artifactId>lombok</artifactId>
        <version>1.18.12</version>
        <scope>provided</scope>
    </dependency>
    <dependency>
        <groupId>org.mybatis</groupId>
        <artifactId>mybatis</artifactId>
        <version>3.5.2</version>
    </dependency>
    <dependency>
        <groupId>mysql</groupId>
        <artifactId>mysql-connector-java</artifactId>
        <version>5.1.47</version>
    </dependency>
    <dependency>
        <groupId>junit</groupId>
        <artifactId>junit</artifactId>
        <version>4.12</version>
    </dependency>
<build>
    <resources>
        <resource>
            <directory>src/main/java</directory>
            <includes>
                <include>**/*.properties</include>
                <include>**/*.xml</include>
            </includes>
            <filtering>false</filtering>
        </resource>
        <resource>
            <directory>src/main/resources</directory>
            <includes>
                <include>**/*.properties</include>
                <include>**/*.xml</include>
            </includes>
            <filtering>false</filtering>
        </resource>
    </resources>
</build>
</dependencies>
ps: 在标签内若不导入此内容,则一般默认只导出scr/main/resources下的描述文件,其他的xml文件无法被输出,从而报错
2、mybatis-config.xml 配置
配置在src/main/resources 下(一般都叫这个名字,不要乱改最好):
作用是
1)连接数据库 以及
2) 在<mappers> </mappers>标签内声明所有用到的XxxMapper.xml 文件
mybatis-config.xml
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE configuration
PUBLIC "-//mybatis.org//DTD Config 3.0//EN"
"http://mybatis.org/dtd/mybatis-3-config.dtd">
<configuration>
<environments default="development">
<environment id="development">
<transactionManager type="JDBC"/>
<dataSource type="POOLED">
<property name="driver" value="com.mysql.jdbc.Driver"/>
<property name="url" value="jdbc:mysql://localhost:3306/mybatisdemo?serverTimezone=Asia/Shanghai&useSSL=false&allowMultiQueries=true&useUnicode=true&characterEncoding=utf-8"/>
<property name="username" value="root"/>
<property name="password" value="123456"/>
</dataSource>
</environment>
</environments>
<!-- 映射器,使用了哪个XxxMapper.xml都要在这里配置-->
<mappers>
<mapper resource="com/kuang/dao/UserMapper.xml"/>
</mappers>
</configuration>
注意:
1)关于<mappers> </mappers>
映射器的resource ,不是com.kuang.dao.UserMapper.xml
而是路径:com/kuang/dao/UserMapper.xml
2)关于
<property name="url" value="jdbc:mysql://localhost:3306/mybatisdemo?serverTimezone=Asia/Shanghai&useSSL=false&allowMultiQueries=true&useUnicode=true&characterEncoding=utf-8"/>
1、MySQL 8之后都要设置serverTimezone 否则报错
2、MySQL 8之后默认useSSL=false,这是连接数据库验证的
3、& 其实就是&的转义, 在idea高版本中需要这样转义
4、useUnicode=true&characterEncoding=utf-8 设置数据库默认编码为utf-8中文字符
5、allowMultiQueries=true 允许批量操作(可以不设置)
所以以后连接MySQL配置基本可以直接复制,但注意修改url中的mybatisdemo,这是database名
3、建好基本类
1)创建实体类,
package com.kuang.pojo;

import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;

@Data
@AllArgsConstructor
@NoArgsConstructor
public class User {

//属性名需要与数据库表中字段名相同 ! 返回result是根据类的属性名去接收数据库表中同名字段的数据记录的
private int id;  //id
private String name;   //姓名
private String pwd;   //密码
}
注意:类的属性名需要与数据库表中字段名相同! 返回的result是根据类的属性名去接收数据库表中同名字段的数据记录的。
若不同名的话需要在mybatis-config.xml 中利用<resultMap/>来修改,可参考后面
mybatis的返回值的封装方式是先构造一个无参的对象,然后通过set方法一个一个的往里面set值,当实体类中未定义无参构造函数时虚拟机会提供一个无参构造函数。但实体类中无toString()方法时,该实体类无法被正常输出。
2)mybatis工具类 (调用mybatis-config.xml)
package com.kuang.utils;

import org.apache.ibatis.io.Resources;
import org.apache.ibatis.session.SqlSession;
import org.apache.ibatis.session.SqlSessionFactory;
import org.apache.ibatis.session.SqlSessionFactoryBuilder;

import java.io.IOException;
import java.io.InputStream;
//MyBatis工具类
public class MybatisUtils {
    private static SqlSessionFactory sqlSessionFactory;static {
    try {
        String resource = "mybatis-config.xml";
        InputStream inputStream = Resources.getResourceAsStream(resource);
        sqlSessionFactory = new SqlSessionFactoryBuilder().build(inputStream);
    } catch (IOException e) {
        e.printStackTrace();
    }
}

//获取SqlSession连接
public static SqlSession getSession(){
    return sqlSessionFactory.openSession(true); //autoCommit:true表示自动提交事务,若无设置默认为false,增删改需要在测试类中session.commit(); 手动提交事务

}
}
创建SqlSession时可以设置是否autoCommit
每个基于 MyBatis 的应用都是以一个 SqlSessionFactory 的实例为核心的。SqlSessionFactory 的实例可以通过 SqlSessionFactoryBuilder 获得。而 SqlSessionFactoryBuilder 则可以从 XML 配置文件或一个预先配置的 Configuration 实例来构建出 SqlSessionFactory 实例。
之后需要SqlSession可以通过sqlSessionFactory.openSession()来获得,
SqlSessionFactory类似于一个POOL池,取出来的SqlSession用完后要close(),避免资源被占用
3)Mapper映射接口类
    package com.kuang.dao;

import com.kuang.pojo.User;

import java.util.List;

public interface UserMapper {  // 其实就是Dao
        //查询所有用户
        List<User> selectUser();
    //根据id搜索用户
    User getUserByID(int num);

    //增加用户  增删改类型都是int 这样可以返回结果集
    int insertUser(User user);

    //更新用户
    int updateUser(Map map);

    //删除
    int deleteUser(int id);

    //模糊查询
List<User> getUserLike(String name);

}
4)Mapper实现(xml文件形式) 以前一般用实现类方式实现接口,在mybatis中用xml文件来实现接口
<?xml version="1.0" encoding="UTF-8" ?>

<!DOCTYPE mapper
        PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
        "http://mybatis.org/dtd/mybatis-3-mapper.dtd">


<!--namespace绑定一个对应的Dao/Mapper接口-->
<mapper namespace="com.kuang.dao.UserMapper">
<!--    id对应的是接口namespace里的method名-->
    <select id="selectUser" resultType="com.kuang.pojo.User">
  select * from user
   </select>


<!--    parameterType指method形参类型,resultType指method返回类型 利用#{[形参名]} 来接收传入的实参-->
    <select id="getUserByID" parameterType="int" resultType="com.kuang.pojo.User">
        select * from user where id=#{num}
    </select>

<!--    这里 #{} 的内容是形参里的属性名-->
    <insert id="insertUser" parameterType="com.kuang.pojo.User">
        insert into user (id,name,pwd) values (#{id},#{name},#{pwd})
    </insert>

    <!--    这里 #{} 的内容是Map里的key, 当实体类属性或表字段较多时使用Map会更加方便-->

<update id="updateUser" parameterType="Map">
    update user set name = #{name}, pwd=#{pwd} where id=#{idd} ;
</update>


    <delete id="deleteUser" parameterType="int">
        delete  from user where id=#{id}
    </delete>

<!--    模糊查询-->
    <select id="getUserLike" resultType="com.kuang.pojo.User">
        select * from user where name like #{name}
    </select>

</mapper>
#{ }其实就类似于一个占位符
路径就在src/main/java/com/kuang/dao/UserMapper.xml
4、测试类 测试
   package com.kuang.dao;

import com.kuang.pojo.User;
import com.kuang.utils.MybatisUtils;
import org.apache.ibatis.session.SqlSession;
import org.junit.Test;
import java.util.List;
import java.util.HashMap;
import java.util.Map;


public class UserMapperTest {
    @Test //方法一:直接利用SqlSession自带方法,这样子可以不用在Mapper接口里写方法
    public void selectAllUser() {
        //获得session
        SqlSession session = MybatisUtils.getSession();
   //调用方法
    List<User> users = session.selectList("com.kuang.dao.UserMapper.selectUser");//实参传入的是 namespace.id

   //输出展示
    for (User user: users){
        System.out.println(user);
    }

    //session关闭
    session.close();
}

@Test  //方法2:利用SqlSession实例化UserMapper,再调用UserMapper中的method
public void getUser(){
    SqlSession session = MybatisUtils.getSession();

    //利用SqlSession实例化UserMapper
    UserMapper mapper = session.getMapper(UserMapper.class);
    //调用接口内method
    User user=mapper.getUserByID(2);

    System.out.println(user);
    session.close();
}

@Test
public void insertUser(){
    SqlSession session = MybatisUtils.getSession();

    //利用SqlSession实例化UserMapper
    UserMapper mapper = session.getMapper(UserMapper.class);
    //调用接口内method
   int res=mapper.insertUser(new User(5,"我被插入了","inserted"));

    //增删改需要提交Transaction事务 ,才能真正对数据库改变
    session.commit();

    if(res>0){
        System.out.println("插入成功");
    }
    session.close();
}

@Test
public void updateUser(){
    SqlSession session = MybatisUtils.getSession();

    //利用SqlSession实例化UserMapper
    UserMapper mapper = session.getMapper(UserMapper.class);
        Map<String, Object> map = new HashMap<String, Object>();
        map.put("idd",5);
map.put("name","我又被修改了");
map.put("pwd","xxxx");
//调用接口内method
int res=mapper.updateUser(map);
 //增删改需要提交Transaction事务 ,才能真正对数据库改变
    session.commit();

    if(res>0){
        System.out.println("修改成功");
    }
    session.close();
}
@Test
public void deleteUser(){
    SqlSession session = MybatisUtils.getSession();

    //利用SqlSession实例化UserMapper
    UserMapper mapper = session.getMapper(UserMapper.class);
    //调用接口内method
    int res=mapper.deleteUser(1);
    @Test
public void getUserLike(){
    SqlSession session = MybatisUtils.getSession();
    UserMapper mapper = session.getMapper(UserMapper.class);
    List<User> list=mapper.getUserLike("我%");   //通配符
    for(User user:list){
    System.out.println(user);
}
}
从 SqlSessionFactory 中获取 SqlSession,SqlSession 提供了在数据库执行 SQL 命令所需的所有方法。你可以通过 SqlSession 实例来直接执行已映射的 SQL 语句。
3对于mybatis-config.xml 的属性说明:
<configuration>标签内有以下标签(上下顺序不能乱,如<properties>一定要在<environments>上面)
properties(属性)
settings(设置)
typeAliases(类型别名)
typeHandlers(类型处理器)
objectFactory(对象工厂)
plugins(插件)
environments(环境配置)
oenvironment(环境变量)
transactionManager(事务管理器)
dataSource(数据源)
databaseIdProvider(数据库厂商标识)
mappers(映射器)
1、db.properties
可以放在resources目录下:
driver=com.mysql.jdbc.Driver
url=jdbc:mysql://localhost:3306/mybatisdemo?serverTimezone=Asia/Shanghai&useSSL=false&allowMultiQueries=true&useUnicode=true&characterEncoding=utf-8
username=root
pwd=123456
注意:这个文件里的&不需要转义,区别于mybatis-config.xml
然后在mybatis-config.xml 的<configuration>标签内配置:
<properties resource="db.properties"></properties>
然后在<environment>内的<property>中,利用${ }即可读取引入的外部配置文件中写好的连接数据库信息。
<environments default=“xxx”/> 标签内可有多个<environment id=“id1”>, 但一个SqlSession实例只能使用一个环境,使用的是default选定的环境
<configuration>
<!--    引入外部配置文件 ,在外部写好连接数据库需要的信息-->
    <properties resource="db.properties"></properties>
<environments default="id1">
    <environment id="id2">
        </environment>
     <environment id="id1">
        <transactionManager type="JDBC"/>
        <dataSource type="POOLED">
            <property name="driver" value="${driver}"/>
            <property name="url" value="${url}"/>
            <property name="username" value="${username}"/>
            <property name="password" value="${pwd}"/>
        </dataSource>
    </environment>
</environments>
    <!--    映射器,使用了哪个XxxMapper.xml都要在这里配置-->
    <mappers>
        <mapper resource="com/kuang/dao/UserMapper.xml"/>
    </mappers>
</configuration>
2、事务管理器(transactionManager)
在 MyBatis 中有两种类型的事务管理器(也就是 type="[JDBC|MANAGED]"):
JDBC – 这个配置直接使用了 JDBC 的提交和回滚设施,它依赖从数据源获得的连接来管理事务作用域。(默认用这个)
MANAGED – 这个配置几乎没做什么。它从不提交或回滚一个连接,而是让容器来管理事务的整个生命周期(比如 JEE 应用服务器的上下文)。 默认情况下它会关闭连接。然而一些容器并不希望连接被关闭,因此需要将 closeConnection 属性设置为 false 来阻止默认的关闭行为
3、数据源(dataSource)
dataSource 元素使用标准的 JDBC 数据源接口来配置 JDBC 连接对象的资源。
大多数 MyBatis 应用程序会按示例中的例子来配置数据源。虽然数据源配置是可选的,但如果要启用延迟加载特性,就必须配置数据源。
有三种内建的数据源类型(也就是 type="[UNPOOLED|POOLED|JNDI]")
一般使用POOLED,这种数据源的实现利用“池”的概念将 JDBC 连接对象组织起来,避免了创建新的连接实例时所必需的初始化和认证时间。 这种处理方式很流行,能使并发 Web 应用快速响应请求
4、<typeAiases/> :
给全限定类名设置一个别名,在XxxMapper.xml中利用别名即可
此标签内有两种方法:
1、
<typeAiases>
 <typeAlias type="com.kuang.pojo.User" alias="Userr">  </typeAlias>
</typeAiases>
别名是Userr
2、
<typeAiases>
<package name="com.kuang.pojo"/>
</typeAiases>
这种方法会扫描整个包下的类,别名自动设置为类名(首字母小写),
但可以在类上使用@Alias(“xx”)来更改:
@Alias("userrr") //所在包需要被\<typeAliases/>的\<package/>扫描才生效
public class User {
}
5、<mappers/>
有3种方法:
1:
<mappers>
    <mapper resource="com/kuang/dao/UserMapper.xml"/>
</mappers>
resource是根据路径查找, 利用 / 来连接
2、
    <mappers>
        <mapper class="com.kuang.dao.UserMapper"></mapper>
    </mappers>
class 是根据全限定类名查找
3、
    <mappers>
       <package name="com.kuang.dao"/>
    </mappers>
根据包名扫描,注册此包下所有XxxMapper.xml
注意!! :方法2和3 要求接口与Mapper配置文件同名!! 且处于同级包内
UserMapper.class
UserMapper.xml
6<resultMap/>
当类属性名与数据库表column字段名不同时,需要在XxxMapper.xml文件中设置resultMap来设置对应关系
UserMapper.xml :
<!--namespace绑定一个对应的Dao/Mapper接口-->
<mapper namespace="com.kuang.dao.UserMapper">

<!--    结果集映射-->
    <resultMap id="User2" type="com.kuang.pojo.User">
        <result column="id" property="idd"></result>
        <result column="name" property="namee"></result>
    </resultMap>

    <select id="selectUser" resultMap="User2">   <!-- 这里id对应的是上面resultMap设置的id-->

  select * from user
   </select>


</mapper>
2、当与数据库表字段不同名的类属性较少时,也可以直接使用别名来解决问题。
select id as idd, name as namee, pwd from user
7<settings/>
关于日志工厂: 主要掌握STDOUT_LOGGING 以及 LOG4J
1、标准日志STDOUT_LOGGING:
<settings>
    <setting name="logImpl" value="STDOUT_LOGGING"/>
</settings>
2、LOG4J:
<settings>
   <setting name="logImpl" value="LOG4J"/>
</settings>
首先需要导依赖:
<dependency>
   <groupId>log4j</groupId>
   <artifactId>log4j</artifactId>
   <version>1.2.17</version>
</dependency>
#将等级为DEBUG的日志信息输出到console和file,E这三个目的地,console和file以及E的定义在下面的代码,不要有任何空格存在!
log4j.rootLogger=DEBUG,console,file,E

#console输出的相关设置
log4j.appender.console=org.apache.log4j.ConsoleAppender
log4j.appender.console.Target=System.out
log4j.appender.console.Threshold=INFO
log4j.appender.console.layout=org.apache.log4j.PatternLayout
log4j.appender.console.layout.ConversionPattern=[%c]-%m%n
#Threshold指低于此级别的日志不输出

#kuang.log文件输出的相关设置
log4j.appender.file=org.apache.log4j.RollingFileAppender
log4j.appender.file.File=./log/kuang.log
log4j.appender.file.MaxFileSize=10mb
log4j.appender.file.Threshold=INFO
log4j.appender.file.layout=org.apache.log4j.PatternLayout
log4j.appender.file.layout.ConversionPattern=[%p][%d{yy-MM-dd}][%c]%m%n

输出ERROR 级别以上的日志到 /log/error.log

log4j.appender.E = org.apache.log4j.DailyRollingFileAppender
log4j.appender.E.File =./log/error.log
log4j.appender.E.Append = true
log4j.appender.E.Threshold = ERROR
log4j.appender.E.layout = org.apache.log4j.PatternLayout
log4j.appender.E.layout.ConversionPattern = %-d{yyyy-MM-dd HH:mm:ss}  [ %t:%r ] - [ %p ]  %m%n

xx.Append = true 表示可以追加 不覆盖文件

#设置日志输出级别
log4j.logger.org.mybatis=DEBUG
log4j.logger.java.sql=DEBUG
log4j.logger.java.sql.Statement=DEBUG
log4j.logger.java.sql.ResultSet=DEBUG
log4j.logger.java.sql.PreparedStatement=DEBUG
注意:log4j.properties 要放在resources目录下,与mybatis-config在同一目录 ,才能被默认搜索到
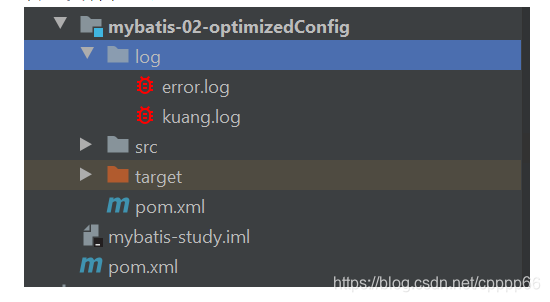
log4j.appender.file.File=./log/kuang.log 指明了日志文件生成后放在log包下命名为kuang.log
log4j.appender.console.Threshold=DEBUG 指明输出到控制台的日志低于DEBUG级别的不输出
配置文件中不能有空格!!,会出错
一般用的有4个日志级别:从低到高是:
info debug warn error
测试类:
package com.kuang.dao;
import com.kuang.pojo.User;
import com.kuang.utils.MybatisUtils;
import org.apache.ibatis.session.SqlSession;
import org.junit.Test;
import java.util.List;
import org.apache.log4j.Logger; //得是apache的这个包不要导错
public class UserMapperTest {
//要在哪个类中使用Logger就传入哪个类
    private static Logger logger = Logger.getLogger(UserMapperTest.class);
@Test
public void loggerDemo() {
    //日志打印
    logger.info("info:进入selectUser方法");
    logger.debug("debug:进入selectUser方法");
    logger.error("error: 进入selectUser方法");

       }
}
日志文件在这里
4POJO注解使用:
可以在类中的方法上使用注解:
    package com.kuang.dao;

import com.kuang.pojo.User;
import java.util.List;
import org.apache.ibatis.annotations.Select;

public interface UserMapper {  // 其实就是Dao
        //查询用户 ,使用注解就不需要在UserMapper.xml中实现
        @Select("select * from user where id=#{id}")
        User selectUserById(int id);
    @Select("select * from user")
    List<User> getUsers();
    }
使用注解就不需要在UserMapper.xml中实现了。
但任然需要在mybatis-config.xml中bind绑定该接口才可使注解生效
<mappers>
    <mapper class="com.kuang.dao.UserMapper"></mapper>
</mappers>
ps:简单的语句可以用注解实现,但复杂的语句以及当语句较多时,建议在XxxMapper.xml中配置统一管理
5多对一的表关系处理:
表的搭建: 多个学生有一个老师
CREATE TABLE `teacher` (
`id` INT(10) NOT NULL,
`name` VARCHAR(30) DEFAULT NULL,
PRIMARY KEY (`id`)
) ENGINE=INNODB DEFAULT CHARSET=utf8;

INSERT INTO teacher(`id`, `name`) VALUES (1, '秦老师');

CREATE TABLE `student` (
`id` INT(10) NOT NULL,
`name` VARCHAR(30) DEFAULT NULL,
`tid` INT(10) DEFAULT NULL,
PRIMARY KEY (`id`),
KEY `fktid` (`tid`),
CONSTRAINT `fktid` FOREIGN KEY (`tid`) REFERENCES `teacher` (`id`)
) ENGINE=INNODB DEFAULT CHARSET=utf8;


INSERT INTO `student` (`id`, `name`, `tid`) VALUES ('1', '小明', '1');
INSERT INTO `student` (`id`, `name`, `tid`) VALUES ('2', '小红', '1');
INSERT INTO `student` (`id`, `name`, `tid`) VALUES ('3', '小张', '1');
INSERT INTO `student` (`id`, `name`, `tid`) VALUES ('4', '小李', '1');
INSERT INTO `student` (`id`, `name`, `tid`) VALUES ('5', '小王', '1');
其中student的tid 是teacher字段id的外键,即student中的字段tid数值必须是teacher字段id中有的值。
构造实体类Student 和Teacher,其中Student中有一Teacher类属性
package com.kuang.pojo;


public class Teacher {
    private int id;
    private String name;
//如果没有toString() 方法时在测试类中无法正常输出Teacher
    @Override
    public String toString() {
        return "Teacher{" +
                "id=" + id +
                ", name='" + name + '\'' +
                '}';
    }
}

package com.kuang.pojo;

public class Student {
    private int id;
    private String name;
    private int tid;
    //学生要关联一个老师
    private Teacher teacher;
@Override
public String toString() {
    return "Student{" +
            "id=" + id +
            ", name='" + name + '\'' +
            ", tid=" + tid +
            ", teacher=" + teacher +
            '}';
}
    }
用两种方法实现StudentMapper接口中返回Students的方法:
package com.kuang.dao;
import com.kuang.pojo.Student;
import java.util.List;

public interface StudentMapper {
List<Student> getStudents();

//在StudentMapper.xml中用两种方法来实现
List<Student> getStudents2();
    }
方法1 :StudentMapper.xml
<select id="getStudents2" resultMap="studentTeacher2">
    select s.id,s.name,s.tid, t.name as tname, t.id as tid from student s,teacher t where s.tid=t.id
</select>
<resultMap id="studentTeacher2" type="com.kuang.pojo.Student">
    <result property="id" column="id"></result>
    <result property="name" column="name"></result>
    <result property="tid" column="tid"></result>
    <association property="teacher" javaType="com.kuang.pojo.Teacher">
        <result property="id" column="tid"></result>
        <result property="name" column="tname"></result>
    </association>
</resultMap>
<resultMap/> 内 <result/> 中的 column是select返回结果集中的字段名
对于这种复杂属性,多对一的(student字段tid 是 teacher字段id 的外键)
利用<association/>标签
这种方法是联表查询,结果嵌套处理(更加符合sql语句逻辑)
方法2: 查询嵌套子查询处理 StudentMapper.xml
<<select id="getStudents" resultMap="studentTeacher">
    select * from student;
</select>

<resultMap id="studentTeacher" type="com.kuang.pojo.Student">
    <result property="id" column="id"></result>
    <result property="name" column="name"></result>
    <result property="tid" column="tid"></result>
    <!--       对于teacher这种无法直接从student表中拿到的复杂对象。多对一情况下 利用association-->
    <association property="teacher" column="tid" javaType="com.kuang.pojo.Teacher" select="getTeachers"></association>
</resultMap>
<select id="getTeachers" resultType="com.kuang.pojo.Teacher">
    select * from teacher where id=#{tid}
</select>
<association/> 中的column是从<select id=“getStudents”/> 中查询回的tid
较复杂 不懂的话不建议使用
6一对多的表关系处理:
一个老师有多个学生
实体类变成这样:
package com.kuang.pojo;

public class Student {   简单的Student
    private int id;
    private String name;
    private int tid;
@Override
public String toString() {
    return "Student{" +
            "id=" + id +
            ", name='" + name + '\'' +
            ", tid=" + tid +
            '}';
}
                      }
package com.kuang.pojo;


import java.util.List;

public class Teacher {
    private int id;
    private String name;
    private List<Student> students;  //一个老师有多个学生
@Override
public String toString() {
    return "Teacher{" +
            "id=" + id +
            ", name='" + name + '\'' +
            ", students=" + students +
            '}';
}
}
在TeacherMapper.xml中实现返回所有老师:
<mapper namespace="com.kuang.dao.TeacherMapper">
    <select id="getTeachers" resultMap="TeacherStudent">
        select s.id as sid,s.name as sname,s.tid as stid,t.id as tid,t.name as tname from teacher t,student s where s.tid=t.id;
    </select>
    <resultMap id="TeacherStudent" type="com.kuang.pojo.Teacher">
        <result property="id" column="tid"></result>
        <result property="name" column="tname"></result>
<!--        association中的javaType指定属性类型,而collection中的泛型信息利用ofType来指定-->
        <collection property="students" ofType="com.kuang.pojo.Student">
            <result property="id" column="sid"></result>
            <result property="name" column="sname"></result>
            <result property="tid" column="stid"></result>
        </collection>
    </resultMap>
</mapper>
注意:
association使用javaType 指定属性类型 多对一 多个学生有一个老师
而collection使用ofType指定泛型信息 一对多 一个老师有多个学生
7动态SQL语句:
新建一个表:
CREATE TABLE `blog` (
`id` varchar(50) NOT NULL COMMENT '博客id',
`title` varchar(100) NOT NULL COMMENT '博客标题',
`author` varchar(30) NOT NULL COMMENT '博客作者',
`create_time` datetime NOT NULL COMMENT '创建时间',
`views` int(30) NOT NULL COMMENT '浏览量'
) ENGINE=InnoDB DEFAULT CHARSET=utf8
编写类:
//生成唯一标识码
package com.kuang.utils;
import java.util.UUID;
public class IdUtil {
public static String genId() {
    return UUID.randomUUID().toString().replaceAll("-", "");

    // UUID(Universally Unique Identifier) 可以保证全时空唯一
    // UUID.randomUUID().toString() 会生成个类似这样的id标识码:d76537bb-f759-465c-b5aa-d36ef8393678
    // 将"-" replace成"" 即空
}
}
pojo
package com.kuang.pojo;
import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;
import java.util.Date; //导这个util下的Date

@AllArgsConstructor
@Data
@NoArgsConstructor
public class Blog {
    private String id;
    private String title;
    private String author;
    private Date create_time;
    private int views;

}
BlogMapper接口:
package com.kuang.dao;

import com.kuang.pojo.Blog;

import java.util.List;
import java.util.Map;

public interface BlogMapper {
    List<Blog> queryBlogIf(Map map); //sql拼接查询
    }
BlogMapper.xml 实现:
<select id="queryBlogIf" resultType="com.kuang.pojo.Blog" parameterType="Map">
    select * from blog where 1=1
    <if test="author != null">   <!--只要实参的key键 title 不为空,就将以下语句拼接到上面-->
        and author=#{author}
    </if>
    <if test="title != null">
        and title=#{title}
    </if>
</select>
where 1=1 是为了后面的语句拼接上来时可以生效
<if/>里的author是根据parameterType的属性名(如果是Map的话就是key)进行匹配的
测试类测试:
public class test {
    @Test
    public void addBlog(){
        SqlSession session = MybatisUtils.getSession();
        BlogMapper mapper = session.getMapper(BlogMapper.class);
        Map<String, String> map = new HashMap<String, String>();
       //map.put("title","Mybatis如此简单");
        map.put("author","狂神说");
        List<Blog> blogs = mapper.queryBlogIf(map);
        for (Blog blog : blogs) {
            System.out.println(blog);
        }
        session.close();
    }
}
<where/> <choose/>
<select id="queryBlogChoose" >
    select * from blog
    <where>
        <choose>
            <when test="title != null">
                AND title like #{title}
            </when>
            <when test="author != null">
                AND author=#{author}
            </when>
            <otherwise>
                AND views=#{views}
            </otherwise>
        </choose>
    </where>
</select>
<choose/>像 Java 中的 switch 语句。 只选择一个进行,都没匹配到就执行<otherwise/>
<where/> 元素只会在子元素返回任何内容的情况下才插入 “WHERE” 子句。而且,若子句的开头为 “AND” 或 “OR”,where 元素也会将它们去除。
<set/>
<update id="updateBlog" parameterType="Map">
    update blog
    <set>
        <if test="title != null"> title=#{title}, </if>
        <if test="author != null"> author=#{author}, </if>
        <if test="views != null"> views=#{views} </if>
    </set>
    where id=#{id}
</update>
注意格式,前面所有元素都要加逗号,最后一个不加 (其实加了也会被删)
set 元素会动态地在行首插入 SET 关键字,并会删掉额外的逗号
<include/>
<select id="queryBlogIf" resultType="com.kuang.pojo.Blog" parameterType="Map">
        select * from blog
        <where>
            <include refid="if-title-author"></include>
        </where>
</select>
<sql id="if-title-author">
    <if test="author != null">
        and author=#{author}
    </if>
    <if test="title != null">
        and title=#{title}
    </if>
</sql>
有时为了抽取部分功能方便复用,可以这样子操作
注意不要将<where/>放到<sql/>里,建议放到外面
<Foreach/>
<!--  以下效果等同于  select * from blog where (id=1 or id=2 or id=3)-->
    <select id="queryBlogForeach" parameterType="List" resultType="com.kuang.pojo.Blog">
        select * from blog
        <where>
            <foreach collection="list" item="idd" open="(" separator="or" close=")">
                id=#{idd}
            </foreach>
        </where>
    </select>
collection:指定输入对象中的集合属性(只能是collection 或list) 或者用Map的key来指定,但其value也得是collection或lsit的类型
item:每次遍历生成的对象
open:开始遍历时的拼接字符串
close:结束时拼接的字符串
separator:遍历对象之间需要拼接的字符串
BlogMapper.java
public interface BlogMapper {
    List<Blog> queryBlogForeach(List listt);
}
测试类:
@Test
public void queryBlogForeach(){
    SqlSession session = MybatisUtils.getSession();
    BlogMapper mapper = session.getMapper(BlogMapper.class);
    Map map = new HashMap();
    List<Integer> idid = new ArrayList<Integer>();
    idid.add(1);
    idid.add(2);
    idid.add(3);
    map.put("ids",idid);  //可以在下面的函数中传入map。需要在BlogMapper.xml文件中修改 collection="ids"
List<Blog> blogs = mapper.queryBlogForeach(idid);
for (Blog blog : blogs) {
    System.out.println(blog);
}
session.close();
}
输出控制台可以查看拼接后的sql语句:
8缓存Cache:(了解即可)
缓存简介:
将用户经常查询的数据放在缓存(内存)中,用户去查询数据就不用从磁盘上(关系型数据库数据文件)查询,从缓存中查询,从而提高查询效率,解决了高并发系统的性能问题
为什么使用缓存?
减少和数据库的交互次数,减少系统开销,提高系统效率。
什么样的数据能使用缓存?
经常查询并且不经常改变的数据。
MyBatis系统中默认定义了两级缓存:一级缓存和二级缓存
默认情况下,只有一级缓存开启。(SqlSession级别的缓存,也称为本地缓存)
二级缓存需要手动开启和配置,他是基于namespace级别的缓存。
为了提高扩展性,MyBatis定义了缓存接口Cache。我们可以通过实现Cache接口来自定义二级缓存
一级缓存也叫本地缓存:(默认开启)
与数据库同一次会话期间查询到的数据会放在本地缓存中,以后如果需要获取相同的数据,直接从缓存中拿,没必须再去查询数据库;MyBatis在开启一个数据库会话时,会创建一个新的SqlSession对象,SqlSession对象中会有一个新的Executor对象,缓存就存在其中。一个SqlSession实例化的不同Maaper之间一级缓存是共通的
1)一级缓存是SqlSession级别的缓存,是一直开启的。
2)每个SqlSession中的缓存相互独立。
3)增删改操作会刷新该SqlSession的缓存( 如下类似可以设置不刷新)
<update id="" parameterType="" flushCache="false"></update>
4)SqlSession还可以 sqlSession.clearCache(); //手动清除缓存
二级缓存也叫全局缓存,一级缓存作用域太低了,所以诞生了二级缓存,是基于namespace级别(绑定一个XxxMapper.java 接口)的缓存,只要是同一个XxxMapper.class实例化的mapper就共享二级缓存。
工作机制:
一个SqlSession查询一条数据,这个数据就会被放在当前SqlSession的一级缓存中;如果当前SqlSession关闭了,这个SqlSession对应的一级缓存就没了;但是当二级缓存开启条件下,这个一级缓存中的数据会被保存到二级缓存中;新的SqlSession查询信息,就可以从二级缓存中获取内容;(注意:当SqlSession关闭后,其一级缓存的内容才会到二级缓存中)
使用方法:
1、在mybatis-config.xml中配置<settings/>
<settings>
    <setting name="logImpl" value="STDOUT_LOGGING"/><!-- 开启日志输出,看sql语句执行几次就知道缓存有没有生效-->
<setting name="cacheEnabled" value="true"/>    <!--    开启二级缓存-->
</settings>
2、
在UserMapper.xml的<mapper/> 中开启<cache/>
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE mapper
        PUBLIC "-//mybatis.org//DTD Config 3.0//EN"
        "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.kuang.dao.UserMapper">
    <cache></cache>
    <select id="queryUserById" parameterType="int" resultType="com.kuang.pojo.User">
        select * from user where id=#{idd}
    </select>
    </mapper>
也可以手动进行一些配置
<cache
 eviction="FIFO"
 flushInterval="60000"
 size="512"
 readOnly="true"> </cache>
<cache> 标签中还有属性type可以选择自制或第三方导入cache
9Note:
1、关于#{ }, ${ }的区别:
#{} 解析为一个 JDBC 预编译语句(prepared statement)的参数标记符,一个 #{ } 被解析为一个参数占位符;而${}仅仅为一个纯碎的 string 替换,在动态 SQL 解析阶段将会进行变量替换。
#{} 解析之后会将String类型的数据自动加上引号,其他数据类型不会;而${ } 解析之后是什么就是什么,他不会当做字符串处理。
在某些特殊场合下只能用${},不能用#{}。例如:在使用排序时ORDER BY ${id},id是column字段名,如果使用#{id},则会被解析成ORDER BY “id”,这显然是一种错误的写法

 3469


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


