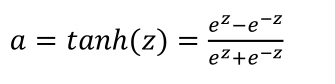【学习报告】10.3-10.10

神经网络学习笔记(五) 上一章我们讨论了求输出层激励的梯度和输出层预激励的梯度的方法,可以发现,求解过程极其复杂,本章将从链式法则入手,推导出各隐层的参数梯度的一般形式。一、链式求导法则回顾高数的知识,若一个函数可写成若干个中间结果,即p(a)=p(q1(a),...qi(a),...,qn(a))p(a)=p(q_1(a),...q_i(a),...,q_n(a)),则有∂p(a)∂a=∑i∂p(a)∂qi(a)∂qi( 阅读详情

神经网络的表示

一般计算神经网络层数时不算输入层,所以下图是二层的神经网络

image-20221004205855071

每个结点包含两个过程,一个是z=wT x+b,另一个是激活函数。

隐藏层和输出层都有参数w和b,第一层的w是4×3的矩阵,b是4×1的矩阵;第二层的w是1×4的矩阵,b是1×1的矩阵。

计算

单样本的

先计算第一层的z和a:

image-20221004210550205

将上述过程向量化:

z看成4×1的矩阵,W看成4×3的矩阵,b看成4×1的矩阵。

image-20221004210909967

多样本的

非向量化的实现:

循环遍历m个样本,对于第i个样本:

image-20221004212848398

image-20221004212856131

向量化的实现:

横向方向对应各个样本,纵向对应神经网络中的不同结点

X矩阵:
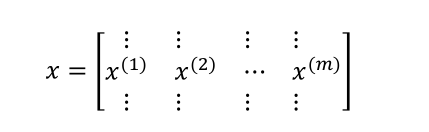
image-20221004213224426

Z[1]:

image-20221004213312470

A[1] :

image-20221004213350575

所以:

Z[1] =W[1] X + b[1]

image-20221004213742434

激活函数

sigmoid激活函数:值域范围[0,1]

image-20221004220706842

image-20221004215952054

仅用于二分类

tanh激活函数:值域范围[-1,1]

image-20221004220651056

image-20221004220107931

除非是二分类应用,否则选用tanh,因为tanh比sigmoid更优越。在训练一个算法模型时,如果使用 tanh 函数代替
sigmoid 函数中心化数据,使得数据的平均值更接近 0 而不是 0.5.

注意:在不同的神经网络层中,激活函数可以不同。

以上二种激活函数的缺点是当z很大或者很小时,梯度会非常小,参数更新就比较慢。

ReLu激活函数:

image-20221004220624304

image-20221004220322297

Leaky ReLu激活函数:

image-20221004220607302

如果不确定选哪种激活函数时,优先考虑ReLu激活函数。

为什么需要非线性激活函数

事实证明:要让你的神经网络能够计算出有趣的函数,你必须使用非线性激活函数。

如果你使用线性激活函数或者没有使用一个激活函数,那么无论你的神经网络有多少层一直在做的只是
计算线性函数,所以不如直接去掉全部隐藏层。

总而言之,不能在隐藏层用线性激活函数,可以用 ReLU 或者 tanh 或者 leaky ReLU 或者其他的非线性激活函数,唯一可以用线性激活函数的通常就是输出层。

激活函数的导数

sigmoid:

image-20221005093716903

tanh:

image-20221005093741811

ReLu:

image-20221005093855796

Leaky ReLu:

image-20221005093810996

神经网络的梯度下降公式

假设输出层的激活函数是sigmoid

image-20221004205855071

正向传播方程:

image-20221005112300683

反向传播方程:

image-20221005113110050

image-20221005113129303

“*”表示对应位置元素相乘

image-20221005113136909

image-20221005113145230

np.sum(keepdims=True)
keepdims=True:确保矩阵的维度为n^[1]×1

随机初始化参数

为什么需要随机初始化?

如果按参数都初始化为0,则同一层的各个结点其实都在计算同一个东西,也就没必要设置多个结点,因此需要随机初始化参数,各个结点都在计算不同的东西。

image-20221006205448581

比如上图这个神经网络,w[1] 是2×2的矩阵,b[1] 是2×1的矩阵,w[2] 是1×2的矩阵,b[2] 是1×1的矩阵,可以通过如下代码随机初始化

w_1 = np.random.randn(2, 2) * 0.01
b_1 = np.zeros((2, 1))

为什么要乘0.01?

我们通常倾向于初始化为很小的随机数。如果要用tanh或者sigmoid激活函数,可能会使得梯度下降得很慢。

代码笔记

  • 如果有一个矩阵X,要求X中的元素如果大于0.5,则将它赋值为1,否则赋值为0

可以循环遍历,也可以使用如下的语句

X=(X>0.5)

此时X中元素的数据类型是bool类型

  • range
range(start, stop, step)
tart: 计数从 start 开始。默认是从 0 开始。例如range(5)等价于range(0, 5);
stop: 计数到 stop 结束,但不包括 stop。例如:range(0, 5) 是[0, 1, 2, 3, 4]没有5
step:步长,默认为1。例如:range(0, 5) 等价于 range(0, 5, 1)
  • np.linspace
numpy.linspace(start, stop, num=50, endpoint=True, retstep=False, dtype=None, axis=0)
Return evenly spaced numbers over a specified interval.
(在start和stop之间返回均匀间隔的数据)
Returns num evenly spaced samples, calculated over the interval [start, stop].
(返回的是 [start, stop]之间的均匀分布)
The endpoint of the interval can optionally be excluded.
Changed in version 1.16.0: Non-scalar start and stop are now supported.
(可以选择是否排除间隔的终点)

start:返回样本数据开始点
stop:返回样本数据结束点
num:生成的样本数据量,默认为50
endpoint:True则包含stop;False则不包含stop
retstep:If True, return (samples, step), where step is the spacing between samples.(即如果为True则结果会给出数据间隔)
dtype:输出数组类型
axis:0(默认)或-1
  • np.c_
np.c_[a,b]
将a和b结合,要求a和b的行数一致
  • ravle()

    ravel函数将多维数组降为一维,仍返回array数组

    x = np.array([[1, 2], [3, 4]])
    print(x)
    >>>array([[1, 2],
           [3, 4]])
    x.ravel()
    >>>array([1, 2, 3, 4])
    
  • np.divide()

numpy.divide(x1, x2, /, out=None, *, where=True, casting=‘same_kind’, order=‘K’, dtype=None, subok=True[, signature, extobj]) = <ufunc ‘true_divide’>)

功能:
数组对应位置元素做除法。
这里的除法结果和Python传统的地板除不同,这里得到的是真实值。numpy.divide的计算结果适应于输出值的数值类型,与输入值的数值类型无关。

参数:
x1	数组型变量	充当被除数的数组
x2  数组型变量	充当除数的数组
out	n维数组,None,n维数组组成的元组,可选参数,计算结果的存放位置。若提供此参数,它的维度必须和输入数组扩维后的维度保持一致。若不提供此参数或该值为None,返回新开辟的数组。若此值为元组类型,其长度必须和返回值的个数保持一致。
where	数组型变量,可选参数	用默认值即可

返回值:
out	n维数组或标量	如果x1和x2均为标量,那么返回值也为标量

深层神经网络

流程图

[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-EJqM88yO-1665366027660)(https://cdn.jsdelivr.net/gh/DaoChenLiu/images/learning_report3/202210080950989.png)]

前向传播

image-20221007213756675

A[0] =X

反向传播

image-20221007213947521

*是对应元素相乘

image-20221007214000779

参数

W[1] b[1] ,W[2] b[2] ……

超参数

控制参数的参数

学习率,迭代次数,隐层数,隐层单元的个数……

如何寻找最优的超参数?

不断尝试

具体流程

  1. 初始化参数
  2. 实现各种函数,包括线性函数,激活函数…
  3. 正向传播
  4. 计算损失
  5. 反向传播
  6. 更新参数

在具体实现时,需要保存每一层的参数,例如A,W,b,Z

NewMap 10.3土地勘测定界自动化系统:GIS与AutoCAD的完美融合 NewMap 10.3土地勘测定界自动化系统通过GIS与AutoCAD的完美融合,实现了建设项目用地勘测定界的高效自动化。该系统基于ObjectARX开发,显著提升数据处理速度,支持图形与属性的双向联动,一键生成标准报告,并兼容主流GIS平台。实际应用中可缩短60%作业时间,降低技术门槛,提供个性化定制选项,是土地勘测领域的革命性工具。 阅读详情

相关推荐

深入解析ChangeFormer:基于Transformer的孪生网络在遥感变化检测中的创新应用

本文深入解析了ChangeFormer这一基于Transformer的孪生网络在遥感变化检测中的创新应用。通过分层Transformer编码器、特征差异计算模块和轻量级MLP解码器的设计,ChangeFormer在LEVIR-CD数据集上取得了90.4%的F1分数,显著优于传统卷积网络。文章还详细探讨了工程化实现、训练调参和模型部署的优化策略,为遥感变化检测领域提供了新的技术范式。

weixin_29051811的博客 731

神经网络模型符号解释!!!蛮重要的,记不住的可以参考下。

神经网络模型符号解释!!!蛮重要的,记不住的可以参考下。

czhuaa的博客 6801

多模态模型评测神器 | OpenCompass MMBench 了解一下!

MMBench 是 OpenCompass 研究团队自建的视觉语言模型评测数据集,可实现从感知到认知能力逐级细分评估。研究团队从互联网公开信息与权威基准数据集采集约 3000 道单项选择题 ,覆盖目标检测、文字识别、动作识别、图像理解、关系推理等 20 个细粒度评估维度。

OpenCompass的博客 7826

【转】机器学习入门——浅谈神经网络

【转】机器学习入门——浅谈神经网络 个人觉得很全,特别适合接触神经网络的新手。

bitjoy的博客 2万+

从‘查理复用’到TM52F1363:深入剖析5脚188数码管的驱动原理与避坑指南

本文深入解析了5脚188数码管的驱动原理,重点介绍了查理复用技术如何通过5个IO引脚高效驱动188段显示,并详细探讨了TM52F1363单片机的寄存器配置与驱动实现。文章还提供了常见问题的解决方案和性能优化技巧,帮助开发者避免实际应用中的各种陷阱。

weixin_29159441的博客 478

STM32 IAP跳转后APP卡死?别慌,手把手教你修复HAL_RCC_OscConfig时钟配置冲突

本文深入分析了STM32 IAP跳转后APP在HAL_RCC_OscConfig函数中卡死的问题,揭示了PLL时钟配置冲突的根本原因。通过详细的代码示例和分步解决方案,指导开发者正确处理STM32F1/F4系列的时钟系统二次初始化问题,确保IAP+APP架构的稳定运行。

weixin_28685287的博客 365

【学习心得】神经网络知识中的符号解释②

神经网络知识中的符号解释②

qq_39780701的博客 1429

单细胞分析(16)—— RNA Velocity 分析流程

RNA velocity 是一种强大的单细胞转录组分析工具,它可以预测细胞的未来状态,揭示发育轨迹,并用于探索细胞状态转换。RNA velocity 是一种通过单细胞 RNA 测序(scRNA-seq)数据推测细胞未来状态的分析方法。🚀**RNA velocity 提供了一个全新的角度来理解细胞的动态变化,为单细胞转录组分析带来了更深入的时空信息!

阅读文献,记录学习笔记 2978

全连接层的算力(矩阵乘法)计算方式

神经网络的全链接层计算过程可以看成两个矩阵相乘,如下图所示,一个MxN的矩阵乘以一个NxP的矩阵,得到一个MxP的矩阵,进行乘法的次数为:(N)*(M*P)加法次数为:(N-1)*M*P所以,矩阵乘法总的计算量为(N)*(M*P)+(N-1)*M*P = (2N-1)*M*P每计算出一个结果,需要对一个N维向量作内积,内积需要进行N次乘法和N-1次加法(第一次计算不需要作加法,或者看成+0,就不需要-1了),计算一个结果的计算次数为2N-1.比如,就拿3*3的矩阵乘法为例:计算如下:所以,它的计算量为:乘法

tugouxp的专栏 7895

【YOLOs-CPP-图像分类部署】04-项目优化(加速部署)

本文详细介绍了将YOLO图像分类C++部署项目从CMake迁移到Visual Studio控制台应用的全过程。针对低配CPU性能瓶颈问题,作者通过替换多线程HPP代码为官方实现,并采用448x448固定输入尺寸优化推理速度。项目配置包含OpenCV和ONNX Runtime环境设置,实现了图像批量处理、分类结果显示及结果日志输出功能。关键步骤包括依赖库配置、DLL部署和代码调试,最终在Windows平台成功实现高效CPU推理。该方案显著提升了低配硬件的兼容性,为图像分类任务提供了稳定的部署解决方案。

深耕CV 353

二、TCP/IP协议之网络层(IP地址的格式、分类、报文格式)

数据报每经过一个路由器,路由器都要重新计算一下首部检验和,若首部未发生变化,则此结果必为 0,于是就保留这个数据报。对于网络号相的设备,无论实际所处的物理位置如何,它们都是处在同一个网络中。在首部的固定部分的后面是一些可选字段,其长度是可变的。IPv4 软件在存储器中维持一个计数器,每产生一个数据报,计数器就加 1,并将此值赋给标识字段。表示数据报在网络中的寿命,英文缩写是 TTL(Time To Live),功能是“跳数限制”。地址的网络号码字段用来标识一个网络,网络号码字段的前几位用来区分。

锦慈的技术博客 185

2025.2.10 每日学习记录3:技术报告只差相关工作+补实验

技术报告只差相关工作+补实验

Kakaxiii的博客 355

19、CATIA V5:参数化建模与零件目录创建全解析

本文详细解析了在CATIA V5中通过设计表实现参数化建模及零件目录创建的完整流程。以支撑块和钩形夹为例,介绍了参数识别、设计表创建与关联、配置管理以及零件目录的构建方法。同时,提供了实际操作建议和注意事项,帮助设计师高效创建和管理零件族,提升设计效率和质量。

raspberrypi5的博客 446

机器学习实验报告:利用3层神经网络对CIFAR-10图像数据库进行分类

PS:这是6月份时的一个结课项目,当时的想法就是把之前在Coursera ML课上实现过的对手写数字识别的方法迁移过来,但是最后的效果不太好… 2014年 6 月 一、实验概述 实验采用的是CIFAR-10 图像数据库,一共包括60000幅32x32 彩色图像。这些图像分为10类,每类6000幅。整个数据库分为五个训练包和一个测试包,每个包一万幅图像,所以一共5万幅训练图像,1万幅...

weixin_30895603的博客 1177

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

将Jupyter Notebook转为HTML报告:Miniconda-Python3.10一键导出方案

利用Miniconda与Python 3.10搭建稳定环境,结合nbconvert实现Jupyter Notebook到HTML的自动化转换。支持代码执行、批量处理与定时生成,兼顾可复现性与交付效率,适合团队协作和工程化报告输出。

weixin_28681379的博客 436

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

深度学习视觉应用学习报告

10类彩色图像数据集(飞机、汽车、鸟等),每类6,000张,50,000训练+10,000测试。:经典手写数字数据集,包含0-9共10类,60,000张训练图像和10,000张测试图像。:替代MNIST的时尚物品数据集,由Zalando提供,包含10类商品(如T恤、鞋子等)。:目标检测与分割经典数据集,2012版最常用,含20类(如人、车、动物等)。:28×28像素灰度图,文件分为训练图像、训练标签、测试图像、测试标签。:微软推出的复杂场景理解数据集,涵盖80类(如人、交通工具、家具等)。

weixin_66603818的博客 898

深度学习项目训练环境效果可视化:matplotlib动态绘图+seaborn评估报告生成实录

本文介绍了如何在星图GPU平台上自动化部署深度学习项目训练环境镜像,并利用其预置的matplotlib和seaborn库,实现训练过程的动态可视化与专业评估报告生成。该环境可广泛应用于图像分类等深度学习项目的效果监控与结果分析,显著提升模型调试与展示效率。

weixin_42298164的博客 390

【华为网络模拟器eNSP】IPv6 网络拓扑搭建实验

基于华为网络模拟软件eNSP搭建IPv6网络拓扑,并在拓扑上应用OSPFv3协议

于此等你的博客 1万+

HTML可视化训练结果:在Miniconda-Python3.10中集成Plotly与TensorBoard

通过Miniconda构建稳定Python环境,结合Plotly生成可交互HTML报告,利用TensorBoard实现实时训练监控,打造高效、可复现的深度学习可视化工作流,提升本地调试与团队协作效率。

weixin_36299472的博客 615

python3.6+selenium3.13 自动化测试项目实战一

一.项目介绍   目的:     测试某官方网站登录功能模块可以正常使用   用例:     1.输入格式正确的用户名和正确的密码,验证是否登录成功;     2.输入格式正确的用户名和不正确的密码,验证是否登录失败,并且提示信息正确;     3.输入格式正确的用户名和任意密码,验证是否登录失败,并且提示信息正确;     4.用户名和密码两者都为空,验证是否登录失败,并且提示...

diaoqiaohai5121的博客 1507

雅礼学习10.1

雅礼学习10.1 上午考试解题报告 各题状况 每道题的难度大概都在noip提高组Day2T2T3难度 T1 只会模拟 模拟写完之后,小小加了一个优化 期望得分20+20 T2 光是理解题意就花了好长时间。。。 然后勉勉强强算是会了暴力的写法(复杂度\(O(N!)\)) 不会判重,但是lyq说按照他的想法这题根本不需要判重??? T3 我。。。这题彻底理解错误了 四联通是指对于每个格子向外扩展的方向...

weixin_30318645的博客 170

深度学习项目训练环境惊艳效果:单命令生成训练报告PDF(含图表+指标+超参)

本文介绍了如何在星图GPU平台自动化部署深度学习项目训练环境镜像,实现单命令生成包含图表、指标和超参的完整训练报告PDF。该环境简化了深度学习工作流程,特别适用于模型训练结果的自动化记录与专业文档生成,大幅提升研究效率。

weixin_42443533的博客 112

RAGFlow想说爱你不容易,win10环境搭建、常用修改,大模型入门到精通,收藏这篇就足够了!

RAGFlow想说爱你不容易,win10环境搭建、常用修改,大模型入门到精通,收藏这篇就足够了!

pythonhy的博客 926

Ollama部署本地大模型高算力适配:ChatGLM3-6B-128K在A10G服务器实测报告

本文介绍了如何在星图GPU平台上自动化部署【ollama】ChatGLM3-6B-128K镜像,高效支撑长文本处理任务。依托平台能力,用户可一键完成模型加载与优化配置,典型应用于技术文档解析、合同风险扫描及个性化学习报告生成等专业场景,显著提升企业知识管理与AI推理效率。

weixin_42602368的博客 254

比手动快10倍!AI生成电源管理工具实测

大幅减少重复性编码工作快速获取最佳实践和优化建议降低API学习和调试的时间成本让开发者更专注于核心逻辑和创新功能当然,AI生成代码也需要人工审核和调整,不能完全依赖。但整体来看,开发效率提升确实能达到5-10倍。如果你也想体验这种高效的开发方式,可以试试InsCode(快马)平台。它的AI辅助功能让复杂项目的开发变得简单快捷,特别适合需要快速实现原型的场景。我实际使用中发现,从描述需求到获得可运行代码的过程非常流畅,而且一键部署功能让分享和测试变得特别方便。

BlackStone33的博客 257

SRC 平台新手入门教程精选

广度: 面向企业安全建设的核心场景(渗透测试、红蓝对抗、威胁狩猎、应急响应、安全运营),本知识库覆盖了从攻击发起、路径突破、权限维持、横向移动到防御检测、响应处置、溯源反制的全生命周期关键节点,是应对复杂攻防挑战的实用指南。深度: 本知识库超越常规工具手册,深入剖析攻击技术的底层原理与高级防御策略,并对业内挑战巨大的APT攻击链分析、隐蔽信道建立等,提供了独到的技术视角和实战验证过的对抗方案。独家《网络攻防知识库》采用由浅入深、攻防结合的讲述方式,既夯实基础技能,更深入高阶对抗技术。

QIANDXX的博客 229
上一篇: 【学习报告】9.26-10.2
下一篇: 【学习报告】10.10-10.17
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值