在 Pycharm 中 debug Scrapy 项目

pycharm下打开、执行并调试scrapy爬虫程序的方法 本篇文章主要介绍了pycharm下打开、执行并调试scrapy爬虫程序的方法,小编觉得挺不错的,现在分享给大家,也给大家做个参考。一起跟随小编过来看看吧 立即下载

缘起

为什么写这篇文章呢?因为自己想在 Scrapy 项目里 debug, 看看 Response 有哪些属性。但是 Scrapy 的官方文档的 debug 说明只有 VSCode 的,没有 Pycharm 的(详见:https://docs.scrapy.org/en/latest/topics/debug.html):

{
    "version": "0.1.0",
    "configurations": [
        {
            "name": "Python: Launch Scrapy Spider",
            "type": "python",
            "request": "launch",
            "module": "scrapy",
            "args": [
                "runspider",
                "${file}"
            ],
            "console": "integratedTerminal"
        }
    ]
}

当然,如果熟悉 VSCode 的人看到这个配置就明白其实执行方式是:python -m scrapy runspider xxx_spider.py (注:这里的 xxx_spider.py 指 spider 文件,如官方文档里面的 quotes_spider.py)。如果这个人同时还熟悉 Pycharm, 那么他就知道在 Pycharm 里面配置进行 debug:

在这里插入图片描述

很遗憾,我不是这样的人,所以就有了这篇文章。

说明

时间:2025/12/06

Pycharm 版本:2025.2.4

Python 版本:3.12.0

Scrapy 版本:2.13.4

Windows 版本:Win 11

main.py

在与 scrapy.cfg 文件同层级的目录中新建一个名为 main.py 的文件,用于 debug。示例:

# main.py
from scrapy.cmdline import execute


if __name__ == '__main__':
    print(1)
    print(2)
    execute(['scrapy', 'crawl', 'manning'])

项目结构:
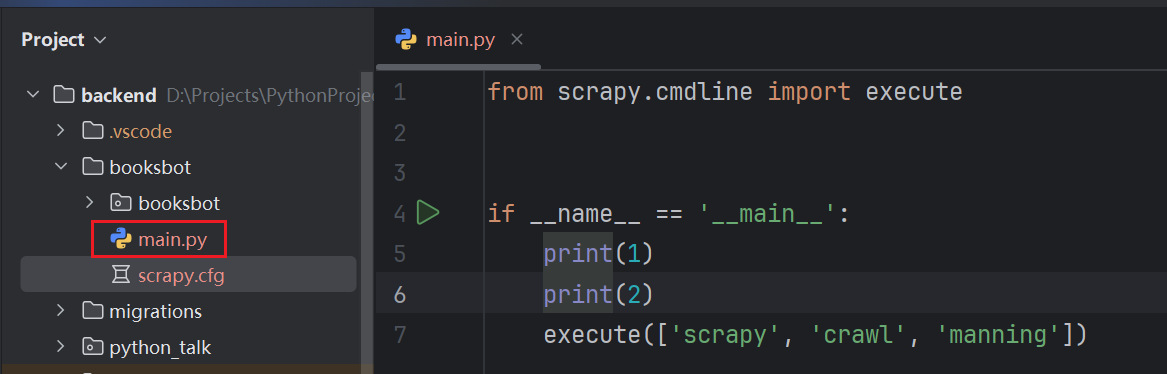
在这里插入图片描述

TypeError: ‘Task’ object is not callable

当 Debug’main’时, 出现错误:

2025-12-06 10:51:15 [asyncio] ERROR: Exception in callback <Task pending name='Task-1' coro=<ExecutionEngine.open_spider() running at D:\Projects\PythonProjects\python-talk\backend\venv\Lib\site-packages\scrapy\core\engine.py:430> cb=[Deferred.fromFuture.<locals>.adapt() at D:\Projects\PythonProjects\python-talk\backend\venv\Lib\site-packages\twisted\internet\defer.py:1255]>()
handle: <Handle <Task pending name='Task-1' coro=<ExecutionEngine.open_spider() running at D:\Projects\PythonProjects\python-talk\backend\venv\Lib\site-packages\scrapy\core\engine.py:430> cb=[Deferred.fromFuture.<locals>.adapt() at D:\Projects\PythonProjects\python-talk\backend\venv\Lib\site-packages\twisted\internet\defer.py:1255]>()>
Traceback (most recent call last):
  File "D:\Apps\Python3.12\Lib\asyncio\events.py", line 84, in _run
    self._context.run(self._callback, *self._args)
TypeError: 'Task' object is not callable

在这里插入图片描述

之所以产生这个问题,不是代码的问题,是 Pycharm debuger 的问题,我还没梳理完,故暂不展开,只讲怎么解决。

Debug 方式

方法 1:TWISTED_REACTOR

  1. Settings > Python > Debugger,取消 Gevent compitable 的勾选。

在这里插入图片描述

2.在项目的 settings.py 文件里设置 TWISTED_REACTOR = ‘twisted.internet.selectreactor.SelectReactor’

在这里插入图片描述

方法 2:python.debug.asyncio.repl

1.Settings > Python > Debugger,取消 Gevent compitable 的勾选(这步和方法 1 是一样的)。

在这里插入图片描述

2.双击 Shift 键打开搜索窗口。

双击 Shift 的意思是“search everywhere,详见 https://www.jetbrains.com/help/pycharm/searching-everywhere.html”。

在这里插入图片描述

3.点击 ALL 选项,输入 registry,最后点击 Regisry 选项。

在这里插入图片描述

4.找到 python.debug.asyncio.repl,取消勾选 Value 列的方框。

在这里插入图片描述

验证

在这里插入图片描述

如上图所示,设置后可以 debug。

参考资料

1.Scrapy 文档, Debugging Spiders: https://docs.scrapy.org/en/latest/topics/debug.html

2.Pycharm 文档,Search for a target by name:https://www.jetbrains.com/help/pycharm/searching-everywhere.html

欢迎搜索及关注:编程人(a_codists),如有问题请留言。

OpenNARS开源通用人工智能系统:非公理推理引擎实践指南 人工智能系统从基于规则推理到深度学习模型,始终围绕如何让机器具备智能决策能力。传统逻辑系统依赖公理和完备知识,而现实世界智能体需要在资源受限、信息不完备环境下进行推理。非公理推理系统(NARS)通过动态真值计算和信念修正机制,实现了在不确定性环境下的自主学习和决策。这种推理引擎的技术价值在于模拟人类思维的核心机制——归纳、演绎和学习,为通用人工智能(AGI)提供了不同于数据驱动的新路径。在应用场景上,NARS适用于游戏NPC决策、复杂系统故障诊断和自适应机器人控制等领域。OpenNARS作为NARS理论的开 阅读详情

相关推荐

电流镜结构实战:从零理解MOS管偏置电路设计(附吴金课程补充)

本文深入解析电流镜结构在MOS管偏置电路设计中的关键作用,从基本原理到实战应用全面覆盖。通过分析偏置电路的核心原理、破解设计难题的实用技巧,以及进阶优化策略,帮助工程师掌握这一模拟电路设计的核心技术。特别适合需要理解电流镜结构和基准电路设计的读者参考学习。

ujm5678901的博客 256

‘ProactorEventLoop‘ object has no attribute ‘_compute_internal_coro‘

'ProactorEventLoop' object has no attribute '_compute_internal_coro'解决

告白与告别的博客 990

SAP 屏幕增强:客户商主数据屏幕增强(KNA1、KNB1、KNVV)

本文介绍了SAP系统中针对客户主数据(KNA1、KNB1、KNVV)进行屏幕增强的具体实现方法。主要内容包括:1)在SPRO配置中创建新条目;2)通过SE80创建函数组和程序(LZKNA1TOP等);3)设置子屏幕9001并添加自定义结构字段;4)利用BADI(CUSTOMER_ADD_DATA等)实现数据交互逻辑。文章分别详细说明了针对客户主数据的一般数据(KNA1)、公司代码数据(KNB1)和销售数据(KNVV)三类不同数据的增强配置步骤,包括函数模块创建、屏幕设置和BADI方法调用等关键技术点。

SAP ABAP开发技能记录分享 1615

‘Task‘ object is not callable ERROR

pycharm 调试异步的代码报错 TypeError: ‘Task‘ object is not callable ERROR: Exception in callback <Task。解决方法:点击菜单栏帮助-查找操作-注册表,在注册表中搜索python.debug.asyncio.repl禁用即可。

我的世界没光的博客 1188

底层软件测试规范,QA评审底层测试

本文首发于【林子的空间】“林子,咱们上次讨论的高效Desk check清单,用起来还挺好的,最近我们组每次Desk check变得顺利多了,Dev也是越来越熟练。”玥玥跟我说。“真好!我们组感觉也是这样!”“不过,我听小慧说他们组有人对QA review UT提出了一些concern(质疑),觉得QA review的价值不大,基本都是Dev给讲一遍,QA也提不出来什么反馈...”玥玥补充说道。“哦...

weixin_42144707的博客 1187

国产大模型 coding plan 实战决策指南:GLM、Kimi、豆包、abab 四大模型分层选型与工程落地

大模型辅助编程(coding assistant)正从概念验证走向规模化工程落地,其核心已不再是‘能否生成代码’,而是‘如何在真实开发流程中精准赋能’。理解模型能力边界、匹配技术栈特征、构建分层工作流(L1行级补全/L2函数生成/L3模块重构),是实现稳定提效的关键。GLM系列以工程稳定性见长,适合代码审计与测试生成;Kimi-Max凭借200K超长上下文胜任深度重构与合规审查;豆包响应快、框架适配深,是IDE高频补全的理想选择;abab系列则在IoT固件等跨模态场景中展现独特价值。本文聚焦国产模型在金融、

weixin_32238157的博客 427

scrapy debug

1、在scrapy项目下新建main.py文件,与scrapy.cfg平级。在spiders文件夹下新建run.py,内容如下。在pycharm中,直接debug该文件就可以了。scrapy crawl xx.py(爬虫文件名)2、python文件运行。

zlc1990628的博客 523

华三(H3C)网络设备配置命令大全与学习指南

本文全面介绍 H3C 网络设备的配置命令,涵盖路由器、交换机、ACL、NAT、VTY、SSH、本地用户、日志、STP、防火墙、QoS 等模块,适合网络工程初学者与运维人员参考。

DreamCollector的博客 6562

python error “object is not callable“ 分析解决

最近在学习python相关的东西,查看别人的代码,有很多地方看不太懂,就写了一些简单的代码来debug 这个调用类的实例化的逻辑。当类中没有特殊函数call时,类的实例不可被调用,当有了call函数,则在调用类的实例的时候会执行call 函数中的内容。因为import的文件里面定义了一个类的对象,因此会调用Animal 类的构造函数进行一些初始化操作。修改主程序 Inherit_test.py,创建一个类调用主程序中的Main函数。会报错,因为Main函数里面调用了一个类的实例。

qq_42429142的博客 1215

深入解析UEFI PEI阶段:PeiCore的三次调用与内存管理机制

本文深入解析UEFI启动流程中的PEI阶段,重点探讨PeiCore的三次调用与内存管理机制。详细介绍了PeiCore在临时内存中的初始化、堆栈切换至永久内存的过程,以及最终交接给DXE阶段的关键步骤,为开发者提供调试技巧与实战案例,助力解决UEFI启动问题。

weixin_28452161的博客 649

【5G】5G 核心网(5GC)基本架构

本文旨在科普5G核心网相关知识...

Learning makes me happy (0^◇^0) 4万+

pycharm 调试异步的代码报错 TypeError: ‘Task‘ object is not callable ERROR: Exception in callback <Task

pycharm debugger TypeError: 'Task' object is not callable ERROR: Exception in callback 链接: https://youtrack.jetbrains.com/issue/PY-62467/TypeError-Task-object-is-not-callable-debugging-uvloop-with-asyncio-support-enabled

weixin_50173184的博客 1836

【四足机器人项目实战】四足机器人运动学、动力学模型

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 TODO:写完再整理 文章目录系列文章目录前言一、四足机器人实际模型的物理难点二、四足机器人运动学模型1.方法一:DH法建立运动学模型(1)运动学建模构型方法(2)运动学模型描述方法1、基于DH法四足机器人单腿运动学模型公式推导(0)DH法科普1)原理2)实现过程3)评价(1)四足机器人的建模规则、坐标系定义及实物参数确定1)标准Denavit-Hartenberg法建模规则2)单腿运动学模型坐标系定义示意图及简化模型3)

qq_35635374的博客 1万+

如何在pycharm中进行scrapy项目的debug

首先得有一个Scrapy项目,我在Desktop上新建一个Scrapy的项目叫test,在Desktop目录打开命令行,键入命令:scrapy startproject test1   目录结构如下:        打开Pycharm,选择open      选择项目,ok    打开如下界面之后,按alt + 1, 打开project...

qq_26449287的博客 1037

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

python command line debug_【已解决】Mac中PyCharm中去加断点实时调试scrapy的项目

折腾:后,在之前已经用过PyCharm去加上断点实时调试别的python程序的前提下。下载希望可以用PyCharm也可以加断点,实时调试scrapy的项目。不过能想到的是,scrapy这种项目,应该属于稍微特殊点的,毕竟可能涉及到多线程同时运行,以及在不同目录下执行scrapy还会有不同的命令(比如在项目根目录下scrapy —help,才能看到crawl子命令)不过在用PyCharm去调试Pyt...

weixin_39520210的博客 296

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

关于Scrapy爬虫项目运行和调试的小技巧(上篇)

扫除运行Scrapy爬虫程序的bug之后,现在便可以开始进行编写爬虫逻辑了。在正式开始爬虫编写之前,在这里介绍四种小技巧,可以方便我们操纵和调试爬虫。 一、建立main.py文件,直接在Pycharm下进行调试 很多时候我们在使用Scrapy爬虫框架的时候,如果想运行Scrapy爬虫项目的话,一般都会想着去命令行中直接执行命令“scrapy crawl crawler_name”,其中craw...

pdcfighting的博客 1437

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

关于Scrapy爬虫项目运行和调试的小技巧(上篇) ...

扫除运行Scrapy爬虫程序的bug之后,现在便可以开始进行编写爬虫逻辑了。在正式开始爬虫编写之前,在这里介绍四种小技巧,可以方便我们操纵和调试爬虫。 一、建立main.py文件,直接在Pycharm下进行调试 很多时候我们在使用Scrapy爬虫框架的时候,如果想运行Scrapy爬虫项目的话,一般都会想着去命令行中直接执行命令“scrapy cr...

测试0901-1 192

Python学习教程:关于Scrapy爬虫项目运行和调试的小技巧-第一讲

Python学习教程:关于Scrapy爬虫项目运行和调试的小技巧 扫除运行Scrapy爬虫程序的bug之后,基本可以开始进行编写爬虫逻辑了。在正式开始爬虫编写之前,在这里跟大家介绍四个小技巧,可以方便我们操...

cpfsdzs2014的博客 182

conda环境下在pycharm中调试scrapy项目

先在计算机目录中找到conda环境中安装的scrapy的comline.py位置。一般是:XXX\envs\scrapy_study\Lib\site-packages\scrapy\cmdline.py。把脚本保存到spiders文件目录内。

abments的博客 516

在 pycharm 中为 scrapy 配置 Run/Debug Configurations

主要是为了在pycharm中可以通过点击Run/Debug 按钮来代替每次在命令行中输入 scrapy crawl crawlName 步骤 1 在scrapy的项目目录中创建一个 start.py 文件,写入如下内容: # -*- coding:utf-8 -*- from scrapy import cmdline cmdline.execute("scrapy crawl craw...

Dolphin's Blog 3278

Python学习教程(Python学习路线):关于Scrapy爬虫项目运行和调试的小技巧-第一讲...

Python学习教程(Python学习路线):关于Scrapy爬虫项目运行和调试的小技巧 扫除运行Scrapy爬虫程序的bug之后,基本可以开始进行编写爬虫逻辑了。在正式开始爬虫编写之前,在这里跟大家介绍四个小技巧,可以方便我们操纵和调试爬虫。 一、建立main.py文件,直接在Pycharm下进行调试 很多时候我们在使用Scrapy爬虫框架的时候,如果想运行Scrapy爬虫项目的话,一般都...

weixin_30477293的博客 117

php 调试 phpcharm,python3-scrapy学习之pycharm配置调试模式

python3-scrapy学习之pycharm配置调试模式龙行Python2018-8-1023000评论最近学习py用上了pycharm调试代码很麻烦每次都要开cmd学到一招:只需要咋项目目录下面新建个py文件 main.py#-*-coding:utf-8-*-fromscrapy.cmdlineimportexecuteimportsysim...

weixin_42363277的博客 236

Python-Scrapy框架Debug模式错误记录

scrapy debugger

JustZzer的博客 1460

mac在pycharm下debug时, import MySQLdb 报这个错误,怎么解决?

mac下抓取伯乐在线网站debug过程中遇到的坑及补充 使用vartualenv创建的python3.x版本在pycharm中运行第四章抓取伯乐在线的例子中 如果遇到以下情况该怎么做 1.ImportError: dlopen(/Users/apple/.virtualenvs/fortune_spider/lib/python3.6/site-packages/_mysql.cpython-3...

姚蔚敏的博客 829
上一篇: 以 Core i9-13900HX 实例讲解CPU概念:物理CPU,内核,逻辑CPU
下一篇: 《Grokking Concurrency》读后感
codists
博客等级 码龄6年 1488粉丝 377原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值