Efficient Dense Modules of Asymmetric Convolution for Real-Time Semantic Segmentation

实时语义分割学习笔记07 Bilateral Network:剩余U块和双重引导注意的双边网络 首先使用并行结构从高分辨率下采样1/8图像分辨率的输出特征图,分辨率分支通过一个3×3的卷积层被放大到其自身大小的一半,并通过线性插值将来自低分辨率分支的1/16图像分辨率的特征图上采样到其自身的两倍。我们将在后面介绍GA的技术细节,但我们需要知道的是,GA的输出与具有相同分辨率的分支的输出具有相同的通道数。因此,我们直接将GA的输出与每个分支的输出在相应的分辨率上相加,实现一个残差结构,最后对低分辨率的特征图进行两次上采样,并与高分辨率的特征图拼接,然后将最终的特征图送入分割头,得到分割预测。 阅读详情

论文地址:https://arxiv.org/pdf/1809.06323.pdf

作者:Shao-Yuan Lo1 Hsueh-Ming Hang1 Sheng-Wei Chan2 Jing-Jhih Lin2 1 National Chiao Tung University 2 Industrial Technology Research Institute sylo95.eecs02@g2.nctu.edu.tw, hmhang@nctu.edu.tw, {ShengWeiChan, jeromelin}@itri.org.tw

1. 首先看一张论文里的贴图:
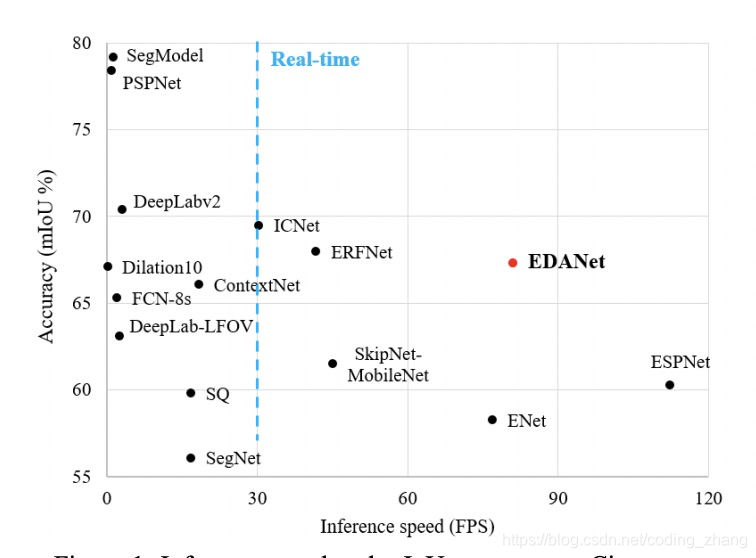
该方法EDAnet比enet更快,而且accuracy也更高。

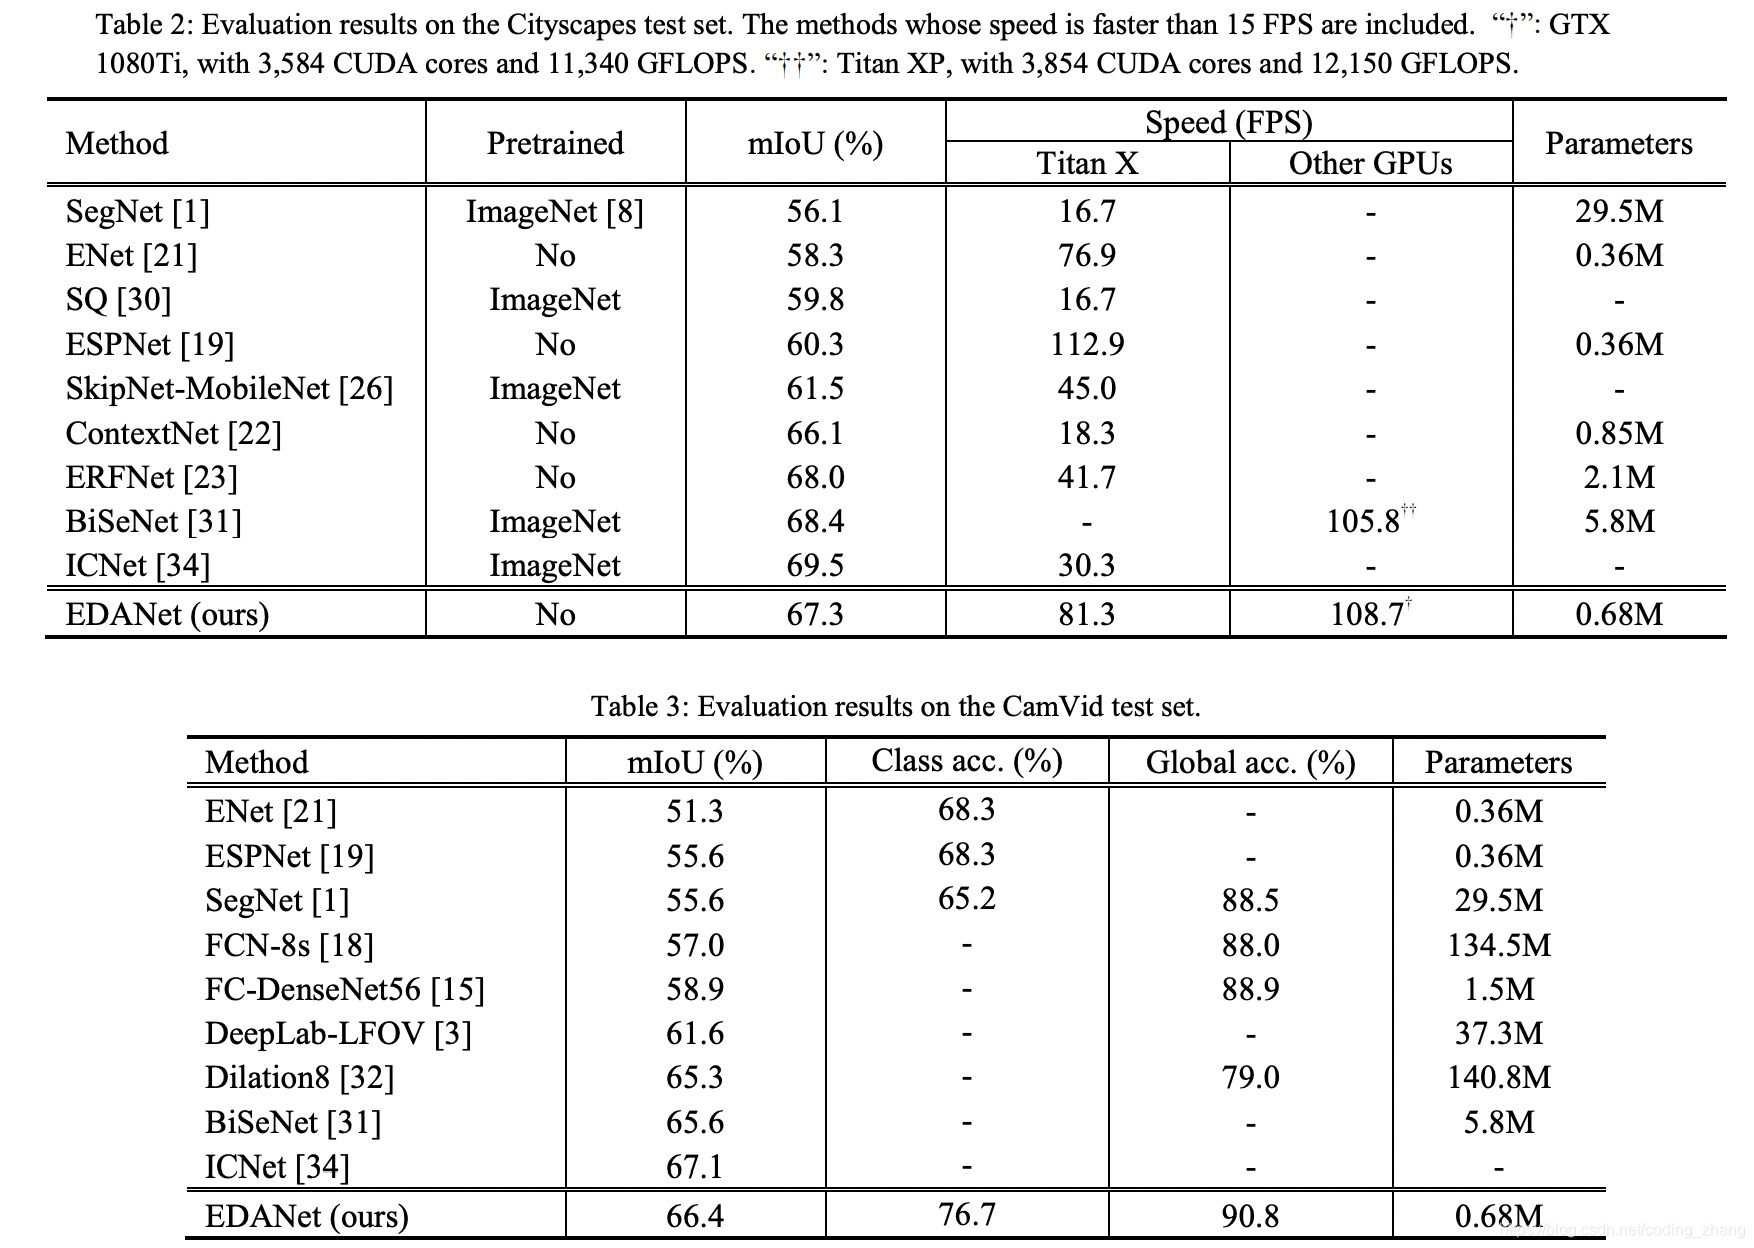
EDAnet采用了Asymmetric convolution,加上空洞卷积和dense connectivity,在速度和准确度上做到了一定的平衡。比icnet快2倍,但是精确度和icnet差不多。而且EDAnet没有采用预训练模型,也没有加入后处理策略,也没有加入额外的context module。所以效果还是非常客观的。在GTX 1080Ti上也能到达108FPS。其中Asymmetric convolution就是想二维的卷积分离成多个一维卷积的组合。譬如原先是n*n的,转换成n*1和1*n.这样子做可以极大的减少参数数量,但是精确率可以降低的比较少。EDAnet也融入了densenet的结构 。dense connect能够很好的提取不同layer的特征并聚合muti scale信息,这对分割任务是非常有帮助的。dense connect也能减少参数量,原因在于由于dense connect的存在,我们每一层layer需要的channel就会变少。空洞卷积则是在保证不损失空间信息的情况下,保证图像的分辨率。

2. 以下是几种网络:

高准确率:

unet ---对称结构的encoder,decoder

DeconvNet ---非对称结构测encoder,decoder

Dilation10 ---context module by dilated convolution 提取muti scale信息

DeepLab --- 提出atrous spatial pyramid pooling (ASPP),采用并行filter 和different dilation rates 来获取muti scale 的信息表达

实时网络:

enet --- 采用了残差链接,通过所见卷积filter来减少计算量

espnet ---采用了efficient spatial pyramid (ESP)模块,在spatial pyramids之前采用point-wise convolution 减少计算消耗。(xception)

icnet 和bisenet

密集连接的网络:

FC-DenseNet ---encoder是densenet。decoder采用了传统的skip connections

SDN --- backbone采用的densenet加上堆叠的deconvolution

3. 网络结构:
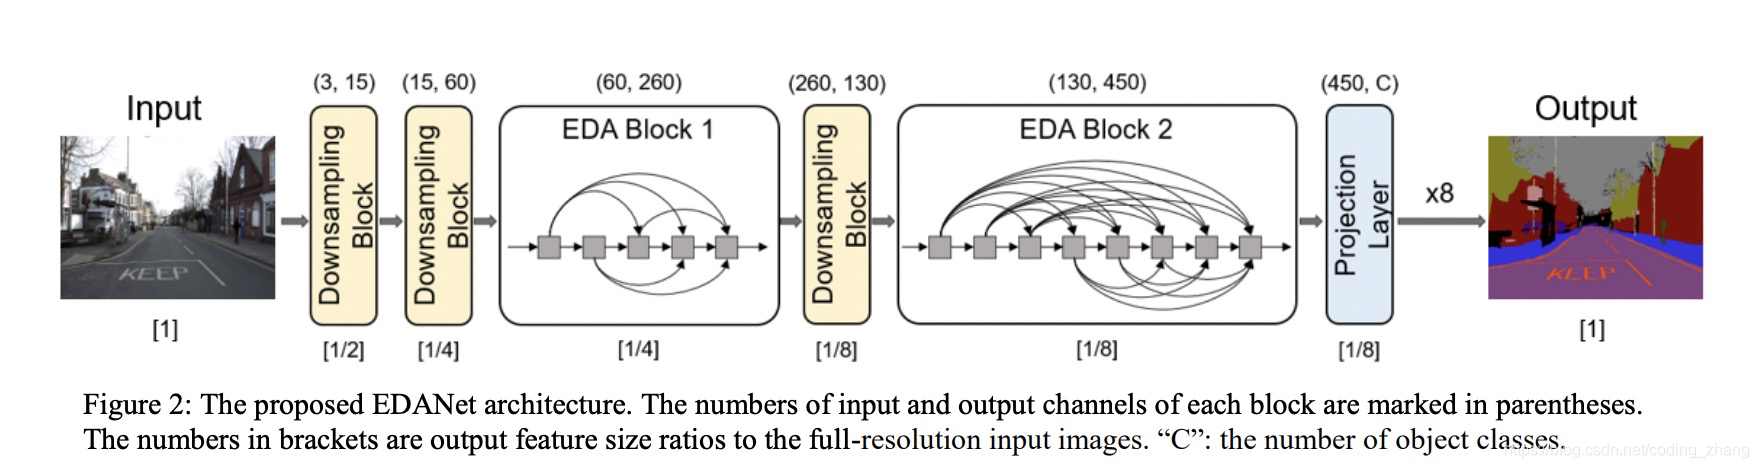
EDAnet 没有decoder部分。个人觉得没有decoder是网络采用了dense connect,计算量总体来说已经有一定量了,如果再加decoder的话,计算量就会更大。

EDAmodule结构图如下:
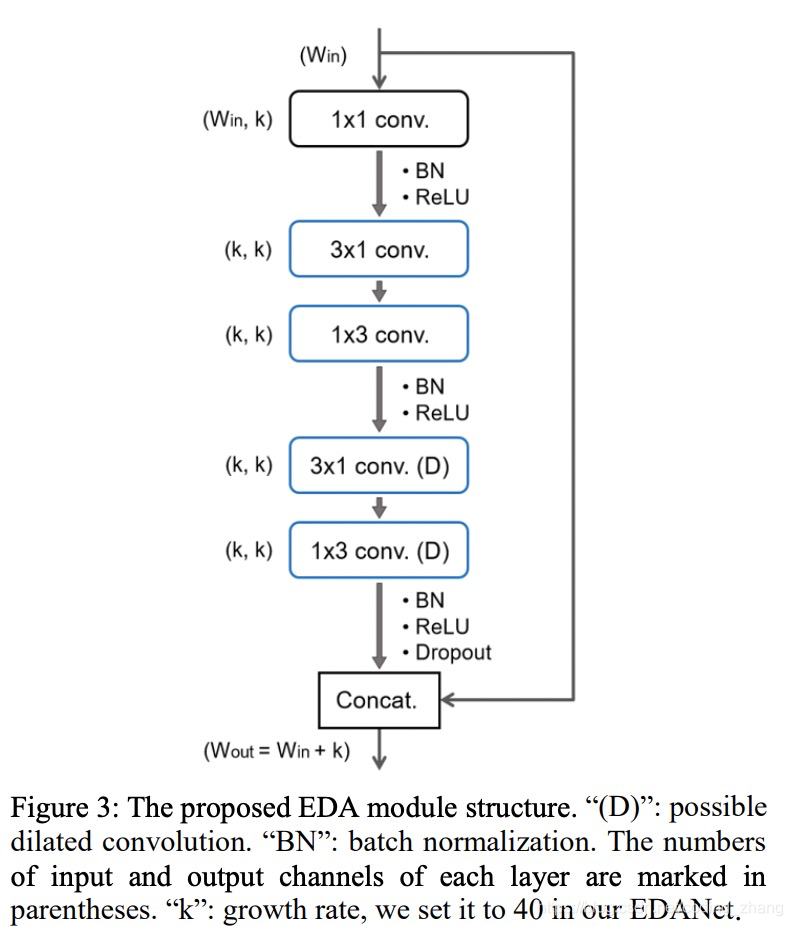
EDA module 由一个point wise convolution layer和一对Asymmetric convolution组成。

Point-wise convolution layer:1*1 的convolution先把通道数降下来。减少参数和计算量

Dense connectivity:

每个EDA block中的EDA module会采用dense net的连接方式。多个EDA module连接相当于多个3*3连接,感受视野会变大,不同的感受视野和dense connet相当于mutil scale的信息有所融合。

4. 网络设计考虑

  •  downsampling 策略:

采用了enet中initial block,并对其做了扩展。
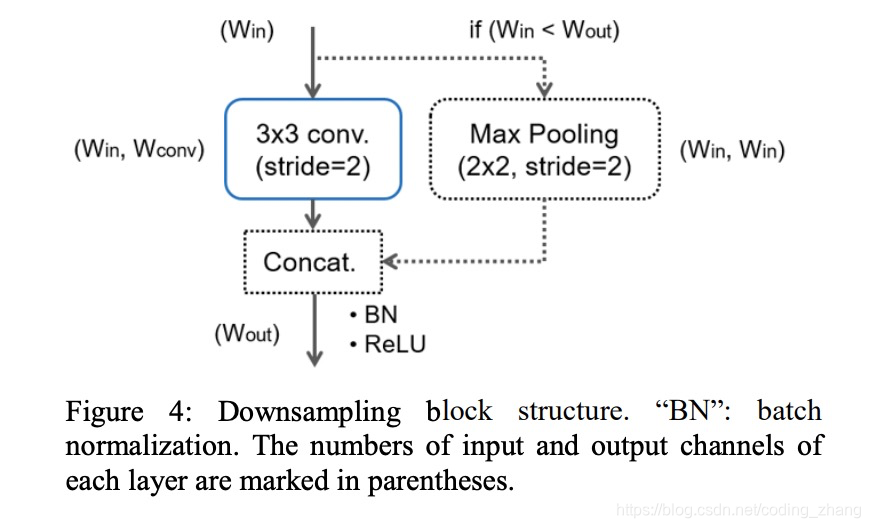
if Wout<Win then 采用3*3 conv s =2   and Wconv = Wout

if Wout>Win then 采用 2*2 maxpooling s =2 并且输入的feature和输出feature 加在一起,Wconv = Wout -Win

EDAnet最后的特征图downsampling到1/8大小,这样保留的信息更充分。

  • Decoding策略:

经过1*1的卷积获取output channel =classes num 数的feature map(应该是包含背景类,还需代码确认)。直接经过一个factor = 8 的bilinear interpolation upsampling 到原图大小。

  • Composite function

采用后置激活函数的方式。参考(Deep residual learning for image recognition CVPR, 2016)这样做,BN可以merge 之前conv的信息,加快inference速度。并在relu和concatenation操作之间采用了dropout。rate =0.02

5. 实验和训练

采用Adam optimization,lr =0.0001,bs =10

学习率策略:poly learning rate policy
(1 − ????/max _????)????? (power为上标)with power 0.9 and initial learning rate
0.0005

class weight策略:采用enet中的策略:
?????? = 1⁄???(?????? + ?), where weset k to 1.12

数据增强:random horizontal flip, the translation of 0~2 pixels on both axes

作者网络feature map数量比借鉴了erfnet网络。

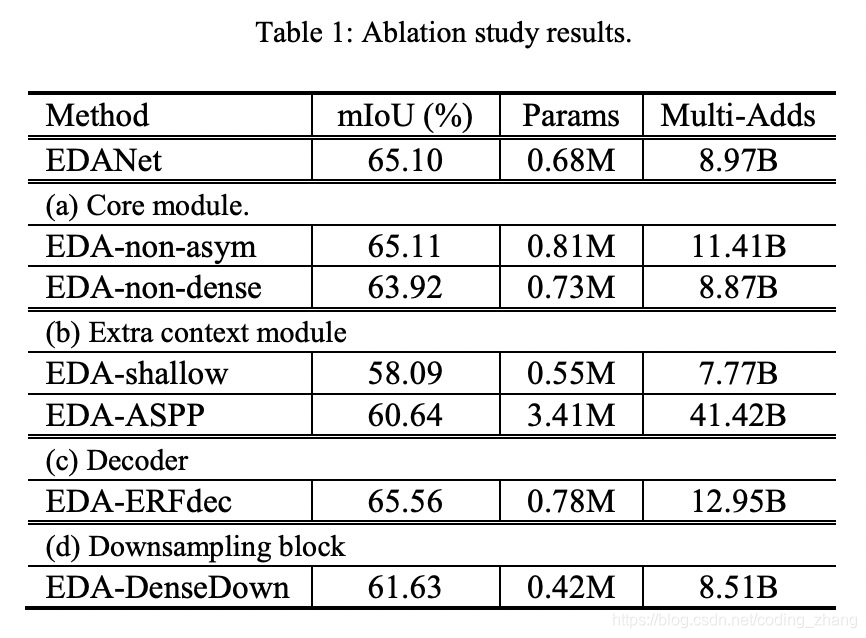
  • 对比asymmetric convolution对网络计算量上的影响

没有采用asymmetric convolution的网络,实验结果表明采用asymmetric convolution的网络和不采用asymmetric convolution的网络准确率差不多的情况下,不采用asymmetric convolution的网络多了27%的计算量。

  • 对比dense connet对于模型准确率上的影响

没有dense connet的网络会比有dense connet的网络准确率低1.18%

  • 对比了dense connet 和ASPP模块在muti scale上的性能
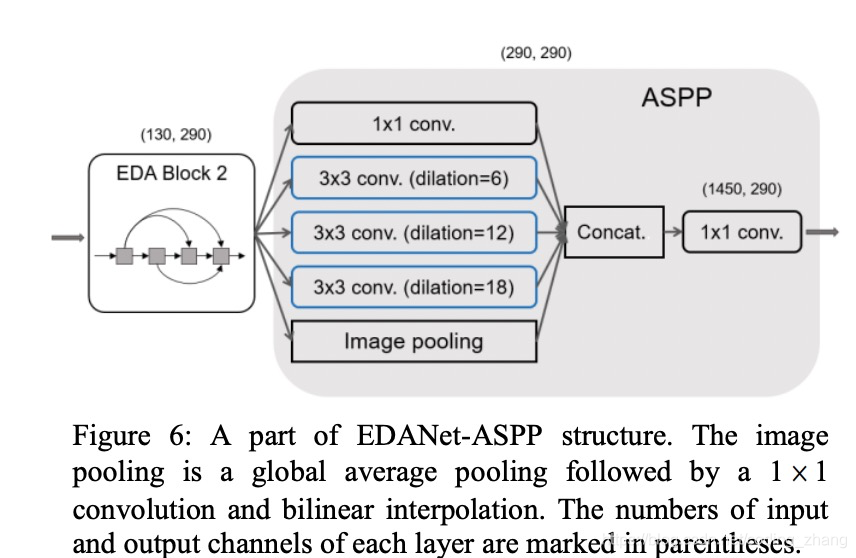
  • 对比了不同的downsampling策略

结果如下:

  • 对比其他网络性能


实时语义分割算法大盘点 语义分割论文 语义图像分割是计算机视觉中发展最快的领域之一,有着广泛的应用。在许多领域,如机器人和自动驾驶汽车,语义图像分割是至关重要的,因为它提供了必要的上下文,以采取行动,基于对场景的理解在像素级。 对于图像的理解有一下几个层次: 分类,即将图像中最具代表性的物体归为某一个类; 带有定位的分类,对分类任务的一个扩展,使用边界框将对象框起来在分类; 目标检测,对多个不同类型的对象进行分类和定位; 语义分割,是对图像中的每个像素进行分类和定位; 实例分割,是 阅读详情

相关推荐

Python连接高斯数据库踩坑实录:从SASL报错到SSL安全连接的完整指南

本文详细记录了Python连接高斯数据库时遇到的SASL authentication报错及其解决方法。通过剖析SASL认证机制,对比了修改数据库配置、使用官方驱动等方案的利弊,并重点提供了通过自动化脚本生成SSL证书,实现安全、免密连接的完整指南,帮助开发者彻底解决连接难题。

weixin_28340315的博客 442

【图像分割论文阅读】Efficient ConvNet for Real-time Semantic Segmentation

文章由西班牙阿尔拉卡大学电子系Eduardo Romera等人完成。发表在2017 IEEE Intelligent Vehicles Symposium (IV). 论文地址:Efficient ConvNet for Real-time Semantic Segmentation 背景 自动驾驶是极具挑战性的任务,需要在感知任务中采用复杂的解决方案,如识别道路、交通灯、车辆行人等。但是...

Ray 1611

①Modbus TCP转Modbus RTU/ASCII网关同步采集无需编程高速轻松组网

MS-A1-50X1系列作为MODBUS TCP通信的服务器进行动作。可通过MODBUS TCP 通信,将 MS-A1-50X1 系列产品通过 RS485 采集的仪器仪表之类的值作为通信数 据输出到 PLC,上位机等。

2401_89571741的博客 1400

【论文阅读笔记】ENet: A Deep Neural Network Architecture for Real-Time Semantic Segmentation

【论文阅读笔记】ENet: A Deep Neural Network Architecture for Real-Time Semantic Segmentation

qq_44653420的博客 492

深度学习-算法工程师岗位面试常见问题及解答

一、相关的问题 深度学习优化学习方法(一阶、二阶) 一阶方法:随机梯度下降(SGD)、动量(Momentum)、牛顿动量法(Nesterov动量)、AdaGrad(自适应梯度)、RMSProp(均方差传播)、Adam、Nadam。 二阶方法:牛顿法、拟牛顿法、共轭梯度法(CG)、BFGS、L-BFGS。 自适应优化算法有哪些?(Adagrad(累积梯度平方)、RMSProp(累积梯度平方的滑动平均)、Adam(带动量的RMSProp,即同时使用梯度的一、二阶矩))。 梯度下降陷入局部最优有什么解决

nobles007820的博客 2924

Matlab安装Embedded Coder Support Package for Texas Instruments C2000 Processors教程

Matlab安装Embedded Coder Support Package for Texas Instruments C2000 Processors

m0_69133594的博客 2837

实时语义分割网络结构汇总

为激发语义分割研究的新想法,特将最近的实时语义分割网络结构进行了汇总,方便大家对实时语义分割网络结构有一个直观快速的了解。 Design of Real-time Semantic Segmentation Decoder for Automated Driving An efficient solution for semantic segmentation: ShuffleNet V2 wi...

sinat_24674017的博客 3549

大语言模型在构建UNSPSC 分类数据中的应用

UNSPSC 是联合国标准产品和服务代码。本文研究如何利用大语言模型生成分类系统的分析

姚家湾博客 1900

YOLOV11|YOLO12改进系列指南

YOLOV11V12改进系列指南,仅仅69.9包含YOLOV11V12模型改进方案、含有440+种改进的集合,且含有多种二次创新和原创改进!

qq_37706472的博客 15万+

ZYNQ实战:手把手教你用AXI4-Full IP核打通PL与PS的DDR数据通道

本文提供了一份详细的ZYNQ实战指南,手把手教你创建并使用具备AXI4-Full Master接口的自定义IP核,实现PL(可编程逻辑)通过AXI HP接口直接读写PS(处理系统)的DDR内存。文章涵盖了从Vivado硬件设计、IP核配置、地址映射到Vitis软件验证的完整流程,并深入解析了数据一致性(禁用Cache)等关键要点,旨在帮助开发者掌握ZYNQ异构计算中高效数据搬运的核心技术。

weixin_29193359的博客 286

DINOv2 基于自定义数据集进行图片分类预测

(前提是安装好pytorch)1. pip安装2. 下载dinov2提供的预训练模型,需要自行前往网站上查找dinov2模型进行下载。模型需要下载三个文件:下载完成后将上述三个文件放置在本地一个名为dinov2_base的文件夹中即可。

sinat_34770838的博客 6668

第J5周:Dense+SE-Net实战

此外,DenseNet的这种连接方式还减少了网络参数的数量,使得模型在保持高性能的同时,具有更高的计算效率和更小的内存占用,这对于实际应用中的模型部署具有重要意义。SE模块作为一种轻量级的注意力机制,其核心思想是通过学习通道间的权重关系,对特征图的通道进行加权,从而增强重要特征的表达,抑制不重要特征的影响。在DenseNet的每个DenseBlock之后添加SE模块,需要确保SE模块的输入和输出特征图的尺寸和通道数与DenseBlock相匹配,这涉及到对特征图尺寸和通道数的精确计算和调整。

DLearner的博客 669

保姆级教程:用AdGuard DNS代理实现全设备广告过滤(含Win/Mac/安卓/iOS配置)

本文提供了一份详尽的AdGuard DNS代理配置指南,帮助用户在全设备(Win/Mac/安卓/iOS)上实现广告过滤。通过系统级DNS设置,AdGuard能有效拦截广告、跟踪器和恶意网站,提升隐私保护和浏览效率。教程涵盖原理说明、各平台配置步骤及高级优化技巧,适合不同技术水平的用户。

weixin_42656416的博客 836

《动手学深度学习》第二十三天---稠密连接网络(DenseNet)

DenseNet作为另一种拥有较深层数的卷积神经网络,具有如下优点: (1) 相比ResNet拥有更少的参数数量. (2) 旁路加强了特征(feature)的重用. (3) 网络更易于训练,并具有一定的正则效果. (4) 缓解了gradient vanishing(梯度消失)和model degradation(模型退化)的问题 梯度消失问题在网络深度越深的时候越容易出现,原因就是输入信息和梯度信...

qq_39594939的博客 3856

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

[论文评析]Densely Connected Convolutional Networks,CVPR,2017

Densely Connected Convolutional Networks,CVPR,2017 DenseNet,

MasterQKK 784

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

深度学习中模块设计汇总(一)

2.1离散小波逆变换 Inverse discrete wavelet transform (IDWT)全局上下文 res-dense 模块包含一个残差密集块 (RDB) 和一个全局上下文块 (GCB)DWT 的本质是将输入特征图分解为高频和低频分量,离散小波变换(DWT)上采样和下采样。1.全局上下文 res-dense 模块。1.2 全局上下文块 (GCB)1.1 残差密集块 (RDB)2.离散小波变换(DWT)............

learning5201的博客 3261

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

深度学习之各种类型的卷积运算

各种卷积运算 group convolution(群卷积或分组卷积) point-wise convolution (点卷积) separable convolution(可分离卷积) depth-wise convolution (深度卷积) dilated convolution (空洞卷积) group convolution(群卷积或分组卷积) 假设上一层的feature map总共有...

梦家の博客 7808

2024 3.16~3.22 周报

密集块,研读SVInvNet

shengMio的博客 966

DenseNet-稠密连接网络

DenseNet的核心:建立的是前面所有层与后面所有层的密集连接(dense connection),加强了前后层之间的信息流通,在一定程度上缓解了梯度消失现象,从而可以将神经网络搭建得很深 通过特征在channel上的连接来实现特征重用(feature reuse)

chang_jx的博客 643

VoVNet:一种实时高效的目标检测Backbone网络【pytorch代码详解】

Pytorch实现代码 2.Factors of Efficient Network Design 在设计轻量级网络时,FLOPs和模型参数是主要考虑因素,但是减少模型大小和FLOPs不等同于减少推理时间和降低能耗。比如ShuffleNetv2与MobileNetv2在相同的FLOPs下,前者在GPU上速度更快。所以除了FLOPs和模型大小外,还需要考虑其他因素对能耗和模型推理速度的影响。这里考虑两个重要的因素:内存访问成本(Memory Access Cost,MAC)和GPU计算效率。 2.1. Mem

Jeremy_lf的博客 2539

结构重参数化之一:ACNet

论文ACNet: Strengthening the Kernel Skeletons for Powerful CNN via Asymmetric Convolution Blocks 代码GitHub - DingXiaoH/ACNet: ACNet: Strengthening the Kernel Skeletons for Powerful CNN via Asymmetric Convolution Blocks 前言 本文提出了一种architecture-neut...

00000cj的博客 5411

【语义分割】DABNet -- Depth-wise Asymmetric Bottleneck for Real-time Semantic Segmentation

Paper:DABNet Github:Code Abstract DABNet 中提出了一个新的 Depth-wise Asymmetric Bottleneck (DAB) module to make a trade-off between accuracy and inference speed. DAB模块中采用了深度可分离卷积、空洞卷积以及分解卷积。此结构 extracts loca...

筱 4081

语义分割--Fully Convolutional DenseNets for Semantic Segmentation

The One Hundred Layers Tiramisu: Fully Convolutional DenseNets for Semantic Segmentation CVPRW 2017 Code: https://github.com/SimJeg/FC-DenseNet本文将 DenseNets 按照 FCN 方式用于 语义分割首先看看 DenseNets 该网络主要由 d

AI小作坊 的博客 7825

【ICCV 2019】ACNet: 使用非对称卷积块增强CNN的卷积核骨架

这篇文章提出了ACNet,使用了一种可以替代原始CNN模型中普通方形$d\times d$卷积核的非对称卷积块( Asymmetric Convolution Block,ACB)。非对称卷积块由卷积核为方形($d×d$)、水平($1×d$)和垂直($d×1$)的三个平行层组成,水平和垂直卷积核与方形卷积核相加可以对方形卷积核的骨架进行增强。利用得到的卷积核参数对原始模型进行部署还可以在不需要额外的计算成本的前提下提升原始模型的准确率:.....................

weixin_44378835的博客 3108

rep论文阅读1:ACNet_Strengthening the Kernel Skeletons for Powerful CNN via Asymmetric Convolution Blocks

结构重参数化系列论文1:ACNet

weixin_44600457的博客 756
上一篇: 学习过程中遇到的bug(持续更新)
下一篇: DABNet: Depth-wise Asymmetric Bottleneck for Real-time Semantic Segmentation
coding_zhang
博客等级 码龄10年 9粉丝 39原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值