python使用tf-idf法判断文本关键词

关键词提取:TF-IDF和n-gram 一:今日相亲 搭档镇楼。 今天的头版给我漂亮的搭档,啥年芳二六、待字闺中之类的矫情话就不说了,希望看到文章的小伙子,如果对眼,请放下你手中的游戏,我可以牵线搭桥。 好好相爱,就是为民除害。 搭档是重庆妹纸,重庆妹纸长得是很水灵。 搭档给我的感觉是情商比较高,比较会捧哏,说话不会闷。 搭档身高160体重100,学历本科水瓶座,目前在重庆的银行工作。 以下为搭档的自我介绍: 性格慢热,... 阅读详情

所有源码都在github上(https://github.com/seasonyao/Keyword-extraction-based-on-tf-idf)

论文的关键词有着其特殊的重要使命,首先当然是方便别人浏览,可以一目了然的知道论文论述的主题,从而决定是否要花费时间阅读正文,节约大家的时间;其次也是更重要的一点,能够方便论文的归类和搜索。所以对待任意一段文本,如果我们能快速得到它的关键词,也就能达到和论文一样的效果。本demo用python语言结合jieba分词库+urllib爬虫库+beautifulsoup的html分析工具实现了tf-idf法判断文本关键词的效果,本文计算tf-idf的值主要是结合了百度文库里对应词出现的词条数来计算,有些地方显的略为复杂是因为加入了自己对文章关键词选取的个人理解,接下来和大家分享。

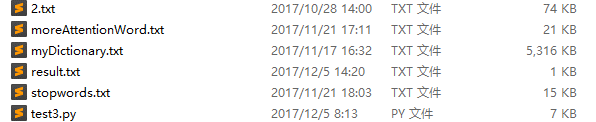
首先你的工作路径下应该是这个样子的
这里写图片描述
2.txt是你要寻找关键词的文本,moreattentionword.txt是你觉得有可能会在你要找的文章的中十分可能出现的一些特殊专业的高频词汇(当然,里面没有内容也可以)。mydictionary.txt是jieba给你的词典+moreattentionword.txt里的内容,result.txt保存下面代码第一部分的分词结果,stopword.txt是停用词表,你也可以加入一些你认为没有的词汇(比如得到的预测关键词有一个很不靠谱的词汇,你就可以加入进以后就再也看不到他了),test.py就是我们的程序文件了

#coding:utf-8
import jieba
jieba.load_userdict("myDictionary.txt")
import jieba.posseg as psg
from collections import Counter
from urllib import request
from urllib.parse import quote
from bs4 import BeautifulSoup
import string
import chardet
import math
import operator; 

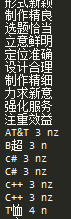
开头给出程序的编码和一些import的操作。load的txt文件是自建的词汇字典,是在jieba原始字典的基础上加入一些自己将要查看的文章有一定可能要用到的一些词汇,它们有的是专业词汇,有的是两三个词汇合在一起构成的词汇(但是在你将要涉猎的论文主题经常出现),因为代码是为有关博物馆的文章所写,所以myDictionary.txt的内容基本上如下截图:
这里写图片描述
按照jieba给出的官方说明,一个词一行,可以在词后边加上词频和词性,以空格隔开。接下来初始化了一堆接下来将要用到的变量,这里逐一介绍:

s = u''
f = open('2.txt',encoding='UTF-8')       
line = f.readline()  
while line:  
    s=s+line
    line = f.readline()  
f.close()

S保存了从txt读进的待操作的文本内容,当然2.txt就是你想要操作的文章

importantWord=[]
f = open('moreAttentionWord.txt',encoding='UTF-8')
line = f.readline()
while line:
	importantWord.append(line)
	line = f.readline()
f.close()

importantWord保存着重要的词汇,和mydictionary新加入的一样就是那些你依仗自己的经验感觉有可能会出现的东西(无论长短),只不过上边的dictionary是给jieba用的,这个importantword我是用来给自己后面处理分出来的词汇用的。

stopWord=[]
f = open('stopwords.txt',encoding='UTF-8')
line = f.readline()
while line:
	stopWord.append(line.split('\n')[0])
	line = f.readline()
f.close()

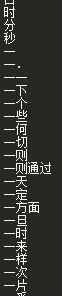
stopword保存着停用词,jieba会根据你的stopwords.txt里的词来对分词出的结果进行筛选,一般保存着如下截图中的这种没有实际意义的词汇。
这里写图片描述

word=[]
cixing=[]
phrasestore=[]
nstore=[]
vstore=[]
sstore=[]

剩下这几个list分别是一会用来保存东西的中间容器,后边再说。

store=[(x.word,x.flag) for x in psg.cut(s)]
for x in store:
	if x in stopWord:
		continue
	word.append(str(x).split(',')[0].split("'")[1])
	cixing.append(str(x).split(',')[1].split("'")[1])

首先利用psg的cut将文本s的内容分词,按照jieba官方给出的格式store链表将会以 词,词性 的形式保存下来(没错,就是这么为所欲为就分好了)。然后对分好的词进行处理,如果在停用词表里就不要这个词,否则把对应的词和词性装入word和cixing链表。

for i in range(1,len(word)):
	if cixing[i]=='n' and cixing[i-1]=='n' and len(word[i])>1 and len(word[i-1])>1:
		phrasestore.append(word[i-1]+word[i])
	if cixing[i]=='v' and cixing[i-1]=='n' and len(word[i])>1 and len(word[i-1])>1:
		phrasestore.append(word[i-1]+word[i])
	if cixing[i]=='n' and cixing[i-1]=='v' and len(word[i])>1 and len(word[i-1])>1:
		phrasestore.append(word[i-1]+word[i])
	if cixing[i]=='a'

TF-IDF原理及其python实现 TF-IDF(Term Frequency-Inverse Document Frequency)算法是常用的一种文本关键词或者文本特征的提取方法。相比于单单考虑单词的出现频率(TF),TF-IDF引入了逆文档频率(IDF),使得我们提取的关键词更加有代表性,而代表性也是TF-IDF方法关注的焦点。 其主要思想是:如果在一篇文章中一个词的出现频率高,并且语料库中其他文章包含这个词的概率小,那么这个... 阅读详情

相关推荐

jieba实现基于tf-idf算法的关键词提取(附完整代码)

@基于itf-idf算法的关键词提取 提出问题 假设我们现在有一篇文章,需要提取这篇文章的关键词,要怎样才能通过计算机实现呢? TF-IDF算法介绍 一篇文章的关键词基本都是能体现文章的内容,而且几乎是在文章中频繁出现的词,统计文章中各个词出现的次数,出现最多的则是这篇文章的关键词了,那具体是怎么统计呢,这里有一个专业术语叫词频(term frequency),简称TF。计算公式如下: TF(词频) = 某次在文章中出现的次数 / 文章中的总词数 举例子:我正在学习人工智能,并且我一定会成功的。 **通过j

qq_45402214的博客 1万+

基于python实现TF-IDF算法

标签:2021.09.27工作内容 参考资料:TF-IDF算法介绍及实现 声明:本文中大量内容转载至参考资料,仅归纳整理和加入部分个人观点心得,侵删 概念 定义 TF-IDF(term frequency-inverse document frequency)是一种用于信息检索与数据挖掘的常用加权技术,常用于挖掘文章中的关键词。 特点:简单高效,用于最开始的文本数据清洗。 TF-IDF (1)TF:词频 可以统计到停用词,并把它们过滤,避免对结果造成影响。 e.g.:“的”、“了”、“是”等等 (2)ID

Daisy_Wang777的博客 1万+

Python实现TF-IDF提取关键词(sklearn库的使用)

TF-IDF算法 TF−IDF=TF×IDFTF-IDF=TF\times IDFTF−IDF=TF×IDF TF=单词w在文档中出现的次数文档总词数TF=\frac{单词w在文档中出现的次数}{文档总词数}TF=文档总词数单词w在文档中出现的次数​ IDF=log文档总数包含单词w的文档数+1IDF=log\frac{文档总数}{包含单词w的文档数}+1IDF=log包含单词w的文档数文档总数​+1 Python实现 TfidfVectorizer是sklearn中的库,可以用来计算TF-IDF值。 fr

杂文集 1万+

基于TF-IDF的关键词提取的实现

简单使用TF-IDF提取关键词

qq_37977007的博客 2736

Python TF-IDF 算法 提取文本关键词

      TF(Term Frequency)词频,在文章中出现次数最多的词,然而文章中出现次数较多的词并不一定就是关键词,比如常见的对文章本身并没有多大意义的停用词。所以我们需要一个重要性调整系数来衡量一个词是不是常见词。该权重为IDF(Inverse Document Frequency)逆文档频率,它的大小与一个词的常见程度成反比。在我们得到词频(TF)和逆文档频率(IDF)以后,将两个值...

lalalawxt的博客 1万+

NLP深入学习(三):TF-IDF 详解以及文本分类/聚类用法

本文主要介绍nlp相关的tf-idf详细用法,包含文本分类、文本聚类等。

日常学习与专研的记录 5718

TF-IDF原理及算法实现

一、TF-IDF算法介绍 TF-IDF(term frequency–inverse document frequency,词频-逆向文件频率)是一种用于信息检索(information retrieval)与文本挖掘(text mining)的常用加权技术. TF-IDF是一种统计方法,用以评估字词对于一个文件集或一个语料库中的其中一份文件的重要程度。字词的重要性随着它在文件中出现的次数成正比增加,但同时会随着它在语料库中出现的频率成反比下降。 TF-IDF主要思想:如果一个单词在该文章中出现的频率(

萤火之光,照亮前行 8204

jieba-基于 TF-IDF 算法的关键词抽取

jieba-基于 TF-IDF 算法的关键词抽取 通过上述三篇文章的介绍(详见其他的博客),接下来将对TF-IDF算法的实现进行介绍。 jieba.analyse.extract_tags(sentence, topK=20, withWeight=False, allowPOS=()) sentence 为待提取的文本 topK 为返回几个 TF/IDF 权重最大的关键词,默认值为 20 ...

Atishoo_13的博客 6253

Python实现TF-IDF算法

TF-IDF(Term Frequency-Inverse Document Frequency)是一种常用的文本挖掘方法,用于衡量一个词语在文档集合或语料库中的重要性。它结合了词频和逆文档频率两个指标,通过计算每个词语在单篇文档中的频率,以及在整个语料库中出现的频率,来判断该词的权重。TF-IDF在信息检索、文本分类、关键词提取等领域具有广泛的应用。我们使用一个简单的新闻文章数据集,包含三篇文章。TF-IDF是一种经典的文本特征表示方法,在文本分析和信息检索中具有重要作用。

闲人编程的博客 2176

Python中实现TF-IDF算法提取关键词指南

本文还有配套的精品资源,点击获取 简介:TF-IDF算法用于评估词在文档集中的重要性,通过Python及其数据处理库实现该算法是信息检索和自然语言处理中的常见做法。本文将介绍如何使用Python和相关库如scikit-learn、nltk等来提取文本中的关键词。首先讨论TF-IDF的基础概念,然后介绍文本预处理、创建TF-IDF模型、提取关键词的具体步骤,并以示例代码说明如...

weixin_35649491的博客 3142

python TF-IDF算法实现文本关键词提取

TF(Term Frequency)词频,在文章中出现次数最多的词,然而文章中出现次数较多的词并不一定就是关键词,比如常见的对文章本身并没有多大意义的停用词。所以我们需要一个重要性调整系数来衡量一个词是不是常见词。该权重为IDF(Inverse Document Frequency)逆文档频率,它的大小与一个词的常见程度成反比。在我们得到词频(TF)和逆文档频率(IDF)以后,将两个值相乘,即可得到一个词的TF-IDF值,某个词对文章的重要性越高,其TF-IDF值就越大,所以排在最前面的几个词就是文章的关键词。 TF-IDF算法的优点是简单快速,结果比较符合实际情况,但是单纯以“词频”衡量一个

薅“刷宝”羊毛的autojs脚本教程,简单粗暴好用!!!

本教程旨在帮助大家实现用手机或闲置手机来进行“刷宝”平台的收益,能薅多少米就看你的本事了,作者教你的是如何用autojs来进行脚本的挂机教程,掌握了这个思路后,你可以根据自己的实际需要来改进脚本或者撸别的平台:) 适用系统,**android4.0以上,苹果机暂不适用**(大多数android系统手机都是7.0以上,要查看自己手机是android几,见文件夹“视频教程-基础”>1.查看android版本的方法)

rousseaou8的博客 8万+

2021秋-北邮计算机导论期末考试(BUPT)

2021秋-北邮计算机导论期末考试(BUPT) 难度较低适合新手练习

weixin_73985779的博客 1500

深入理解梅尔刻度、梅尔滤波器组和梅尔时频谱图

读取一段音频,使用短时傅里叶变换,得到普通的时频谱图,然后绘制梅尔滤波器组,值得注意的是,librosa的梅尔滤波器组函数还带有权重归一化功能,即对一个三角形滤波器的每个权重,都除以该三角形的面积,如果不希望进行该归一化,设置参数。从公式可见,对数部分可以以自然对数为底数,也可以以10为底数,不同的底数对应不同的系数,要确定当前的系数,只需要代入(1000Hz, 1000mel)即可。其中,m是当前滤波器的序号,表征了当前的时间段,k是当前频率的序号,表征了当前正在对哪一频率的。

DEDSEC_Roger的博客 1万+

openclaw + ollama本地模型 + 飞书平台 windows平台部署教程

本教程将指导您在 Windows 10/11 环境下,通过 Ollama 运行本地模型,并结合 OpenClaw 接入飞书,搭建一个完全本地化的 AI 助手。

专注于技术研发行业技术主要有AI人工智能视觉识别、物联网技术、电商平台、app原生技术、微信小程序、鸿蒙语言开发、办公企业oa、ERP等,致力于做东半球最优秀的程序员 2175

【深度解析TI InstaSPIN】无传感器FOC控制的核心方案

TI InstaSPIN通过“自动识别+通用观测器+开源工具链”的组合,解决了无传感器FOC控制开发难度大、周期长的核心痛点。其核心优势在于快速统一软件观测器的通用性与高精度,以及Fly Start闭环零速启动策略的高可靠性,可适配空调压缩机等家电电机的复杂运行需求。在空调外机双电机控制场景中,InstaSPIN与TI C2000系列MCU(F280013x/F28E12x)完美契合,借助MCU的高性能DSP内核与丰富外设,可实现双电机的精准同步控制,同时降低硬件成本与开发周期。

昔时扬尘处 328

【报错】(pycharm运行程序)OSError: [WinError 1114] 动态链接库(DLL)初始化例程失败。 Error loading

1 报错 OSError: [WinError 1114] 动态链接库(DLL)初始化例程失败。 Error loading 2 分析原因 通过 activate Distance 进行自己创建的 Distance 虚拟环境中,输入python会显示环境中python的版本信息,再依次import,显然不会报错。 这是因为在Anaconda的环境下有支持 import torch 的 dll,而在PyCharm中使用的是自己创建的新环境,还缺少相应支持的dll,仅需在PyCharm中配置环境变量。.

静谧、淡雅 8623

【数据集】全球预报系统GFS概述:数据下载及处理

【数据集】全球预报系统GFS概述:数据下载及处理

WW、forever的博客 5751

Natural Language Processing

作者:禅与计算机程序设计艺术 1.简介 自然语言处理(NLP)是研究如何使计算机理解和处理自然语言的理论和方法,目的是让电脑更好的理解、获取、生成、存储和沟通人类语言。20世纪80年代末,IBM的三位博士陈天奇、周博磊和王力雄在贝尔实验室创建了首个自然语言处理系统——“布莱克多·艾森豪威尔”(Bletc

AI天才研究院 731

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

上一篇: HTTP学习与Web服务器编程
下一篇: 爬取百度对应词汇页面量
codes_first
博客等级 码龄10年 255粉丝 34原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值