Openai_clip,一个厉害的多模态Python库!

多模态搜索引擎——基于CLIP实现 本文提出一个多模态(图文本地搜索引擎),基于CLIP模型实现,并给出相关数据和代码在Github上。 阅读详情

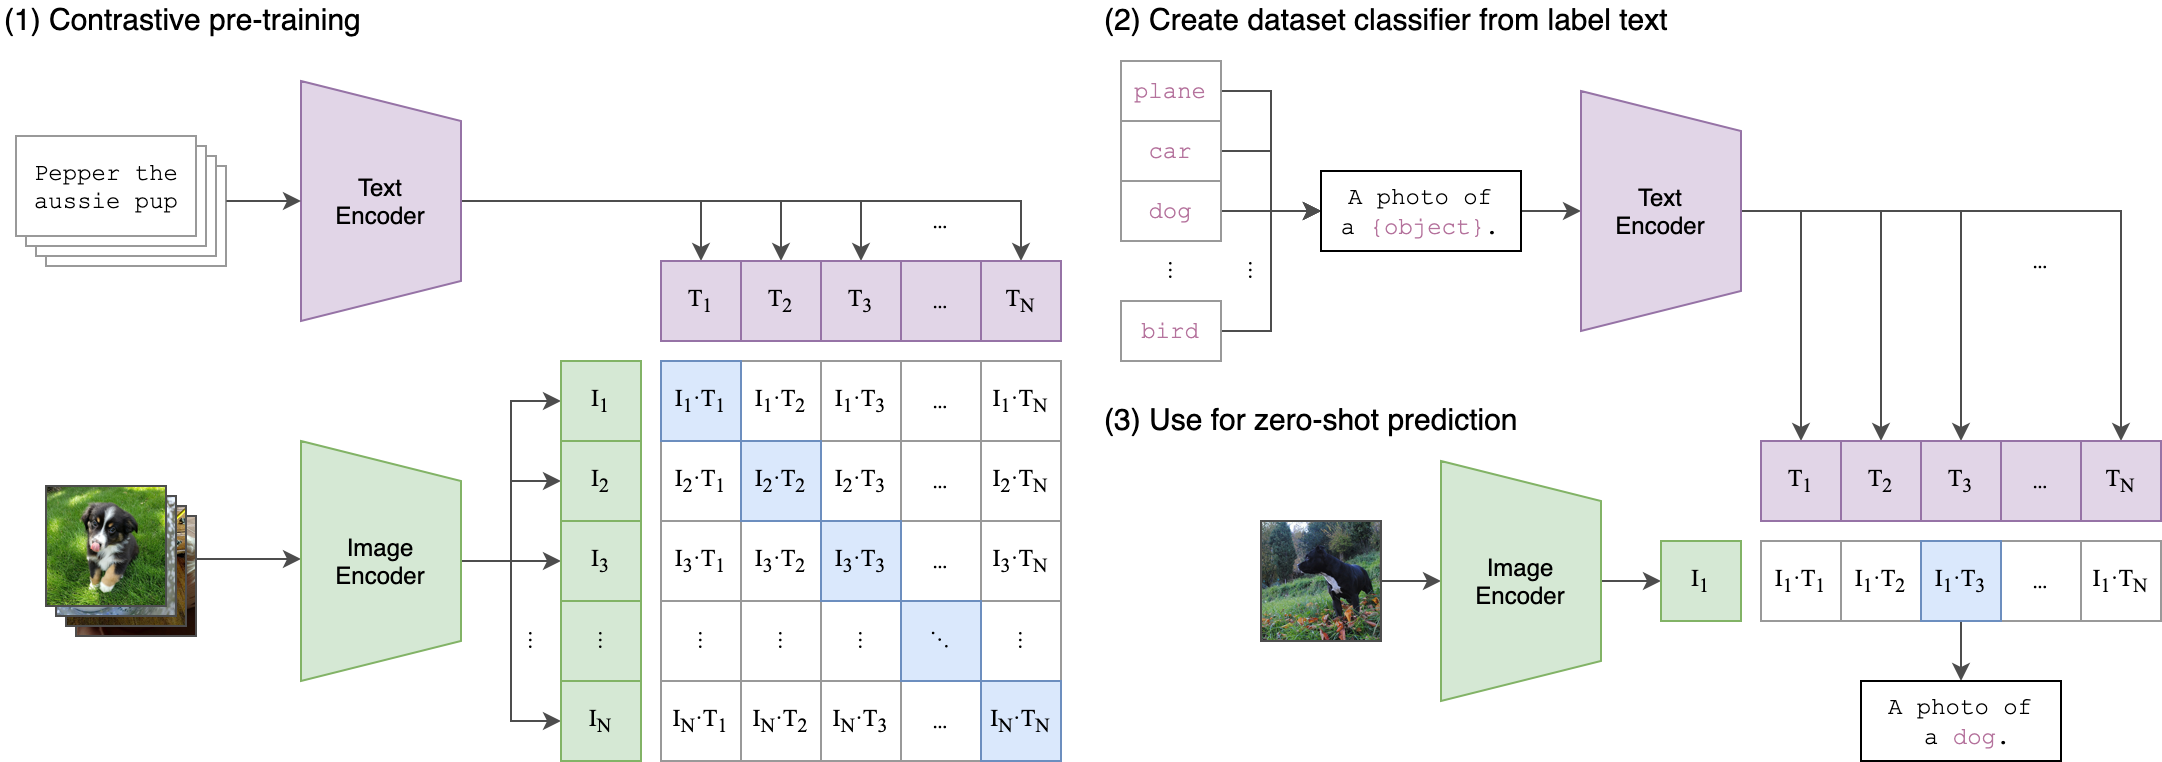
CLIP(对比语言-图像预训练)  是 OpenAI 开发的一种多模态学习架构。它从自然语言监督中学习视觉概念。它通过在包含图像及其相应文本描述的大规模数据集上联合训练模型来弥合文本和视觉数据之间的差距。这类似于 GPT-2 和 GPT-3 的零样本能力。


Stars 数26758
Forks 数3384

主要特点

它通过联合训练两个编码器来工作。一个编码器用于图像(Vision Transformer),另一个编码器用于文本(基于 Transformer 的语言模型)。

  • 图像编码器:图像编码器从视觉输入中提取显著特征。此编码器将“图像作为输入”并生成高维向量表示。它通常使用 卷积神经网络 (CNN) 架构(如ResNet)来提取图像特征。

  • 文本编码器:文本编码器对相应文本描述的语义进行编码。它以“文本标题/标签作为输入”并生成另一个高维向量表示。它通常使用基于 Transformer 的架构(如 Transformer 或 BERT)来处理文本序列。

  • 共享嵌入空间:两个编码器在共享向量空间中生成嵌入。这些共享嵌入空间允许 CLIP 比较文本和图像表示并了解它们的底层关系。

GitHub:https://github.com/openai/CLIP

OpenAI——CLIPs(代码使用示例) 阅读详情

相关推荐

Openai连接文本和图像CLIP模型(Huggingface版)zero-shot分类代码案例

主要和大家分享一下Openai大热的连接文本和图像CLIP模型(Huggingface版)zero-shot分类代码案例,其实还是可以看到一些GPT的影子,模型本身比较简单,没什么难度,或许是将来的趋势吧。可以运用到更多的下游任务。.........

Allen_人工智能与大数据 6426

openai多模态大模型:clip详解及实战

零次学习(Zero-Shot Learning,简称ZSL)假设斑马是未见过的类别,但根据描述外形和马相似、有类似老虎的条纹、具有熊猫相似的颜色,通过这些描述推理出斑马的具体形态,从而能对斑马进行辨认。零次学习就是希望能够模仿人类的这个推理过程,使得计算机具有识别新事物的能力,如下图所示。如今深度学习非常火热,使得纯监督学习在很多任务上都达到了让人惊叹的结果,但其限制是:往往需要足够多的样本才能训练出足够好的模型,并且利用猫狗训练出来的分类器,就只能对猫狗进行分类,其他的物种它都无法识别。

十年以上架构设计经验,专注于软件架构和人工智能领域,对机器视觉、NLP、音视频等领域都有涉猎 7万+

CLIP跨语言多模态模型 pytorch下安装

github地址 GitHub - openai/CLIP: Contrastive Language-Image Pretraining​​​​​​​ 创建python环境 conda create -n CLIP python=3.8 安装pytorch和torchvision conda install --yes -c pytorch pytorch=1.7.1 torchvision cudatoolkit=11.0 下载包:ftfy regex tqdm 和CLIP pip

MISS_XDY的博客 8460

OpenAI最重要的模型【CLIP】

CLIP 代表 Contrastive Language-Image Pretraining:CLIP 是一个开源、多模态、零样本模型。给定图像和文本描述,该模型可以预测与该图像最相关的文本描述,而无需针对特定任务进行优化。开源:该模型由 OpenAI 创建并开源。稍后我们将看到有关如何使用它的编程教程。多模态:多模态架构利用多个领域来学习特定任务。CLIP 结合了自然语言处理和计算机视觉。零样本:零样本学习是一种在未见过的标签上进行泛化的方法,无需专门训练来对它们进行分类。

新缸中之脑 1万+

别再手动打标签了!用OpenAI CLIP模型5分钟搞定自定义图片分类(附Python代码)

本文介绍了如何利用OpenAI CLIP模型的zero-shot能力快速构建自定义图片分类器,无需训练数据即可在5分钟内完成分类任务。通过详细的Python代码示例和优化技巧,帮助开发者高效实现图片分类,适用于电商、内容审核和艺术风格识别等多种场景。

weixin_28718793的博客 327

Minimax H3多模态模型实战:从CLIP原理到“无效输入”问题深度排查

多模态大模型通过融合视觉与语言理解能力,正成为AI应用的新前沿。其核心原理在于利用如CLIP(Contrastive Language-Image Pre-training)等视觉编码器,将图像与文本映射到统一的语义空间进行对齐,从而实现跨模态的理解与生成。这一技术为图像描述、视觉问答、内容创作等场景带来了巨大价值。然而,在实际工程集成中,开发者常会遇到模型对特定输入“视而不见”或返回“无效的clip输入”等问题,这往往源于图像预处理、特征空间对齐或API调用格式等底层细节的偏差。本文以Minimax H3

weixin_34238633的博客 370

【Python】CLIP 库:CLIP多模态模型的库

CLIP(Contrastive Language–Image Pretraining)是 OpenAI 提出的 多模态模型,可以将图像和文本映射到同一个嵌入空间中,从而实现图文匹配、零样本分类、图文检索等任务。虽然 OpenAI 没有单独发布一个叫 clip 的官方 Python 库,但社区版本如 open_clip, CLIP from OpenAI, CLIP-as-service 等都被广泛使用。加载模型:clip.load(),文本编码:model.encode_text(),图像编码:model

彬彬侠的博客 2012

CLIP+FAISS实现语义图像搜索:零样本多模态检索实战

语义图像搜索是一种将文本与图像映射到统一向量空间的跨模态检索技术,其核心在于突破传统关键词匹配与像素比对的局限,实现‘用自然语言描述找图’的能力。它依赖多模态预训练模型(如CLIP)完成图文联合表征,再通过高效近似最近邻算法(如FAISS)支撑海量向量实时检索。该技术具备强零样本泛化能力,无需微调即可理解复杂语义组合,显著提升内容理解深度与检索准确率。典型应用场景包括数字资产库智能检索、文生图提示优化、博物馆藏品语义导航等。本文聚焦CLIP向量归一化、FAISS索引构建及端到端工程落地细节,解决实际部署中的

weixin_34072458的博客 534

CLIP包安装以及如何安装github上的python包

三种方法安装clip包,以及如何对github是上的包如何安装有git安装和离线zip安装两种方法。

qq_52476897的博客 1万+

多模态大模型学习主线:CLIP、SAM、BLIP、DALLE2核心解析

在人工智能技术快速迭代的今天,多模态大模型已成为联接视觉与语言的关键技术。其核心原理在于建立不同信息形态间的语义对齐,让机器能够像人类一样理解图文、视频等内容。通过对比学习、扩散模型引导、提示分割等机制,模型在图像匹配、内容生成、目标分割等任务中展现出强大能力。从CLIP的图文对齐到SAM的可提示分割,再到BLIP的统一理解与生成,这些代表性模型共同构成了多模态技术的基础框架。掌握这些模型,有助于开发者快速落地内容审核、商品检索、医学影像分析等实际工程场景。本文围绕多模态大模型的四类核心模型,系统梳理了它们

weixin_33923762的博客 374

多模态大模型学习路线:从CLIP、BLIP到DALL-E实战指南

多模态学习作为人工智能的重要分支,通过让机器同时处理文本、图像、音频等不同模态数据,模拟人类的多感官认知方式。其核心原理基于对比学习技术,将不同模态的特征映射到统一语义空间,实现跨模态的语义对齐。这种技术价值在于能够构建更智能的AI系统,具备强大的零样本推理和跨模态生成能力。在实际应用场景中,多模态技术已广泛应用于智能客服、内容创作、自动驾驶等领域。随着大模型技术的发展,多模态与大模型的结合创造了更强大的AI系统,其中CLIP模型通过对比学习实现图像文本语义对齐,BLIP系列在理解生成任务上表现出色,DAL

weixin_34356310的博客 392

多模态————CLIP

批量大小(N=4),即每次训练4组图文对# 图文编码后的向量维度(D=512),统一图像和文本的输出维度# 温度系数τ(CLIP默认0.07),用于缩放相似度,调节损失分布# 设备选择:优先使用GPU(cuda),无GPU则用CPU核心逻辑:CLIP 通过跨模态对比学习,让图文编码器学习 “匹配对向量相似、不匹配对向量疏远”,核心是归一化 + 余弦相似度 + InfoNCE 损失;关键公式:损失函数由图像到文本、文本到图像两部分交叉熵组成,温度系数 τ 用于调节相似度分布;

2402_89488435的博客 1154

CLIP openai多模 图形-文字匹配;文字query搜索图片;以图搜图;再训练

参考:https://github.com/openai/CLIP 安装环境 pip install torch==1.7.1+cpu torchvision==0.8.2+cpu -f https://download.pytorch.org/whl/torch_stable.html pip install ftfy regex tqdm 1、输入图片检索是什么内容 import torch import clip from PIL import Image device = "cud

weixin_42357472的博客 4883

OpenAI CLIP 深度拆解:ViT 图像编码 + 图文对比预训练,附图文相似度检索完整代码

OpenAI CLIP是一个开创性的多模态模型,通过对比学习将文本和图像嵌入到共同语义空间,实现跨模态理解。该模型采用双流网络架构,分别处理图像(ViT编码器)和文本,优化匹配对的相似度。CLIP在零样本预测、跨模态检索等任务中表现优异,其训练数据来自4亿图文对的WIT数据集。文章详细解析了CLIP的技术原理、训练流程和应用场景,并提供了图文相似度检索的完整代码示例,展示了如何使用ViT-B/32模型进行图像特征提取和文本匹配。CLIP的创新之处在于突破传统单模态限制,为多模态AI发展提供了重要参考。

weixin_52610848的博客 1365

Reeds-Shepp曲线公式推导及代码实现-第二部分(共三部分)

文章目录2. Reeds-Shepp求解2.1 L+S+L+L^+S^+L^+L+S+L+2.2 L+S+R+L^+S^+R^+L+S+R+2.3 L+R−L+L^+R^-L^+L+R−L+2.4 L+R−L−L^+R^-L^-L+R−L−2.5 L+R+L−L^+R^+L^-L+R+L−2.6 L+Rβ+Lβ−R−L^+R_{\beta}^+L_{\beta}^-R^-L+Rβ+​Lβ−​R−2.7 L+Rβ−Lβ−R+L^+R_{\beta}^-L_{\beta}^-R^+L+Rβ−​Lβ−​R+2.8

jianmo的博客 1213

画个板子玩一玩STM32F030F4P6,也许是最便宜的32bit MCU

前言,什么是STM32F030F4P6 STM32目前最便宜的芯片之一应该就是这一块,STM32F030F4P6,这一个芯片没有USB,但是其他都有,引脚少,价格低廉,如果找不到原厂,可以买替代的国产芯片,性能也一样。 不管怎么样也是Cortex-M0,比8bit和16bit的性能都强,总的来说就是低价,引脚少,体积小的同时,还容易开发,有很多模拟输入可玩,还有SPI,硬件I2C等等 所以,这一款MCU真的是从理论来说又便宜又好用,非常适合把玩。 画个板,最小系统 STM32F030其..

arenascat的博客 2万+

别再只把CLIP当分类器了!用Python+OpenAI CLIP玩转图像搜索与创意应用(附完整代码)

本文深入探讨了OpenAI CLIP模型在图像搜索与创意应用中的潜力,展示了如何利用Python构建跨模态图像搜索系统。通过实战代码示例,详细解析了CLIP的语义理解机制、向量数据库选型及电商场景下的智能应用,帮助开发者解锁这一多模态大模型的创新价值。

weixin_33671935的博客 421

set_data_check专题[使用,report_timing,setup/hold检查]

set_data_check用于约束『数据-对-数据』的『建立保持』时间检查,通常被称为非时序约束 ( non-sequential constraints ), 理论上set_data_check 可以设在任意的两个data pin 上,其中一个pin 称为 constrained pin 类似于寄存器的data pin, 另一个pin 称为related pin 类似于寄存器的clock pin.

cy413026的博客 1万+

基于QC8380 高通骁龙系列Windows系统平台进行OPENAI-CLIP应用开发示例教程

通过以上步骤,您应该能够在高通骁龙系列C8380 Windows系统平台上成功搭建环境并运行OpenAI CLIP应用。如果您在开发过程中遇到任何问题,建议查阅官方文档或寻求社区帮助。祝您开发顺利!

weixin_38498942的博客 1414

QT下利用FFTW实现功率谱密度分析(周期图法)

写在前面 出于项目需求,需要在QT的msvc 2015编译环境下实现功率谱密度估计。 所以这个需求很直接的关键词就是 1. C++ 2. QT 3. 傅里叶变换 4. 功率谱密度估计 但是在网上搜索了很久,没有一个非常直接的答案。所以我觉得很有必要写一篇文章来说明,在QT msvc2015 32bit环境下如何实现功率谱密度估计。 本文并没有经过严格编辑,但代码是已经可以跑通的,如...

李时珍食疗志的博客 5224

别再瞎试了!手把手教你用DC NXT的compile_ultra命令搞定物理综合(附完整脚本)

本文详细介绍了如何使用DC NXT的compile_ultra命令进行物理综合,包括环境配置、设计库创建、RTL加载、物理约束加载等关键步骤。通过实战示例和完整脚本,帮助工程师快速掌握TOPO模式下的物理综合流程,提升设计效率。

weixin_30413765的博客 295

Daily-LLM多模态应用:从CLIP到DALL-E的完整技术解析

想要掌握当今最热门的**多模态人工智能技术**吗?Daily-LLM项目为你提供了从基础到前沿的完整学习路径!🔥 本文将带你深入探索**多模态应用**的核心技术,从CLIP的对比学习到DALL-E的扩散模型,为你揭开AI如何理解并生成图文内容的神秘面纱。 ## 🎯 多模态AI:视觉与语言的完美融合 **多模态人工智能**是当今AI领域最激动人心的突破之一。想象一下,AI不仅能看懂图片,还能

gitblog_00815的博客 555

【解决方案】使用transformer指定显卡后,模型依然加载到默认第1张显卡上

按理说指定了环境变量为后面几张显卡,模型会自动加载到我们指定的显卡上。可是查看gpu使用情况,发现还是加载在了第一张显卡上,这是为啥呢?

m0_56745306的博客 2442

mmaction2 CLIP4Clip 实战指南:基于 CLIP 的端到端视频-文本检索

视频-文本检索是多模态理解中的核心任务:给定一段视频,在大规模文本库中召回相关描述(或反之)。mmaction2 提供的 CLIP4Clip 方案,将 OpenAI CLIP 在图像-文本上预训练获得的视觉概念知识,以端到端的方式迁移到视频-文本检索任务上:用 CLIP 视觉编码器逐帧编码视频帧,再用一个轻量 adapter(默认简单均值池化)把帧级特征聚合成视频级特征,与文本特征在共享嵌入空间中

gitblog_01152的博客 155

2026年1至9月武汉市房地产价格深度分析报告

本报告基于2026年1月至9月武汉市实际成交案例,从成交价格、区域分布、户型结构、价格走势等维度进行深度分析。数据来源包括武汉市住房保障和房屋管理局备案数据、主要中介机构成交记录及典型楼盘网签案例,覆盖全市15个行政区及主要功能板块。

王国平的博客 339

23 中望CAD二次开发(ZRX C++)-自定义实体(二)

本文详细介绍了自定义图形实体,如何实现几何变换、捕捉、节点编辑,并介绍了CAD代理的概念。

cilvsuanna的博客 439
上一篇: Hugging Face Transformers:自然语言处理的革命性工具!
下一篇: Zerox:gpt-4o-mini 加持的零配置高效 OCR 神器
开源项目精选
博客等级 码龄6年 2011粉丝 227原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值