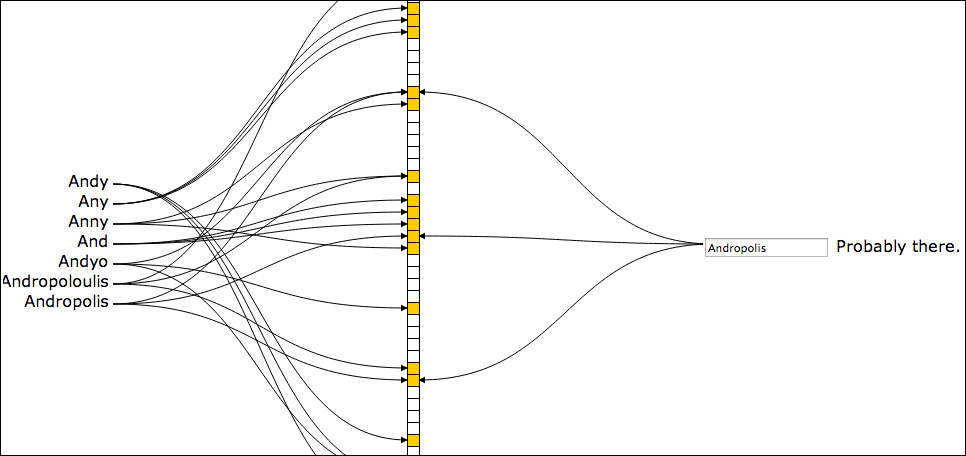
布隆过滤器(Bloom Filter)的原理和应用

Redis-布隆过滤器(Bloom Filter)详解 什么是布隆过滤器 布隆过滤器(Bloom Filter)是 1970 年由布隆提出的,是一种非常节省空间的概率数据结构,运行速度快,占用内存小,但是有一定的误判率且无法删除元素。它实际上是一个很长的二进制向量和一系列随机映射函数组成,主要用于判断一个元素是否在一个集合中。 通常我们都会遇到判断一个元素是否在某个集合中的业务场景,这个时候我们可能都是采用 HashMap的Put方法或者其他集合将数据保存起来,然后进行比较确定,但是如果元素很多的情况下,采用这种方式就会非常浪费空间,最终达到瓶颈,检索速度也会越 阅读详情

布隆过滤器的概念

布隆过滤器(Bloom Filter)是1970年由布隆提出的。它实际上是一个很长的二进制向量和一系列随机映射函数。布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率和查询时间都比一般的算法要好的多,缺点是有一定的误识别率和删除困难。

如果想要判断一个元素是不是在一个集合里,一般想到的是将所有元素保存起来,然后通过比较确定。链表,树等等数据结构都是这种思路。但是随着集合中元素的增加,我们需要的存储空间越来越大,检索速度也越来越慢(O(n),O(logn))。不过世界上还有一种叫作散列表又叫哈希表(Hash table)的数据结构。它可以通过一个Hash函数将一个元素映射成一个位阵列(Bit array)中的一个点。这样一来,我们只要看看这个点是不是1就可以知道集合中有没有它了。这就是布隆过滤器的基本思想。

Hash面临的问题就是冲突。假设Hash函数是良好的,如果我们的位阵列长度为m个点,那么如果我们想将冲突率降低到例如 1%, 这个散列表就只能容纳m / 100个元素。显然这就不叫空间效率了(Space-efficient)了。解决方法也简单,就是使用多个Hash,如果它们有一个说元素不在集合中,那肯定就不在。如果它们都说在,虽然也有一定可能性它们在说谎,不过直觉上判断这种事情的概率是比较低的。

布隆过滤器的算法思想

  1. 首先需要k个hash函数,每个函数可以把key散列成一个整数。

  2. 初始化时,需要一个长度为n比特的数组,每个比特位初始化为0。

  3. 当个key要加入集合时,用k个hash函数计算出k个散列值,并把数组中对应的比特位置置为1。

  4. 判断某个key是否在集合时,用k个hash函数计算出k个散列值,并查询数组中对应的比特位,如果所有的比特位都是1,认为在集合中。
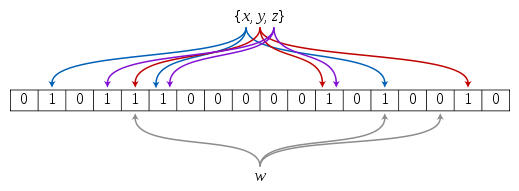
    布隆过滤器图1

    布隆过滤器图2

数据结构如上图所示。布隆过滤器其中重要的实现就是位图的实现,也就是位数组,并且在这个数组中每一个位置只占有1个bit,而每个bit只有0和1两种状态。如上图所示,bitarray也叫bitmap,大小就是布隆过滤器的大小。

假设一种有k个哈希函数,且每个哈希函数的输出范围都大于m,接着将输出值对k取余(%m),就会得到k个[0, m-1]的值,由于每个哈希函数之间相互独立,因此这k个数也相互独立,最后将这k个数对应到bitarray上并标记为1(涂黑)。等判断时,将输入对象经过这k个哈希函数计算得到k个值,然后判断对应bitarray的k个位置是否都为1(是否标黑),如果有一个不为黑,那么这个输入对象则不在这个集合中,如果都是黑,那说明在集合中,但有可能会误,由于当输入对象过多,而集合也就是bitarray过小,则会出现大部分为黑的情况,那样就容易发生误判!因此使用布隆过滤器是需要容忍错误率的,即使很低很低!

如果输入量过大,而bitarray空间的大小又很小,那么误判率就会上升。那么bitarray空间大小怎么确定呢?不要慌,已经有人通过数据推倒出公式了!

假设输入对象个数为n,bitarray大小(也就是布隆过滤器大小)为m,所容忍的误判率p和哈希函数的个数k。计算公式如下:(小数向上取整)
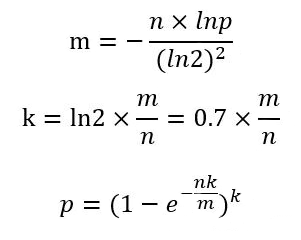
位图大小计算公式

注意:由于我们计算的m和k可能是小数,那么需要经过向上取整,此时需要重新计算误判率p。

假设一个网页黑名单有URL为100亿,每个样本为64B,失误率为0.01%,经过上述公式计算后,需要布隆过滤器大小为25GB,这远远小于使用哈希表的640GB的空间。

并且由于是通过hash进行查找的,所以基本都可以在O(1)的时间完成。

布隆过滤器的优点&缺点

优点:布隆过滤器在空间和时间方面都有巨大的优势。布隆过滤器存储空间和插入/查询时间都是常数。另外, Hash函数相互之间没有关系,方便由硬件并行实现。布隆过滤器不需要存储元素本身,在某些对保密要求非常严格的场合有优势。布隆过滤器可以表示全集,其它任何数据结构都不能。

缺点:误算率是其中之一,随着存入的元素数量增加,误算率随之增加。常见的补救办法是建立一个小的白名单,存储那些可能被误判的元素。但是如果元素数量太少,则使用散列表足矣。另外,一般情况下不能从布隆过滤器中删除元素。我们很容易想到把位列阵变成整数数组,每插入一个元素相应的计数器加1, 这样删除元素时将计数器减掉就可以了。然而要保证安全的删除元素并非如此简单。首先我们必须保证删除的元素的确在布隆过滤器里面。这一点单凭这个过滤器是无法保证的。另外计数器回绕也会造成问题。在降低误算率方面,有不少工作,使得出现了很多布隆过滤器的变种。

布隆过滤器的应用场景

布隆过滤器广泛应用于网页黑名单系统、垃圾邮件过滤系统、爬虫网址判重系统等,有人会想,我直接将网页URL存入数据库进行查找不就好了,或者建立一个哈希表进行查找不就OK了。当数据量小的时候,这么思考是对的,但如果整个网页黑名单系统包含100亿个网页URL,在数据库查找是很费时的,并且如果每个URL空间为64B,那么需要内存为640GB,一般的服务器很难达到这个需求。那么,在这种内存不够且检索速度慢的情况下,不妨考虑下布隆过滤器,但业务上要可以忍受判断失误率。比较经典的案例如下:

  • Redis缓存穿透问题

Redis 是基于缓存的数据存储,极大的提升了应用程序的性能的效率,尤其是在数据的查询方面,但同时也有一些问题,比如:缓存穿透,缓存雪崩,缓存击穿。

缓存穿透,指的是查询一个数据库中不一定存在的数据。正常使用Redis查询收据的流程是,根据key去查询value,如果key不存在或者key已经过期,再对数据库进行查询,并把查询的对象,放到缓存中。如果数据库查询对象为空,则不放进缓存中。

但是如果频繁的请求查询一个不存在value的key,由于缓存中没有数据,所以每次都要去查询数据库。当对key查询的并发请求很大时,每次都访问DB,就对DB造成了影响,由于缓存不命中,每次都要去查询持久层,就失去了缓存的意义。

方法1:将数据库中的空值也缓存层中,这样查询空值就不会再去访问持久层,而是直接在缓存层访问就行。但是弊端就是缓存太多空值占用了更多的空间,可以通过给缓存层空置设立一个较短的过期事件来解决,例如60S。

方法2:这时候只要增加一个布隆过滤器,后端每次插入一个数据时,都在布隆过滤器中设置一次。每当需要查询后端时,先判断key在后端是否存在,这样就能避免了后端的压力。

  • 推荐去重问题

例如新闻客户端的推送去重功能,当推荐系统推荐新闻时会从每个用户的历史记录中进行筛选,过滤掉那些已经存在的记录。

实际上,如果历史记录存储在关系数据库中,去重就需要频繁的对数据库进行exists查询,当系统并发量很高时,数据库很难扛住压力。但是如果使用缓存把历史记录都放在缓存中又会占用空间太大,这时候布隆过滤器就起到作用了,它就是用来解决这种去重问题的。同时还能节省90%以上的空间,但就是稍微有那么一点不精确,也就是有一定的误判概率。

用户浏览记录存入数据库中时,需要将其设置到布隆过滤器中。查询时在过滤器上通过key的hash算法存储判断其是否存在,避免了每次是否存在都要去数据库查询一遍,这样推送新闻时只要通过布隆过滤器判断,如果不存在就推送。可能由于误判率过滤掉极小的一部分,但仍然可以保证推荐给用户的都是无重复的。

Scipy优化踩坑实录:trust-constr和SLSQP约束定义到底差在哪? 本文深入解析了Scipy优化模块中trust-constr和SLSQP两种方法在约束定义上的差异。通过对比面向对象的trust-constr和字典式定义的SLSQP,揭示了它们各自的优势与适用场景,帮助开发者在有约束优化问题中选择合适的算法,提升计算效率与准确性。 阅读详情

相关推荐

泛微OA表单开发实战:如何用JavaScript动态控制明细表的必填与可编辑属性

本文详细介绍了如何在泛微OA系统中使用JavaScript动态控制明细表字段的必填与可编辑属性。通过主表字段变更事件监听和明细表字段属性批量修改,实现智能化的表单交互,提升用户体验和系统灵活性。文章深入解析了关键API的使用方法,并提供了实战代码示例和最佳实践。

weixin_30955617的博客 551

牛逼哄哄的布隆过滤器,到底有什么用?

作者:CodeBear的园子 www.cnblogs.com/CodeBear/p/10911177.html 本文是站在小白的角度去讨论布隆过滤器,如果你是科班出身,或者比较聪明,又或者真正想完全搞懂布隆过滤器的可以移步。 不知道从什么时候开始,本来默默无闻的布隆过滤器一下子名声大燥,仿佛身在互联网,做着开发的,无人不知,无人不晓,哪怕对技术不是很关心的小伙伴也听过它的名号。 我也花了不少时间去研究布隆过滤器,看了不少博客,无奈不是科班出身,又没有那么聪明的头脑,又比较懒...经过“放弃,拿起,放.

Java技术栈,分享最主流的Java技术 888

利用CubeMX复现正点原子TFTLCD驱动例程

①准备delay.c、delay.h、sys.c和sys.h四个文件。FMC的工作原理暂时先欠着,先记录一下CRUD的过程。这里我们使用的是BANK1 的第一个分区。点击 Configuration->FMC。②把fmc自动生成的代码注释掉一部分。配置参数如下图 17.5.1。③这个printf语句要屏蔽掉。选项卡之下配置相关参数。④整体代码,按需裁剪。

qq_59757948的博客 1613

布隆过滤器(Bloom Filter)是什么、作用、原理

一、组成:一个很长的二进制向量(集合)多个映射函数二、作用:判断某个元素一定不在集合内或可能在集合内三、背景:集合中元素增加,所需存储空间和查询时间都会增加。比如邮件服务商存储垃圾邮件账号,一个亿的email地址需要1.6GB的内存空间,若是想要判断一个邮件账号是否为垃圾地址,则耗时更长四、原理布隆过滤器是一个基于m位的比特向量(b1,b2…,bm),这些比特向量的初始值为0。一系列的哈希函数(h1,h2…,hk),这些哈希函数运算后的哈希值范围在[1, m]内。1. 插入 如下图,就是x、y

软件工程小施同学 的专栏 1423

python气象数据可视化学习笔记8——利用matplotlib和ERA5数据绘制时间-高度气象综合廓线图

利用matplotlib和ERA5数据绘制时间-高度气象综合廓线图

qiuylulu的博客 8068

学习笔记|多样本单因素方差分析|事后比较|方差齐性|F检验|韦尔奇检验|两独立样本T检验|两样本方差分析|规范表达|《小白爱上SPSS》课程:SPSS第七讲 | 单因素方差分析怎么做?

学习笔记|多样本单因素方差分析|事后比较|方差齐性|F检验|韦尔奇检验|两独立样本T检验|两样本方差分析|规范表达|《小白爱上SPSS》课程:SPSS第七讲 | 单因素方差分析怎么做?

Medlar_CN的博客 9520

布隆过滤器(Bloom Filter)

它实际上是一个很长的二进制向量和一系列随机映射函数。布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率和查询时间都比一般的算法要好的多,缺点是有一定的误识别率和删除困难。。

清风的博客 1330

在 SAP 里玩转 FTP:标准程序 RSFTP00x 全景解析与落地实践

摘要:SAP系统通过封装的标准FTP程序(RSFTP001-008)提供便捷的文件传输能力,适用于各类集成场景。关键点包括:1)依赖SAPFTP可执行程序和RFC目的地;2)使用RSFTP005进行前置检查并生成RFC配置;3)标准报表各司其职,如RSFTP002用于命令测试、RSFTP007/008提供参考实现;4)开发时组合FTP_CONNECT/COMMAND/DISCONNECT等函数模块。特别注意前台(SAPFTP)与后台(SAPFTPA)的环境差异,这是常见故障点。该方案通过标准化工具链显著降低

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 211

布隆过滤器的原理和使用场景详解

什么是布隆过滤器? 布隆过滤器是一种数据结构,特点是高效的插入和查询,而且非常节省空间。通过对位(bit)的操作,可以用来告诉你”某个值一定不存在或者可能存在“。相比于传统的 List、Set、Map 等数据结构,它更高效、占用空间更少,但是缺点是 hash 碰撞造成的误判。 场景 一般使用较多的场景就是避免缓存穿透,具体场景就是:在使用 Reids 做数据缓存的时候,很有可能会遇到一个问题:用户想要查询一个数据,发现 redis 缓存没有命中,于是向数据库查询。发现也没有,于是本次查询失败。当用户很

wui66655的博客 7574

从零开始学习PX4源码0(固件下载及编译)

本节主要记录从零开始学习PX4源码1(固件下载)的过程,欢迎批评指正!!!下载固件主要分为两个版本,之前稳定版本和最新官网发布版本,为什么要下载两个版本,主要是说明两个版本有一定的差异(开发环境及源码文件格式等),我们是从之前版本开始学习,为什么不从最新的?因为之前版本代码文件格式还是固定的,最新的变化很大,不利于初学者学习,apm和px4不好的地方就是之前版本v1.7.2和最新版本v1.14.0有些文件总是在变化,这样很不好。

陌城烟雨 4617

Oracle 从入门到精通系列(入门篇)1.1-Oracle 数据库发展史

Oracle 从入门到精通系列(入门篇)1.1-Oracle 数据库发展史

LuciferLiu_DBA 2191

布隆过滤器(Bloom Filter)原理以及应用

布隆过滤器(Bloom Filter)是1970年由布隆提出的。它实际上是一个很长的二进制向量和一系列随机映射函数。布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率和查询时间都远远超过一般的算法,缺点是有一定的误识别率和删除困难。 hash原理 Hash (哈希,或者散列)函数在计算机领域,尤其是数据快速查找领域,加密领域用的极广。 其作用是将一个大的数据集

9091

爬虫:一文掌握网站加密和混淆以及浏览器调试的技巧

面对加密和混淆技术的网站,传统的爬虫方法可能难以奏效。通过结合浏览器调试工具(如Puppeteer、Playwright)、代理工具(如Burp Suite、Fiddler)以及动态和静态分析技巧,可以深入理解网站的运行机制,绕过加密和混淆,实现有效的数据抓取。同时,务必注意合法合规,尊重目标网站的规则和用户的隐私,确保爬虫行为的正当性和可持续性。

数据知道的博客 9894

布隆过滤器(Bloom Filter)原理与应用

例如用来判断某个用户名是否已经注册,把数据表中已经注册的用户名全部放入布隆过滤器,新的注册请求进入时,判断过滤器中用户名是否存在,如果不存在(有一个位置是0),则可以进行注册,否则提示用户名已存在,也可能出现误判(这个数据的位置都是0,但是其他数据计算出来的位置恰好让这些位置变成1),出现误判时,用户名不存在而布隆过滤器显示存在,这时只能让用户重新输入用户名,对业务影响不大。例如对"hello"进行三种不同方式的hash,第一次对"hello"直接进行hash,假设得到2,把数组上2的位置置为1。

分享Java硬核干货 685

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

【redis】布隆过滤器(Bloom Filter)原理解析与应用

布隆过滤器(Bloom Filter),是1970年由布隆提出的。它实际上是一个很长的二进制向量和一系列随机映射函数。布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率和查询时间都远远超过一般的算法,缺点是有一定的误识别率和删除困难。 Bloom Filter原理 当一个元素被加入集合时,通过K个散列函数将这个元素映射成一个位数组中的K个点,把它们置为1。检索时,我们只要看看这些点是不是都是1就(大约)知道集合中有没有它了:如果这些点有任何一个0,则被检元素一定不在;如果都是1,则被检元素

阿杰 740

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

【布隆过滤器(Bloom Filter)基本概念与原理、Bloom Filter优点与缺点、以及应用场景】

【布隆过滤器(Bloom Filter)基本概念与原理、Bloom Filter优点与缺点、以及应用场景】关于布隆过滤器基本概念与原理、Bloom Filter优点与缺点、以及应用场景就先介绍到这里,当然关于布隆过滤器相关的知识还有很多内容并没有讲到,这个就需要你先看懂这些,然后再一步深入学习。如果对你有帮助,就留下你的小关注吧!

Coder_ljw的博客 1105

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

布隆过滤器(Bloom Filter)原理与应用——Mapreduce

布隆过滤器——初始状态     转自: 海量数据处理算法—Bloom Filter假设Bloom Filter使用一个m比特的数组来保存信息,初始状态时,Bloom Filter是一个包含m位的位数组,每一位都置为0。布隆过滤器——添加元素将要添加的元素给k个哈希函数(Hash Function),也称之为散列函数, 得到对应于位数组上的k个位置,将这k个位置设为1。现有S={x1, x2,…,x...

生活不止眼前的枸杞, 还有蜂蜜和咖啡! 2936

布隆过滤器(Bloom Filter)原理与应用

K-v存储中bloom filter能够实现快速查找一个元素是否在集合中。bloom filter返回false,证明一定该元素一定不在于该集合中;bloom filter返回true,证明该该元素可能存在该集合中,也有可能不存在,不过通过设计bloom filter一般情况下,bloom filter返回true,则该元素极大概率存在于该集合当中。 最低错误概率公式:k=m/n*ln2,k:ha...

weixin_44660094的博客 367

布隆过滤器(Bloom Filter)的原理及在推荐去重中的应用

遇到的问题 在业务中,我需要给每个用户保存1w条浏览记录,之后每一次的返回值都要和历史记录做一个去重,即保证用户不会重复看到同一篇文章. 这个需求有两个比较麻烦的地方: 1.空间问题 每个用户1w条,10w用户就是10亿条数据,应该保存在哪里呢? Redis?哪里有那么大内存给你用. Hbase?Hbase我不太了解具体原理,据说每次全量查询有点慢啊(后来听大佬说这点数据无压力的). Mysql?...

weixin_33845477的博客 154

布隆过滤器(Bloom Filter):原理、实现与分布式应用

布隆过滤器是一种空间效率极高的概率型数据结构,用于快速判断元素是否可能存在于集合中。其核心特点是:判断"不存在"时100%准确,判断"存在"时有微小误判率(如1%)。相比HashSet,布隆过滤器只需约1/30内存即可处理大规模数据,适合需要快速排除"不存在"元素的场景。 工作原理基于位数组和多个哈希函数:添加元素时将哈希对应位置1,查询时检查所有哈希位是否均为1。虽然无法删除元素或获取具体元素列表,但在分布式缓存、垃圾邮件过滤等场景表现优异。Redis等分布式系统可通过位图实现共享布隆过滤器,解决多实例数

BADAO_LIUMANG_QIZHI的博客 479

golang实现的布隆过滤器_布隆过滤器(bloom filter)的原理及在推荐去重中的应用

遇到的问题在业务中,我需要给每个用户保存1w条浏览记录,之后每一次的返回值都要和历史记录做一个去重,即保证用户不会重复看到同一篇文章.这个需求有两个比较麻烦的地方:1.空间问题每个用户1w条,10w用户就是10亿条数据,应该保存在哪里呢?Redis?哪里有那么大内存给你用.Hbase?Hbase我不太了解具体原理,据说每次全量查询有点慢啊(后来听大佬说这点数据无压力的).Mysql?倒是能存下这么...

weixin_33782296的博客 355
上一篇: Base64原理和实现
下一篇: C的时间操作相关函数
code_peak
博客等级 码龄5年 403粉丝 67原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

code_peak

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值