


概念
hadoop是一个大数据的分布式存储,调度,计算框架。也可以说是一个生态圈,包含很多技术:Hive、Hbase、Flume、Kafka...
Hadoop的优点
- Hadoop具有存储和处理数据能力的高可靠性。
- Hadoop通过可用的计算机集群分配数据,完成存储和计算任务,这些集群可以方便地扩展到数以
- 千计的节点中,具有高扩展性。
- Hadoop能够在节点之间进行动态地移动数据,并保证各个节点的动态平衡,处理速度非常快,具
- 有高效性。
- Hadoop能够自动保存数据的多个副本,并且能够自动将失败的任务重新分配,具有高容错性。
Hadoop的缺点
- Hadoop不适用于低延迟数据访问。
- Hadoop不能高效存储大量小文件。
- Hadoop不支持多用户写入并任意修改文件。
集群搭建
下载:https://archive.apache.org/dist/hadoop/common/hadoop-2.9.2/
集群规划
| 框架 | linux121 | linux122 | linux123 |
| HDFS | NameNode,DataNode | DataNode | SecondaryNameNode,DataNode |
| YARN | NodeManager | NodeManager | NodeManager,ResourceManager |
解压到安装目录:tar -zxvf hadoop-2.9.2.tar.gz -C /opt/lxq/servers
编辑环境变量:vim /etc/profile
# HADOOP_HOMEexport HADOOP_HOME = /opt/lxq/servers/hadoop-2.9.2export PATH = $PATH : $HADOOP_HOME /binexport PATH = $PATH : $HADOOP_HOME /sbin
使环境变量生效:source /etc/profile
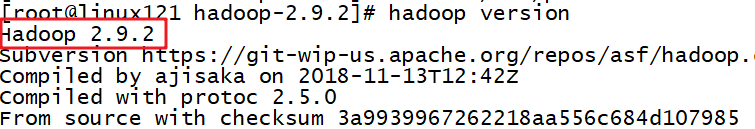
验证hadoop:hadoop version
集群配置
vim hadoop-env.shexport JAVA_HOME = /opt/lxq/servers/jdk1.8.0_231vim core-site.xml<!-- 指定 HDFS 中 NameNode 的地址 --><property><name>fs.defaultFS</name><value>hdfs : //linux121 : 9000</value></property><!-- 指定 Hadoop 运行时产生文件的存储目录 --><property><name>hadoop.tmp.dir</name><value>/opt/lxq/servers/hadoop-2.9.2/data/tmp</value></property>vim hdfs-site.xml<!-- 指定 Hadoop 辅助名称节点主机配置 --><property><name>dfs.namenode.secondary.http-address</name><value>linux123 : 50090</value></property><!-- 副本数量 --><property><name>dfs.replication</name><value>3</value></property>vim slaves 这里要注意不能有空格,不能有空行linux121linux122linux123vim mapred-env.shexport JAVA_HOME = /opt/lxq/servers/jdk1.8.0_231mv mapred-site.xml.template mapred-site.xmlvim mapred-site.xml<!-- 指定 MR 运行在 Yarn 上 --><property><name>mapreduce.framework.name</name><value>yarn</value></property><!-- 历史服务器端地址 --><property><name>mapreduce.jobhistory.address</name><value>linux121 : 10020</value></property><!-- 历史服务器 web 端地址 --><property><name>mapreduce.jobhistory.webapp.address</name><value>linux121 : 19888</value></property><!-- 文件压缩 --><property><name>mapreduce.output.fileoutputformat.compress</name><value>true</value></property><property><name>mapreduce.output.fileoutputformat.compress.type</name><value>RECORD</value></property><property><name>mapreduce.output.fileoutputformat.compress.codec</name><value>org.apache.hadoop.io.compress.SnappyCodec</value></property>vim yarn-site.xml<!-- 指定 YARN 的 ResourceManager 的地址 --><property><name>yarn.resourcemanager.hostname</name><value>linux123</value></property><!-- Reducer 获取数据的方式 --><property><name>yarn.nodemanager.aux-services</name><value>mapreduce_shuffle</value></property><!-- 日志聚集功能 --><property><name>yarn.log-aggregation-enable</name><value>true</value></property><!-- 日志保留时间设置 7 天 --><property><name>yarn.log-aggregation.retain-seconds</name><value>604800</value></property><property><name>yarn.log.server.url</name><value>http://linux121:19888/jobhistory/logs</value></property><!-- 指定我们的任务调度使用 fairScheduler 的调度方式 --><property><name> yarn.resourcemanager.scheduler.class </name><value> org.apache.hadoop.yarn.server.resourcemanager.scheduler.fair.FairScheduler </value><description> In case you do not want to use the default scheduler </description></property>
<?xml version="1.0" encoding="UTF-8" standalone="yes"?>
<allocations>
<defaultQueueSchedulingPolicy>fair</defaultQueueSchedulingPolicy>
<queue name="root" >
<queue name="default">
<aclAdministerApps>*</aclAdministerApps>
<aclSubmitApps>*</aclSubmitApps>
<maxResources>9216 mb,4 vcores</maxResources>
<maxRunningApps>100</maxRunningApps>
<minResources>1024 mb,1vcores</minResources>
<minSharePreemptionTimeout>1000</minSharePreemptionTimeout>
<schedulingPolicy>fair</schedulingPolicy>
<weight>7</weight>
</queue>
<queue name="queue1">
<aclAdministerApps>*</aclAdministerApps>
<aclSubmitApps>*</aclSubmitApps>
<maxResources>4096 mb,4vcores</maxResources>
<maxRunningApps>5</maxRunningApps>
<minResources>1024 mb, 1vcores</minResources>
<minSharePreemptionTimeout>1000</minSharePreemptionTimeout>
<schedulingPolicy>fair</schedulingPolicy>
<weight>3</weight>
</queue>
</queue>
<queuePlacementPolicy>
<rule create="false" name="specified"/>
<rule create="true" name="default"/>
</queuePlacementPolicy>
</allocations>赋予权限:chown -R root:root /opt/lxq/servers/hadoop-2.9.2
安装分发工具:yum install -y rsync
用法:rsync -rvl /opt/lxq/software/ root@linux122:/opt/lxq/software
编写分发脚本 vim /usr/local/bin/rsync-script
#!/bin/bash
#1 获取命令输入参数的个数,如果个数为0,直接退出命令
paramnum=$#
if((paramnum==0)); then
echo no params;
exit;
fi
#2 根据传入参数获取文件名称
p1=$1
file_name=`basename $p1`
echo fname=$file_name
#3 获取输入参数的绝对路径
pdir=`cd -P $(dirname $p1); pwd`
echo pdir=$pdir
#4 获取用户名称
user=`whoami`
#5 循环执行rsync
for((host=121; host<124; host++)); do
echo ------------------- linux$host --------------
rsync -rvl $pdir/$file_name $user@linux$host:$pdir
done
赋予脚本权限:chmod 777 /usr/local/bin/rsync-script
拓展一些
chmod命令
用来变更文件或目录的权限。在UNIX系统家族里,文件或目录权限的控制分别以读取、写入、执行3种一般权限来区分,另有3种特殊权限可供运用。用户可以使用chmod指令去变更文件与目录的权限,设置方式采用文字或数字代号皆可。符号连接的权限无法变更,如果用户对符号连接修改权限,其改变会作用在被连接的原始文件。
权限范围的表示法如下:
u User,即文件或目录的拥有者;
g Group,即文件或目录的所属群组;
o Other,除了文件或目录拥有者或所属群组之外,其他用户皆属于这个范围;
a All,即全部的用户,包含拥有者,所属群组以及其他用户;
r 读取权限,数字代号为“4”; w 写入权限,数字代号为“2”;
x 执行或切换权限,数字代号为“1”;
- 不具任何权限,数字代号为“0”;
s 特殊功能说明:变更文件或目录的权限。
语法 chmod(选项)(参数)
选项
-c或——changes:效果类似“-v”参数,但仅回报更改的部分;
-f或--quiet或——silent:不显示错误信息;
-R或——recursive:递归处理,将指令目录下的所有文件及子目录一并处理;
-v或——verbose:显示指令执行过程;
--reference=<参考文件或目录>:把指定文件或目录的所属群组全部设成和参考文件或目录的所属群组相同;
<权限范围>+<权限设置>:开启权限范围的文件或目录的该选项权限设置;
<权限范围>-<权限设置>:关闭权限范围的文件或目录的该选项权限设置;
<权限范围>=<权限设置>:指定权限范围的文件或目录的该选项权限设置;
参数
权限模式:指定文件的权限模式;
文件:要改变权限的文件。
例:
rwx rw- r-- r=读取属性 //值=4
w=写入属性 //值=2
x=执行属性 //值=1
chmod u+x,g+w f01 //为文件f01设置自己可以执行,组员可以写入的权限
chmod u=rwx,g=rw,o=r f01
chmod 764 f01
chmod a+x f01 //对文件f01的u,g,o都设置可执行属性 文件的属主和属组属性设置
chown user:market f01 //把文件f01给uesr,添加到market组
ll -d f1 查看目录f1的属性
chown命令
改变某个文件或目录的所有者和所属的组,该命令可以向某个用户授权,使该用户变成指定文件的所有者或者改变文件所属的组。用户可以是用户或者是用户D,用户组可以是组名或组id。文件名可以使由空格分开的文件列表,在文件名中可以包含通配符。 只有文件主和超级用户才可以便用该命令。
语法 chown(选项)(参数)
选项
-c或——changes:效果类似“-v”参数,但仅回报更改的部分;
-f或--quite或——silent:不显示错误信息;
-h或--no-dereference:只对符号连接的文件作修改,而不更改其他任何相关文件;
-R或——recursive:递归处理,将指定目录下的所有文件及子目录一并处理;
-v或——version:显示指令执行过程;
--dereference:效果和“-h”参数相同;
--help:在线帮助;
--reference=<参考文件或目录>:把指定文件或目录的拥有者与所属群组全部设成和参考文件或目录的拥有者与所属群组相同;
--version:显示版本信息。
参数
用户:组:指定所有者和所属工作组。当省略“:组”,仅改变文件所有者;
文件:指定要改变所有者和工作组的文件列表。支持多个文件和目标,支持shell通配符。
实例 将目录/usr/meng及其下面的所有文件、子目录的文件主改成 liu:
chown -R liu /usr/meng
分发hadoop到集群其它节点:rsync-script /opt/lxq/servers/hadoop-2.9.2
第一次启动格式化(不是第一次不用这句命令):hadoop namenode -format
群起yarn:start-yarn.sh [stop-yarn.sh]
群起hdfs:start-dfs.sh [stop-dfs.sh]
历史服务器起关命令
$HODOOP_HOME/sbin/mr-jobhistory-daemon.sh start historyserver
$HODOOP_HOME/sbin/mr-jobhistory-daemon.sh stop historyserver
HDFS WEB界面:http://linux121:50070/dfshealth.html#tab-overview
历史服务器web页面:http://linux121:19888/jobhistory
查看启动的服务命令:jps
HDFS命令
hdfs dfs -help rm
hdfs dfs -ls /
hdfs dfs -mkdir -p /a/b/c
hdfs dfs -removeFromLocal /opt/lxq/a.txt /a/b/c/
hdfs dfs -appendToFile /xx /xx/xx.csv
hdfs dfs -cat /a/b/c/a.txt
hdfs dfs -chmod 666 /a/b/c/a.txt
hdfs dfs -chown root:root /a/b/c/a.txt
hdfs dfs -copyFromLocal /opt/lxq/b.txt /a/b/c/
hdfs dfs -cp /a/b/c/a.txt /a/b/a.txt
hdfs dfs -mv  /a/b/a.txt /a/b/c/d/
hdfs dfs -get /a/b/c/a.txt
hdfs dfs -copyToLocal /a/b/c/a.txt /opt/lxq/data/
hdfs dfs -put xxx xxx
hdfs dfs -tail /xx/xx/xx.log
hdfs dfs -rm -r /a/b/c/d
hdfs dfs -du -s -h /a
hdfs dfs -du -h /a
hdfs dfs -setrep 10 /a/b/c/a.txt
Java整合Hadoop的依赖
<dependency>
    <groupId>org.apache.hadoop</groupId>
    <artifactId>hadoop-common</artifactId>
    <version>2.9.2</version>
</dependency>
<!-- https://mvnrepository.com/artifact/org.apache.hadoop/hadoop-client -->
<dependency>
    <groupId>org.apache.hadoop</groupId>
    <artifactId>hadoop-client</artifactId>
    <version>2.9.2</version>
 </dependency>
<!-- https://mvnrepository.com/artifact/org.apache.hadoop/hadoop-hdfs -->
<dependency>
    <groupId>org.apache.hadoop</groupId>
    <artifactId>hadoop-hdfs</artifactId>
    <version>2.9.2</version>
</dependency>
Java HDFSUtils类
package ;

import lombok.extern.slf4j.Slf4j;
import org.apache.commons.lang.StringUtils;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.*;
import org.apache.hadoop.hdfs.DistributedFileSystem;
import org.apache.hadoop.hdfs.protocol.DatanodeInfo;
import org.apache.hadoop.io.IOUtils;

import java.io.File;
import java.io.FileInputStream;
import java.io.FileOutputStream;
import java.io.IOException;
import java.net.URI;
import java.net.URISyntaxException;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.List;
import java.util.stream.Collectors;

@Slf4j
public class HDFSUtil {

    private static final Configuration configuration = new Configuration();

    private static volatile FileSystem fileSystem = null;

    private HDFSUtil() {
    }

    private static FileSystem getFS() {
        if (null == fileSystem) {
            synchronized (HDFSUtil.class) {
                if (null == fileSystem) {
                    try {
                        fileSystem = FileSystem.get(new URI("hdfs://linux121:9000"), configuration, "root");
                    } catch (IOException | InterruptedException | URISyntaxException e) {
                        throw new RuntimeException(e);
                    }
                }
            }
        }
        return fileSystem;
    }

    /**
     * 获取 HDFS 集群节点信息
     *
     * @param hdfsUri 集群路径
     * @return List<String>
     * @author lxq
     * @since 2025-07-31
     */
    public static DatanodeInfo[] getHDFSNodes(String hdfsUri) {
        if (StringUtils.isBlank(hdfsUri)) {
            return null;
        }
        DatanodeInfo[] dataNodeStats = new DatanodeInfo[0];
        try (FileSystem fs = getFS()) {
            // 获取分布式文件系统
            DistributedFileSystem hdfs = (DistributedFileSystem) fs;
            dataNodeStats = hdfs.getDataNodeStats();
        } catch (IOException e) {
            log.error("Get DataNode Info exception:", e);
        }
        return dataNodeStats;
    }

    /**
     * 获取目标路径下的所有文件或者文件夹的全路径列表
     *
     * @param target 目标路径
     * @return List<String>
     * @author lxq
     * @since 2025-07-31
     */
    public static List<String> listFile(String target) {
        if (StringUtils.isBlank(target)) {
            return null;
        }
        try (FileSystem fs = getFS()) {
            FileStatus[] status = fs.listStatus(new Path(target));
            /*for (FileStatus s : status) {
                s.isFile();
                s.isDirectory();
            }*/
            // 获取目录下的所有文件路径
            return Arrays.stream(FileUtil.stat2Paths(status))
                    .map(Path::toString)
                    .collect(Collectors.toList());
        } catch (IllegalArgumentException | IOException e) {
            log.error("list file exception:", e);
        }
        return null;
    }

    /**
     * @param target
     * @return
     */
    public static List<LocatedFileStatus> getFileLocatedStatus(String target) {
        List<LocatedFileStatus> locatedFileStatusList = new ArrayList<>();
        if (StringUtils.isNotBlank(target)) {
            try (FileSystem fs = getFS()) {
                RemoteIterator<LocatedFileStatus> listFiles = fs.listFiles(new Path(target), true);
                while (listFiles.hasNext()) {
                    LocatedFileStatus status = listFiles.next();
                    // 输出详情
                    // 文件名称
                    System.out.println(status.getPath().getName());
                    // 长度
                    System.out.println(status.getLen());
                    // 权限
                    System.out.println(status.getPermission());
                    // 分组
                    System.out.println(status.getGroup());
                    // 获取存储的块信息
                    BlockLocation[] blockLocations = status.getBlockLocations();
                    for (BlockLocation blockLocation : blockLocations) {
                        // 获取块存储的主机节点
                        String[] hosts = blockLocation.getHosts();
                        for (String host : hosts) {
                            System.out.println(host);
                        }
                    }
                }
            } catch (Exception e) {
                log.error("list file located status exception:", e);
            }
        }
        return locatedFileStatusList;
    }

    /**
     * 查找某个文件在 HDFS集群的位置
     */
    public static BlockLocation[] getFileBlockLocations(String target) {
        if (StringUtils.isBlank(target)) {
            return null;
        }

        // 文件块位置列表
        BlockLocation[] blkLocations = new BlockLocation[0];
        try (FileSystem fs = getFS()) {
            // 获取文件目录
            FileStatus filestatus = fs.getFileStatus(new Path(target));
            // 获取文件块位置列表
            blkLocations = fs.getFileBlockLocations(filestatus, 0, filestatus.getLen());
        } catch (IOException e) {
            log.error("Block Location exception:", e);
        }
        return blkLocations;
    }

    /**
     * 创建文件夹 是不能创建文件的
     */
    public static void mkdir(String target) {
        if (StringUtils.isBlank(target)) {
            return;
        }
        try (FileSystem fs = getFS()) {
            fs.mkdirs(new Path(target));
            log.info("Dir:{} Create Success.", target);
        } catch (Exception e) {
            log.error("make dir exception!", e);
        }
    }

    /**
     * 上传文件
     *
     * @param sourcePath 源路径
     * @param targetPath 目标路径
     * @author lxq
     * @since 2025-07-31
     */
    public static void uploadFile(String sourcePath, String targetPath) {
        if (StringUtils.isBlank(sourcePath) || StringUtils.isBlank(targetPath)) {
            return;
        }
        try (FileSystem fs = getFS()) {

            File file = new File(sourcePath);
            if (!file.exists()) {
                return;
            }
            if (file.isDirectory()) {
                // ... 需要完善文件夹的处理
                return;
            }
            String filename = file.getName();
            fs.copyFromLocalFile(new Path(sourcePath), new Path(targetPath + "/" + filename));
            log.info("Had Upload File:{} To Hdfs:{}", sourcePath, targetPath);
        } catch (Exception e) {
            log.error("upload file exception!", e);
        }
    }

    /**
     * 上传文件
     *
     * @param sourcePath 源路径
     * @param targetPath 目标路径
     * @author lxq
     * @since 2025-07-31
     */
    public static void downFile(String sourcePath, String targetPath) {
        if (StringUtils.isBlank(sourcePath) || StringUtils.isBlank(targetPath)) {
            return;
        }
        try (FileSystem fs = getFS()) {
            // boolean delSrc 指是否将原文件删除
            // Path src 指要下载的文件路径
            // Path dst 指将文件下载到的路径
            // boolean useRawLocalFileSystem 是否开启文件校验
            fs.copyToLocalFile(false, new Path(sourcePath), new Path(targetPath), true);
            log.info("Had Download File:{} To {}", sourcePath, targetPath);
        } catch (Exception e) {
            log.error("download file exception!", e);
        }
    }

    /**
     * 删除文件 / 文件夹
     *
     * @param target 目标文件或者文件夹
     * @author lxq
     * @since 2025-07-31
     */
    public static void delFileOrDir(String target) {
        try (FileSystem fs = getFS()) {
            if (StringUtils.isNotBlank(target)) {
                // 删除文件或者文件目录  delete(Path f) 此方法已经弃用
                fs.delete(new Path(target), true);
                log.info("Had Deleted File Or Dir Under the {} From Hdfs", target);
            }
        } catch (Exception e) {
            log.error("delete file or dir exception!", e);
        }
    }

    /**
     * 判断目录是否存在
     *
     * @param target 目标路径
     * @param create 不存在是否创建
     * @return 是否存在路径
     */
    public static boolean existDir(String target, boolean create) {
        if (StringUtils.isBlank(target)) {
            return false;
        }
        try (FileSystem fs = getFS()) {
            Path path = new Path(target);
            if (create) {
                if (!fs.exists(path)) {
                    fs.mkdirs(path);
                }
            }
            if (fs.isDirectory(path)) {
                return true;
            }
        } catch (Exception e) {
            log.error("exist Dir exception:", e);
        }
        return false;
    }


    /************************** 流相关API *****************************/
    /**
     * 流方式 文件上传
     */
    public static void uploadWithStream(String sourcePath, File file, String targetPath) {
        if ((StringUtils.isNotBlank(sourcePath) || null != file) && StringUtils.isNotBlank(targetPath)) {
            try (FileSystem fs = getFS()) {
                if (null == file) {
                    file = new File(sourcePath);
                }
                if (!file.exists()) {
                    return;
                }
                if (file.isDirectory()) {
                    return;
                }
                String filename = file.getName();
                FileInputStream fis = new FileInputStream(file);
                FSDataOutputStream fos = fs.create(new Path(targetPath + "/" + filename));
                IOUtils.copyBytes(fis, fos, configuration);
                IOUtils.closeStream(fos);
                IOUtils.closeStream(fis);
                log.info("Had Upload File:{} To Hdfs:{} With Stream.", sourcePath, targetPath);
            } catch (Exception e) {
                log.error("upload file with stream exception!", e);
            }
        }
    }

    /**
     * 流方式 文件下载
     */
    public static void downloadWithStream(String sourcePath, String targetPath) {
        if (StringUtils.isNotBlank(sourcePath) && StringUtils.isNotBlank(targetPath)) {
            try (FileSystem fs = getFS()) {
                Path path = new Path(sourcePath);
                /*if (!fs.exists(path)) {

                }
                if (fs.isDirectory(path)) {

                }*/
                FSDataInputStream fis = fs.open(path);
                FileOutputStream fos = new FileOutputStream(new File(targetPath));
                IOUtils.copyBytes(fis, fos, configuration);
                IOUtils.closeStream(fos);
                IOUtils.closeStream(fis);
                log.info("Had Download File:{} From Hdfs:{} With Stream.", sourcePath, targetPath);
            } catch (Exception e) {
                log.error("download file with stream exception!", e);
            }
        }
    }
}


 2746


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


