


1. 背景
XGBoost 的全称是eXtreme Gradient Boosting,它是Gradient Boosting Machine的一个c++实现,在计算速度和准确率上相比较于GBDT有较大的提升。作者为正在华盛顿大学研究机器学习的大牛陈天奇 。xgboost最大的特点在于,它能够自动利用CPU的多线程进行并行,同时在算法上加以改进提高了精度。它的处女秀是Kaggle的 希格斯子信号识别竞赛,因为出众的效率与较高的预测准确度在比赛论坛中引起了参赛选手的广泛关注。本文主要参考XGBoost官方文档Tutorials和陈大佬的slides来阐述一下自己的理解,如有不准确的地方,欢迎指正,谢谢!!!
2. 目标函数:Training Loss+Regularization
训练模型的主要任务是找到拟合训练数据集 ( X i , y i ) (X_i,y_i) (Xi,yi)的最佳参数 θ \theta θ。为了训练模型,需要定义目标函数度量模型拟合训练数据的程度。目标函数由两部分组成:训练损失和正则化项,其数学公式如下:

其中,
L
L
L是误差损失函数,度量模型与训练数据的拟合度,
Ω
Ω
Ω是正则化项,用来惩罚模型的复杂度。
一种常用的损失函数是MSE(the mean squared error),公式如下:
L
(
θ
)
=
∑
i
(
y
i
−
y
^
i
)
2
L(\theta)=\sum_i(y_i-\hat{y}_i)^2
L(θ)=i∑(yi−y^i)2
另一种损失函数是logistics loss,被用于逻辑回归。
L
(
θ
)
=
∑
i
[
y
i
ln
(
1
+
e
−
y
^
i
)
+
(
1
−
y
i
)
ln
(
1
+
e
y
^
i
)
]
L(\theta)=\sum_i[y_i\ln(1+e^{-\hat{y}_i})+(1-y_i)\ln(1+e^{\hat{y}_i})]
L(θ)=i∑[yiln(1+e−y^i)+(1−yi)ln(1+ey^i)]
正则化项被用来控制模型的复杂度,有利于防止过拟合。为了更好的理解正则化的作用,采用如下的一个例子进行分析。
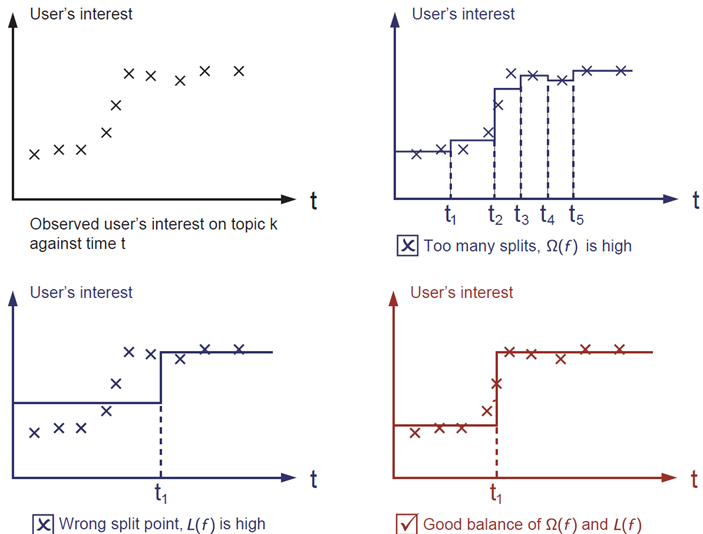
上图左上角,给定用户对某话题的感兴趣程度与时间t的数据关系,通过一个目标函数来建模,拟合这些输入数据。右上角图中的模型虽然很好的拟合每一个输入数据,但是 s p l i t split split分片太多,导致模型的复杂度很高。左下角图的模型的复杂度很小,但是每一个数据的拟合偏差很大,导致损失函数很大。右下角的模型基本上拟合每一个数据,而且 s p l i t split split很少,模型复杂度很小。机器学习模型的通用原则是简单并且准确。从 b i a s − v a r i a n c e bias-variance bias−variance t r a d e o f f tradeoff tradeoff角度来分析,模型越简单, v a r i a n c e variance variance(方差)越小,模型预测越准确, b i a s bias bias(偏置)越小。模型选择通常是在 b i a s bias bias和 v a r i a n c e variance variance之间做一个折中,选择最合适的模型。
3. XGBoost模型
3.1 模型函数形式
给定 n n n个样本,每个样本 m m m个特征的数据集 D = { ( X i , y i ) } , ( ∣ D ∣ = n , X i ∈ R m , y i ∈ R ) D=\lbrace {(X_i,y_i)} \rbrace,(|D|=n,X_i \in R^m,y_i \in R) D={(Xi,yi)},(∣D∣=n,Xi∈Rm,yi∈R),XGBoost进行Additive Training,学习 K K K颗树,采用以下函数对样本进行预测:

其中, F \mathcal F F是回归树空间, f ( x ) f(x) f(x)是回归树(CART)

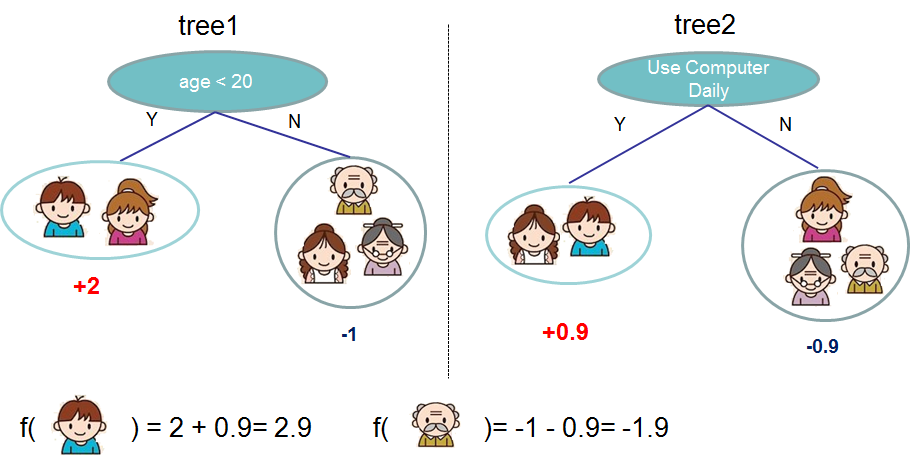
q q q表示每棵树的结构,将每一个样本映射到相应的叶子节点。 T T T是每棵树的叶子节点数量。每一个 f k f_k fk对应一个独立的树结构 q q q和叶子节点权重 w w w。与决策树不同,每一颗回归树上的每一个叶子节点上包含一个连续score,我们用 w i w_i wi表示第 i i i个叶子节点的score。对于一个样本实例,使用每一颗树( q q q)的决策规则将其划分到对应树的叶子节点并求和对应叶子节点的score( w w w)来计算最终的预测值。为了学习模型中的函数集合,通常最小化正则化目标函数。

l l l用来度量预测值 y ^ i {\hat y_i} y^i与目标值 y i y_i yi误差的损失函数。 Ω ( f k ) Ω(f_k) Ω(fk) 用来惩罚每棵回归树的复杂度。相比较GBDT,XGBoost的目标函数增加了正则化项,对叶子节点个数 T T T和叶节点分数 w w w进行惩罚,相当于在训练过程中做了剪枝,使得学习的模型更加不容易过拟合。
3.2 梯度提升树
上述的集成树模型不能使用传统的优化方法来优化求解,但是,集成模型可以通过Additive Training(Boosting)的训练方式来递归求解每棵树的模型。

y ^ i ( t ) \hat y^{(t)}_i y^i(t)表示第 i i i个实例在第 t t t次迭代的预测值,第 t t t次迭代后的模型预测值等于前 t − 1 t-1 t−1次模型预测值加上第 t t t棵树的预测值,递推公式如下:
y ^ i ( t ) = y ^ i ( t − 1 ) + f t ( x i ) \hat y^{(t)}_i=\hat y^{(t-1)}_i+f_t(x_i) y^i(t)=y^i(t−1)+ft(xi)
那么目标函数可写为:

上述公式中,
y
i
,
y
^
i
(
t
−
1
)
y_i,\hat y^{(t-1)}_i
yi,y^i(t−1)都是已知,
f
t
f_t
ft未知,模型学习是第
t
t
t棵树
f
t
f_t
ft。将目标函数在
y
^
i
(
t
−
1
)
\hat y^{(t-1)}_i
y^i(t−1)出进行二阶泰勒公式展开。
泰勒公式:
f
(
x
+
Δ
x
)
≃
f
(
x
)
+
f
′
(
x
)
Δ
x
+
1
2
f
′
′
(
x
)
Δ
x
2
f(x+\Delta x)\simeq f(x)+f^{'}(x)\Delta x+\frac{1}{2}f^{''}(x)\Delta x^2
f(x+Δx)≃f(x)+f′(x)Δx+21f′′(x)Δx2

其中, g i = ∂ y ^ ( t − 1 ) l ( y i , y ^ ( t − 1 ) ) g_i=\partial_{\hat y^{(t-1)}}l(y_i,\hat y^{(t-1)}) gi=∂y^(t−1)l(yi,y^(t−1))和 h i = ∂ y ^ ( t − 1 ) 2 l ( y i , y ^ ( t − 1 ) ) h_i=\partial^2_{\hat y^{(t-1)}}l(y_i,\hat y^{(t-1)}) hi=∂y^(t−1)2l(yi,y^(t−1))分别是损失函数的一阶导数和二阶导数。由于 l ( y i , y ^ ( t − 1 ) ) l(y_i,\hat y^{(t-1)}) l(yi,y^(t−1))是常数项,将其从原目标函数中移除得到一个新的简化目标函数:

将
f
t
,
Ω
(
f
t
)
f_t,\Omega(f_t)
ft,Ω(ft)写成树结构的形式,即把下式代入目标函数中
f
t
(
x
)
=
w
q
(
x
)
f_t(x)=w_{q(x)}
ft(x)=wq(x)
Ω
(
f
t
)
=
γ
T
+
1
2
λ
∥
w
∥
2
\Omega(f_t)=\gamma T+\frac{1}{2}\lambda \lVert w\rVert^2
Ω(ft)=γT+21λ∥w∥2
目标函数为:

为了将所有的节点统一起来,定义每个叶节点 j j j上的样本集合为 I j = { i ∣ q ( x i ) = j } I_j=\lbrace {i|q(x_i)=j} \rbrace Ij={i∣q(xi)=j},则目标函数可转化为叶节点累加的形式:

对于一个确定的树结构,即 q ( x ) q(x) q(x)确定,为了使目标函数最小化,可令其导数为0,求解得到每个叶节点的最优预测分数:

代入目标函数,得到最小损失为:

上述公式通常被用于度量树结构质量 q q q的打分函数。下图解释了score如何被计算。

4. 回归树的学习策略
当回归树的结构确定时,可推导出其最优的叶节点分数以及对应的最小损失值,那么是怎么确定树的结构呢?
- 暴力枚举所有可能的树结构,选择损失最小的树结构,这是NP难问题。
- 贪心算法,每次尝试分裂一个叶节点,计算分裂前后的增益,选择增益最大的特征及其对应的特征值作为分裂点。
XGBoost的打分函数

红色标记部分衡量了每个叶节点对总体损失的贡献,我们希望损失越小越好,则标红部分的值越大越好。因此,对一个叶节点进行分裂,分裂前后的增益定义为:

G a i n Gain Gain值越大,分裂后 L L L减小越多,所以当对一个叶节点分裂时,计算所有候选( f e a t u r e , v a l u e feature,value feature,value)对应的 G a i n Gain Gain,选择 G a i n Gain Gain值最大的分裂点进行分割。
5. 缩减与列取样
除了使用正则项,还有两种技术可用来防止过拟合: S h r i n k a g e Shrinkage Shrinkage(缩减)和 C o l u m n S u b s a m p l i n g Column Subsampling ColumnSubsampling(列取样)。 S h r i n k a g e Shrinkage Shrinkage在每棵提升树迭代后,增加了权重因子 η \eta η。与随机优化的学习率相似, S h r i n k a g e Shrinkage Shrinkage降低了每棵树结构和对应的叶节点对整体树模型的影响程度。列取样事实上是特征取样,类似于 R a n d o m F o r e s t Random Forest RandomForest的 b a g g i n g bagging bagging思想,有利于防止过拟合,而且提升了并行计算的速度。
y ( t ) = y ( t − 1 ) + η f t ( x i ) y^{(t)}=y^{(t-1)}+\eta f_t(x_i) y(t)=y(t−1)+ηft(xi)
6. 树节点分裂方法(Split Finding Algorithms)
6.1 精确算法(Basic Exact Greedy Algorithm)
遍历所有特征的所有可能分割点,计算对应的 G a i n Gain Gain值,选择 G a i n Gain Gain值最大的( f e a t u r e , v a l u e feature,value feature,value)作为分割点进行分割。为了提升计算效率,在分割前首先对每一个 f e a t u r e feature feature进行 f e a t u r e feature feature v a l u e value value排序,然后有序的遍历特征值计算梯度统计( g i , h i g_i,h_i gi,hi)。

6.2 近似算法(Approximate Algorithm)
问题:精确算法由于贪婪地遍历了所有特征对应所有可能分裂点,因此这种算法非常损耗性能。而且,当数据量很大时,无法全部加载到内存,导致无法进行有效的特征排序并计算对应的增益
G
a
i
n
Gain
Gain。
对于每个特征,近似算法依据特征分布的分位点提出候选分裂点,然后将连续特征映射到由候选分裂点划分的
b
u
c
k
e
t
s
buckets
buckets中,加速了梯度统计和计算速度。
- G l o b a l Global Global:初始化每棵树结构之前,提出所有的候选切分点。
- L o c a l Local Local:每次分裂前,重新提出候选切分点

近似算法实例:三分位数

6.3 加权分位数(Weighted Quantile Sketch)
数据集 D k = { ( x 1 k , h 1 ) , ( x 2 k , h 2 ) . . . . ( x n k , h n ) } \mathcal {D}_k=\lbrace {(x_{1k},h_1),(x_{2k},h_2)....(x_{nk},h_n)} \rbrace Dk={(x1k,h1),(x2k,h2)....(xnk,hn)}表示每个训练样本的第k个特征值和对应的二阶导数梯度统计 h i h_i hi。定义一个排序函数 r k : R → [ 0 , + ∞ ] : r_k:R\to [0,+\infty]: rk:R→[0,+∞]:

上式表示 k − t h k-th k−th特征值小于 z z z的样本百分比,目标是寻找候选分裂点 { s k 1 , s k 2 . . . . s k l , } \lbrace {s_{k1},s_{k2}....s_{kl},} \rbrace {sk1,sk2....skl,}

其中 ϵ \epsilon ϵ是近似因子,意味着有 1 / ϵ 1/\epsilon 1/ϵ个候选分裂点,每一各数据都有一个权重 h i h_i hi。实际上XGBoost是以二阶导数值作为权重来选择候选分裂点。

目标函数整理成以下形式,可看出 h i h_i hi对 l o s s loss loss有加权的作用。
∑ i = 1 n 1 2 h i ( f t ( x i ) + g i / h i ) 2 + Ω ( f t ) + c o n s t a n t \sum_{i=1}^n\frac{1}{2}h_i(f_t(x_i)+g_i/h_i)^2+\Omega(f_t)+constant i=1∑n21hi(ft(xi)+gi/hi)2+Ω(ft)+constant
6.4 稀疏值分裂(Sparsity-aware Split Finding)
实际输入数据存在大量的稀疏值,原因有以下三种:
- 数据中存在大量的缺失值
- 数据统计中大量的零数值
- o n e − h o t one-hot one−hot编码
为了选择稀疏值分裂方向,每一个树节点提出了一个默认方向,当数据缺失时,样本会被分到默认方向的树节点。从非缺失训练样本 I k I_k Ik学习最优的默认方向。


7. 系统设计
7.1 Column Block for Parallel Learning
对于训练树模型,最耗时的部分是对数据排序,为了减少排序的时间耗费,提出将数据存储到内存单元( b l o c k block block)。
- 特征预排序,以column block的结构存于内存
- 存储样本索引
- block中的数据以稀疏格式(CSC)存储
这个结构加速了
s
p
l
i
t
split
split
f
i
n
d
i
n
g
finding
finding的过程,只需在训练树之前排序一次,在后面的迭代过程中可以重复使用,后面节点分裂时直接根据索引得到梯度统计。
每一列
c
o
l
u
m
n
column
column的统计信息可并行化,用于分裂点划分。而且,
c
o
l
u
m
n
column
column
b
l
o
c
bloc
block结构可支持列取样。

7.2 Cache-aware Access
c o l u m n column column b l o c k block block按特征大小顺序存储,根据 r o w row row索引获取对应的梯度统计,然而每个数据相应的样本梯度信息在内存中是分散的,造成内存的不连续访问,降低了 C P U CPU CPU c a c h e cache cache命中率。
缓存优化方法
- 预取数据到 b u f f e r buffer buffer(非连续->连续),统计梯度信息
- 调节 b l o c k block block的大小
XGBoost的其他特性
- 行取样
- 支持自定义损失函数(二阶可导)
8. XGBoost参数解析
xgboost有两种接口:xgboost自带的API和scikit-learn的API,参数用法大致相同。
在执行XGBoost之前,首先设置三种类型的参数:general parameters、booster parameters和task parameters。
- General parameters(通用参数):与用于提升的提升器相关,一般是基于tree模型和基于linear模型。
- Booster parameters(提升器参数):取决于选择哪一种提升器。
- Learning task parameters(学习目标参数):取决于学习场景,例如回归任务通常设置不同的参数用于排序任务。
8.1 General Parameters
- booster [default=gbtree]
- 选择使用哪一种提升器,通常是gbtree,gblinear或者dart;gbtree和dart使用基于树模型而gblinear使用基于线性模型
- verbosity [default=1]
- 打印信息的标识。有效值0(silent),1(warning),2(info),3(debug)。如果XGBoost尝试基于根据启发式更改配置,将会发出警告消息。如果有意外行为发生,请增加verbosity值。
- nthread [default to maximum number of threads available if not set]
- 运行XGBoost并行执行线程的数量
- disable_default_eval_metric [default=0]
- flag使得默认指标无效,设置大于零使其无效。
- num_pbuffer [set automatically by XGBoost, no need to be set by user]
- 预测值buffer的大小,通常设置训练样本的数量,缓存区被用来保存上一个Boosting的预测结果。
- num_feature [set automatically by XGBoost, no need to be set by user]
- Boosting使用的特征维度,通常设置特征最大维度
8.2 Booster Parameters
- eta [default=0.3, alias: learning_rate]
- 为了防止过拟合,在更新过程中使用收缩步长。在每次提升计算之后,通常会直接获得新特征的权重。 eta通过缩减特征的权重使提升计算过程更加健壮。取值范围为[0,1]
- gamma [default=0, alias: min_split_loss]
- 在树的叶节点上进行进一步划分所需的最小损失减少,gamma越大,算法越保守。取值范围 [ 0 , ∞ ] [0,\infty] [0,∞]
- max_depth [default=6]
- 树的最大深度,增加这个值将会使模型更加复杂,而且很容易过拟合。取值范围 [ 1 , ∞ ] [1,\infty] [1,∞]
- min_child_weight [default=1]
- 满足子节点的最小样本权重之和,如果树分区导致叶节点的样本权重之和小于min_child_weight ,将会停止进一步的划分。在回归模型中,这个参数是指建立每个模型所需要的最小样本数。min_child_weight值越大,算法越保守。取值范围 [ 0 , ∞ ] [0,\infty] [0,∞]
- max_delta_step [default=0]
- Maximum delta step we allow each leaf output to be. If the value is set to 0, it means there is no constraint. If it is set to a positive value, it can help making the update step more conservative. Usually this parameter is not needed, but it might help in logistic regression when class is extremely imbalanced. Set it to value of 1-10 might help control the update.取值范围 [ 0 , ∞ ] [0,\infty] [0,∞]
- subsample [default=1]
- 训练样本的子样本比例。设置为0.5表明XGBoost将随机取样一半的训练数据去训练树模型,而且防止过拟合。每次Boosting迭代都会进行子取样。取值范围(0,1]
- colsample_bytree [default=1]
- 构建每棵树时对特征采样的比例。取值范围(0, 1]
- lambda [default=1, alias: reg_lambda]
- L2正则项的惩罚系数,增加lambda,将会使模型更加健壮,防止过拟合。
- alpha [default=0, alias: reg_alpha]
- L1正则项的系数,增加alpha,将会使模型更加健壮,防止过拟合。
- scale_pos_weight [default=1]
- 控制正负权重的平衡,在类别高度不平衡的情况下,将参数设置大于0,可以加快收敛。
8.3 Learning Task Parameters
- objective [default=reg:squarederror]
- reg:squarederror: 平方损失的回归
- reg:logistic: 逻辑回归
- binary:logistic: 二分类的逻辑回归问题,输出为概率
- binary:logitraw:二分类的逻辑回归问题,输出结果为 w T x w^Tx wTx
- count:poisson:计数问题的poisson回归,输出结果为poisson分布。
- multi:softmax:XGBoost采用softmax目标函数处理多分类问题,同时需要设置num_class
- multi:softprob:和softmax一样,但是输出的是ndata * nclass的向量,可以将该向量reshape成ndata行nclass列的矩阵。没行数据表示样本所属于每个类别的概率
- rank:pairwise:使用LambdaMART执行pairwise排序,使其损失最小化。
- base_score [default=0.5]
- 所有实例的初始化预测score,相当于全局偏置
- eval_metric [default according to objective]
- 验证数据所需要的评价指标,根据目标函数选择默认的评价指标(rmse for regression, and error for classification, mean average precision for ranking)
- 用户可以添加多种评价指标,对于Python用户要以list传递参数对给程序,而不是map参数list参数不会覆盖’eval_metric’
- The choices are listed below:
- rmse: root mean square error
- mae: mean absolute error
- logloss: negative log-likelihood
- error:二分类错误率,计算公式为#(wrong cases)/#(all cases)。对于预测,评估将会将预测值大于0.5的实例视为正样本,否则看做负样本。
- merror: Multiclass classification error rate. It is calculated as #(wrong cases)/#(all cases).
- mlogloss: Multiclass logloss.
- auc: Area under the curve
- aucpr: Area under the PR curve
- ndcg: Normalized Discounted Cumulative Gain
- map: Mean Average Precision
- ndcg@n, map@n: ‘n’ can be assigned as an integer to cut off the top positions in the lists for evaluation.
- poisson-nloglik: negative log-likelihood for Poisson regression
- gamma-nloglik: negative log-likelihood for gamma regression
- seed [default=0]
- 随机数的种子
- dtrain:训练的DMatrix数据
- num_boost_round:Boosting迭代的次数
- evals:一个列表,用于对训练过程中进行评估列表中的元素,形式evals = [(dtrain,‘train’),(dval,‘val’)]或者是evals = [(dtrain,‘train’)],对于第一种情况,它使得我们可以在训练过程中观察验证集的效果
- obj:自定义目的函数
- feval:自定义评估函数
- maximize:是否对评估函数进行最大化
- early_stopping_rounds:早期停止次数 ,假设为100,验证集的误差迭代到一定程度在100次内不能再继续降低,就停止迭代。这要求evals 里至少有 一个元素,如果有多个,按最后一个去执行。返回的是最后的迭代次数(不是最好的)。如果early_stopping_rounds存在,则模型会生成三个属性,bst.best_score,bst.best_iteration和bst.best_ntree_limit
- evals_result:字典,存储在watchlist中的元素的评估结果。
- verbose_eval :(可以输入布尔型或数值型),也要求evals里至少有 一个元素。如果为True,则对evals中元素的评估结果会输出在结果中;如果输入数字,假设为5,则每隔5个迭代输出一次。
- learning_rates:每一次提升的学习率的列表
- xgb_model:在训练之前用于加载的xgb model
在知乎上看到一个值得思考的问题,贴出来以供大家参考,来源于知乎
讨论:xgboost相比传统gbdt有何不同?xgboost为什么快?xgboost如何支持并行?
- 传统GBDT以CART作为基分类器,xgboost还支持线性分类器,这个时候xgboost相当于带L1和L2正则化项的逻辑斯蒂回归(分类问题)或者线性回归(回归问题)。
- 传统GBDT在优化时只用到一阶导数信息,xgboost则对代价函数进行了二阶泰勒展开,同时用到了一阶和二阶导数。顺便提一下,xgboost工具支持自定义代价函数,只要函数可一阶和二阶求导。
- xgboost在代价函数里加入了正则项,用于控制模型的复杂度。正则项里包含了树的叶子节点个数、每个叶子节点上输出的score的L2模的平方和。从Bias-variance tradeoff角度来讲,正则项降低了模型的variance,使学习出来的模型更加简单,防止过拟合,这也是xgboost优于传统GBDT的一个特性。
- Shrinkage(缩减),相当于学习速率(xgboost中的eta)。xgboost在进行完一次迭代后,会将叶子节点的权重乘上该系数,主要是为了削弱每棵树的影响,让后面有更大的学习空间。实际应用中,一般把eta设置得小一点,然后迭代次数设置得大一点。(补充:传统GBDT的实现也有学习速率)
- 列抽样(column subsampling)。xgboost借鉴了随机森林的做法,支持列抽样,不仅能降低过拟合,还能减少计算,这也是xgboost异于传统gbdt的一个特性。
- 对缺失值的处理。对于特征的值有缺失的样本,xgboost可以自动学习出它的分裂方向。
- xgboost工具支持并行。boosting不是一种串行的结构吗?怎么并行的?注意xgboost的并行不是tree粒度的并行,xgboost也是一次迭代完才能进行下一次迭代的(第t次迭代的代价函数里包含了前面t-1次迭代的预测值)。xgboost的并行是在特征粒度上的。我们知道,决策树的学习最耗时的一个步骤就是对特征的值进行排序(因为要确定最佳分割点),xgboost在训练之前,预先对数据进行了排序,然后保存为block结构,后面的迭代中重复地使用这个结构,大大减小计算量。这个block结构也使得并行成为了可能,在进行节点的分裂时,需要计算每个特征的增益,最终选增益最大的那个特征去做分裂,那么各个特征的增益计算就可以开多线程进行。
- 可并行的近似直方图算法。树节点在进行分裂时,我们需要计算每个特征的每个分割点对应的增益,即用贪心法枚举所有可能的分割点。当数据无法一次载入内存或者在分布式情况下,贪心算法效率就会变得很低,所以xgboost还提出了一种可并行的近似直方图算法,用于高效地生成候选的分割点。
参考文献
- XGBoost: A Scalable Tree Boosting System. T. Chen, C. Guestrin (2016).
- Introduction to Boosted Trees. T. Chen
- https://github.com/dmlc/xgboost

 907


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


