天天使用MySQL,你知道MySQL数据库能抗多少压力吗?附(真实案例)_mysql读写qps

高并发下的一些基础概念:吞吐量、QPS、并发数、响应时间,服务熔断、隔离、降级、限流,缓存穿透、缓存击穿、缓存雪崩 文章目录吞吐量、QPS、并发数、响应时间吞吐量(Throughput)QPS(Query Per Second)并发量响应时间(RT)小结服务熔断、隔离、降级、限流降级熔断隔离限流缓存穿透、缓存击穿、缓存雪崩缓存穿透缓存击穿缓存雪崩 吞吐量、QPS、并发数、响应时间 吞吐量(Throughput) 吞吐量(TPS):是指系统在单位时间内处理请求的数量。 对于无并发的应用系统而言,吞吐量与响应时间成严格的反比关系,实际上此时吞吐量就是响应时间的倒数。 对于单用户的系统,响应时间可以很好地度量系统的性能,但对 阅读详情

一般业务系统运行流程图

首先,我们先来看一个最最基础的java业务系统连接数据库运行的架构,其实简单来说,我们平时都是用spring boot+ssm技术栈开发一个java业务系统的,用spring boot内嵌tomcat就可以对外提供http接口了,然后最多现在会加上nacos+dubbo调用别的系统接口,数据全部靠连接mysql数据库进行crud就可以了,如下图。

上面那种架构的系统,估计就是很多兄弟日常做的最多的系统架构了,有的兄弟稍微做的高大上一点,大概来说,可能就是会加入一些es、redis、rocketmq一类的中间件简单使用一下,但是大致来说也就这么回事了,那么还是回归主题,大家知道你上述那种系统下,他连接的数据库能抗多大压力吗?

一台4核8G的机器能扛多少并发量呢?

说实话,要解决这个问题,一般来说,不是先聊数据能抗多少压力,因为往往不是数据库先去抗高并发,而是你连接数据库的web系统得先去抗高并发!也就是我们的spring boot+ssm那套业务系统能抗多高并发我们得先搞清楚!

所以要搞明白这个问题,就得先说一个主题,一般来说我们的spring boot应用系统大致就是部署在2核4G或者4核8G的机器上,这个机器配置其实是很关键的,所以这里直接告诉大家一个经验值,即使说咱们如果部署的是一个4核8G的机器,然后spring boot内嵌的tomcat默认开了200个线程来处理请求,接着每个请求都要读写多次数据库,那么此时,大致来说你的一台机器可以抗大概500~1000这个并发量,具体多少得看你的接口复杂度,如下图。

高并发来袭时数据库会先被打死吗?

所以其实一般来说,当你的高并发压力来袭的时候,通常不会是数据库先扛不住了,而是你的业务系统所在机器抗不住了,比如你部署了2台机器,那么其实到每秒一两千并发的时候,这两台机器基本上cpu负载都得飙升到90%以上 ,压力很大,而且接口性能会开始往下掉很多了,如下图。

那么这个时候我们的数据库压力会如何呢?其实一般来说你的两台机器抗下每秒一两千的请求的时候后,数据库压力通常也会到一个小瓶颈,因为为什么呢?关键是你的业务系统处理每个业务请求的时候,他是会读写多次数据库的,所以业务系统的一次请求可能会导致数据库有多次请求,也正因为这样,所以此时可能你的数据库并发压力会到几千的样子。

8核16G的数据库每秒大概可以抗多少并发压力?

那么所以下一个问题来了,你的数据库通常是部署在什么样配置的机器上?一般来说给大家说,数据库的配置如果是那种特别低并发的场景,其实2核4G或者4核8G也是够了,但是如果是常规化一点的公司的生产环境数据库,通常会是8核16G。那么8核16G的数据库每秒大概可以抗多少并发压力?大体上来说,在几千这个数量级。

因为这个具体能抗多少并发也得看你数据库里的数据量 以及你的SQL语句的复杂度,所以一般来说8核16G的机器,大概也就是抗到每秒几千并发就差不多了,量再大基本就扛不住了,因为往往到这个量级下,数据库的cpu、内存、网络、io的负载基本都很高了,尤其是cpu,可能至少也在百分之七八十了,如下图。

数据库架构可以从哪些方面优化?

1.根据业务系统拆分多个数据库机器优化方案

那么接着说,如果到了这个并发压力之下,通常来说可以如何进行**数据库架构的优化呢?**其实也简单,我们完全可以加机器,把数据库部署到多台机器上去。因为通常来说,我们的一个数据库里会放很多业务系统的db和tables,所以首先就是可以按照业务系统来进行拆分,比如说多加一台机器,再部署一个数据库,然后这里放一部分业务系统的db和tables,老数据库机器放另外一部分业务系统的db和tables,此时一下子就可以缓解老数据库机器的压力了,如下图。

2. 读写分离架构优化方案

那么接着问题来了,如果说并发压力继续提升,导致拆分出去的两台数据库压力越来越大了呢?此时可以上一招,叫做读写分离,就是说给每个数据库挂一个从库,让主数据库基于binlog数据更新日志同步复制给从数据库,让主从数据库保持数据一致,然后我们的系统其实可以往主库里写入,在从库里查询,此时就又可以缓解原来的主数据库的压力了,如下图。

3、分库分表架构优化方案

再往下说,如果说即使是给主数据库挂了从库,然后接着并发压力继续提升,让我们的主数据库写入压力过大,每秒几千写入,又要扛不住了呢?此时就只能上终极方案,分库分表了,就是把主库拆分为多个库,每个库里放一个表的部分数据,然后用多个主库抗高并发写入压力,这样就可以再次分散我们的压力了,如下图所示。

总结优化

好了,今天分享的知识就到这里了,其实我们的数据库架构演进基本上就是按照今天说的这个顺序和思路逐步逐步的演进的,刚开始你单台数据库机器抗几千并发扛不住了,就按照业务系统拆分多个数据库机器,然后再扛不住了,就上主从架构分摊读写压力,再扛不住了就分库分表,多个机器抗数据库写入压力,最后总是可以用数据库架构抗住高并发压力的。

真实环境问题

30万用户的web系统,单台mysql服务器可以扛住吗?

最近看了很多高可用,集群的方案,越看越头疼。看后的感觉就是,维护成本太大,对于我这种没这方面经验的新手,实在头大。
        实在不想弄那种集群,高可用的方案,什么分表,分库,水平拆分,垂直拆分,什么mycat啥的,统统都不想弄。我技术水平驾驭不住!
        服务器,32g-ddr3内存,ssd-240g硬盘,cpu-xeon系列!
        单mysql服务器,实在好控制,不用操心,不在自己技术范围外的异常情况!
        例如redis,我没经验,写到是能写出来,照葫芦画瓢,但是他有数据不一致的问题,需要额外处理,这个没经验,感觉还是驾驭不了。
        主要是没时间,去试错。
        平均每天5万条数据左右写入,剩下的基本都是读!

qps是什么?

QPS(Query Per Second)意思为“每秒查询率”,是一台服务器每秒能够响应的查询次数,是对一个特定的查询服务器在规定时间内所处理流量多少的衡量标准。

一,分析

一般应用来说,并发估算公式如下:

qps = 5 * 日pv / 86400

5是通用峰值倍数,如果你有高峰值特性自行调整,比如秒杀功能。

mysql通常在实体机的读写综合qps在几千左右,具体你可以自己压测一下,跟机器配置有关。

所以首先你需要通过收集日志得到日pv,然后通过估算得到当前qps,再根据未来一段时间的用户量和场景看看够不够。

比如你每天数据库访问次数是100万,可估算峰值qps为60左右,比如数据库qps可达3000,那么可估算你的服务器还能撑同等场景50倍增长。

以上方法都是通用方法,杠精退散。

脱离具体方法来说,题主这种小型站点,我的建议是不要听某些人说的用什么牛逼方案,用最成熟的通用方案就对了,有问题方便解决,以后也便于别人接盘。

切忌过度优化,互联网老兵给你的成熟建议。

根据全日的qps计算,该用户一天大概只能5万的写入量,如果是平均的话每两秒只有一次写入,qps只有0.5左右,当前服务器绰绰有余的就可以接盘,如果是在同一个时间段有上万数据同时涌入的话,数据库会到达一个瓶颈,有可能会出现崩溃的情况,但是如果这么高的并发的话,大可能是前面web端的服务器先支撑不住。

二,qps计算

业务qps的估算一般按照场景来划分,阐述下常见场景的估算方法:

1、抢购和活动场景

按照80%的访问量集中在20%的时间内

qps=pv*80%/86400*20%

2、白天提供业务的场景(例如政务查询系统等)

按照一半时间去计算4w秒

qps=pv/40000

3、全天后无明显波峰场景

qps=pv/86400

至于mysql的性能直接测试一下,不同机器配置差异太大,一般qps几k没有问题

附带建议:不要只一台服务,怎么也搞个主从,只为少些晚上被叫起来搞事情

三,总结

1、通常情况下,线上环境应用部署在4核8G的机器上,而数据库应部署在8核16G或者16核32G,正常情况下单节点应用服务可支撑500左右的并发,当然还要根据请求的处理时长来计算,比如接口请求响应过慢就会导致并发降低

自我介绍一下,小编13年上海交大毕业,曾经在小公司待过,也去过华为、OPPO等大厂,18年进入阿里一直到现在。

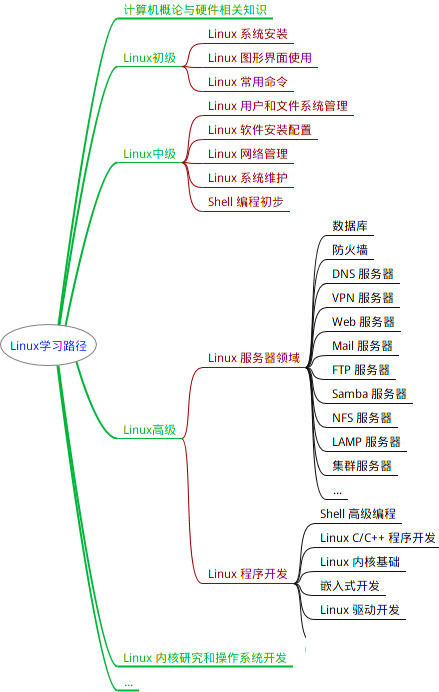
深知大多数Linux运维工程师,想要提升技能,往往是自己摸索成长或者是报班学习,但对于培训机构动则几千的学费,着实压力不小。自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!

因此收集整理了一份《2024年Linux运维全套学习资料》,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友,同时减轻大家的负担。
img
img
img
img
img

既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,基本涵盖了95%以上Linux运维知识点,真正体系化!

由于文件比较大,这里只是将部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新

如果你觉得这些内容对你有帮助,可以添加VX:vip1024b (备注Linux运维获取)
img

最全的Linux教程,Linux从入门到精通

======================

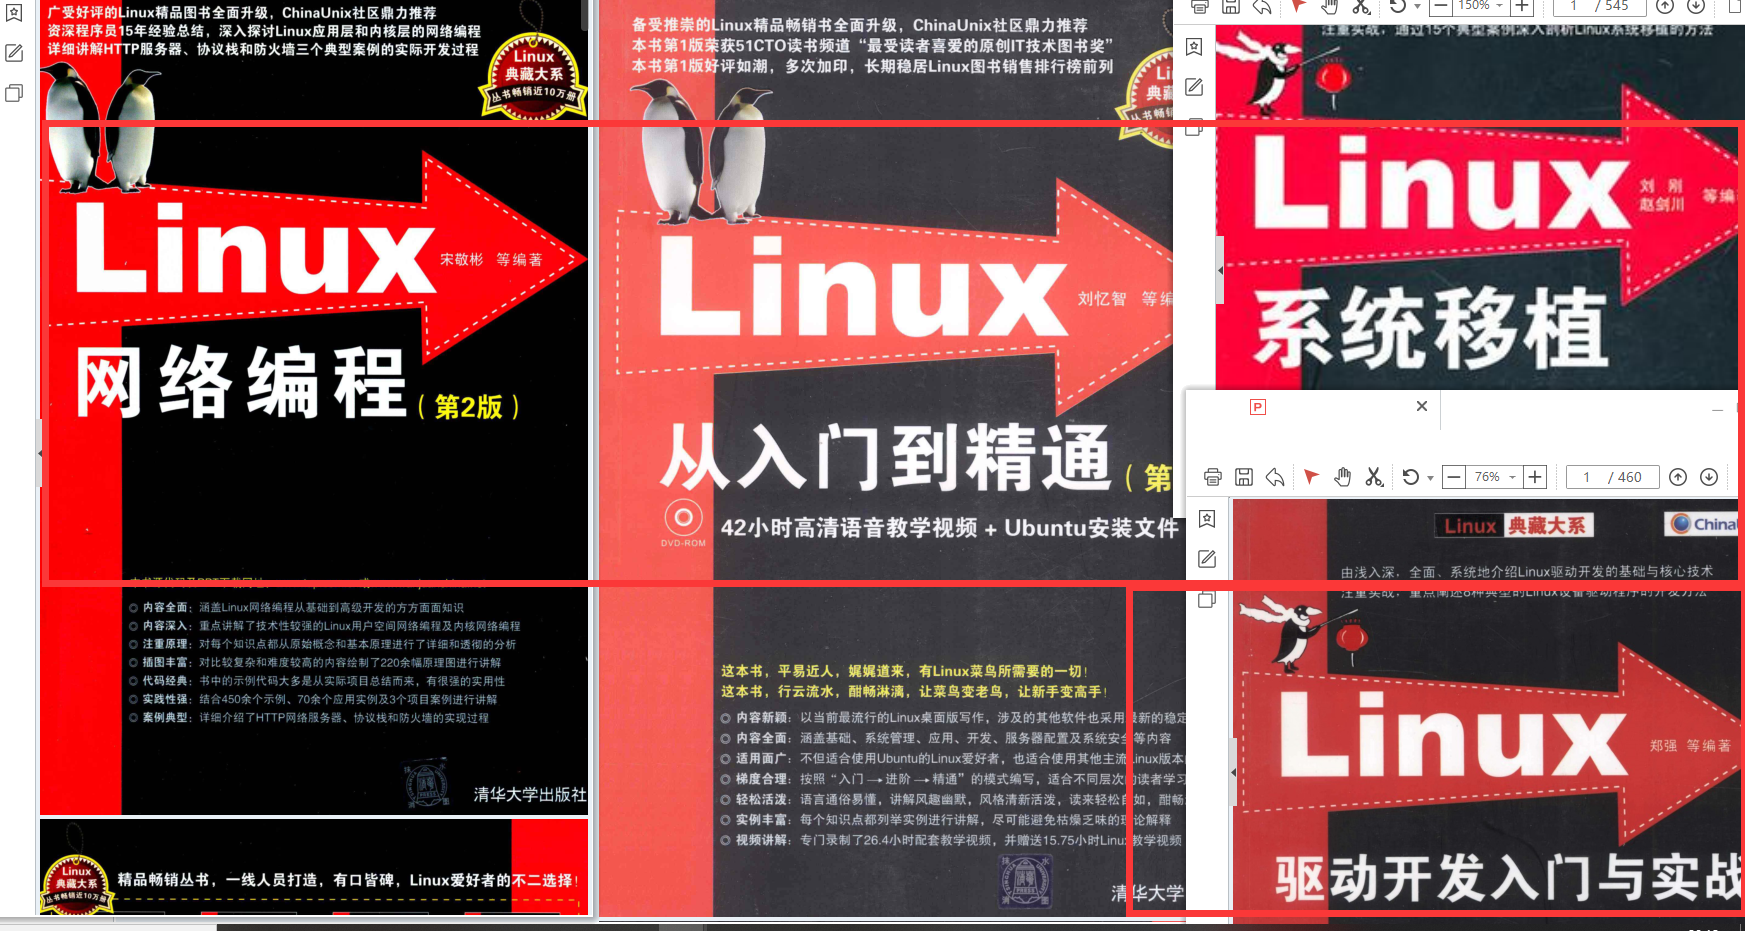
  1. linux从入门到精通(第2版)

  2. Linux系统移植

  3. Linux驱动开发入门与实战

  4. LINUX 系统移植 第2版

  5. Linux开源网络全栈详解 从DPDK到OpenFlow

华为18级工程师呕心沥血撰写3000页Linux学习笔记教程

第一份《Linux从入门到精通》466页

====================

内容简介

====

本书是获得了很多读者好评的Linux经典畅销书**《Linux从入门到精通》的第2版**。本书第1版出版后曾经多次印刷,并被51CTO读书频道评为“最受读者喜爱的原创IT技术图书奖”。本书第﹖版以最新的Ubuntu 12.04为版本,循序渐进地向读者介绍了Linux 的基础应用、系统管理、网络应用、娱乐和办公、程序开发、服务器配置、系统安全等。本书附带1张光盘,内容为本书配套多媒体教学视频。另外,本书还为读者提供了大量的Linux学习资料和Ubuntu安装镜像文件,供读者免费下载。
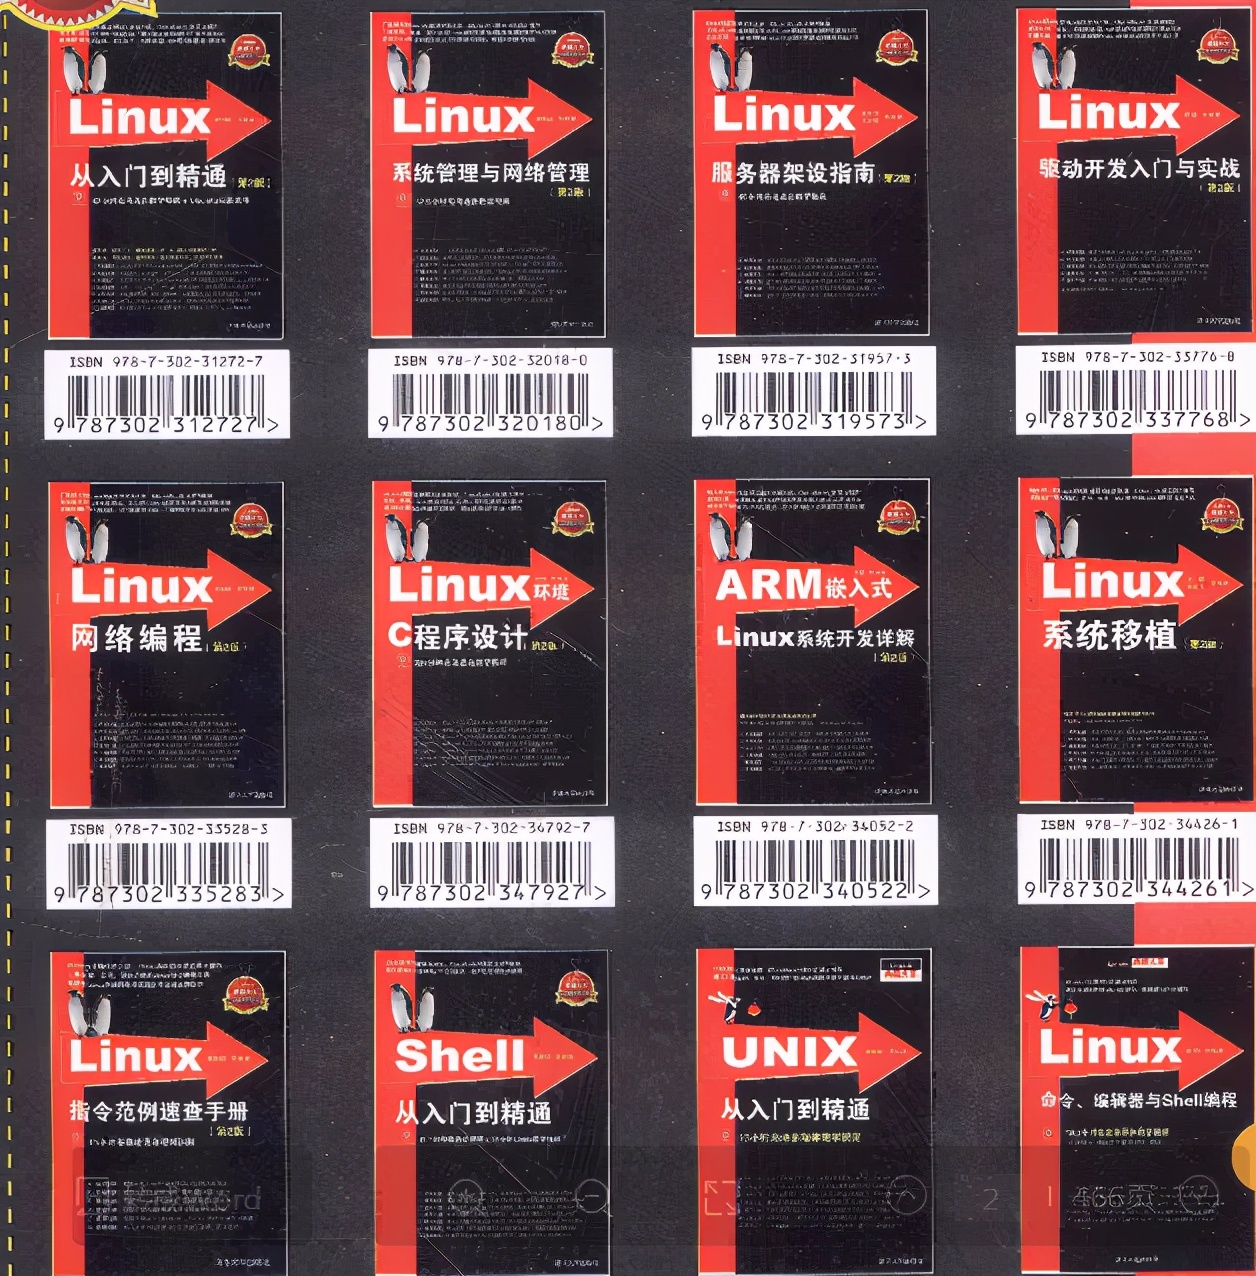
华为18级工程师呕心沥血撰写3000页Linux学习笔记教程

本书适合广大Linux初中级用户、开源软件爱好者和大专院校的学生阅读,同时也非常适合准备从事Linux平台开发的各类人员。

需要《Linux入门到精通》、《linux系统移植》、《Linux驱动开发入门实战》、《Linux开源网络全栈》电子书籍及教程的工程师朋友们劳烦您转发+评论

一个人可以走的很快,但一群人才能走的更远。不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎扫码加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!
img

大专院校的学生阅读,同时也非常适合准备从事Linux平台开发的各类人员。**

需要《Linux入门到精通》、《linux系统移植》、《Linux驱动开发入门实战》、《Linux开源网络全栈》电子书籍及教程的工程师朋友们劳烦您转发+评论

一个人可以走的很快,但一群人才能走的更远。不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎扫码加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!
[外链图片转存中…(img-m2CX5As4-1712897419826)]

生产级机器学习系统:从模型上线到抗脆弱部署的工程实践 机器学习模型部署不是算法落地的终点,而是系统性工程挑战的起点。当模型进入真实业务环境,其稳定性、延迟、数据依赖与故障恢复能力,远比离线指标(如AUC、F1)更能决定成败。本文围绕MLOps核心痛点——特征漂移、同步/异步时间错位、Fallback黑盒、监控断层与混沌韧性,深入解析如何将模型服务构建为具备契约意识、失败自愈与决策可溯的生产级系统。内容覆盖数据契约定义、弹性批处理、四层防御式监控(数据-特征-模型-业务)、影子模式验证及合规审计闭环,直击金融、风控等高SLA场景下的‘毫秒级确定性’需求。 阅读详情

相关推荐

AI辅助专利撰写实战:用Codex 30分钟生成发明专利初稿

这次我们来看一个用 Codex 从零开始撰写发明专利的实战项目。对于技术研发人员、产品经理或初创团队来说,专利申请是保护创新成果、构建技术壁垒的关键一步。然而,撰写一份高质量的专利申请书,尤其是权利要求书和说明书,往往需要专业的法律和技术语言,耗时耗力。这个项目演示了如何利用 AI 工具 Codex,在短时间内生成一份结构完整、逻辑清晰、具备授权潜力的专利申请文件初稿。 整个过程的核心不是让 AI 完全替代专利代理人,而是将其作为强大的“技术翻译”和“内容生成”助手。它能将你的技术构思、流程图、核心算法或产

weixin_32181267的博客 417

java 常见软件的性能指标

Akka:Akka 是一个基于 Actor 模型的并发框架,可以支持数百万的并发连接。从报告中,我们可以得出 Redis 的单机 QPS 可以达到 8w+(CPU 性能有关系,也和执行的命令也有关系比如执行 SET 命令甚至可以达到 10w+QPS)。需要注意的是,并发连接数只是衡量并发能力的一个指标,还需要考虑每个连接的处理时间、资源消耗等因素。Spring 框架:Spring 本身不直接处理并发,但是它可以与支持高并发的技术如 Netty、Vert.x 等集成,因此具体并发量取决于所使用的技术。

bareape的博客 5452

电子发票二维码背后的秘密:10分钟看懂校验码、加密字符含义与防伪设计

本文深入解析电子发票二维码的结构与防伪设计,揭示校验码和加密字符的生成原理及验证方法。通过实际案例和技术细节,帮助财务人员理解电子发票的安全机制,提升防伪识别能力,确保税务合规。

weixin_29248611的博客 533

QPS瓶颈限制

如果有有10WQPS的流量进入,只能进行服务器的扩容,将流量转嫁到服务器上,并且MYSQL因为瓶颈数过低,需要进行多次分层扩容才能满足查询及插入的需求。redis则需要根据业务场景考虑是否进行多次分层。本质上还要根据单台服务器的QPS上限来计算。2.Redis单台机器QPS瓶颈在20000左右。1.MYSQL单台机器QPS瓶颈在4000左右。

weixin_45647550的博客 1679

BDD测试之Behave使用入门

BDD测试(Behavior-Driven Development Testing)是一种基于“行为驱动开发”(BDD)理念。

想要成为酷盖但是失败的小明 581

微信小程序OCR身份证识别实战:从拍照到信息提取全流程解析

本文详细解析了微信小程序中OCR身份证识别的全流程实现,从环境配置、拍照上传到OCR核心识别及安全优化。通过微信开发者工具和OCR插件,开发者可快速构建高效的身份信息采集系统,提升用户体验和数据安全性。重点介绍了图像处理、加密传输及混合云架构等企业级解决方案。

j0k1l2m3n的博客 458

Mysql性能指标

一、QPS Queries Per Second意思是“每秒查询率”,是一台服务器每秒能够相应的查询次数 是对一个特定的查询服务器在规定时间内所处理流量多少的衡量标准。 普通的可以通过status 查看, 展示的一个平均值, 是通过下面 mysql重启后开始计算的Questions 查询次数;Uptime 到现在的时间; 这里有一个问题: 这里只能看见开机到现在的,如果我们需要看现在实时的QPS,怎么看了 mysqladmin extended-statu.....

u010648194的博客 5033

如何使用 ABAP 代码调度一个 ABAP 程序,让其以后台作业的方式运行

笔者之前的教程,介绍了如何使用 SM36 一系列事务码,将一个 ABAP 程序,调度成以后台作业方式运行的详细步骤。 38. 如何让 ABAP 报表在后台作业的模式下运行 大家如果照着上述文章的步骤走一遍,会发现这些手动执行的步骤还是有些繁琐的。 有没有可能让这一切都自动化起来,即通过 ABAP 代码去完成呢?当然可以。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1945

天天用MySQL开发,你知道数据库能抗多大并发压力吗?

很多小伙伴天天基于mysql做系统开发,但是写的系统都是低并发压力、小数据量的,上线了也能正常跑。但是你知道连接的MySQL数据库到底能抗多大并发压力吗?如果MySQL数据库扛不住压力应该如何演进呢?

石杉的架构笔记 1万+

QMK键盘固件开发零基础教程(2025全新重制版)

《QMK键盘固件开发零基础教程(2025全新重制版)》是一套专为键盘爱好者和开发者设计的全面教程,旨在帮助用户从零基础快速掌握最新的QMK固件开发技术。教程基于2025年最新的QMK版本(0.19.8+),解决了旧版教程中的诸多问题,如概念不清、步骤缺失和代码过时等。新版教程提供了详细的图解、完整的项目源码以及从环境配置到高级功能开发的全流程指导。此外,教程还涵盖了2024年QMK生态的重大变革,包括键码系统的重构、编译工具链的更新以及Config文件格式的改变等。付费版教程额外提供独家内容,如新特性解析、

Despacito0o的博客 1121

23、微波电路中的过孔、过孔围栏与接地焊盘建模分析

本文详细分析了微波电路设计中过孔、过孔围栏及接地焊盘的建模与优化方法。探讨了过孔模型的发展及其电感与电容特性,通过场求解器和集总元件模型提高建模精度。此外,分析了过孔隔离围栏在改善信号隔离中的作用,并通过2.5D和3D电磁仿真验证其效果。最后,研究了接地焊盘中过孔布局对电路稳定性的影响,提出了优化过孔位置以消除谐振和杂散振荡的方法。文章为微波电路设计提供了重要的理论支持和实践指导。

convnet3designer的博客 164

天天使用MySQL,你知道MySQL数据库能抗多少压力吗?附(真实案例)

好了,今天分享的知识就到这里了,其实我们的数据库架构演进基本上就是按照今天说的这个顺序和思路逐步逐步的演进的,刚开始你单台数据库机器抗几千并发扛不住了,就按照业务系统拆分多个数据库机器,然后再扛不住了,就上主从架构分摊读写压力,再扛不住了就分库分表,多个机器抗数据库写入压力,最后总是可以用数据库架构抗住高并发压力的。

征服Bug的博客 4679

【目标检测】全局上下文感知的详解

目标检测中的全局上下文感知(Global Context Awareness)​是指模型在定位和识别目标时,能够有效利用图像中全局或大范围的上下文信息(如场景语义、目标间关系、空间布局等),而不仅仅依赖局部特征。这种能力显著提升了检测的鲁棒性,尤其是在复杂场景(如遮挡、小目标、密集目标)中表现突出。

浩瀚之水的专栏 650

10分钟砍掉70%数据库压力:go-zero内置的2个数据库加速器

接口P99卡在半秒以上,DBA天天催你优化?给服务加上 go-zero 数据库缓存和读写分离这两个内置能力,10分钟配置,数据库承受的压力能砍到原来的五分之一。本文手把手带你落地。 ## 对号入座:这3个症状你中了几个 - **热点页面被秒级刷爆**:创作者主页每秒被看上千次,每次请求都直连数据库,后果是连接池耗尽,响应时间直接翻3倍。 - **读多写少却全压在主库**:90%的流量是查询,却

gitblog_00270的博客 944

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

自建数据库vs云端数据库

摘要:云端数据库服务(RDS、PolarDB等)相比自建数据库优势显著:运维从数周缩减至分钟级(如RDS 10分钟自动扩容),故障切换从3分钟降至秒级(PolarDB<10秒),性能提升显著(TPS最高达3.5万)。真实案例显示,电商/银行等客户使用后实现零故障、成本下降60%(银行年省12万)、运维效率倍增(如Redis库存准确率100%)。云数据库通过托管服务和弹性架构,解决了自建数据库在扩容慢、高可用差、人力成本高等痛点。

m0_66705547的博客 540

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

第30章:【中级篇综合实战】MySQL构建高可用订单数据库集群

本章以中型电商单机瓶颈为背景,交付生产级高可用订单数据库集群。目标架构采用三节点MGR单主模式+MySQL Router透明路由,分三阶段从一主一从异步复制升级到半同步GTID再到MGR。部署Prometheus+Grafana+Alertmanager三层监控,配置8条核心告警,并通过故障演练验证RTO<60秒、RPO≈0。性能压测对比集群吞吐,备份从Secondary执行。最后总结MGR优缺点、适用场景及Clone带宽、Router路由规则等踩坑经验。

davidwang456的专栏 593

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

返利系统数据库优化实战:读写分离与分库分表完整复盘

在业务高速增长中,数据库往往会成为最先暴露瓶颈的环节。面对高并发读写、海量订单数据以及实时性要求极高的资金流转场景,MySQL架构的合理设计显得尤为关键。本文从数据库性能优化的基础概念出发,系统梳理了读写分离、分库分表、主从复制等核心技术在返利系统中的应用路径。通过深入分析主从延迟、行锁竞争、跨分片查询等典型案例,展示了如何借助合理的分片策略与一致性设计,将数据库压力从单点集中式转向弹性扩展式,从而支撑CPS、分销平台的稳定运行。无论是解决订单表千万级数据膨胀,还是应对大促峰值流量,这些工程实践都为后端开发

weixin_34239592的博客 132

用户从1万到100万,我们如何不重写代码,让系统扛住了压力?

《从崩溃边缘到性能飞跃:百万用户系统的急救指南》 面对用户激增引发的系统崩溃危机,技术团队通过精准诊断和低成本优化实现300%性能提升。关键步骤:1) 快速定位高频接口与慢查询拖垮数据库;2) 采用Redis缓存+SQL优化+前端防抖的"微创手术"组合拳,使QPS下降90%;3) 部署自动伸缩与冷数据迁移,降低60%运维成本;4) 建立智能监控预警体系变被动为主动。本文揭示了性能优化的核心逻辑:精准打击瓶颈比盲目扩容更有效,为面临类似困境的团队提供可落地的急救方案。

OBJUI 577

ShardingSphere选型与分库分表读写分离实战指南

数据库水平扩展是应对海量数据与高并发写入的必经之路,而分库分表作为核心手段,需要解决数据路由、扩容和运维复杂度等难题。ShardingSphere作为主流的数据库中间件,提供JDBC与Proxy两种接入形态,分别面向应用内嵌入和独立代理场景,在透明性、连接数控制与多语言支持上各有取舍。合理设置分片键、选择分片算法并联动读写分离,才能真正发挥其价值。从新项目改造到存量系统迁移,从连接数优化到主从延迟规避,本文梳理了实际工程中的选型逻辑与配置要点,帮助后端团队快速定位适合自身业务的技术路径,并避免常见陷阱。

cuixie2370的博客 354

PolarDB-X选型与迁移实战指南:从MySQL分库分表到分布式数据库落地

分布式数据库是应对单库性能瓶颈、分库分表复杂性及强一致事务挑战的关键技术方案。其核心原理在于通过计算与存储分离、全局索引和分布式事务协调,实现水平扩展与一致性保障。技术价值体现在降低运维成本、提升高并发稳定性,并支持百万级QPS与毫秒级跨库查询。典型应用场景包括电商订单系统、金融账务、物流跟踪等需海量数据+强事务+低延迟的业务。阿里云PolarDB-X凭借MySQL协议兼容、准不停服迁移能力及企业级运维工具链,成为中大型企业从MySQL平滑升级的务实选择,尤其适合已遭遇QPS超8000、跨分片查询超1.5秒

weixin_29294975的博客 298

单机MySQL扛不住?从真实案例看分布式数据库选型与PolarDB-X落地实践

当业务增长越过单机数据库的临界点,慢查询、连接数瓶颈和热点写冲突便会集中爆发。分布式数据库的核心价值并非让单条SQL跑得更快,而是通过水平扩展将压力分散到多节点,实现像使用单机MySQL一样操作分布式集群。从电商大促、金融强一致到物流轨迹存储,真实场景验证了透明分布式、全局二级索引与在线扩缩容等能力如何降低迁移成本。面对数据库选型,需从数据量、峰值QPS、峰均比等维度体检,并通过分布式JOIN、事务并发及扩缩容平滑度压测来验证。PolarDB-X作为兼容MySQL的分布式数据库,为分库分表与中间件运维提供了

weixin_42116058的博客 258

阿里云MySQL选型指南:自建vs瑶池RDS决策框架

MySQL数据库选型是企业架构演进的关键起点,涉及部署模式、运维责任与成本结构的根本性权衡。理解自建MySQL与云托管服务(如阿里云瑶池RDS)的本质差异,需从‘责任边界转移’切入——前者要求全栈运维能力,后者通过SLA将高可用、备份、安全等能力产品化。技术价值体现在降低故障响应时间、规避隐性人力成本、加速微服务与混合云演进;典型应用场景覆盖初创SaaS的快速上线、政企系统的等保合规、高并发直播平台的弹性分层。本文聚焦阿里云生态下MySQL与瑶池RDS的实操决策逻辑,结合QPS、数据量、安全等级等硬指标,拆

weixin_34391445的博客 456

MySQL容量规划实战:从原理到避坑指南

数据库容量规划是保障系统稳定性的关键技术,其核心在于通过监控数据增长趋势、业务峰值压力和资源瓶颈预判风险。在MySQL场景中,InnoDB存储引擎的缓冲池机制和索引结构使得内存与磁盘的配比尤为关键,合理的容量规划能显著降低硬件成本并避免OOM等生产事故。通过sysbench压测工具模拟真实负载,结合Prometheus+Granafa监控体系,可建立从数据采集、趋势分析到弹性扩容的完整解决方案。本文重点解析电商大促、物联网时序数据等典型场景中,如何通过分表策略、参数调优(如innodb_buffer_poo

weixin_30225755的博客 276

ShardingSphere分库分表实战:JDBC/Proxy选型与读写分离联动解析

分库分表是应对海量数据存储与高并发访问的关键技术,通过将数据分散到多个数据库实例,突破单库容量和性能瓶颈。其核心原理依赖路由规则与数据分片策略,而读写分离则通过主从复制分担读压力。在实际工程中,数据库中间件如ShardingSphere提供了JDBC与Proxy两种接入形态,分别适用于嵌入式集成与独立部署场景。理解路由优先级、事务边界与扩容方案,是保障系统稳定性的基础。本文将围绕ShardingSphere的形态选型、分片边界设计以及读写分离联动中的常见问题,梳理可落地的实践路径。

weixin_33860553的博客 307

智能体工程化落地:21个扛住百万QPS的架构模式

智能体(Agent)作为大模型落地的关键范式,其核心挑战早已超越模型能力本身,转向真实业务场景下的稳定性、可观测性与安全治理。本文从状态流控制、工具协同、安全治理、可观测性及弹性伸缩五大功能域出发,系统梳理21种经产线验证的工程机制——包括状态快照+事务日志双轨恢复、工具路由表+熔断器前置、动态凭证注入与字段级脱敏、三级日志颗粒度标准、分级队列控制器等。这些模式直击智能体项目高频故障点:对话状态丢失、工具调用雪崩、权限越界泄露、日志无法定位根因、资源瓶颈误判。适用于需对接ERP、IoT、审批流等复杂系统的工

weixin_29057163的博客 274
上一篇: 大量示例彻底搞懂Linux查找,which,whereis,locate,find
下一篇: 天擎YII_CSRF_TOKEN反序列化远程代码执行(含批量验证poc)
普通网友
博客等级 码龄5年 4697粉丝 610原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值