项目总面试技巧,利用Selenium模拟浏览器进行爬虫,解析底层原理

万字博文教你爬虫必备 -> Selenium【详解篇】(上) 我们伟大的Python为我们提供了许多模拟浏览器运行的库,其中比较强大&&用的较多的就是Selenium。接下来几篇博文带领小伙伴们走入Selenium的世界! 阅读详情

count = 0

def getCommentList():

global count

try:

commentList = driver.find_elements_by_css_selector(‘div.reply-content’)

print (commentList)

for comment in commentList:

content = comment.find_element_by_tag_name(‘p’)

print(content.text)

count = count + 1

return commentList

except:

return None

def clickMoreButton() -> bool:

try:

moreButton = driver.find_element_by_css_selector(‘button.page-last-btn’)

moreButton.click()

return True

except:

return False

def main():

while True:

请求一次即可

try:

driver.switch_to.frame(driver.find_element_by_css_selector(“iframe[title=‘livere-comment’]”))

自我介绍一下,小编13年上海交大毕业,曾经在小公司待过,也去过华为、OPPO等大厂,18年进入阿里一直到现在。

深知大多数Python工程师,想要提升技能,往往是自己摸索成长或者是报班学习,但对于培训机构动则几千的学费,着实压力不小。自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!

因此收集整理了一份《2024年Python开发全套学习资料》,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友,同时减轻大家的负担。
img
img


既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,基本涵盖了95%以上Python开发知识点,真正体系化!

由于文件比较大,这里只是将部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新

如果你觉得这些内容对你有帮助,可以添加V获取:vip1024c (备注Python)
img

文末有福利领取哦~

👉一、Python所有方向的学习路线

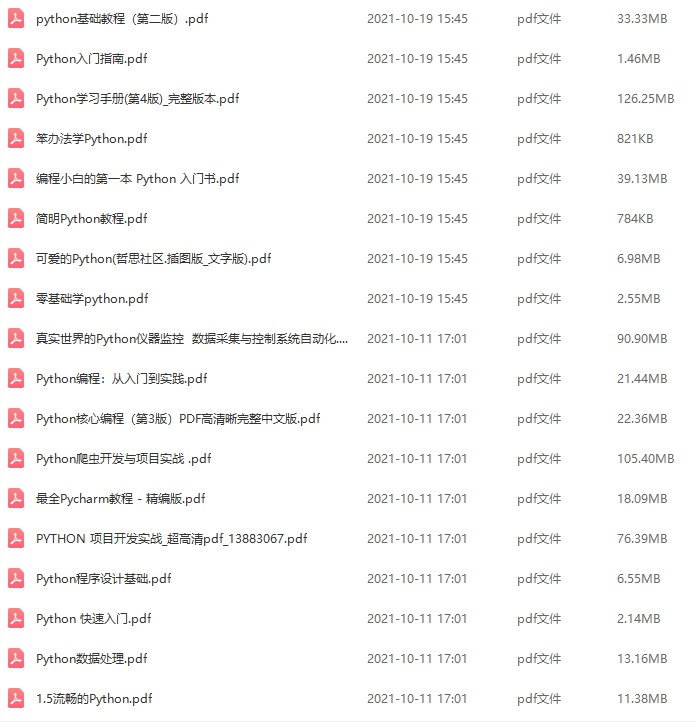
Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。img

👉二、Python必备开发工具

img
👉三、Python视频合集

观看零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。
img

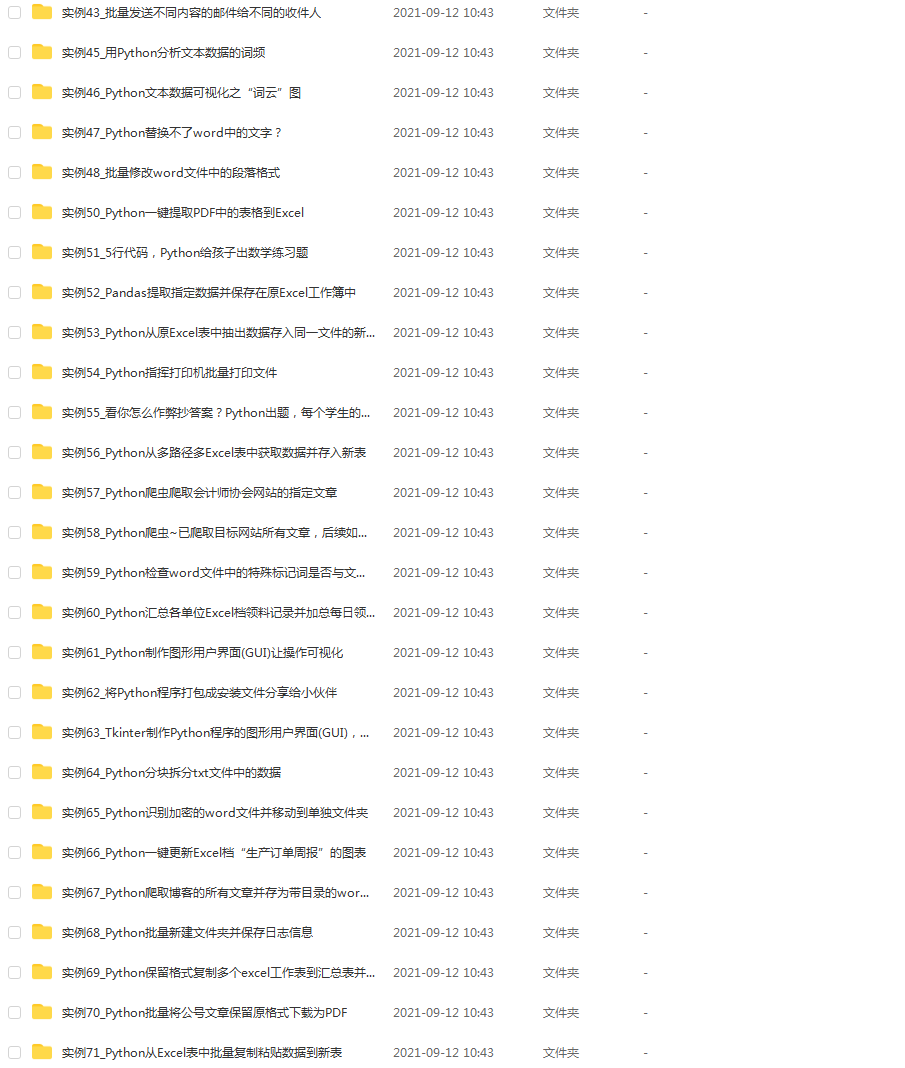
👉 四、实战案例

光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。(文末领读者福利)
img

👉五、Python练习题

检查学习结果。
img

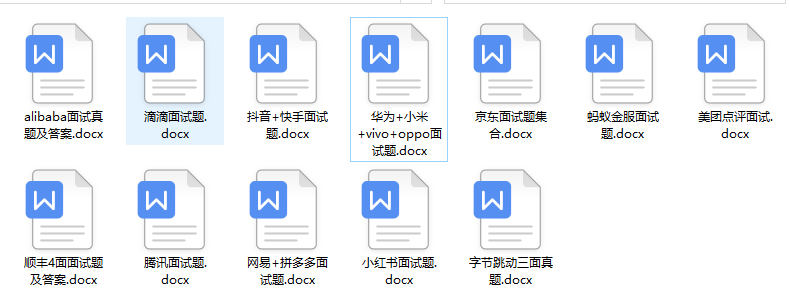
👉六、面试资料

我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。
img

img

👉因篇幅有限,仅展示部分资料,这份完整版的Python全套学习资料已经上传

一个人可以走的很快,但一群人才能走的更远。不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎扫码加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!
img

从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎扫码加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!**
[外链图片转存中…(img-naxDh02S-1712615637921)]

《爬虫和逆向教程》 - 专栏介绍和目录 本专栏为爬虫初学者和进阶开发者量身定制的爬虫和逆向学习园地。为你提供全面而深入的爬虫和逆向技术指导,从入门到精通,从基础理论到高级实战,助你在数据的海洋中畅游,挖掘出有价值的信息。通过本专栏的学习,你将具备独立开发和优化爬虫程序的能力,及逆向分析能力和项目开发能力,成为爬虫领域的佼佼者。 阅读详情

相关推荐

基于Xilinx的I2S Receiver IP核和I2S Transmitter IP核音频验证

基于Xilinx的I2S Receiver IP核和I2S Transmitter IP核音频验证 文章目录前言一、工程构架二、Xilinx IP的配置1.I2S Transmitter IP配置:2.I2S Receiver IP配置:3.WM8960的配置:总结 前言 本实验基于Xilinx ZU4EV平台,也适用于ZYNQ平台。音频验证完成,记录调过程。 ①Xilinx 音频IP只支持主模式,左对齐或右对齐方式,16bit或24bit字长。 ②WM8960器件作为从模式;24bit字长;数据传输格

weixin_45637597的博客 6816

面试宝典之爬虫面试题

来源:Python全家桶 链接:https://mp.weixin.qq.com/s/vqDkLyuuUdedgSYjduX9BQ前边已经分享了20道深度学习相关的...

python爬虫人工智能大数据 6679

LTE 中设置voice/data centric的差异

1. 什么是voice centric和data centric Voice centric和data centric的差别在于以语音为中心还是以数据为中心。这里的以某某为中心可不是说说而已。举个栗子,UE一般搜网注册都会按照LUG(LTE->UMTS->GSM)或者LC(LTE->CDMA)的顺序进行,如果UE(未开通VOLTE)注册到LTE时,网络提示不支持语音,比如CSFB。UE就必须disable LTE后回到GU或者CDMA,否则留在不能语音的网络下,UE就会...

alimingh的博客 5236

python爬虫面试题及答案-Python面试题爬虫篇(附答案)

第一部分 必答题注意:第31题1分,其他题均每题3分。1,了解哪些基于爬虫相关的模块?-网络请求:urllib,requests,aiohttp-数据解析:re,xpath,bs4,pyquery-selenium- js逆向:pyexcJs2,常见的数据解析方式?- re、lxml、bs43,列举在爬虫过程中遇到的哪些比较难的反爬机制?-动态加载的数据-动态变化的请求参数-js加密-代理- co...

weixin_39737636的博客 4457

LIO-SAM运行报错‘process has died’?别慌,一个命令搞定libmetis.so库路径问题

本文详细解析了LIO-SAM运行中常见的‘process has died’报错问题,特别是由libmetis.so库路径错误导致的节点崩溃。通过一个简单的命令移动库文件到正确位置,即可快速解决这一问题,同时提供了多种替代方案和预防措施,帮助开发者更好地理解Linux动态库加载机制和ROS环境管理。

weixin_29231221的博客 206

LSTM+Transformer混合模型时间序列预测实战教学

LSTM+Transformer混合模型时间序列预测实战教学 毕业设计

8221

python 3网络爬虫开发实战这本书怎么样?_《python网络爬虫开发实战》

Python崛起并且风靡,因为优点多、应用领域广、被大牛们认可。学习 Python 门槛很低,但它的晋级路线很多,通过它你能进入机器学习、数据挖掘、大数据,CS等更加高级的领域。Python可以做网络应用,可以做科学计算,数据分析,可以做网络爬虫,可以做机器学习、自然语言处理、可以写游戏、可以做桌面应用…Python可以做的很多,你需要学好基础,再选择明确的方向。这里给大家分享一份全套的 Python 学习资料,给那些想学习 Python 的小伙伴们一点帮助!

2401_84140112的博客 671

zynq的irq_f2p 如何增加或修改中断引脚个数(宽度)

ZYNQ开发过程中,如果使用PL到PS的中断,会产生一个疑问,设置界面显示可以有[91:84]、[68:61]共16个中断引脚,但是并没有设置中断口的宽度,如果使用多个中断引脚,应该怎么办?如果通过concat连接多个引脚,则自动调整为对应的引脚数。例如连接3个中断信号,则自动调整为:IRQ_F2P[2:0]

FPGA艺术家的博客 838

python 3网络爬虫开发实战这本书怎么样?_《python网络爬虫开发实战》(2)

① 2000多本Python电子书(主流和经典的书籍应该都有了)② Python标准库资料(最全中文版)③ 项目源码(四五十个有趣且经典的练手项目及源码)④ Python基础入门、爬虫、web开发、大数据分析方面的视频(适合小白学习)⑤ Python学习路线图(告别不入流的学习)除了网络图书是成体系的经验分享,《python 3网络爬虫开发实战》这本书怎么样?这本书记录了崔庆才先生对爬虫实战技术开发最精华的部分,人工智能的浪潮和深度学习技术的突破密不可分,却很少有人会谈论另一位幕后英雄即数据。

2401_84140112的博客 766

EuROC 数据集格式及相关代码

Euroc提供ROS和zip两种数据格式。

~勿据散客~的博客 2093

CUDA-GDB(11)——调试示例演练

本博客包含三个CUDA-GDB的演练示例: ​​​​▶ Example: bitreverse ▶ Example: autostep ▶ Example: MPI CUDA Application

AI-安全-功耗 1516

Java爬虫原理实现及面试点整理

网络爬虫(Web Crawler)是一种按照一定规则,自动抓取互联网信息的程序或脚本。核心流程textURL队列 → 下载页面 → 解析内容 → 提取数据 → 存储数据 → 发现新URL → 继续循环。

2503_92804185的博客 1938

数据分析!Python爬虫爬取B站UP主数据并分析涨粉规律(附可视化图表)

爬取更多UP主:扩充列表,增加需要分析的UP主UID数量爬取更多作品:修改的参数,增加每个UP主的作品爬取页数新增分析维度:在类中添加方法,可分析发布时间(如定时发布对涨粉的影响)、内容标签(如游戏/知识区涨粉差异)优化可视化样式:调整方法中的图表类型、颜色、标题等,适配个人展示需求播放量与粉丝数强正相关:从相关性热力图可看出,总播放量与粉丝数的相关系数通常在0.8以上,说明曝光量是涨粉的核心基础作品数量存在“边际效应”

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1229

【2023年】崔庆才 Python3 网络爬虫学习教程

要学爬虫,首推的就是 Python 语言,简单快速易上手,且 Python 语言的爬虫生态极其丰富。

bagell的博客 1707

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

爬虫怎么学?_爬虫怎么学习(1)

当工作中没有你需要的数据,你要从上网搜集一些数据时,这时候就可以利用爬虫模拟浏览器打开网页,获取网页中我们想要的那部分数据,从而提高工作效率。另外构建自动化表格也是可以用爬虫做到的,也就是通过爬虫搜集特定数据,然后自动保存到Excel中实现自动化表格的构建。

2401_84140707的博客 2389

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Python爬虫(一):了解爬虫

本文摘要:网络爬虫技术详解 网络爬虫是一种自动化程序,通过模拟人类浏览行为系统化收集网络数据。文章系统介绍了爬虫的核心原理和技术实现:1)按目标范围分为通用爬虫、聚焦爬虫、增量爬虫和深层爬虫;2)按技术实现分为静态页面、动态页面、API和浏览器模拟爬虫。详细解析了爬虫系统的五大核心组件(URL管理器、下载器、解析器、存储器、调度器)及其工作流程,并提供了Python实现的系统架构代码示例。文章强调爬虫不仅是技术工具,更是实现信息民主化的重要方式,为数据分析等领域提供了数据获取的解决方案。

每天都在认真分享,期待您的关注 1055

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

什么是IP代理和爬虫技术?

在数字时代,数据成为了新的石油。从企业到研究人员,都在争先恐后地获取和分析数据。本文深入探讨了IP代理和爬虫技术的重要性与实用性,涵盖了网络爬虫的工作原理、IP代理的作用,以及它们如何相辅相成地解决数据采集中的难题。通过详细的技术分析和代码示例,无论你是数据采集领域的新手还是专家,都能从中获益。关键词包括:IP代理、网络爬虫、数据采集、反爬虫策略、技术解决方案等,旨在帮助本文通过搜索引擎如百度更容易被发现。技术功能应用场景IP代理隐藏真实IP数据采集、隐私保护网络爬虫自动化数据采集。

猫头虎技术团队:授渔优于赠鱼,兴趣引领智慧,探索之乐尤显珍贵。商务合作+:Libin9iOak ,万粉变现+:优快云WF,猫头虎承诺每年免费为100名C站创作者做账号流量诊断服务!全网搜:猫头虎技术团队,点击文章底部名片或直接私信我一切皆可谈,快找虎哥! 6342

python爬虫相关面试题

这一般是指WWW服务器中安装的一个功能,当有人来访问这个服务器中的网站时,服务器中的这个功能就将网页内容压缩后传输到来访的电脑浏览器中显示出来.一般对纯文本内容可压缩到原大小的40%.这样传输就快了,效果就是你点击网址后会很快的显示出来.当然这也会增加服务器的负载*. *一般服务器中都安装有这个功能模块的。它支持各种浏览器,包括 Chrome,Safari,Firefox 等主流界面式浏览器,如果你在这些浏览器里面安装一个 Selenium 的插件,那么便可以方便地实现Web界面的测试。

smile6868的博客 650

爬虫面试

谈一谈你对 Selenium的了解   Selenium是一个Web 的自动化测试工具,可以根据我们的指令,让浏览器自动加载页面,获取需要的数据,甚至页面截屏,或者判断网站上某些动作是否发生。   Selenium 自己不带浏览器,不支持浏览器的功能,它需要与第三方浏览器结合在一起才能使用。但是我们有时候需要让它内嵌在代码中运行,Selenium库里有个叫 WebDriver 的...

diesuan4284的博客 486

Python爬虫副业接单月入过万,不吹!(小白爬虫书籍推荐)

利用python在网上接单赚钱 , 兼职也能月入过万适用人群:上班族 , 程序员 , 大学生。学习python编程 不仅可以找一份高薪工作 , 而且如果不打算转行或者是在校学生的话 , 也能为你日常生活工作提供一些帮助。比如:自动化办公爬取、数据信息之类等等。另外闲暇时间也能在网上接一些小单 , 增加一些收入 起码不用为生活费发愁。兼职工资上面就是我目前接的最大的一个单子,作为一个准大二的学生,就能靠着兼职给父母和女朋友买点小礼物,心里别提有多高兴了!

m0_58477260的博客 1107

python爬虫面试真题及答案_Python面试题爬虫篇(附答案)

0|1第一部分 必答题注意:第31题1分,其他题均每题3分。1,了解哪些基于爬虫相关的模块?- 网络请求:urllib,requests,aiohttp- 数据解析:re,xpath,bs4,pyquery- selenium- js逆向:pyexcJs2,常见的数据解析方式?- re、lxml、bs43,列举在爬虫过程中遇到的哪些比较难的反爬机制?- 动态加载的数据- 动态变化的请求参数- js...

weixin_29480659的博客 4255

走过路过不容错过,Python爬虫面试总结

Python爬虫面试总结1. 写一个邮箱地址的正则表达式?[A-Za-z0-9\u4e00-\u9fa5]+@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]...

人生代码 ---- 公众号 1024

【一起学爬虫】爬虫基本原理

#什么是爬虫 请求网站,提取网页内容的最大化程序。获取到的是html代码,需要从这些文本中提取需要的数据 发起请求: 向目标站点发送HTTP请求,即发送一个Request,请求可以包括额外的header等信息,等待服务器响应 2.获取响应内容 如果服务器正常,在第一步会返回一个response,response的内容便是所要获取的页面内容,类型可能有HTML,Json字符串、二进制数据(...

weixin_34205076的博客 97

如何爬取优快云全站综合热榜标题,顺便统计关键词词频 | 爬虫案例

Python崛起并且风靡,因为优点多、应用领域广、被大牛们认可。学习 Python 门槛很低,但它的晋级路线很多,通过它你能进入机器学习、数据挖掘、大数据,CS等更加高级的领域。Python可以做网络应用,可以做科学计算,数据分析,可以做网络爬虫,可以做机器学习、自然语言处理、可以写游戏、可以做桌面应用…Python可以做的很多,你需要学好基础,再选择明确的方向。这里给大家分享一份全套的 Python 学习资料,给那些想学习 Python 的小伙伴们一点帮助!

2401_83621918的博客 558

怎样利用 python 学习爬虫?

先讲讲我自己吧,去年我利用,最主要的是爬虫需求基本都是通用的,所以只要你掌握了主流的方法,到哪里都很吃香。下面讲讲怎么利用python去学习爬虫。先讲一下这两个概念,,我们只是使用python语言工具去实现爬虫功能,C++能不能写爬虫也是可以的,Java也可以写爬虫,只要是有网络功能的都是可以做爬虫设计。只是现在python的现成库比较多,所以大家比较喜欢使用python来进行爬虫学习。

m0_58477260的博客 781

爬虫面试手册

爬虫岗位要求和常见面试题

u010926168的博客 2886
上一篇: 项目实践过程怎么写,快来用Python制作只属于你和ta的聊天渠道吧,7年老Python一次操蛋的面试经历
下一篇: 项目总面试技巧,数据科学家常用的24个Python库,五面拿下阿里飞猪offer
普通网友
博客等级 码龄5年 4697粉丝 610原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值