Gemini 3.6 Flash 国内怎么调用?不同 API 渠道价格和稳定性对比

‌Gemini 2.5 Pro 定价体系 Gemini Advanced 订阅‌:‌19.99 美元/月‌,包含基础额度 API 调用权限及长期上下文支持,性价比显著高于 OpenAI 同类服务。输入 Token‌:每百万 Token 收费 ‌1.25 美元‌(约人民币 9.1 元)输出 Token‌:每百万 Token 收费 ‌10 美元‌(约人民币 72.9 元)输入 Token‌:费用上调至 ‌2.50 美元/百万‌(约人民币 18.2 元)输出 Token‌:费用升至 ‌15 美元/百万‌(约人民币 109 元) 阅读详情
  • Gemini 3.6 Flash 适合做什么?

Gemini 3.6 Flash 是 Google 于 2026 年 7 月发布的模型。Oken 页面标注其支持对话、识图、深度思考、编码、长文本处理和多模态融合。

它更适合需要兼顾速度和成本的生产力场景,例如代码辅助、文档理解、图片识别、多步骤任务处理等。页面介绍中提到,相较上一代 Gemini 3.5 Flash,它在代码和多模态任务上提升了效率,部分代码基准场景下 Token 消耗也更低。

  • 先区分官方价格和第三方线路价格

Google Gemini API 定价页的 Gemini 3.6 Flash 付费档显示:输入 $1.50 / 百万 Token,输出(含思考 Token)$7.50 / 百万 Token,上下文缓存 $0.15 / 百万 Token。
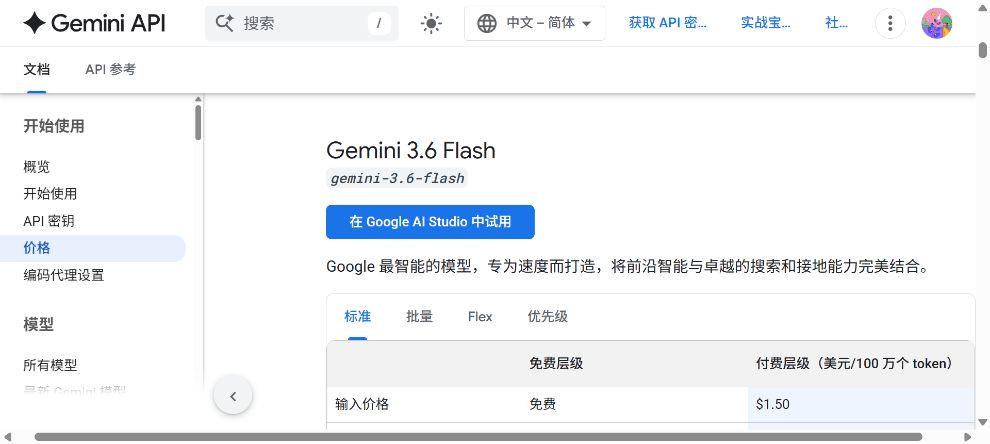
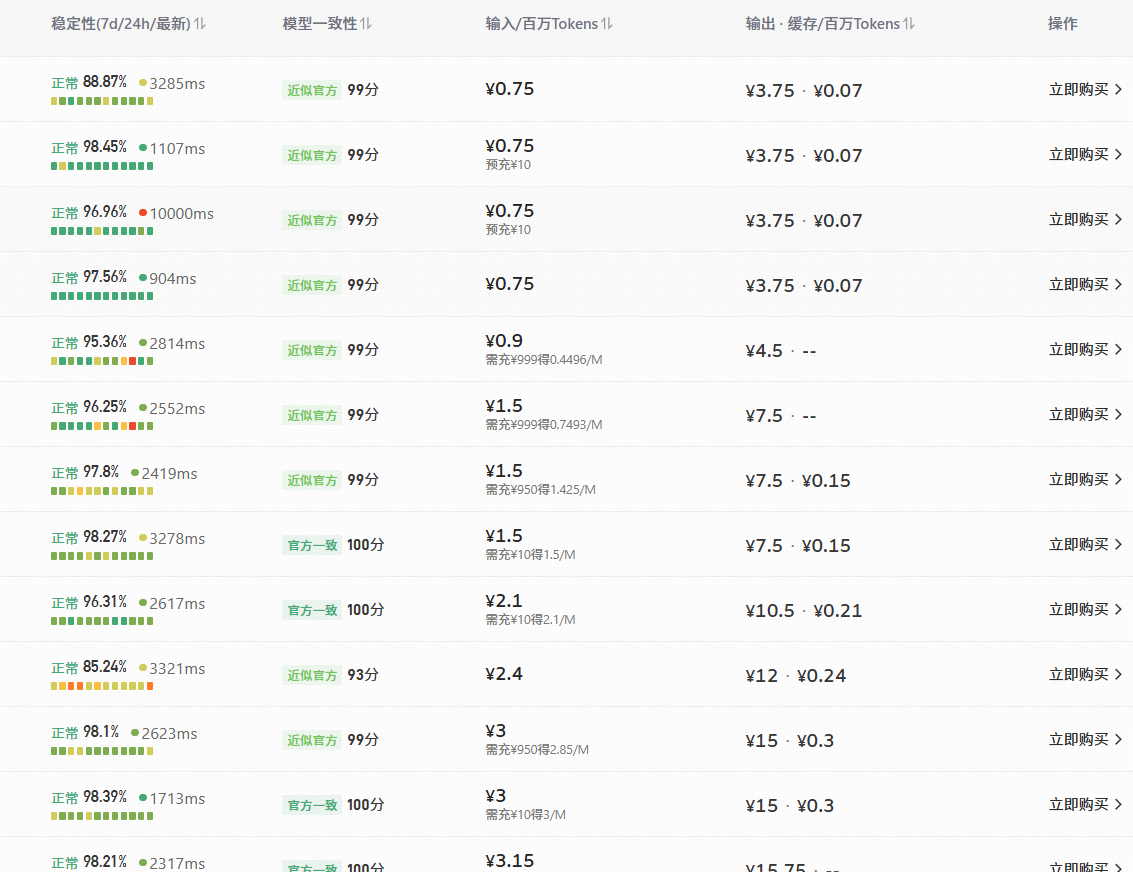
第三方平台通常采用人民币计费和本地化充值,两者是不同计费体系,不能直接认为同价。
  • Token 成本如何估算

总成本 = 输入 Token 数 / 1,000,000 × 输入单价 + 输出 Token 数 / 1,000,000 × 输出单价 + 缓存 Token 成本(如使用)

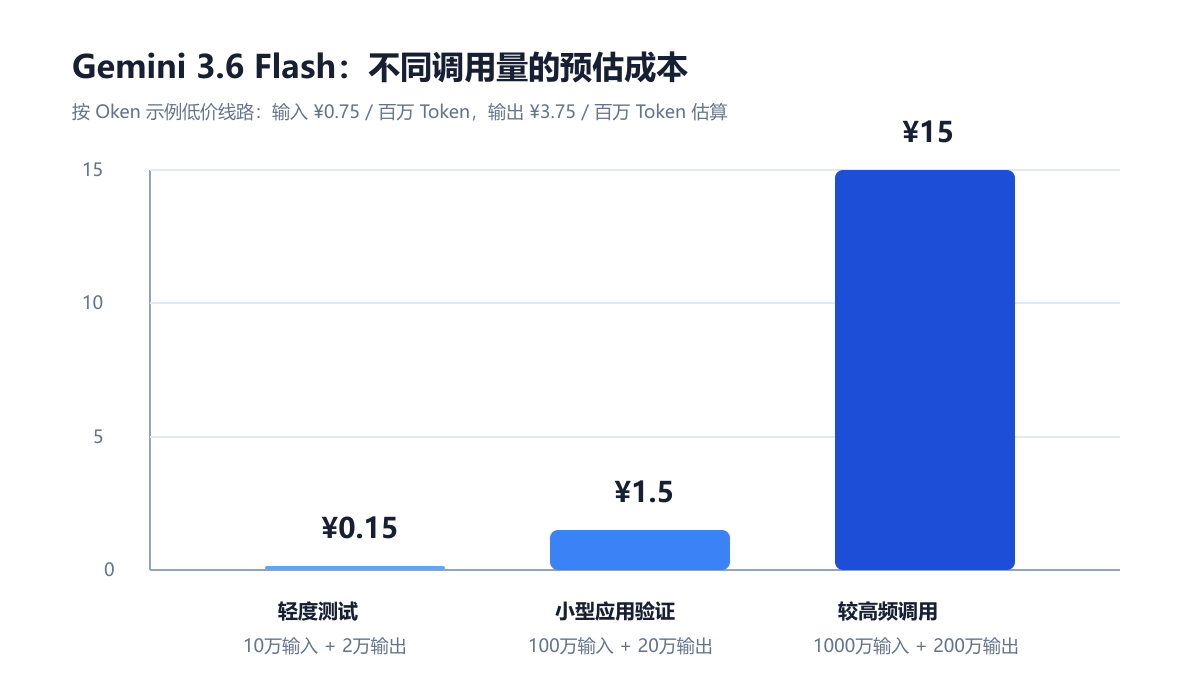
以输入 0.75 元、输出 3.75 元 / 百万 Token 的第三方示例线路计算:10 万输入 + 2 万输出约 0.15 元;100 万输入 + 20 万输出约 1.5 元;1000 万输入 + 200 万输出约 15 元。生产环境还需要将重试、缓存和线路切换成本纳入预算。
  • 选择线路时的四项检查

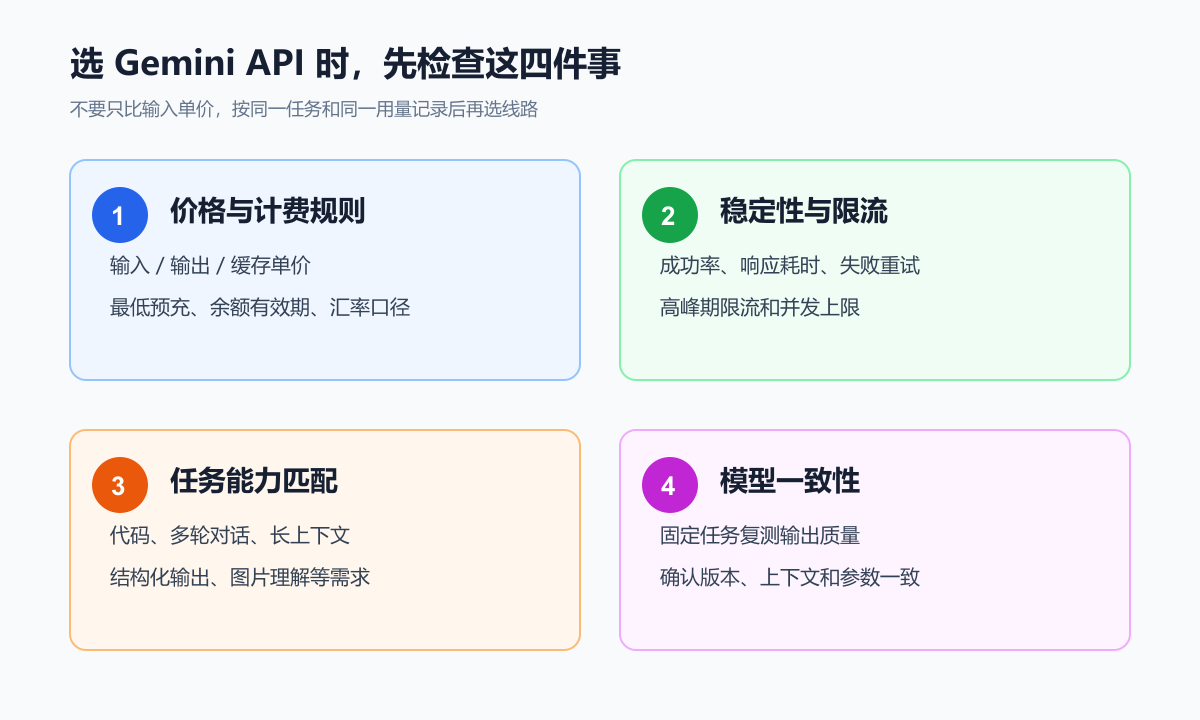
  • 价格:分别看输入、输出、缓存单价,以及最低预充和余额有效期。

  • 稳定性:记录成功率、P95 响应耗时、超时率和高峰期限流。

  • 任务能力:用代码、长上下文、结构化输出等真实任务连续复测。

  • 模型一致性:确认模型版本和参数,并与官方输出做固定样本对照。

  • 推荐的接入方式

个人开发者可以先选低预充、计费透明的线路,用真实项目验证;小团队应至少准备一条备用线路;生产业务则应优先看稳定性和故障响应,不要只按最低报价决策。

接入前可以做模型一致性和消耗的验证,再按自己的任务和用量选择。

Gemini API文档-模型 第8章:价格 Gemini API提供三种版本:免费版适合开发人员和小型项目,提供有限访问和免费令牌;付费版为生产应用提供更高限制、批量API和高级模型访问;企业版支持大规模部署,包含专属支持和安全合规功能。Gemini 3 Pro和2.5 Pro模型分别针对多模态理解和复杂推理任务,付费版按令牌数量计费,批量模式可降低成本50%。企业用户还可获得用量折扣和ML运维支持。 阅读详情

相关推荐

手把手教你搭建谷歌Gemini

此外,谷歌将使用免费版的输入和输出来提高模型的能力,但承诺付费版不会用于训练和改进产品,以保护用户的隐私。卷吧卷吧,反正白嫖你没商量,我们可以基于开源的项目(GeminiProChat)以及 Gemini 开放的免费 API 进行搭建一个对话的网站。关于上述的问题,比较好的解决办法,就是为网站分配一个没有被墙的域名,没有域名的可以到国内各大云厂商花几块钱搞个便宜的域名玩玩。我感觉回复速度还是可以的,中文体验也行,能够回答一些问题,害,都是白嫖的玩玩还是可以的,趁现在免费赶紧耗一耗。如何获取 APIkey。

java优质资源提供与创作者 7872

Gemini 2.5 Pro API恢复免费,每分钟5次、25万tokens及每日100次请求的免费额度

为开发者提供了更具吸引力的使用条件。根据最新信息,免费层级的API限制为请求、请求,以及的额度。这一免费政策的变化体现了谷歌对该模型的推广策略调整。Gemini 2.5 Pro作为谷歌的旗舰AI模型,在多模态处理、推理能力和长上下文窗口等方面具有显著优势。其API定价在付费层级为,超过20万token后价格会有所上调。

POLOAPI的博客 9660

OpenRouter集成Gemini Flash模型:国内开发者高性价比AI调用方案

AI模型API调用是现代应用开发的核心技术,其原理是通过标准化接口访问云端大语言模型。OpenRouter作为模型聚合平台,通过统一API格式解决了多模型接入的复杂性,为开发者提供了显著的技术价值。在工程实践中,API调用的稳定性和成本控制是关键考量因素,特别是在国内网络环境下。Gemini Flash系列模型针对推理速度优化,Gemini 3.6 Flash在代码生成和逻辑推理方面表现优异,而Gemini 3.5 Flash-Lite则提供了更具成本效益的轻量级解决方案。这些模型通过OpenRouter平

weixin_33898233的博客 416

Gemini Pro API 详细申请步骤

Gemini Pro API key 的详细申请步骤。

qq_52475653的博客 6247

Gemini 3.6 Flash与3.5 Flash Lite:轻量级AI模型选型与API实战指南

模型蒸馏与量化是优化大型语言模型的核心技术,通过减少参数规模实现计算效率的提升。其原理在于将复杂模型的知识迁移至更紧凑的架构,在保持基础能力的同时显著降低资源消耗。这一技术为AI应用带来了成本效益与部署灵活性的双重价值,尤其在文档摘要、数据清洗等批量处理场景中优势明显。Google推出的Gemini 3.6 Flash和3.5 Flash Lite正是基于此类技术打造的轻量级解决方案,前者侧重成本优化,后者专注低延迟环境,为开发者提供了从云端到边缘设备的完整AI能力覆盖。本文将以API调用实战为例,解析两者

weixin_34236869的博客 455

OpenRouter上线Gemini 3.6 Flash与3.5 Flash-Lite:模型选择与API集成指南

大语言模型API作为现代AI应用的核心技术,通过标准化接口实现了自然语言处理能力的快速集成。其工作原理基于深度学习架构,将文本输入转换为向量表示,经过多层神经网络处理生成智能响应。在技术价值层面,API化服务显著降低了AI应用开发门槛,使开发者能够专注于业务逻辑而非模型训练。典型应用场景包括智能客服、内容生成、代码辅助等需要自然语言交互的领域。以OpenRouter平台最新集成的Gemini系列模型为例,3.6 Flash凭借其强大的推理能力,在处理复杂代码生成和学术研究等任务时表现突出;而3.5 Flas

xpp02的专栏 208

2026年最值得关注的6个AI新模型,国内中转API价格全面对比

最近这段时间,AI模型圈子可以说是热闹非凡。Anthropic、Google、OpenAI三家几乎同时放出了一批让人眼前一亮的新模型。但对于国内开发者来说,直连官方API不仅需要解决支付问题,还要面对网络延迟、限速等各种麻烦。本文数据基于各中转服务商公开报价整理,价格可能随时调整,请以各平台实时报价为准。如有疑问或数据更新,欢迎在评论区留言。因此成了很多人的首选。

Cvmax的博客 2065

Gemini 3.5 Flash 生产级API契约升级指南

大语言模型API调用正从实验性集成迈向生产级契约化——以Gemini 3.5 Flash为代表的新一代模型,将function calling、thought preservation、context caching等能力从‘可选特性’升格为‘硬性接口规范’。其核心原理在于通过严格参数校验(如id透传、name大小写敏感、response结构强制嵌套)、思考链自动延续机制与上下文token增长建模,显著提升多轮协作与工具调用的确定性。技术价值体现在降低长周期任务的不可控延迟与资损风险,支撑智能客服、代码生成

weixin_30681121的博客 393

用真实项目跑了一遍,Step 3.7 Flash 的表现有点意外

国产大模型近期密集发布多款新模型,包括Step 3.7 Flash、MiniMax M3、GLM-5.2和Kimi K2.7 Code等,各自聚焦不同方向:性价比、长上下文、开源和编程场景。当前大模型竞争已从单纯性能比拼转向Agent能力建设,注重高频使用场景的稳定性与性价比。文章重点测试了Step 3.7 Flash等"Flash档"模型在实际项目中的表现,通过代码生成、工具调用等任务对比发现,这类模型虽不追求极限性能,但在任务拆解、错误修复和结果整理等执行层表现出色。测试案例显示,Step 3.7 Fl

轻口味的专栏 2万+

Gemini 3.6 Flash与3.5 Flash-Lite:企业AI智能体成本优化实战

大语言模型作为人工智能的核心技术,通过深度学习架构实现对自然语言的理解与生成。其原理基于Transformer神经网络,通过预训练和微调获得通用语言能力。在工程实践中,企业关注如何平衡模型性能与推理成本,这正是AI智能体应用落地的关键挑战。Google最新发布的Gemini 3.6 Flash和3.5 Flash-Lite版本,针对企业级AI应用场景进行了专门优化。这两个模型在保持核心能力的同时,显著降低了API调用成本,为客服机器人、文档分析、知识库问答等智能体应用提供了更经济的解决方案。其中Gemini

weixin_33901926的博客 314

AI早报:Gemini 3.7 Flash价格减半与GPT-image 2.5灰度测试,开发者如何应对

在AI模型迭代加速的背景下,灰度测试已成为厂商控制发布风险的关键机制。新版本先经过小流量真实调用验证,再逐步放量,开发者通过观察模型ID变化即可判断版本是否处于实验阶段。与此同时,模型价格调整直接影响API调用成本,轻量级Flash系列降价后,使得全量日志分析、批量内容审核等原本受预算限制的场景成为可能。面对Gemini 3.7 Flash与GPT-image 2.5等动态,开发者需回归官方文档,以模型列表接口验证可用性,建立可量化、可回滚的接入流程。围绕灰度发布原理与价格变化影响,从概念到实践,提供一套从

weixin_30824479的博客 351

Gemini 3.7 Flash火速上线:开发者如何应对API价格战与接入难题?

大模型API调用已成为AI应用的基础组件,开发者如何平衡性能、成本与稳定性是关键。在众多模型层级中,Flash级轻量模型凭借更快的响应和更低的单次价格,成为高频、批量、成本敏感型请求的理想选择。然而,选择模型不能只看跑分和单价,还需结合任务难度、调用量与失败重试成本进行综合评估。当Gemini 3.7 Flash这类新品火速上线并引发API价格战时,开发者更需要冷静处理地区不可用、Chrome无入口、503与no available accounts等接入问题。从环境准备、最小请求验证,到错误分类与日志规范

weixin_34197488的博客 333

一顿饭钱用上Gemini 3.5 Flash:从API接入到VS Code深度集成

大语言模型正经历从‘问答系统’向‘可执行智能体’的关键演进,Gemini 3.5系列标志着Agentic能力的工程化落地。其核心价值不在于参数规模,而在于低延迟动作执行、高任务完成率与原生工具调用能力。依托Google Cloud Platform(GCP)的免费额度与弹性计费机制,开发者可稳定调用gemini-3.5-flash-latest模型,实现代码补全、文档解析、自动化报告等高频场景——无需破解、不依赖中转站,真正以低成本获得生产级AI工作流支持。本文聚焦实操路径,覆盖账户配置、API密钥安全管理

深未来技术 544

国内调用 Gemini 3.6 Flash 超时率高?TaoToken 通道下先对照价格、稳定性和模型一致性

context deadline exceeded 让 Gemini 3.6 Flash 夜间调用频繁超时,先别急换模型。在 TaoToken 创建 Key 后,用同一脚本跑短请求、长上下文、结构化输出各 50 次,记录成功率、P95、超时率和 429;再对照输入/输出缓存价格、模型一致性与高峰限流。若短请求正常而长上下文崩,先改参数;三组同时崩且集中在晚高峰,再考虑备用线路。Key 创建入口:https://taotoken.net/?utm_source=taotoken_aicg_blog_end。

weixin_42581003的博客 83

Gemini 3.7 Flash 接入实战:模型选型、成本控制与排错指南

大模型能力落地的关键往往不在于单次推理质量,而在于API接入的工程效率与调用成本。理解token计费原理是控制开销的基础,而模型选型是否合理则直接影响响应速度与账单结构。Flash这类轻量模型凭借低延迟和高性价比,正适合邮件分类、信息抽取、RAG摘要等高频场景。围绕这些需求,开发者需要掌握从环境准备、官方SDK调用到异常处理、成本优化的完整链路,还常常会面对503限流或配额不足等服务端报错。从Python调用、流式输出到带重试的生产型封装,一份可复用的接入方案能有效缩短开发周期,降低长期运维风险。本文结合G

weixin_33858336的博客 581

Gemini Flash更新:编程能力强化与API成本下降的工程应对

随着AI编程助手与自动化代码任务逐渐进入研发流程,开发者对云端大模型的选择已不再只关注生成代码的“惊艳度”,而是更看重调用成本、响应延迟与工程可接入性。理解模型分层的原理——旗舰模型擅长复杂推理但成本高,轻量Flash模型更适合高频、低延迟的大批量代码补全、测试生成与代码审查——是搭建高效AI编程工具链的基础。在此基础上,通过合理封装API调用、设计可量化的评测集与灰度切换策略,团队能够以更低成本验证模型能力,并规避单一模型依赖带来的排期风险。本文聚焦Gemini Flash的更新方向,从工程视角拆解编程能

weixin_34295316的博客 573

重新对比13款文本模型API价格:GPT-5.5、GPT-5.6、Claude、Gemini和DeepSeek谁更划算?

最近重新读取了一次 MaiziTech 的/v1/models接口。相比上一次记录,部分文本模型的价格已经发生变化,其中比较明显的是 GPT-5.6 Luna 和 GPT-5.6 Terra。两款模型调整价格后,目前都比 OpenAI 官方标准实时 API 价格低约20%。这次对比不讨论“哪个平台一定更好”,也不把低价直接等同于模型效果。需要说明的是,本次属于,没有进行相同提示词下的模型能力、响应速度、并发能力和稳定性测试。同名模型也不一定意味着上游线路、默认参数、限流规则和数据策略完全相同。

平原的博客 964

在LinuxMint 22.1(Ubuntu24.04)上安装使用同花顺远航版

Linux用户成功在LinuxMint22.1系统上通过Wine9.0运行同花顺远航版,解决了长期困扰的股票行情软件问题。此前Linux原生版同花顺功能简陋且停止更新,Wine版通达信存在显示问题。作者作为自由软件支持者,通过调整Wine配置文件解决了高分屏显示异常问题,实现了远航版的正常使用。期待同花顺能重启Linux原生版开发,支持更多处理器架构,完善国产软件生态。该方案为Linux股票软件用户提供了实用参考。

5151

2026 大模型 API 选型:价格、性能与性价比全面对比

当前大模型API市场高度分化,Claude Opus 4.7在复杂推理领先,GPT-5.5的Agent能力最强,DeepSeek V4性价比碾压,Qwen中文能力最佳。国内开发者建议主力使用DeepSeek、Qwen等国内模型,高质量任务通过国际访问使用海外模型,并充分利用缓存降低成本。没有单一模型全面碾压,组合使用是主流。

一点一木 1824

【SAP GUI 脚本 VBA】实战:构建Excel驱动的SAP自动化操作平台

本文详细介绍了如何利用VBA和SAP GUI脚本构建Excel驱动的SAP自动化操作平台,实现高频事务码的标准化封装和批量处理。通过实战案例展示物料主数据查询(MM03)、会计凭证修改(FB02)等场景的自动化实现,帮助用户提升10倍+操作效率,同时确保数据可追溯性和操作安全性。

weixin_33748818的博客 506

VQGAN实战:从文本到高清图像的保姆级生成教程(含PyTorch代码)

本文详细介绍了VQGAN(Vector Quantized Generative Adversarial Network)在文本到高清图像生成中的应用,提供了从环境配置到模型加载、文本编码及图像生成的完整PyTorch代码教程。通过实战案例和高级调优技巧,帮助开发者快速掌握VQGAN的核心技术,实现百万像素级的高清图像生成。

u8v9w0x1y的博客 649
上一篇: DeepSeek V4正式版发布,教你在Codex中配置Flash
下一篇: AI 工具选型:豆包、WorkBuddy、Codex 与 Hermes 实践
oken.ai
博客等级 码龄175天 0粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值