深入腾讯云TBDS: 湖仓架构下存储自动化治理实践

腾讯云大数据套件TBDS与阿里云大数据能力产品对比 通过建设数仓,以数据可视化和数据应用的方式赋能业务,TBDS - 数据仓库(简称 TCHouse)提供数据集成和开发处理,完成数仓分层建模,搭配海量数据查询引擎,提升数据查询性能,满足实时/在线数据分析的需要。DataWorks数据治理包含数据治理中心、数据质量、数据地图等多个产品,覆盖数据湖仓中事前、事中、事后的数据生命周期,通过数据治理健康分、质量规则、数据大血缘等能力,将书面的数据治理规范落地成平台化的产品能力,让数据治理不再只是一个 “阶段性项目”,而是一个“可持续的运营项目”。 阅读详情

ef576b57f96b3a2bf8694125c786d611.gif

1 、前言

2020年,Lakehouse 架构被首先提出,区别于传统数据仓库,Lakehouse 同时吸收了数据仓库和数据湖的优势,试图去融合数仓和数据湖这两者的优势,通过将数仓构建在数据湖上,使得存储变得更为廉价和弹性,同时 Lakehouse 能够有效地提升数据质量,减小数据冗余,使数据分析师和数据科学家可以在同一个存储中对数据进行操作,同时也能为数据平台进行数据治理带来更多的便利性。

TBDS 在过去几年很好的支撑了各行业客户业务在湖仓架构下的落地,在数据的时效性、数据审计、数据降冷、数据查询速度、数据存储查询成本等维度得到了全面的提升,然而随着用户对湖仓的使用场景越来越多样化和规模化,数据湖底层文件治理成本也随之增高,一方面是用户在湖仓架构上使用的便利与高效,另一方面是湖仓架构下万亿级文件治理带来的运维成本,目前业界在数据湖存储治理方面开源且易用的方案并不多,我们基于项目中的实战经验,分享腾讯云 TBDS 在湖仓存储自动化治理的解决方案,希望能对大家有所启发和帮助。

2、湖仓治理实践背景

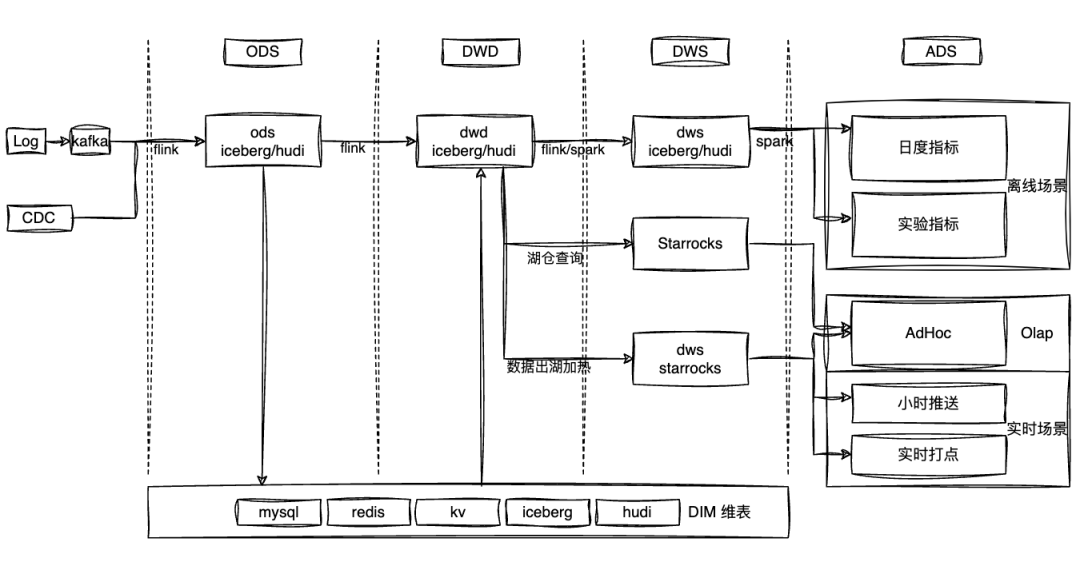
当前,数据驱动业务决策已经成为各行业客户业务发展的共识,尤其是在互联网、金融、新媒体等行业,数据新鲜度成为数据质量的重要衡量指标,越来越多的客户开始将数据链路从传统数仓T+1更新转化为更加实时的数据架构,这里我们从某头部金融客户的湖仓架构展开,其整体数据加工链路如下:
52483ecdee05d42a992873c4d1be933e.png

在客户的数据处理链路中,Iceberg / Hudi 作为统一湖格式支撑着整个数据链路中各个环节数据的入湖出湖,承担着重要的角色,取代了传统的 Hive 驱动着整个数据链路。

随着数据湖使用规模的扩大,客户在使用过程中也遇到了数据湖带来的多个问题,过多的小文件会给 Hadoop HDFS 的 NameNode 可用性上带来严重的问题,同时也会在计算引擎侧带来大量的 IO 和查询速度的降低,同时数据湖ACID 特性和高频入湖也会导致数据湖元数据的膨胀,以及数据湖下表的生命周期管理等问题,这些都会影响湖仓在客户侧的落地,因此数据湖存储优化模块是湖仓架构下必不可少的模块,也是湖仓生产落地过程中关键的部分。

基于客户在湖仓架构下的生产使用现状,秉承开源优先的原则,我们率先在 TBDS 中集成了开源数据湖优化组件 Amoro。得益于 TBDS 底座强大易用的 Open API,我们也在 Amoro 的集成上进行了开箱即用的增强来减少用户使用的成本,同时保证内核和社区对齐。与此同时为了将湖仓存储优化能力更好的落地客户生产业务,我们也对 Amoro 的内核进行了大量的功能性和易用的改造,该部分会在下个章节的 Luoshu 相关优化方案中展开。

3、新一代的数据湖存储治理解决方案

数据湖存储优化方案的一个核心在于:为上层用数应用提供一个合理的数据组织结构,为下层存储基座提供一个精简的数据存储结构,同时为运维人员提供一个功能完备的数据管理系统。这一切都是为来简化 Lakehouse 架构在落地过程中开发和运维的复杂性,提供一个统一的数据处理层,同时支持离线批量处理和实时增量处理,满足用户对数据一致性的要求。

3.1 传统业务实践痛点

● 学习门槛高

在客户的生产环境中,我们发现传统的开源数据湖存储优化方案在客户侧能很好的解决不同时效性的表的存储优化,特别是在小文件治理方面表现出色,同时能很好的进行优化资源的配置和隔离,但是实现这一过程需要对组件内核和运行机制比较熟悉,同时由于传统的开源方案内部引入了“资源组”等领域概念,并且内部优化资源服务于该资源组下面的所有表,在优化过程中需要用户控制每个表的资源使用配额,包对资源组资源实例的调整等。

因此,数据湖存储优化方案中,在提供功能强大的优化能力的同时,客户对于优化系统的易用性和高效的运维也存在比较迫切的需求。

● 资源运维成本高

传统的开源方案内部主要使用 Spark ,  Flink任务来作为优化资源重写数据湖表来达到对表进行优化的目的,通常情况下用户在为表配合好逻辑优化资源队列后,用户需要从业务角度出发为该优化队列配置足够的资源,同时确保队列下的计算资源稳定运行来确保业务表的优化正常稳定执行,但是由于缺少优化资源队列下表的统计信息无法对计算资源进行正确的评估,以及生产环境中优化任务的稳定性问题,通常保证队列下表优化的正常需要比较高的运维成本,难以达到理想的优化状态。

因此,业界对一个能够在统一解决数据湖存储优化的同时降低运营维护成本的数据湖优化解决方案的需求日益迫切,在这种方案架构下,用户可以上层无感的进行使用,同时底层优化组件具备良好的自适应优化和完备的资源自愈能力来满足用户落地数据湖过程中对高效运营的需求。

3.2 湖仓治理定位及特性分析

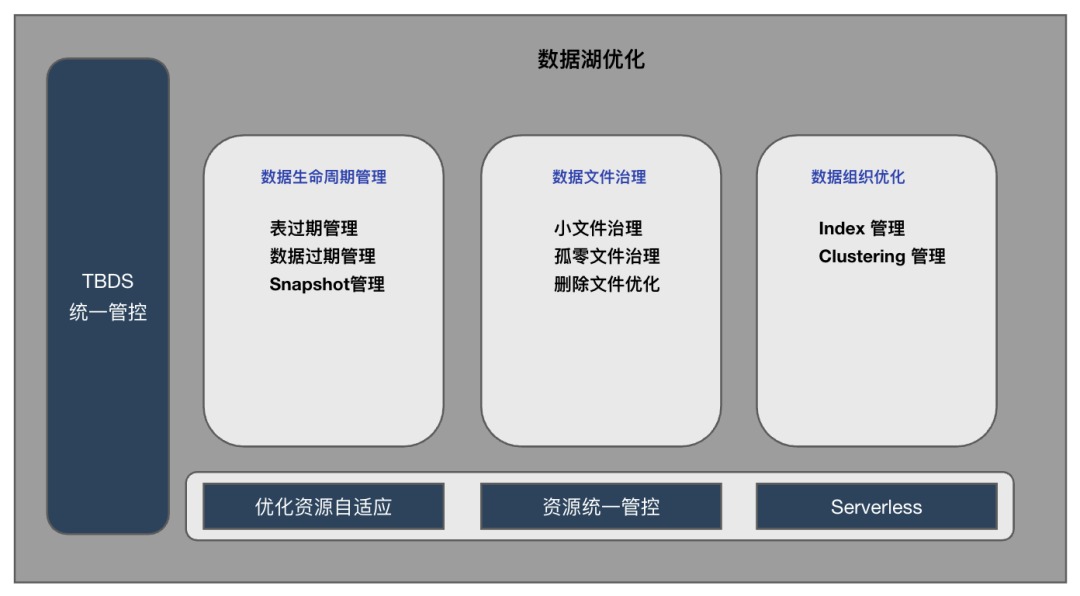
构建一个具备对数据湖文件中数据生命周期管理,数据文件治理,数据组织优化的核心功能外,我们也需要在整体的数据湖优化过程中具备对系统资源的整体管控,以及底层的优化资源管控,和底层优化资源的自适应运维能力,来帮助用户尽可能地降低在使用过程中的运维成本。
f1b6db6da55a6c47fbebd237901a4ef9.png

3.3 湖仓治理核心优化方向

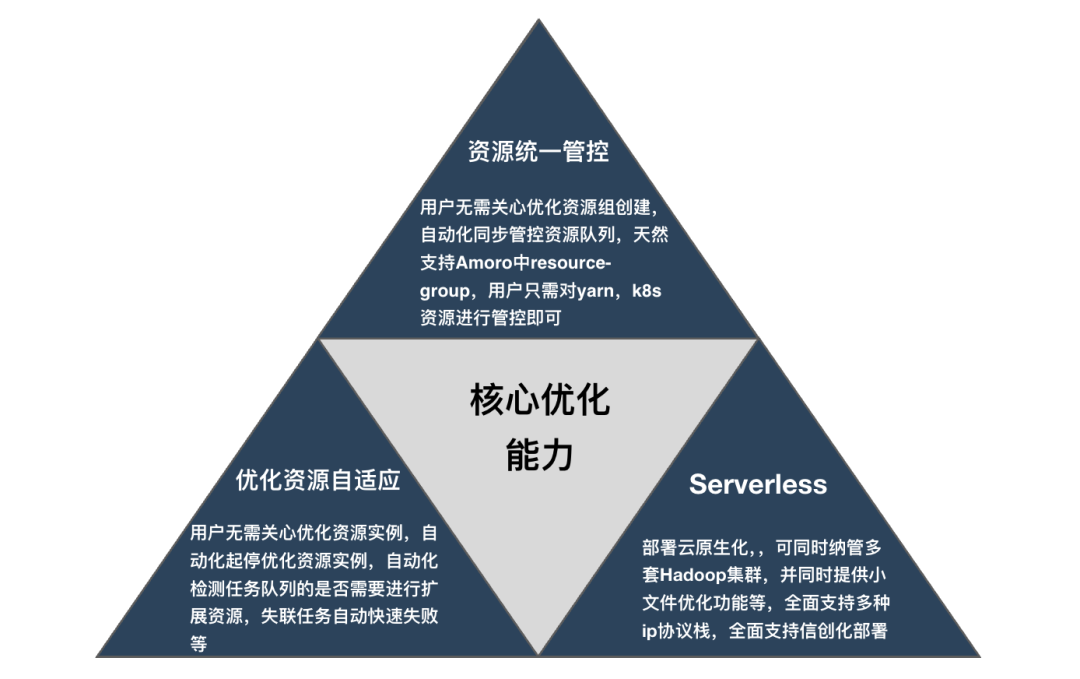
从用户使用角度出发,我们除了需要为用户提供完善的数据湖核心优化能力之外,我们重点完善了整个方案中的运维成本较高的模块,包括进行了Serverless化部署适配,同时将逻辑资源优化组直接对接系统的资源管理模块,自动化同步优化资源组模块,对于用户在使用中复杂程度较高的优化资源实例扩展,我们实现了根据用户配置规则进行自动化拉起释放机制,让用户摆脱了使用中的需要人工介入运维的过程。
683e4c54092485798124dce51934af1d.png

基于腾讯云TBDS 在客户侧丰富的实践经验,我们开始在 Amoro 的基础上通过改造,赋能 TBDS 上一个功能全面易用的数据湖优化组件,简单描述我们的预期为:

用户只需要在工作台编辑配置表的属性配置,即可无感将该表托管给 TBDS 的数据管理优化系统,TBDS 会根据预置策略全自动的托管该表的生命周期管理和优化。

3.4 新架构服务Luoshu的核心能力

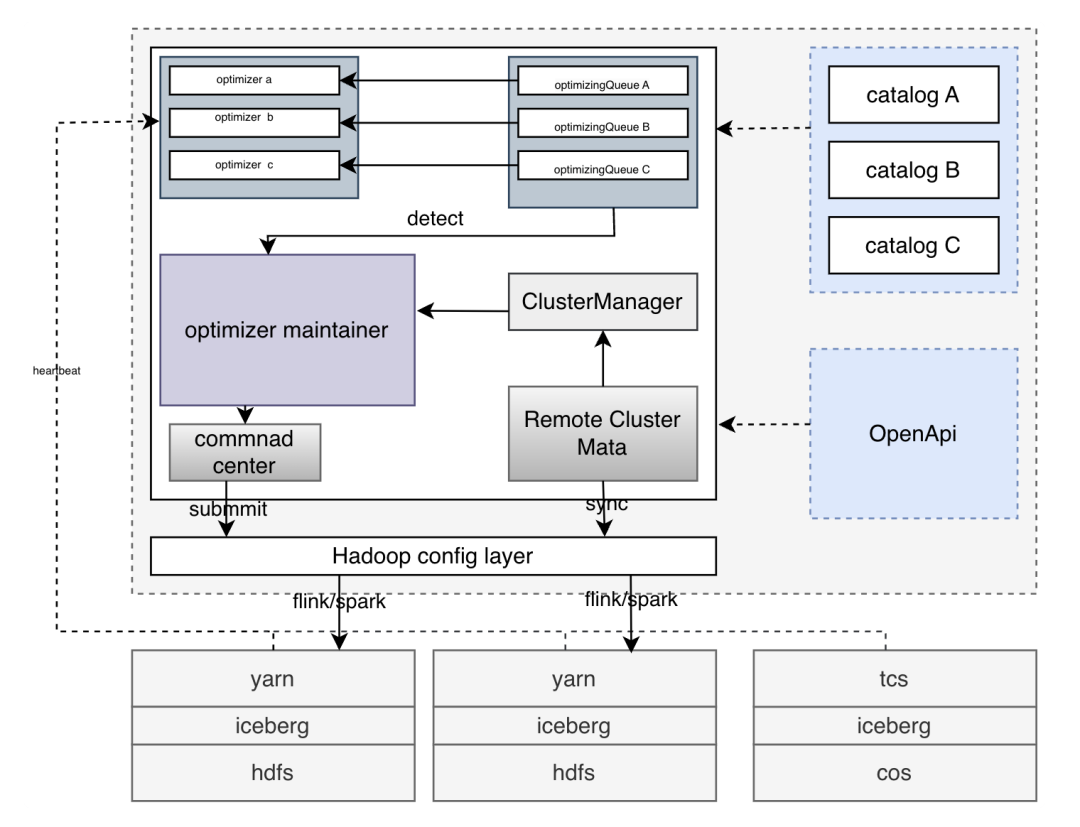
下面是TBDS增强版数据湖优化管理服务Luoshu的整体架构,包含OptimizerMaintainer, ClusterManager, CommandCenter等核心新增模块:
e3221cfa1349d554325836bf113a50ac.png

由于自动化数据优化核心在于表的生命周期全优化托管,用户只需关心业务相关语义,无需关心优化组和优化器具体的生命周期,因此,为了实现整个流程表优化的自动化我们主要改造点为:

● Serverless化。由于该组件服务于管控下的所有 Hadoop集群,因此需要进行 Serverless 化来支持后期性能扩展,同时配合 TBDS 管控来实现 Hadoop集群生命周期初始化过程中自动化的将 Catalog 相关信息注册到 Luoshu,实现为多集群提供存储优化服务。

● 资源统一管控。TBDS管控下所有用户的资源队列信息自动化同步到 Luoshu 中为用户提供统一资源组视图,对齐用户在传统 Hadoop/K8s 下的使用方式,同时支持优化任务多集群提交,需要针对不同集群的湖文件,在进行优化时将优化资源提交到指定的计算集群,实现 Luoshu 的资源管控与传统大数据使用同一套资源管控

● 优化资源自适应。Luoshu 自动感知优化队列是否有表需要优化,并根据用户的资源模版自动拉起优化任务,并在没有表需要优化时主动释放资源

3.4.1 Serverless化部署

不同于社区的云原生方案,TBDS版本中我们进行进行了定制化的落地改造,主要基于以下出发点:

● TBDS目前提供面向云原生的计算集群,但是考虑到大量的客户主要计算资源依旧为yarn, 所以云原生场景下依旧需要完整的支持 Yarn 作为主要的计算资源。

● 由于 TBDS 全栈支持 IPv4/IPv6 协议,在云原生场景下涉及多个外部接口, 我们需要通过 TBDS 管控平台获取该 Pod 的专有 IPv4与IPv6 地址。

● TBDS 可以同时纳管多套 Hadoop集群以及上面的计算引擎,同时各个集群自由支持 IPv4, IPv6, 双栈等网络协议栈,TBDS需要根据不同的 Hadoop集群协议栈使用不同的通信协议。

● 为提升优化任务性能,我们也将 TBDS 内部优化版本  Flink, Spark进行预置。

同时 TBDS 目前提供了完备的 Open API ,TBDS管控侧的监听机制可以在 Hadoop 集群创建的初期自动化的将以上所有的配置文件自动化的注册到 Luoshu 组件上,实现 Catalog 的自动化接入注册,实现 Hadoop 创建过程中及联化接入。

3.4.2 资源统一管控

通常情况下,对于开源数据湖存储优化组件,用户需要配置优化队列,并在后期拉起优化器过程中使用该优化队列来聚合优化资源,提供统一的资源视图,但是实际使用过程中我们也发现部分问题:

● 该优化资源队列不同于 yarn 或 k8s 队列,为内部领域概念,在用户使用过程中增加了理解成本

● 对于优化资源队列的创建需要单独进行规划设计,增加了额外的成本,在多集群的架构下运维变得困难

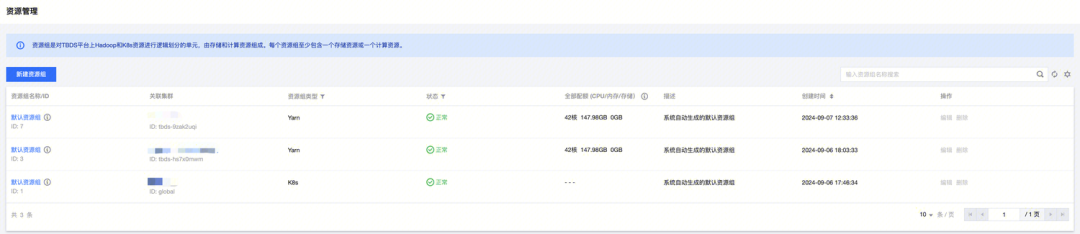
TBDS 提供了统一的资源管理模块,我们希望将优化队列概念对齐统一资源视图中资源队列的概念,减少用户使用时的学习使用成本。因此我们也自动化的将 TBDS 的资源相关信息自动化的同步到了 Luoshu侧。同时为了进行不同集群的资源隔离,我们在 Luoshu 的优化组侧对资源相关信息进行重新格式化为 queue@cluster-id 的形式,用于在后期进行调起任务的过程中去解析集群与资源组的信息。
bd638668d356ad81614079da2789ae6a.png

TBDS 统一资源管理视图

0f24725e4e98e780b0f0ecfe911174c8.png

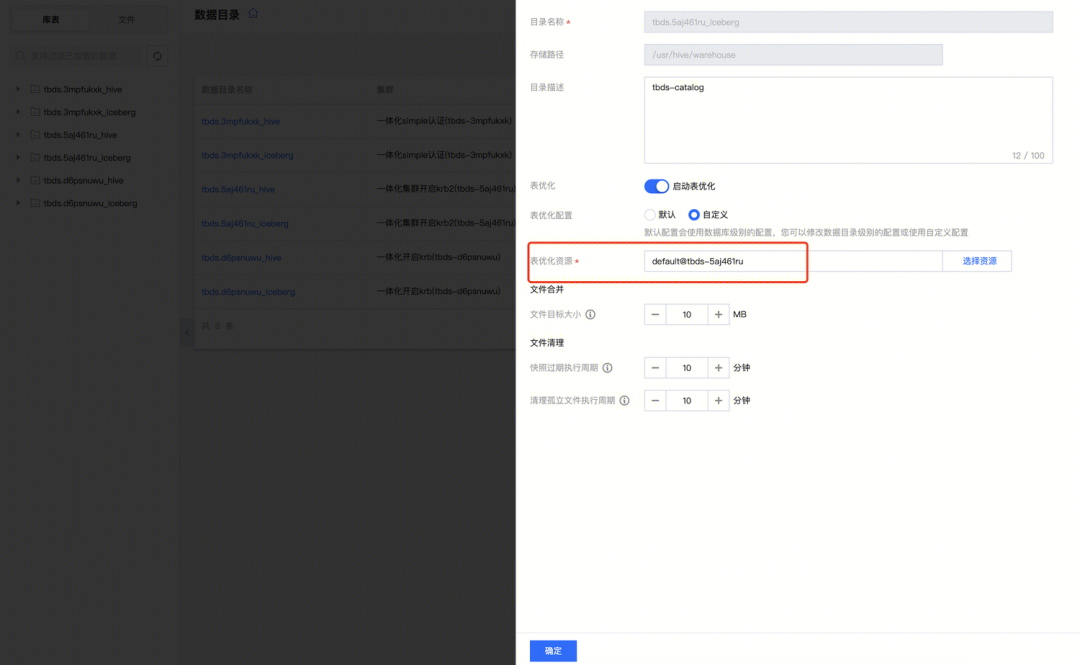
TBDS 统一资源管理编辑界面

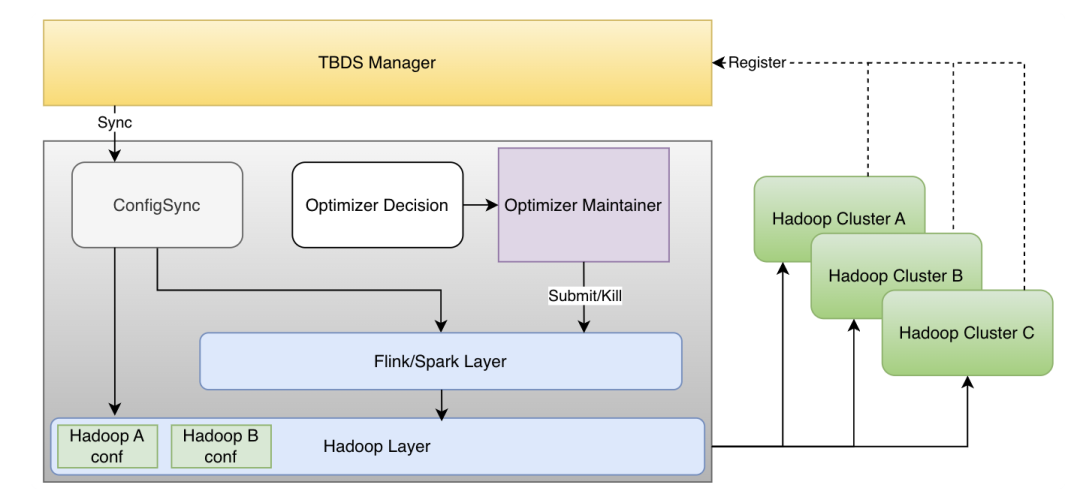
由于在实际客户使用场景中,大数据的集群计算资源主要以 Yarn 资源为主,同时从客户使用稳定性角度出发,我们优先支持了 Yarn 资源来进行优化,但同时也面临一个问题,在一个 Pod 中如何根据指定的优化器启动命令完成向不同的集群提交优化任务,同时保证该任务可以正常的优化并和传统Hadoop 的 AZ部署时具备相同的优化性能。为此我们对接 TBDS OpenAPI 实现了在单一POD 可以根据指定资源组自动化的将优化任务提交到指定的 Yarn 集群中,具体多集群远程提交示意图如下:
866515a3d6f3cca07f22c712564526c2.png

其中主要需要实现了以下几个关键功能:

● 自动化感知纳管集群配置信息并同步至 POD 中。

● 支持异构网络协议栈下提交 Flink/Spark 优化任务。

● 支持自动化识别生成优化器提交命令上下文并提交至远程指定 Yarn 集群中。

通过以上的改造我们可用将用户指定优化队列下的优化任务提交到指定的远程 Yarn 集群,同时保证优化任务可以正确的建立心跳以及后续优化任务拉取等流程。实现湖文件优化的计算本地化。

3.4.3 优化资源自适应

传统的对数据湖表进行优化需要用户手动拉起优化计算资源,并在表无需优化时进行手动释放,在实际的业务使用中,用户需要频繁的进行运维操作,同时优化任务失败时无法及时感知拉起会导致整个湖表的优化状态不符合预期,为此我们在 Luoshu 上实现了优化任务的自动拉起释放机制来确保用户无需人工介入,全流程自动化感知操作。

● 优化任务自适应拉起

通常情况下用户需要在指定的优化队列下手动拉起指定的优化任务,并在后续根据优化时根据具体情况手动 Kill 掉优化任务来释放资源等,为了减少用户的使用成本,我们也将该过程进行自动化。由于在 Luoshu 内部,表的优化信息通常会聚合在指定的优化队列下,同时保持连接的优化器也会聚合在指定的优化队列下,我们通过检测各个优化队列下的表信息以及优化器信息来决定是否需要进行拉起优化器。

● 优化任务自适应释放

优化任务自动释放,主要在两个场景下需要处理:

1. 优化任务与 Luoshu 由于网络隔离导致失联,同时 Luoshu 的自动拉起优化器逻辑无法感知网络隔离会导致频繁拉起,该场景下需要使断联的优化器主动自杀来避免耗尽所有机器队列资源。

2. 优化任务在指定队列无优化表的情况下默认会持续持有资源等待新的优化任务生成,该场景下存在一定情况下的资源浪费,该情况下进行优化任务的主动释放时必要的,我们也在该场景下实现了优化任务的主动释放,其中部分代码逻辑如下:

//主动释放资源异常类型
public static final int PLUGIN_STOP_ERROR_CODE = 2007;
public class LuoshuStopException extends LuoshuRuntimeException {
  public LuoshuStopException(String message) {
    super(message);
  }
}
//在Luoshu指定优化队列无表需要进行优化的情况下进行资源释放
@Override
public void touch(String authToken) {
    if (schedulingPolicy.isEmpty()) {
      throw new LuoshuStopException(
          "SchedulingPolicy is empty, will indicate the optimizer should be stopped");
    }
    OptimizerInstance optimizer = getAuthenticatedOptimizer(authToken).touch();
    LOG.debug("Optimizer {} touch time: {}", optimizer.getToken(), optimizer.getTouchTime());
    doAs(OptimizerMapper.class, mapper -> mapper.updateTouchTime(optimizer.getToken()));
}  
//在网络断联情况下对于连接失败指定次数后进行主动释放资源  
private boolean shouldStop(Throwable t) {
    String tName = t.getClass().getName();
    if (t instanceof ConnectionFailException) {
      if (throwableMeta.getOrDefault(tName, 0) >= CONNECTION_FAIL_TIMES) {
        return true;
      }
      throwableMeta.put(tName, throwableMeta.getOrDefault(tName, 0) + 1);
    }
    // Call Luoshu again when got an unexpected error
    return false;
}

4、总结与展望

4.1 业务使用效果

目前我们已经在腾讯云TBDS 上线自动化数据湖优化组件 Luoshu,用户只需为指定表配置使用的资源队列,即可将该表全托管给 TBDS 优化,为用户提供更加易用的数据湖优化体验,减少用户数据湖落地过程中使用运维成本。如下图所示,用户只需为表配置优化资源队列既可托管该表,由 Luoshu 负责该表的优化以及生命周期管理。
a46d1672ca94ed10aa816e5eb742240f.png

性能层面,目前在客户的使用场景中,使用 Luoshu 单实例治理的 Iceberg 表数量稳定在 1W 左右,Iceberg 单表存储最大 50G 左右,单表文件数最大多达17W,可确保整个数据湖使用达到平稳状态,同时使用 Luoshu 进行自动化治理后,上层计算引擎在计算阶段平均节省资源 15% 左右,大大减少了因为小文件过多导致的计算查询无法完成的异常情况。

使用体验层面,使用 Luoshu 作为公共数据湖优化组件,可以为同时为多套 Hadoop 集群上湖仓数据提供优化服务,用户在使用过程中也无需进行除了表配置外的其他操作,即可无感知的对表进行优化,无需在进行专职运维人员进行运维操作,极大的优化了业务开发人员的使用体验。

4.2 未来优化方向

在后续 Luoshu 的演进方向上,我们结合客户的使用场景也会继续进行一系列功能的增强和性能的优化,主要包括:

● 优化资源方面将自动化根据线上表优化任务执行统计信息自动化扩缩容优化资源。

● 优化计划生成方面将自动化识别巨量表,自动拉起单实例优化任务,来减小对其他表优化的影响。

● 功能层面将会结合 TBDS 统一元数据服务将 Index, Clustering 等功能集成进入 Luoshu 实现湖仓智能加速,进一步提升上层计算引擎的查询速度。

后续我们也将继续加强 TBDS Luoshu 在数据湖治理方面的能力,同时也将积极将这些功能回馈社区,继续推进湖仓一体架构在更多的客户业务中落地。

腾讯云大数据始终致力于为各行业客户提供轻快、易用,智能的大数据平台。

关注腾讯云大数据公众号

邀您探索数据的无限可能
cf2295baa85e3df4a37f87e1a8146aba.png

点击阅读原文,了解更多相关产品详情

↓↓↓

大数据领域数据仓库的数据治理实践 数据治理是大数据时代企业数据管理的核心环节。随着数据量的爆炸式增长和数据应用的多样化,企业面临着数据质量低下、数据标准不统一、数据安全风险等诸多挑战。本文旨在系统性地介绍数据仓库环境下的数据治理实践,涵盖从理论到实施的全过程。数据治理的基本概念和框架数据治理的关键技术和工具数据治理的实施方法论典型行业应用案例未来发展趋势本文采用理论结合实践的结构,首先介绍数据治理的基本概念,然后深入探讨各项关键技术,接着通过实际案例展示实施过程,最后展望未来趋势。背景介绍:阐述数据治理的背景和重要性。 阅读详情

相关推荐

保姆级教程:Synology NAS共享文件夹从创建到权限设置的完整流程

本文提供了一份详尽的Synology NAS共享文件夹创建与权限设置指南。重点讲解了如何将NAS接入企业AD域,并利用域管理员账户进行集中身份验证和权限管理。文章从基础概念、域环境配置、文件夹创建、精细化权限分配到客户端访问与维护,完整覆盖了构建安全高效企业级文件共享空间的全流程,旨在帮助管理员实现便捷的团队协作与数据安全管理。

u9v0w的博客 559

腾讯--TBDS大数据集群迁移实践总结

背景 xx公司属于最早一批使用TBDS(腾讯大数据处理平台)产品的老客户,从2016年开始将业务运行在TBDS。目前客户使用的是早期TBDS版本,与最新release版本在系统总体架构、组件版本等方面相差过大。因为客户需求越来越多,现在使用的老版本大数据集群因为功能较少,导致部分需求无法满足客户新增需求。由于历史遗留原因,老版本升级到新版本代价较高。考虑到客户的大数据集群规模不是很大(TB数据量...

yangbosos的博客 1万+

Python实战:5分钟搞定N-CMAPSS航空发动机数据集解析(附完整代码)

本文提供了一份针对N-CMAPSS航空发动机数据集的快速解析实战指南。通过Python的h5py和Pandas库,详细演示了如何高效读取HDF5格式文件、理解数据结构、提取关键特征(如传感器数据与剩余使用寿命RUL),并整合为可用于预测性维护分析的DataFrame,帮助研究者和工程师快速上手这一重要的工业时序数据集。

weixin_29083373的博客 281

Tencent : TBDS

腾讯大数据处理套件(Tencent Big Data Suite,TBDS)是基于腾讯多年海量数据处理经验,对外提供的可靠、安全、易用的大数据处理平台。您可以借助 TBDS 在公有云、私有云、非云化环境,根据不同数据处理需求选择合适的大数据分析引擎和相应的实时数据开发、离线数据开发以及算法开发服务,来构建您的数据仓库、用户画像、精准推荐、风险管控等大数据应用服务。

难得糊涂 1927

SAP PP模块 MRP配置实战:5步完成工厂级物料需求计划激活

本文详细介绍了SAP PP模块中物料需求计划(MRP)的工厂级配置实战,通过5个关键步骤从基础环境准备到最终激活。内容涵盖SPRO后台配置、MRP控制者定义、主数据设置及核心参数调整,帮助顾问快速掌握MRP配置清单的完整流程,确保物料需求计划的高效运行。

weixin_30431445的博客 346

HOPE:基于强化学习的混合策略路径规划器,适用于多样化停车场景

本文提出了一种混合策略路径规划器(HOPE),用于解决自动停车中的路径规划问题。HOPE结合了强化学习(RL)和Reeds-Shepp(RS)曲线,通过动作掩码机制引导RL智能体的探索,并利用Transformer融合环境感知信息与掩码。该方法在多样且复杂的停车场景中实现了超过97%的成功率,并通过真实实验验证了其泛化能力。此外,本文还提出了基于空间与障碍物分布的停车场景难度分级标准,进一步提升了训练与评估的效率。实验结果表明,HOPE在规划成功率和跨场景泛化能力上均优于传统的基于规则算法和朴素强化学习方法

weixin_42783201的博客 1466

Tencent : TBDS简介

TBDS可以在公有云、私有云、非云化环境中,根据不同数据处理需求组合合适的存算分析组件,如Hive、Spark、HBase、Flink、Presto、Iceberg、Elasticsearch、StarRocks等,以快速构建企业级数据湖仓。综上所述,Tencent TBDS是一个功能强大、安全可靠、易用灵活的大数据处理套件,可以帮助企业高效地处理和分析海量数据,提升业务效率和决策水平。:支持多种计算引擎,包括Hadoop、Spark和Flink等,用户可以根据实际需求选择最适合的引擎进行数据处理和分析。

IT深耕十余载,大道之简 2420

【信创-k8s】银河麒麟V10国防版+鲲鹏/飞腾(arm64架构)在线/离线部署k8s1.30+kubesphere

银河麒麟作为国家核高基专项的重要成果,国防版凭借其卓越的安全性和可靠性,已成为军工领域的首选操作系统。之前我们在适配麒麟V4国防版的过程中已发现诸多安全性要求,而麒麟V10国防版在安全防护等级上又达到了更高的级别。本文将主要演示离线部署,因为军工项目基本不会出现联网场景。即使在线,也可以按离线方式部署,且离线部署由于有私有仓库,不会存在镜像获取不到和丢失情况。

jiaworld的博客 730

腾讯云大数据TBDS 助力国有大行一表通业务性能翻三倍!

背景介绍1.腾讯云 TBDS大数据平台介绍腾讯云 TBDS 是腾讯经过多年的大数据实践,面向数据全生命周期,对外提供安全、可靠、易用的一站式、高性能、企业级大数据存储计算分析平台,腾讯云TBDS 已落地金融、政务、能源、工业等多个行业,交付了 1000+ 的私有云大数据项目,腾讯云TBDS 从 2017 年开始支持某国有大行的大数据平台建设,在大规模集群支持、核心业务性能优化、金融级数据安全、...

cloudbigdata的博客 751

【Qt】QByteArray详解

对象共享同一份数据,直到修改时才进行深拷贝,以节省内存和计算资源。:可存储任意二进制数据(如图片、音频、协议数据),不依赖字符编码。与编码(如 UTF-8、Latin-1)之间的桥梁(例如。• 补零规则确保奇数字符串能正确解析,避免数据截断。:内部自动分配和释放内存,无需手动管理。将输入的字符串视为十六进制编码数据,返回实际数据长度(不包括结尾的。的输入必须是有效的十六进制字符(,但针对 Qt 框架做了优化。:处理加密后的二进制结果(如。• 如果输入字符串长度为奇数,• 若输入长度为奇数,自动在。

CSUC的博客 1599

LPDDR6 技术标准详解(JESD209-6)

是继 LPDDR5/5X 之后的新一代低功耗 DRAM 标准,专为满足移动终端、AI、边缘计算等高带宽、低功耗场景而设计。该标准通过全新架构、动态功耗控制机制和增强型数据完整性机制,实现性能、能效与可靠性的全面升级。LPDDR6 并非仅是速度升级,更是内存架构设计思路的演进,围绕“低功耗 + 高带宽 + 强安全”的三维目标,构建下一代 SoC 平台关键基础。✅ 高带宽:支持 32B/64B 动态突发✅ 低功耗:动态电压、通道切换✅ 高可靠性:ECC + 自测试 + 安全区。

weixin_43199439的博客 2593

【面试】数据平台产品经理面试知识点总结

距离上次写作已经过去3年,还是要保持写作的习惯。本人从事金融科技行业,有4年左右的数据平台产品经理经验,25年3月起陆续面试了几家公司,写一下面试总结及知识点。建发 厦门安踏 厦门平安银行 深圳招商银行 深圳MarkdownText-to-HTMLAuthorsJohnLuke。

Mr_charm的博客 1522

嵌入式系统开发笔记112:通过有人云测试MQTT

项目中使用到“有人”公司的WH-LTE-7S0模块,本文讲解通过有人云进行MQTT测试的方法。

snmplink的博客 999

深入腾讯云TBDS:大规模HDFS集群优化实战

HDFS在腾讯微信、腾讯广告、腾讯金融等产品和业务领域有着广泛应用,节点规模可达10万级、存储规模达EB级,在应用实践中做了针对性的改善。腾讯云TBDS是腾讯大数据能力的私有云产品化,结合内部实践和典型客户的具体情况,对HDFS做了系统的优化。

cloudbigdata的博客 925

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

腾讯云大数据平台 TBDS全面升级,加速构建安全可控的大数据生态

8月22日,腾讯云大数据首届“智理无数,心中有数”伙伴交流会在深圳滨海大厦举办。本次会议主要围绕腾讯云大数据平台TBDS产品的全新升级,以及在渠道伙伴中的推广策略及应用实践展开。华云、国双、北明、东华、东方金信、国泰新点、久远银海等数十家核心合作伙伴相关负责人出席本次峰会。腾讯云副总裁王峰对各位伙伴的到来表示热烈的欢迎,并表示将继续推进各伙伴与腾讯云大数据融合应用,培育发展大数据产业聚集高地。“腾...

cloudbigdata的博客 1303

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

从数据湖到元数据湖——TBDS新一代元数据湖管理

腾讯大数据TBDS 8月重磅推出了的新一代元数据湖管理系统,提供面向大数据湖仓分析、AI智能的统一元数据管理和治理。翻译一下就是:元数据管理的边界,我们给扩展以及统一了!01元数据管理发展阶段大数据发展多年以来,在元数据上整体可以分成三个阶段。第一阶段是以Hive Metastore为代表的元数据服务,主要提供存储和访问Hive库表等的元数据信息,是首个Hadoop开源的元数据管理服务,几乎成了事...

cloudbigdata的博客 898

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

腾讯云TBDS获金融信创实验室全项适配认证 打造国产化大数据平台标杆

点击蓝字⬆ 关注我们本文共计1605字 预计阅读时长5分钟近日,腾讯云大数据套件软件TBDS V5.3、数据仓库TCHouse V3.0通过金融信创生态实验室(以下简称“实验室”)的适配验证。本测试基于典型金融业务场景,在全信创环境下,从产品功能、性能、兼容性、可靠性、业务场景等全方面进行了适配验证,取得100%通过,这意味着腾讯云TBDS打造的企业级大数据平台完全满足金融业务系统所需。金融信创生...

cloudbigdata的博客 1303

腾讯云TBDS:新一代数据湖仓实践,助力企业数据架构升级

导读本次分享主题为 TBDS 新一代数据湖仓助力企业数据架构升级。文中将介绍 TBDS 新一代数据湖仓产品的能力升级,以及 TBDS 新一代产品在企业数据架构实时化、云原生化升级中的实践。主要包括以下几大部分:1.TBDS 新一代数据湖仓架构2.全新架构 全新体验3.环境全面适配4.企业数据架构升级实践案例01TBDS新一代数据湖仓架构腾讯云大数据 TBDS 是一款依托腾讯多年海量数据...

cloudbigdata的博客 665

腾讯云TBDS面向AI时代的多模态智算平台,助力企业AI转型

腾讯云TBDS多模态数据智算平台通过Ray统一计算底座 + 自研Xpark/HyperFrame引擎 + TBDSFS统一存储的三层架构,系统性解决了企业在AI基础设施层面面临的异构算力管理、多模态数据处理、训练推理割裂等核心难题。

cloudbigdata的博客 489

腾讯云TBDS在海量Iceberg的治理之路

Iceberg表写入是动态的,不同表之间数据写入量,更新量,小文件的产生频率等都有很大的差别,这也就表明了需要处理的优化任务具有较大差异,也即不同的任务需要的资源需求不同,如果资源配置不合理则比较容易出现任务因资源不足导致OOM的情况,如果靠人工运维配置则需要非常大的人工运维压力并且使用复杂度高,因此需要一个自适应的资源使用方案,来简化LakeKeeper的使用门槛和降低人工运维的投入度。这些问题不仅影响查询性能,还增加了存储成本和运维复杂度,为Iceberg的治理也带来了比较大的使用成本。

cloudbigdata的博客 861

腾讯TBDS和Cloud Data AI CMP 比较的缺陷在哪里?

腾讯云TBDS与Cloudera CMP在大数据平台选型中存在明显差异:TBDS优势在于深度国产化支持(信创适配、等保合规)、AI原生能力及低成本模型,特别适合国内金融政务场景;而CMP强项在于全球合规认证、Impala的OLAP性能及多云统一管理能力,更适合跨国企业。主要缺陷对比:TBDS存在生态封闭(绑定腾讯云)、跨云能力弱的问题;CMP则面临在华落地困难、许可成本高昂(约5千美元/核/年)及缺乏国产化支持的短板。企业选型需重点考虑业务地域性、合规要求及现有技术栈。

yumgpkpm的专栏 1163

腾讯大数据环境(tbds)对接问题处理日志

tbds对接若干问题日志和处理方法

flyinf_guo的专栏 2142

湖仓一体(Lakehouse)架构的核心组件之存储层——Lakehouse 架构(三)

存储层是任何数据平台的核心,在基于lakehouse架构的平台中,它对于高效持久化各类数据、提高查询引擎的性能发挥着重要作用。 Lakehouse存储层由云存储、文件格式和表格式组成。 本文将说明与 Lakehouse 存储相关的基本概念、行式存储和列式存储之间的区别,以及存储格式是如何与性能密切相关的。 然后,将深入探讨用于数据分析场景的存储格式、使用每种格式的好处以及构建数据平台时应考虑的关键功能。 了解了上边的概念后将讨论湖仓一体中的开放表格式,包括其功能和优点,以及在使用的时候需要注意的地方。

奔跑的蜗牛的博客 2438

从“严格模式”到金融级合规:TBDS信创数据库适配实战录

因此,当面临信创数据库的适配需求时,团队的工作不是颠覆性的重构,而是在一个业已经过验证的成熟框架下,为这个新的数据库“方言”开发一个对应的“驱动”或“适配器”。这对客户的长期战略意义是深远的:他们不再被任何单一的数据库供应商锁定,未来无论是需要适配另一款信创产品、拥抱一个新的开源标准,还是迁移到更具成本效益的云数据库,都能够以最小的代价和业务中断风险来完成。因此,无主键表的存在是常态,而非例外。从满足“合规”的抽象概念,到交付可验证的工程杰作,其间的鸿沟需要用一行行坚实的代码和一层层精巧的设计来填补。

cloudbigdata的博客 1097

腾讯TEG首次集体亮相腾讯全球数字生态大会,这些亮点不容错过!

5月21日—23日,腾讯全球数字生态大会将在昆明滇池国际会展中心召开。大会是将腾讯过往的三大峰会“腾讯全球合作伙伴大会”、“腾讯云+未来峰会”和“互联网+数字经济峰会”进...

腾讯技术工程 5484
上一篇: 即将召开 | 大模型时代数据开发实践分享沙龙
下一篇: 国内首个!腾讯云WeData通过中国信通院大模型驱动的智能数据开发平台专项测试...
腾讯云大数据
博客等级 码龄6年 348粉丝 219原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值