


利用JAVA向Mysql插入一亿数量级数据—效率测评
这几天研究mysql优化中查询效率时,发现测试的数据太少(10万级别),利用 EXPLAIN 比较不同的 SQL 语句,不能够得到比较有效的测评数据,大多模棱两可,不敢通过这些数据下定论。
所以通过随机生成人的姓名、年龄、性别、电话、email、地址 ,向mysql数据库大量插入数据,便于用大量的数据测试 SQL 语句优化效率。、在生成过程中发现使用不同的方法,效率天差万别。
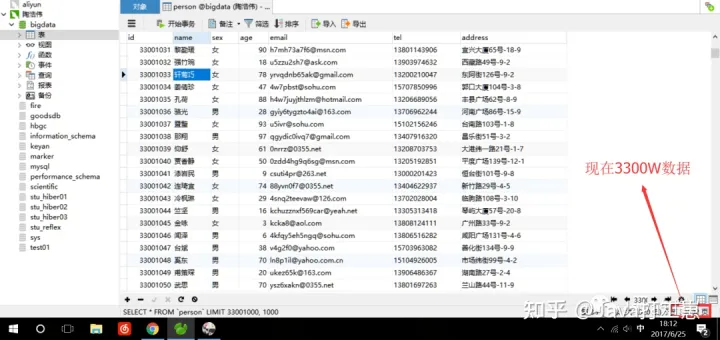
1、先上Mysql数据库,随机生成的人员数据图。分别是ID、姓名、性别、年龄、Email、电话、住址。
下图一共三千三百万数据:

在数据量在亿级别时,别点下面按钮,会导致Navicat持续加载这亿级别的数据,导致电脑死机。~觉着自己电脑配置不错的可以去试试,可能会有惊喜

2、本次测评一共通过三种策略,五种情况,进行大批量数据插入测试
策略分别是:
- Mybatis 轻量级框架插入(无事务)
- 采用JDBC直接处理(开启事务、无事务)
- 采用JDBC批处理(开启事务、无事务)
测试结果:
Mybatis轻量级插入 -> JDBC直接处理 -> JDBC 批处理。
JDBC 批处理,效率最高
第一种策略测试:
2.1 Mybatis 轻量级框架插入(无事务)
Mybatis是一个轻量级框架,它比hibernate轻便、效率高。
但是处理大批量的数据插入操作时,需要过程中实现一个ORM的转换,本次测试存在实例,以及未开启事务,导致mybatis效率很一般。
这里实验内容是:
- 利用Spring框架生成mapper实例、创建人物实例对象
- 循环更改该实例对象属性、并插入。
//代码内无事务

 private long begin = 33112001;//起始id
    private long end = begin+100000;//每次循环插入的数据量
    private String url = "jdbc:mysql://localhost:3306/bigdata?useServerPrepStmts=false&rewriteBatchedStatements=true&useUnicode=true&characterEncoding=UTF-8";
    private String user = "root";
    private String password = "0203";


@org.junit.Test
    public void insertBigData2()
    {
        //加载Spring,以及得到PersonMapper实例对象。这里创建的时间并不对最后结果产生很大的影响
        ApplicationContext context = new ClassPathXmlApplicationContext("applicationContext.xml");
        PersonMapper pMapper = (PersonMapper) context.getBean("personMapper");
        //创建一个人实例
        Person person = new Person();
        //计开始时间
        long bTime = System.currentTimeMillis();
        //开始循环,循环次数500W次。
        for(int i=0;i<5000000;i++)
        {
            //为person赋值
            person.setId(i);
            person.setName(RandomValue.getChineseName());
            person.setSex(RandomValue.name_sex);
            person.setAge(RandomValue.getNum(1, 100));
            person.setEmail(RandomValue.getEmail(4,15));
            person.setTel(RandomValue.getTel());
            person.setAddress(RandomValue.getRoad());
            //执行插入语句
            pMapper.insert(person);
            begin++;
        }
        //计结束时间
        long eTime = System.currentTimeMillis();
        System.out.println("插入500W条数据耗时:"+(eTime-bTime));
    }
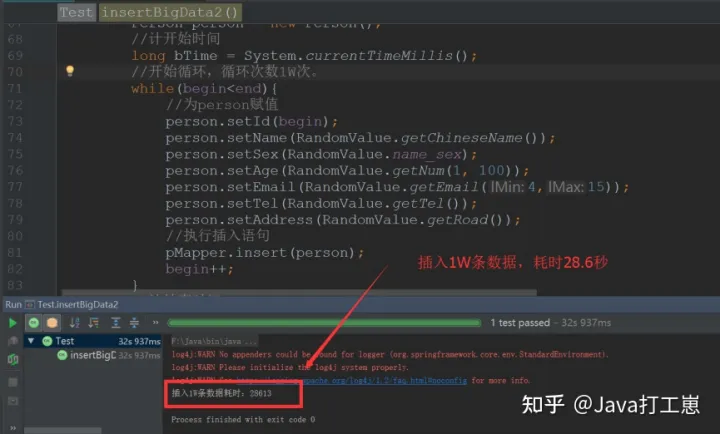
本想测试插入五百万条数据,但是实际运行过程中太慢,中途不得不终止程序。最后得到52W数据,大约耗时两首歌的时间(7~9分钟)。随后,利用mybatis向mysql插入10000数据。
结果如下:
利用mybatis插入 一万 条数据耗时:28613,即28.6秒

第二种策略测试:
2.2 采用JDBC直接处理(开启事务、关闭事务)
采用JDBC直接处理的策略,这里的实验内容分为开启事务、未开启事务是两种,过程均如下:
- 利用PreparedStatment预编译
- 循环,插入对应数据,并存入
事务对于插入数据有多大的影响呢? 看下面的实验结果:
//该代码为开启事务
 private long begin = 33112001;//起始id
    private long end = begin+100000;//每次循环插入的数据量
    private String url = "jdbc:mysql://localhost:3306/bigdata?useServerPrepStmts=false&rewriteBatchedStatements=true&useUnicode=true&characterEncoding=UTF-8";
    private String user = "root";
    private String password = "0203";


@org.junit.Test
    public void insertBigData3() {
        //定义连接、statement对象
        Connection conn = null;
        PreparedStatement pstm = null;
        try {
            //加载jdbc驱动
            Class.forName("com.mysql.jdbc.Driver");
            //连接mysql
            conn = DriverManager.getConnection(url, user, password);
             //将自动提交关闭
             conn.setAutoCommit(false);
            //编写sql
            String sql = "INSERT INTO person VALUES (?,?,?,?,?,?,?)";
            //预编译sql
            pstm = conn.prepareStatement(sql);
            //开始总计时
            long bTime1 = System.currentTimeMillis();

            //循环10次,每次一万数据,一共10万
            for(int i=0;i<10;i++) {
                //开启分段计时,计1W数据耗时
                long bTime = System.currentTimeMillis();
                //开始循环
                while (begin < end) {
                    //赋值
                    pstm.setLong(1, begin);
                    pstm.setString(2, RandomValue.getChineseName());
                    pstm.setString(3, RandomValue.name_sex);
                    pstm.setInt(4, RandomValue.getNum(1, 100));
                    pstm.setString(5, RandomValue.getEmail(4, 15));
                    pstm.setString(6, RandomValue.getTel());
                    pstm.setString(7, RandomValue.getRoad());
                    //执行sql
                    pstm.execute();
                    begin++;
                }
                //提交事务
                conn.commit();
                //边界值自增10W
                end += 10000;
                //关闭分段计时
                long eTime = System.currentTimeMillis();
                //输出
                System.out.println("成功插入1W条数据耗时:"+(eTime-bTime));
            }
            //关闭总计时
            long eTime1 = System.currentTimeMillis();
            //输出
            System.out.println("插入10W数据共耗时:"+(eTime1-bTime1));
        } catch (SQLException e) {
            e.printStackTrace();
        } catch (ClassNotFoundException e1) {
            e1.printStackTrace();
        }
    }
1、我们首先利用上述代码测试无事务状态下,插入10W条数据需要耗时多少。
如图:

成功插入1W条数据耗时:21603
成功插入1W条数据耗时:20537
成功插入1W条数据耗时:20470
成功插入1W条数据耗时:21160
成功插入1W条数据耗时:23270
成功插入1W条数据耗时:21230
成功插入1W条数据耗时:20372
成功插入1W条数据耗时:22608
成功插入1W条数据耗时:20361
成功插入1W条数据耗时:20494
插入10W数据共耗时:212106
实验结论如下:
在未开启事务的情况下,平均每 21.2 秒插入 一万 数据。
接着我们测试开启事务后,插入十万条数据耗时,如图:

成功插入1W条数据耗时:4938
成功插入1W条数据耗时:3518
成功插入1W条数据耗时:3713
成功插入1W条数据耗时:3883
成功插入1W条数据耗时:3872
成功插入1W条数据耗时:3873
成功插入1W条数据耗时:3863
成功插入1W条数据耗时:3819
成功插入1W条数据耗时:3933
成功插入1W条数据耗时:3811
插入10W数据共耗时:39255
实验结论如下:
开启事务后,平均每 3.9 秒插入 一万 数据
第三种策略测试:
2.3 采用JDBC批处理(开启事务、无事务)
采用JDBC批处理时需要注意一下几点:
1、在URL连接时需要开启批处理、以及预编译
String url = “jdbc:mysql://localhost:3306/User?rewriteBatched
-Statements=true&useServerPrepStmts=false”;
2、PreparedStatement预处理sql语句必须放在循环体外
代码如下:
private long begin = 33112001;//起始id
private long end = begin+100000;//每次循环插入的数据量
private String url = "jdbc:mysql://localhost:3306/bigdata?useServerPrepStmts=false&rewriteBatchedStatements=true&useUnicode=true&characterEncoding=UTF-8";
private String user = "root";
private String password = "0203";


@org.junit.Test
public void insertBigData() {
    //定义连接、statement对象
    Connection conn = null;
    PreparedStatement pstm = null;
    try {
        //加载jdbc驱动
        Class.forName("com.mysql.jdbc.Driver");
        //连接mysql
        conn = DriverManager.getConnection(url, user, password);
  //将自动提交关闭
  // conn.setAutoCommit(false);
        //编写sql
        String sql = "INSERT INTO person VALUES (?,?,?,?,?,?,?)";
        //预编译sql
        pstm = conn.prepareStatement(sql);
        //开始总计时
        long bTime1 = System.currentTimeMillis();

        //循环10次,每次十万数据,一共1000万
        for(int i=0;i<10;i++) {

            //开启分段计时,计1W数据耗时
            long bTime = System.currentTimeMillis();
            //开始循环
            while (begin < end) {
                //赋值
                pstm.setLong(1, begin);
                pstm.setString(2, RandomValue.getChineseName());
                pstm.setString(3, RandomValue.name_sex);
                pstm.setInt(4, RandomValue.getNum(1, 100));
                pstm.setString(5, RandomValue.getEmail(4, 15));
                pstm.setString(6, RandomValue.getTel());
                pstm.setString(7, RandomValue.getRoad());
                //添加到同一个批处理中
                pstm.addBatch();
                begin++;
            }
            //执行批处理
            pstm.executeBatch();
           //提交事务
  //        conn.commit();
            //边界值自增10W
            end += 100000;
            //关闭分段计时
            long eTime = System.currentTimeMillis();
            //输出
            System.out.println("成功插入10W条数据耗时:"+(eTime-bTime));
        }
        //关闭总计时
        long eTime1 = System.currentTimeMillis();
        //输出
        System.out.println("插入100W数据共耗时:"+(eTime1-bTime1));
    } catch (SQLException e) {
        e.printStackTrace();
    } catch (ClassNotFoundException e1) {
        e1.printStackTrace();
    }
}
首先开始测试
无事务,每次循环插入10W条数据,循环10次,一共100W条数据。
结果如下图:


成功插入10W条数据耗时:3832
成功插入10W条数据耗时:1770
成功插入10W条数据耗时:2628
成功插入10W条数据耗时:2140
成功插入10W条数据耗时:2148
成功插入10W条数据耗时:1757
成功插入10W条数据耗时:1767
成功插入10W条数据耗时:1832
成功插入10W条数据耗时:1830
成功插入10W条数据耗时:2031
插入100W数据共耗时:21737
实验结果:
使用JDBC批处理,未开启事务下,平均每 2.1 秒插入 十万 条数据
接着测试
开启事务,每次循环插入10W条数据,循环10次,一共100W条数据。
结果如下图:

成功插入10W条数据耗时:3482
成功插入10W条数据耗时:1776
成功插入10W条数据耗时:1979
成功插入10W条数据耗时:1730
成功插入10W条数据耗时:1643
成功插入10W条数据耗时:1665
成功插入10W条数据耗时:1622
成功插入10W条数据耗时:1624
成功插入10W条数据耗时:1779
成功插入10W条数据耗时:1698
插入100W数据共耗时:19003
实验结果:
使用JDBC批处理,开启事务,平均每 1.9 秒插入 十万 条数据
3 总结
能够看到,在开启事务下 JDBC直接处理 和 JDBC批处理 均耗时更短。
- Mybatis 轻量级框架插入 , mybatis在我这次实验被黑的可惨了,哈哈。实际开启事务以后,差距不会这么大(差距10倍)。大家有兴趣的可以接着去测试
- JDBC直接处理,在本次实验,开启事务和关闭事务,耗时差距5倍左右,并且这个倍数会随着数据量的增大而增大。因为在未开启事务时,更新10000条数据,就得访问数据库10000次。导致每次操作都需要操作一次数据库。
- JDBC批处理,在本次实验,开启事务与关闭事务,耗时差距很微小(后面会增加测试,加大这个数值的差距)。但是能够看到开启事务以后,速度还是有提升。
结论:设计到大量单条数据的插入,使用JDBC批处理和事务混合速度最快
实测使用批处理+事务混合插入1亿条数据耗时:174756毫秒
4 补充
JDBC批处理事务,开启和关闭事务,测评插入20次,一次50W数据,一共一千万数据耗时:
1、开启事务(数据太长不全贴了)
插入1000W数据共耗时:197654
2、关闭事务(数据太长不全贴了)
插入1000W数据共耗时:200540
还是没很大的差距~
借用:


分别是:
- 不用批处理,不用事务;
- 只用批处理,不用事务;
- 只用事务,不用批处理;
- 既用事务,也用批处理;(很明显,这个最快,所以建议在处理大批量的数据时,同时使用批处理和事务)
 642


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


