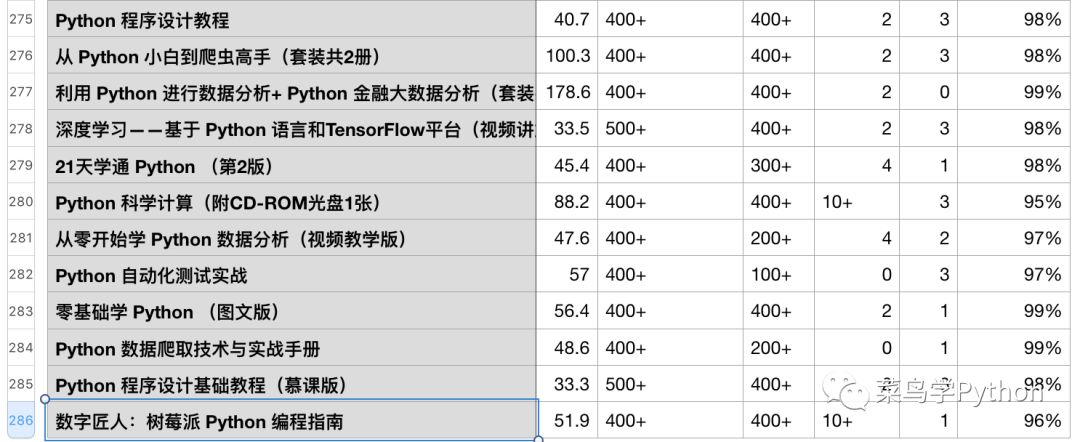
爬取300本Python书籍,用Python告诉你哪家强?

python爬取豆瓣读书任意标签下的书籍信息 import requests from bs4 import BeautifulSoup for tag in ['%E8%AE%A1%E7%AE%97%E6%9C%BA', '%e5%b0%8f%e8%af%b4', '%e5%a4%96%e5%9b%bd%e6%96%87%e5%ad%a6', '%e6%96%87%e5%ad%a6', '%e9%9a%8f%e7%a... 阅读详情

我们的菜鸟学Python公众号经常会送出一些福利,比如Python书籍。时间长了以后,觉得这么多五花八门的python书籍,究竟那几本书籍才是最好的呢,今天小编就带领大家用Python来探查一番,究竟哪些书籍是比较火的。


01

整体的思路

首先小编先带领大家从京东上爬取各类python的书籍,然后通过分析来评出最好的书籍,针对于最好的书籍,小编再对其进行着重的分析。


02

爬取300本书籍

首先是获取python书籍的相关信息,由于信息的获取需要从商品的详细页面获取,因此小编采用selenium库来模拟页面翻页过程,以此来到达新的页面进行爬取,如下图所示。

(动态图,多看5秒钟)

利用selenium可以自动的控制浏览器,并抓取我们需要的信息,部分程序如下图所示。
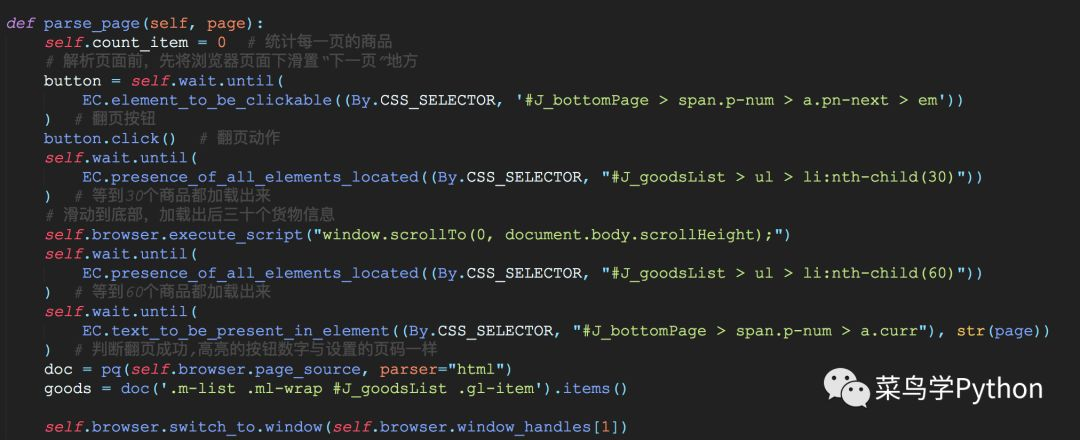
上述程序中,selenium控制浏览器滑到“下一页”的地方,然后模拟翻页动作,将每个页面中的全部60个商品加载显示出来,然后再利用pyquery来解析页面源码,获取我们需要的信息。


03

数据的分析处理

这里小编爬取了近300部python书籍的信息,这些信息包含了书的名称、价格、总评论数、好评数量、中评数量、差评数量和好评率。如下图所示。
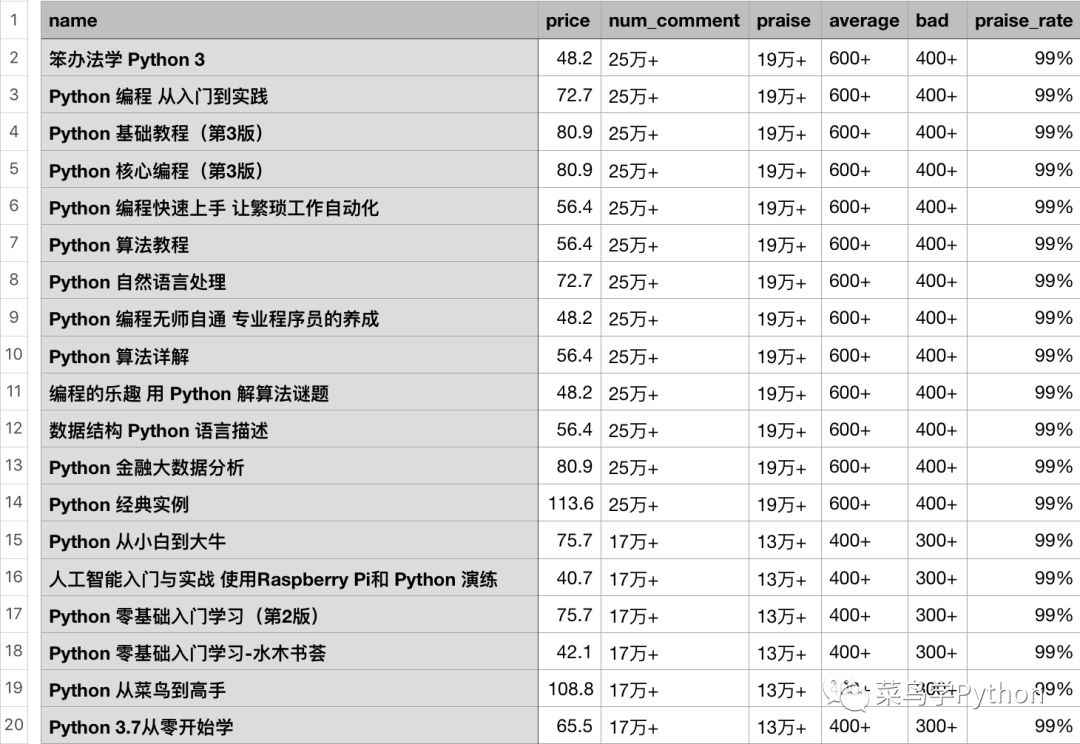
有了书籍的信息后,接下来就是对书籍进行评分,看一下究竟哪些python书籍是最火的。

1).先是数据的预处理,由于爬取到的信息绝大多数是字符串类型,所以需要先将其转化为数字,然后才能进行接下来的处理,数据预处理的部分程序如下所示。
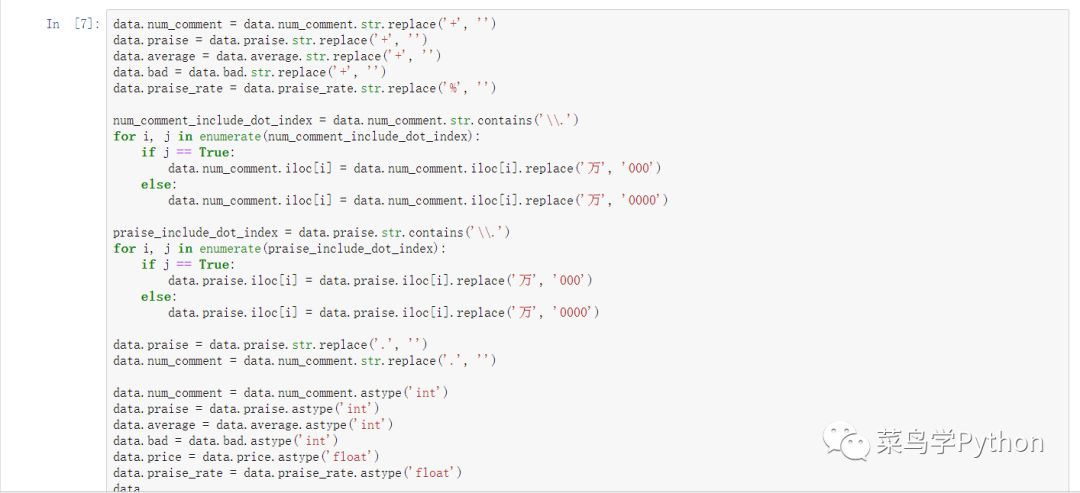
上述程序中,首先是将数据中的无关字符去除,然后进行单位的转化,最后是将字符串转化为数字。

2).数据进行归一化的处理,以避免不同数量级的特征带来干扰,例如好评数量都是几万的,但是好评率却仅仅是不到1的小数,这显然会对评判造成影响。数据归一化后,我们按照下图的公式得到了最终的评分,如下图所示。
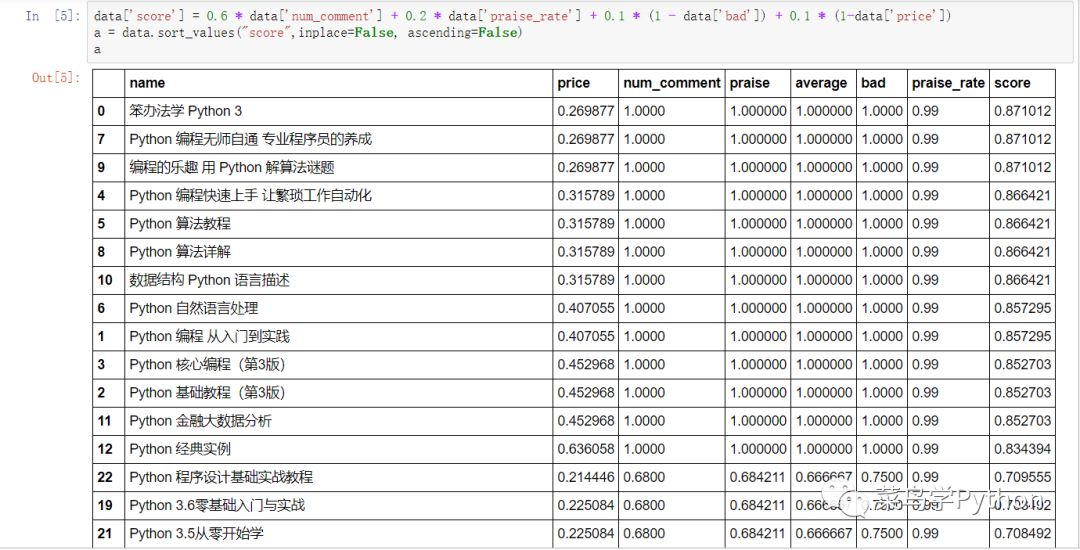
评分是这样的,小编采用总的评论数量占60%的比重,而好评率占20%的比重,差评的数量占10%的比重,而价格占了10%的比重,这样组合起来成为了100%。

由上图我们也可以看出,《笨办法学python3》成为了最好的python图书,而这本书我们也曾经送出过。当然上述的计算公式只是按照小编的个人喜好来的,如果大家觉得公式不是很合理,大家可以自己编辑公式进行打分,全凭个人喜好。


04

书籍的评论分析

接下来小编对于《笨办法学python3》和《python编程 从入门到实践》这两本书的评论进行了爬取,爬取的部分程序如下图所示。
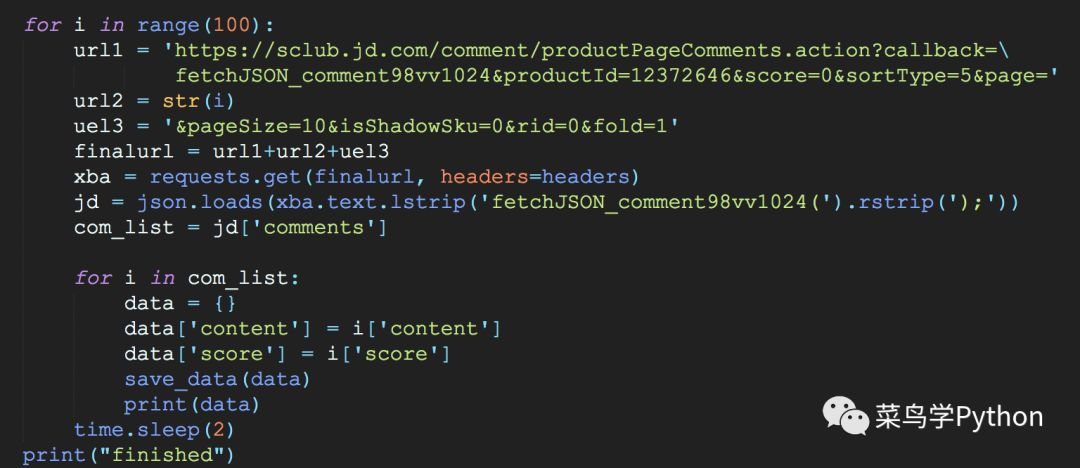
上述程序中不同的请求url只是页面数值的变化,只需要不停的循环页面,然后对返回的json数据解析,便可以得到需要的数据。

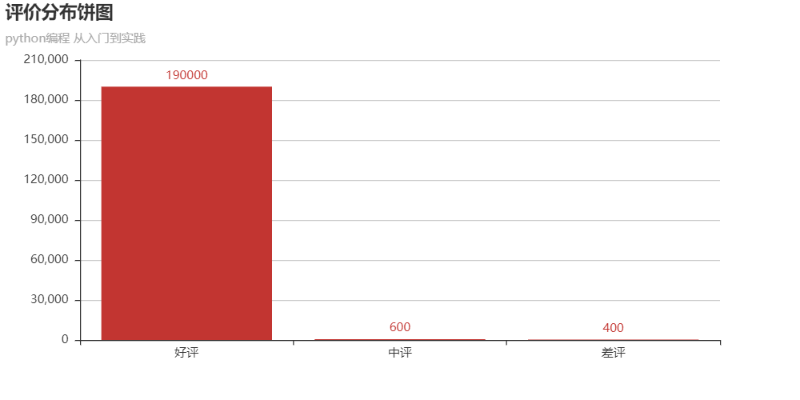
下图是对于这两本书的评论数量的分析,如下图所示。
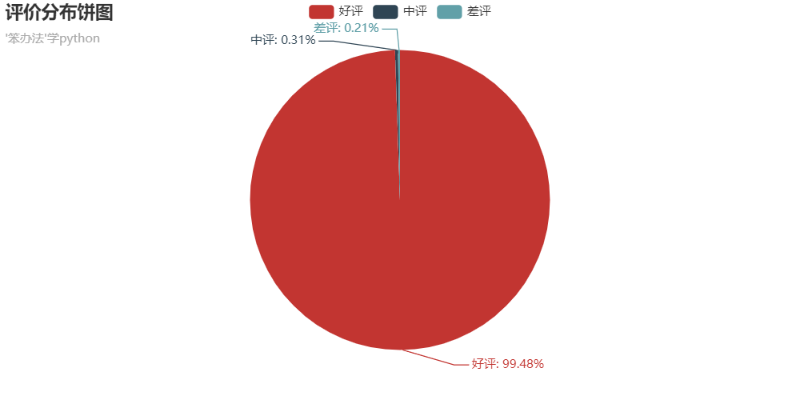
由图可以看出,两本书的好评数量高达99.48%,这与我们爬取到的好评率相一致。最后是对于爬取到的评论进行词云的展示,如下图所示。

《“笨办法”学python》词云
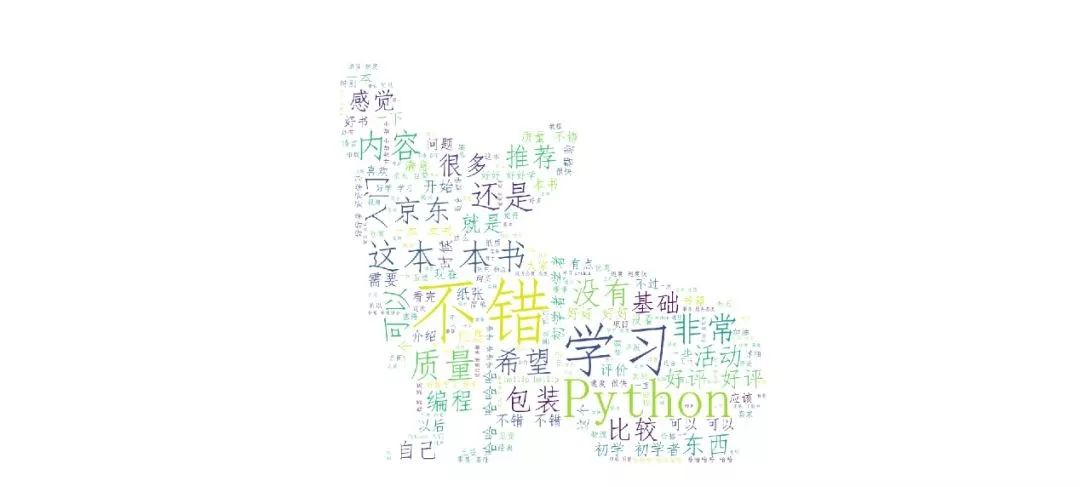
《python编程,从入门到实践》


通过上图可以看出,大家对于这些书的普遍印象都是很不错的,大家都比较认可这两本书。不知道你心目中的Python神书是那一本,欢迎留言吱一声!

近期热门:

还在做重复的劳动,不如用Python自动生成Excel以邮件发送

独家秘籍,50行代码教你买哪只黄金股

点击阅读原文,原创400篇干货文章

豆瓣读书top250数据爬取与可视化 爬虫–scrapy 题目:根据豆瓣读书top250,根据出版社对书籍数量分类,绘制饼图 搭建环境 import scrapy import numpy as np import pandas as pd import matplotlib.pyplot as plt 加载scrapy框架 #terminal 终端实现 cd .. # 跳转到上一层目录 scrapy startproject booktop # 和项目同名的scrapy框架项目 setting配置 ROBOTSTXT_OBEY = F 阅读详情

相关推荐

Python爬取上交所一年大盘数据(1)

这是我花了几天的时间去把Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。基本上主流的和经典的都有,这里我就不放图了,版权问题,个人看看是没有问题的。

2401_83977530的博客 1597

分享300本Python各类电子书,还不快保存起来!

8.8智慧生活日? 今天微信可谓是大手笔,各种支付摇一摇免单。中午吃饭付钱后看怎么出现个好久不见的摇一摇界面,点进去就瞬间膨胀了。 微信免单 感觉最近运气有些好啊...兴高采烈的发了个朋友圈,结果才知道今天微信放大招好友们各种免单,你们是否摇到免单了呢?哈哈... 雨露均沾 最近感觉运气有些好,今天下班回来,收到了华为云社区博客活动的奖品,雷蛇机械键盘,剩下的书和小...

清风Python 1066

ConvLSTM时空预测实战代码详解

ConvLSTM代码复现

JaysonWong的博客 1万+

关于Python爬虫,看这8本书就够了

关于爬虫,应该没有人不知道了吧,其抓取速度快和数据质量优的两大特点而受到越来越多的人追捧,互联网时代,有爬虫技术的加持对于职场人来说无疑是锦上添花。随着爬虫技术的流行,网上的资源层出不穷,但对于初学者来说,可能难以选择,如果选错还会在爬虫学习上走一些弯路。老DC专门为想学习了解Python爬虫的同学汇总了一份书单,大家可以先保存~其实学习爬虫不需要一大堆书单和教程,看这8本书就够了。豆瓣评分:9.1本书是一本针对所有层次的Python 读者而作的Python 入门书。

weixin_67991858的博客 1988

AI赚钱新思路 利用RPA+KIMI实现小红书全自动制作发布(详细攻略)

我已经事先准备好了文案素材,现在就利用Kimi的智能,根据我们已有的文案来创作出新的文案吧。之前我写过一篇关于【:一个戴着用百元大钞制成的简约头饰的少女,她坐在小车里,手里拿着一叠港元,整个画面洋溢着现实主义动漫风格和治愈系的温暖气息。通过这篇文章,我们已经一步步地完成了小红书治愈系文案的创作、治愈系图片的生成,以及笔记的发布,实现了整个流程的自动化。不慌不忙,快乐常在 在繁忙的日常中,给自己的心灵留一片净土,感受内心深处的平静与安宁。接下来,我将展示如何使用影刀来编写自动化脚本,以生成治愈系的图文图片。

weixin_42172073的博客 3686

深入理解EtherCAT状态机:从IGH代码看伺服电机如何从‘上电’到‘使能’

本文深入解析EtherCAT状态机的工作原理,重点探讨伺服电机从'上电'到'使能'的状态转换过程。通过分析状态字(Status Word)和控制字(Control Word)的交互机制,结合IGH代码实例,揭示DS402状态机的核心逻辑,帮助工程师解决60%以上的伺服控制问题,提升EtherCAT网络调试效率。

weixin_42549037的博客 288

学习Python爬虫,必不可少的8本书

关于爬虫,应该没有人不知道了吧,其抓取速度快和数据质量优的两大特点而受到越来越多的人追捧,互联网时代,有爬虫技术的加持对于职场人来说无疑是锦上添花。

DEVELOPERAA的博客 3732

(功能安全六)硬件FMEDA计算

FMEDA(故障模式、影响与诊断分析)是功能安全验证的核心方法,通过量化分析硬件故障模式及其影响,计算SPFM、LFM、PMHF等关键指标。分析过程包含六大步骤:计算元器件失效率、识别故障模式、评估安全机制诊断覆盖率、分类计算各类失效率、量化指标计算及设计优化。输入需要系统架构图、硬件故障模式清单等资料,输出安全指标达标情况及改进建议,确保设计满足ASIL等级要求。该方法通过系统化的故障分类和量化评估,为硬件安全设计提供科学依据。

Dayongger的博客 1448

有关Python爬虫,看这几本书就够了!

网页抓取就是从网站中提取数据,因为有很多网站,已经有很多开发工具可以用来浏览网站(web爬行)寻找特定的数据片段并自动收集它们(web抓取)。收集到的数据大多是非结构化的HTML形式,之后再将其转化为结构化数据,例如电子表格或者某种形式的数据库,以便能够对这些数据加以利用。这些信息对于那些希望了解趋势的公司或寻找他们感兴趣的特定信息的组织来说是非常宝贵的。

lyy2017175913的博客 1456

【读代码】SQLBot:开源自然语言转SQL智能助手原理与实践

SQLBot是 DataEase 团队开源的自然语言转 SQL 智能助手,致力于让非技术用户也能通过自然语言与数据库对话,自动生成 SQL 查询,实现自助数据分析、智能BI问答、报表生成等场景。SQLBot 结合了大语言模型(LLM)、数据库元数据解析、SQL解析与执行等多项技术,具备强大的多数据库适配能力和灵活的扩展性。降低数据分析门槛,让业务人员无需掌握SQL即可获取数据洞察支持多种数据库类型,适应企业多样化数据环境提供可扩展的API和插件机制,便于集成到各类BI、数据平台和业务系统。

kakaZhui的博客 829

【天气雷达】双偏振产品-差分反射率ZDR详解

双偏振产品-差分反射率ZDR详解。

珞瑜的博客 5407

Python网络爬虫经典书籍推荐

1. Python编程:从入门到实践 - 2016 本书是一本针对所有层次的Python 读者而作的Python 入门书。全书分两部分:第一部分介绍用Python 编程所必须了解的基本概念,包括matplotlib、NumPy 和Pygal 等强大的Python 库和工具介绍,以及列表、字典、if 语句、类、文件与异常、代码测试等内容;第二部分将理论付诸实践,讲解如何开发三个项目,包括简单的Python 2D 游戏开发如何利用数据生成交互式的信息图,以及创建和定制简单的Web 应用,并帮读者解决常..

铃响了铎 8226

LVGL core theme主题管理(lv_theme.c)

如果打开宏,主题的初始化是在显示设备注册时完成的。整个themes的实现放在目录下面。这里一共有三套主题(basic、default和mono)可供选择或者参考。源码中默认对接的是 default 主题,所以在中,看到的是调用default主题的接口。也就是说,如果需要更换主题,把这里面的接口换掉就可以了。或者要重新做一套主题,参考这些实现修改也就可以了。虽说有三套主题,但逻辑流程是一样的。主要完成两个工作:构造lv_theme_t结构体和初始化默认样多备用(style_init函数内实现)。构造。....

Bigan(安)的博客 3411

python书籍_爬取300本Python书籍,用Python告诉你哪家强?

我们的菜鸟学Python公众号经常会送出一些福利,比如Python书籍。时间长了以后,觉得这么多五花八门的python书籍,究竟那几本书籍才是最好的呢,今天小编就带领大家用Python来探查一番,究竟哪些书籍是比较火的。01整体的思路首先小编先带领大家从京东上爬取各类python的书籍,然后通过分析来评出最好的书籍,针对于最好的书籍,小编再对其进行着重的分析。02爬取300本书籍首先是获...

weixin_39548541的博客 105

Transformer实战(2)——循环神经网络详解

循环神经网络 (Recurrent neural networks, RNN) ,RNN 是在文本输入中广泛使用的神经网络。RNN 非常灵活,已被用于解决诸如语音识别、语言建模、机器翻译、情感分析和图像字幕等问题。RNN 利用输入的序列特性,序列输入可以是文本、语音、时间序列以及任何其他元素的出现取决于其前面元素的序列。在本节中,我们介绍了 RNN 及其变体,并学习如何使用 TensorFlow 进行实现。

盼小辉丶的博客 1万+

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

python书籍_近300本Python书籍到底哪家强,用Python告诉你

我们的菜鸟学Python公众号经常会送出一些福利,比如Python书籍。时间长了以后,觉得这么多五花八门的python书籍,究竟那几本书籍才是最好的呢,今天小编就带领大家用Python来探查一番,究竟哪些书籍是比较火的。01整体的思路首先小编先带领大家从京东上爬取各类python的书籍,然后通过分析来评出最好的书籍,针对于最好的书籍,小编再对其进行着重的分析。02爬取300本书籍首先是获...

weixin_39622225的博客 131

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

自学python的书籍逐级推荐-近300本Python书籍到底哪家强,用Python告诉你

爬取300本书籍首先是获取python书籍的相关信息,由于信息的获取需要从商品的详细页面获取,因此小编采用selenium库来模拟页面翻页过程,以此来到达新的页面进行爬取,如下图所示。(动态图,多看5秒钟)利用selenium可以自动的控制浏览器,并抓取我们需要的信息,部分程序如下图所示。上述程序中,selenium控制浏览器滑到“下一页”的地方,然后模拟翻页动作,将每个页面中的全部60个商品加载...

weixin_37988176的博客 208

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

python爬虫-爬取当当网书籍信息存到Excel中

文章目录一、任务二、分析(一)、单页面的信息分析源代码分析目标信息定位与分析代码设计(二)、所有目标页面链接分析目标链接分析代码设计三、注意要点四、完整代码五、参考 一、任务 获取当当网上至少300本书【均为某类书,如python相关的书籍,或概率论相关的书籍】的信息,包括书名,网址,价格,作者,并存在excel表格中。 二、分析 (一)、单页面的信息分析 源代码分析 在当当网的搜索框输入“pyt...

kakazai.cn 7005

Scarpy爬取当当网书籍

1:Scarpy (1) Scrapy是什么: Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可以应用在包括数据挖掘,信息处理 或存储历史数据等一系列的程序中。 (2)安装scrapy: pip install scrapy 2.scrapy项目的创建以及运行 1.创建scrapy项目: 终端输入 scrapy startproje...

m0_57126456的博客 511

selenium爬取300条京东懒加载的商品信息

selenium爬取京东懒加载的商品信息1.页面分析2.滑动滚动条获取完整页面源码3.解析源码获取标签内容4.保存信息至数据库5.运行结果 1.页面分析 首先给出要爬取数据的url: 京东 进入页面后,显示在界面上的图片已经加载完成,但是没有显示在屏幕上的内容,是没有加载的,只有当我们拖动界面,才会对相应资源进行请求和加载,我们如果用requests模块直接去请求获取页面源码数据,获取的源码肯定不完整。 这时就可以用selenium模拟浏览器的操作,通过拖动界面模拟人浏览,使浏览器资源加载完成后,再去获取页

向日葵的专属太阳 2709

我用Python爬取800只基金数据,发现……

现在很多同学都尝试过购买基金了,毕竟这是号称最简单的懒人投资方法!然而只要基金定投就一劳永逸了吗?当然不是,有哪个硬汉能忍住定投收益一点一点下跌的心痛感?这不,刚过完年,股市急转直下,众多...

简说Python的博客 825

用Python爬取Bilibili上二次元妹子的视频

点击上方“菜鸟学Python”,关注文末干货立马到手作者:Mike_Shine来源:https://urlify.cn/2qyMBb一直想爬取BiliBili的视频,无奈一直没有去研究一...

cainiao_python的博客 390

scrapy案例——当当网的爬取二

第二页 http://category.dangdang.com/pg2-cp01.03.41.00.00.00.html。1.使用scrapy爬虫技术爬取当当网中科幻小说的书籍数据,包括(图片、标题、作者和价格)#管道可以有很多个,因此管道有优先级 范围1-1000 值越小优先级越高。项目名称:当当网的爬取一——爬取科幻小说的书籍数据。2.将获取到的数据保存在本地josn文件中。6.将图片下载至本地books文件夹中。3.将图片保存在本地文件夹中。

qq_53256193的博客 877

使用python3.7中的scrapy框架,爬取起点小说

这几天在学习scrapy框架,感觉有所收获,便尝试使用scrapy框架来爬取一些数据,对自己阶段性学习进行一个小小的总结 本次爬取的目标数据是起点中文网中的免费作品部分,如下图: 本次一共爬取了100本小说,并对爬取结果进行以下两种存储; 1.把小说内容分章节写入txt中 2.把小说的内容存入sqlserver中 如下: 实现的逻辑: 1.通过书的列表页获得...

weixin_30693183的博客 706

python爬虫教程-有什么好的python3爬虫入门教程或书籍吗?

Python Web Scraping Cookbook - 2018.pdfhttps://china-testing.github.io/scrap_books.html​china-testing.github.ioPublished: 二 06 十一月 2018 By andrew In ...

q6q6q的专栏 2288

Python |(爬虫 )爬取当当网书籍信息存到Excel中

文献检索作业,小白也很无奈。还好有学霸同学的可以借鉴。 一、任务 获取当当网上至少300本书【均为某类书,如Linux相关的书籍,或C++相关的书籍】的信息,包括书名,网址,价格,作者,并存在excel表格中。 二、分析 (一)、单页面的信息分析 源代码分析 在当当网的搜索框输入“Linux”,出现搜索后的页面,按F12查看源代码。  <li ddt-pit="1" clas...

Sherlock_Homles的专栏 4139
上一篇: 女程序员做了个梦。。。
下一篇: 程序员的自我救赎,使用Python开发性格分析工具
菜鸟学Python
博客等级 码龄9年 8044粉丝 571原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值