Qwen3-Omni Technical Report

在这里插入图片描述

一、文章主要内容总结

Qwen3-Omni是一款单模态多任务模型,在文本、图像、音频和视频等多模态任务上均实现了顶尖性能,且相较于单模态模型未出现性能衰减。

1. 核心性能表现

  • 跨模态性能均衡:与Qwen系列同规模单模态模型在文本和视觉任务上性能相当,在音频任务上表现突出。在36个音频及视听基准测试中,开源领域有32个达到最优(SOTA),整体有22个达到最优,超越Gemini-2.5-Pro、Seed-ASR、GPT-4o-Transcribe等闭源强模型。
  • 多语言与长音频支持:支持119种语言的文本交互、19种语言的语音理解和10种语言的语音生成;可处理单实例最长40分钟的音频录制,用于自动语音识别(ASR)和口语理解。

2. 架构设计

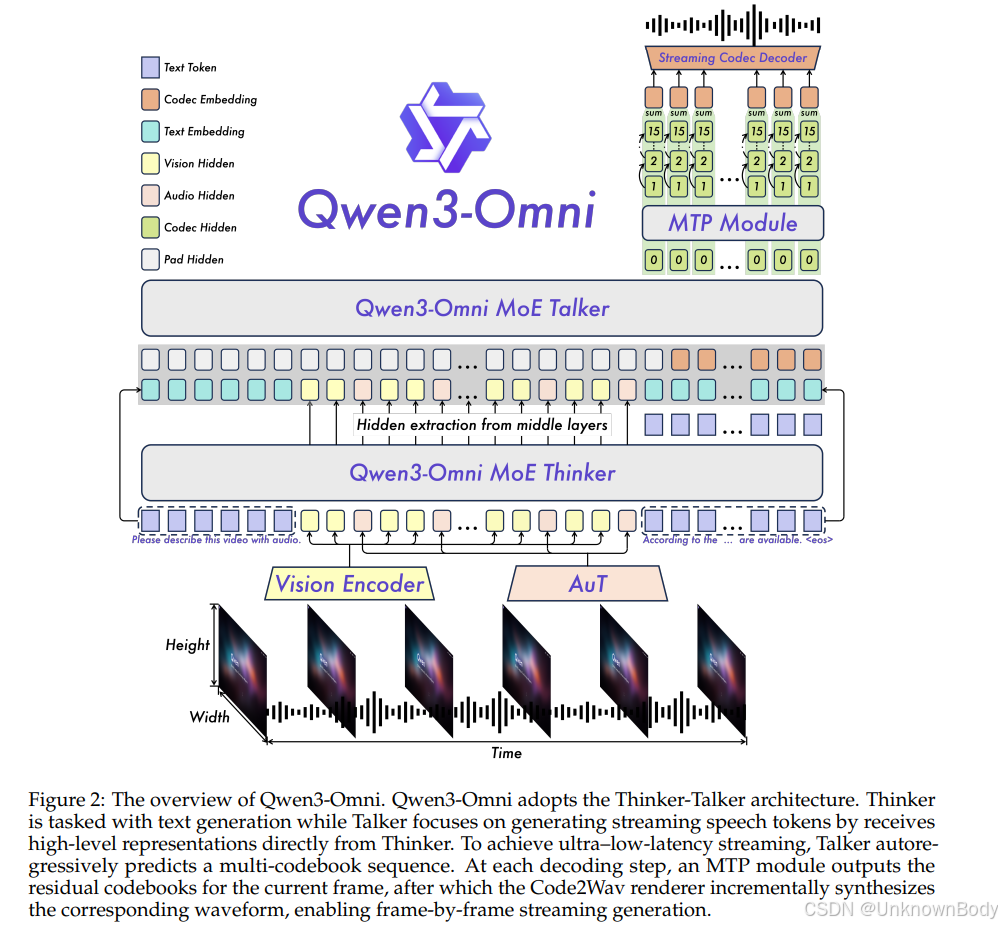
  • Thinker–Talker混合专家(MoE)架构:统一文本、图像、音频、视频的感知与生成,实现流畅文本输出和自然实时语音生成。
    • Thinker:负责文本生成,采用MoE Transformer架构(30B-A3B参数),支持流式处理,能将多模态输入转换为表征用于后续处理。
Qwen3-ASR Technical Report 本文介绍了 Qwen3-ASR 模型家族,包含两款功能强大的一体化语音识别模型与一款新型非自回归语音强制对齐模型。Qwen3-ASR-1.7B 与 Qwen3-ASR-0.6B 支持 52 种语言及方言的语言识别与语音转写,均借助大规模语音训练数据与基础模型 Qwen3-Omni 强大的音频理解能力构建。除开源基准测试外,我们还进行了全面的内部评估(开源基准上的模型得分差异较小,但真实场景中的质量差距显著)。实验表明,1.7B 版本在开源 ASR 模型中达到最优性能,且可与最强商业 API 竞争; 阅读详情

相关推荐

多模态诅咒:为什么大模型会看图以后,文本推理反而变弱

多模态诅咒的本质,是四重打击叠加:信息密度不对等引入噪声,参数容量竞争造成零和博弈,跨模态对齐污染文本权重,视觉 token 稀释关键注意力。行业打破它经历了三次范式跳跃:第一阶段靠数据配比和冻结策略少交税;第二阶段靠原生联合预训练和 MoE 解耦避免互相伤害;第三阶段靠推理型多模态把视觉压缩成高密度逻辑表示,让不同模态开始互相增强。对前沿模型来说,多模态正在从拖累变成增益。对中小模型和微调场景来说,诅咒还没有自动消失。

AI浩 254

unity中简单全景搭建

全景场景能够直观的展现一部分区域的全貌,在全景场景中我们能360°观看周围的景象,仿佛自身就在这个场景中,在场景的外部,我们能发现场景就是一个密封的球体,我们是处在球体的内部观察周围,在球内部观察四周看到的都是球的内表面,所以我们看到的全景其实就是贴在密封球体内的一张全景图片。接下来要介绍的就是如何在unity中用一个球体来搭建全景场景。

qq_31791999的博客 3637

极验第四代滑块验证码破解(三):滑块轨迹构造

极验第四代滑块验证码破解(三):滑块轨迹构造声明 声明 原创文章,请勿转载! 本文内容仅限于安全研究,不公开具体源码。维护网络安全,人人有责。 本文关联文章超链接:

帯泪的鱼的博客 8624

《Cesium 基础知识点》- 申请 Cesium Ion 密钥

一、访问 https://cesium.com/ion/signin/tokens 二、登录/注册 三、申请 四、使用 // 密钥 let defaultAccessToken = 'your token string'; // 设置 Cesium.Ion.defaultAccessToken = defaultAccessToken; // 初始化 let viewer = new Cesium.Viewer('cesiumContainer', {}); ...

前端技术 2572

uniapp - 解决uni.getLocation定位不准有偏差,定位经纬度不准确有几百米误差、获取地图定位有偏差怎么办,已配置高精确度但依旧不精准(uni.getLocation定位不准如何解决)

uni.getLocation,获取当前的地理位置、速度。已经设置altitude高精度,uniapp API获取定位有差异问题解决,获取定位有几百米偏差,uni.getLocation(OBJECT)中使用默认type ”wgs84“会导致定位不准的问题,gcj02,uni.getLocation地图定位不准,获取经纬度错误偏移了几十公里,经纬度的精确度误差,怎么消除经纬度偏差,解决 uniapp uni.getLocation 定位经纬度不准问题,使用定位不准,定位不准误差问题,解决定位不准问题,高德地

✅ 精选推荐文章 1万+

YOLOv8改进,YOLOv8添加可变性卷积DCNv2

DCNv2对原始的DCNv1进行了改进,可变形卷积网络的卓越性能源于其适应对象几何变化的能力。通过对其自适应行为的检查,虽然对其神经特征的空间支持比常规的ConvNets更接近于对象结构,但这种支持可能远远超出感兴趣区域,导致特征受到不相关图像内容的影响。为了解决这个问题,我们提出了一种可变形卷积网的重新表述,通过提高建模能力和更强的训练,提高了其专注于相关图像区域的能力。通过更全面地集成网络中的可变形卷积,并引入扩展变形建模范围的调制机制,增强了建模能力。

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 3606

三维重建(十八)——colmap的使用(粗浅)

三维重建(十八)——colmap的使用(粗浅)

河海大学研究生在读的学习笔记 1377

2026国内Claude Code保姆级教程:安装、避坑、防串台全优化

安装 Claude Code CLI + 切换 npm 国内镜像优先配置固定关闭:自动联网、自动项目扫描VSCode 内置终端直接用,不装多余插件会话隔离+指令约束,彻底解决 Rust、小程序 跨语言串台。

lpfasd123的博客 2564

基于STM32设计的智能水母投喂器(华为云IOT)_170

本项目利用STM32单片机控制各种传感器和水泵等设备,能够自动检测和调整水温和水质等参数,自动换水,自动供氧等等,充分满足了水母的养殖要求和需要。同时,根据水母喜欢的光环境,添加了RGB氛围灯,以及可以手动控制的喂食器等功能,提升了水母养殖的便利性和趣味性。

8808

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

上一篇: ALOPE: Adaptive Layer Optimization for Translation Quality Estimation using Large Language Models
下一篇: SimpleFold: Folding Proteins is Simpler than You Think
UnknownBody
博客等级 码龄16年 5601粉丝 4739原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

UnknownBody

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

