


42. 接雨水
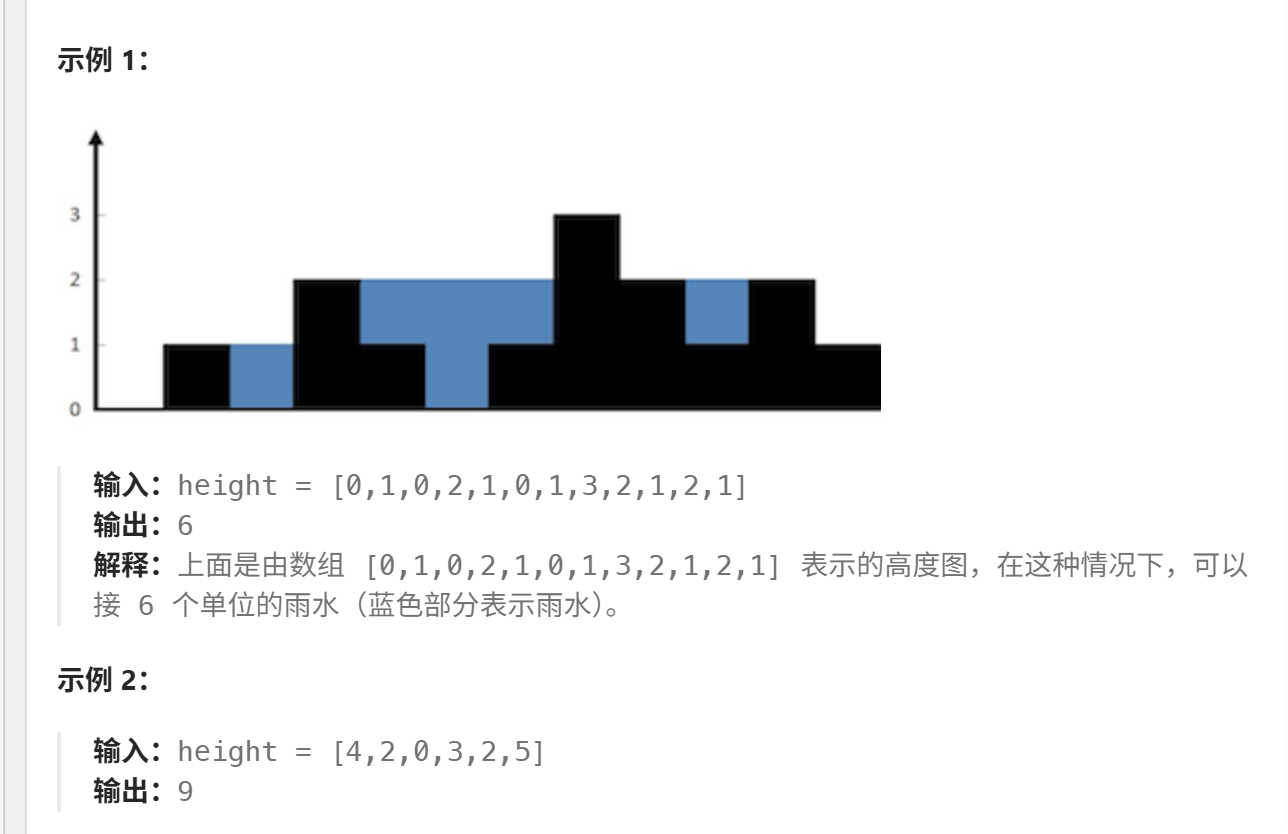
1、题解
这道题其实就是需要我们计算出每一个柱子可以最多盛多少水,然后把它们相加。
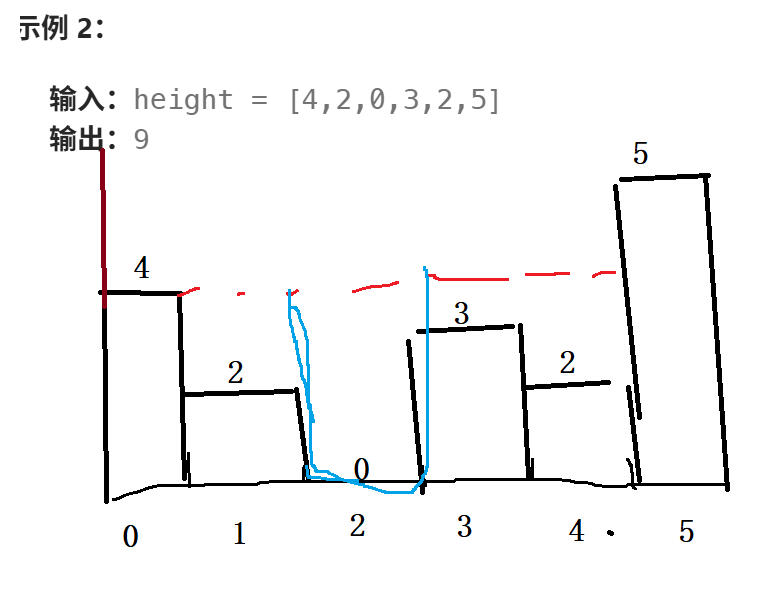
以示例二为例,我要算出下标 2 这个位置可以盛多少雨水,是不是需要往下标 2 的左边看看找到最大高度 4 ,然后往下标 2 的右边看看找到最大高度 5 ,而盛水多少是取决于,两个高度较小的那个,选高的那个高度绝对溢出,那这个地方就要选择下标 0 ,然后再用 height [0] 减去下标2 位置的高度就可以得出结果了。
这里把 i 下标左边的最大高度设置为 mleft[i],i 下标右边的最大高度设置为 mright[i],盛水多少 = max(mleft[i], mright[i])- height[i]。
(1)暴力算法,遍历所有下标,每次都从左边找最大高度,从右边找到最大高度,时间复杂度就是O(N2)。
(2)动态规划的思想:我们可以利用两个数组,分别记录i位置的左边最大高度
= max (mleft[i-1], height[i-1]),右边最大高度 = max (mright[i+1], height[i+1]),最后再遍历一次数组,根据盛水多少 = max(mleft[i], mright[i])- height[i] ,然后累加,不就可以得出最后结果了吗。其实就是用空间换时间的思想。
class Solution {
public:
    int trap(vector<int>& height) {
        //利用两个数组,分别记录i位置的左边最大高度=max(mleft[i-1],height[i-1]),
        //右边最大高度=max(mright[i+1],height[i+1])
        int n = height.size();
        vector<int> mleft(n), mright(n);
        for(int i = 1; i < n; i++)
        {
            mleft[i] = max(mleft[i-1], height[i-1]);
        }
        for(int i = n-2; i >= 0; i--)
        {
            mright[i] = max(mright[i+1], height[i+1]);
        }
        //每一个位置的盛水高度:min(mleft[i], mright[i]) - height[i]
        int ret = 0;
        for(int i = 0; i < n; i++)
        {
            int tmp = min(mleft[i], mright[i]) - height[i];
            if(tmp > 0) ret += tmp;
        }
        return ret;
    }
};
(3)双指针
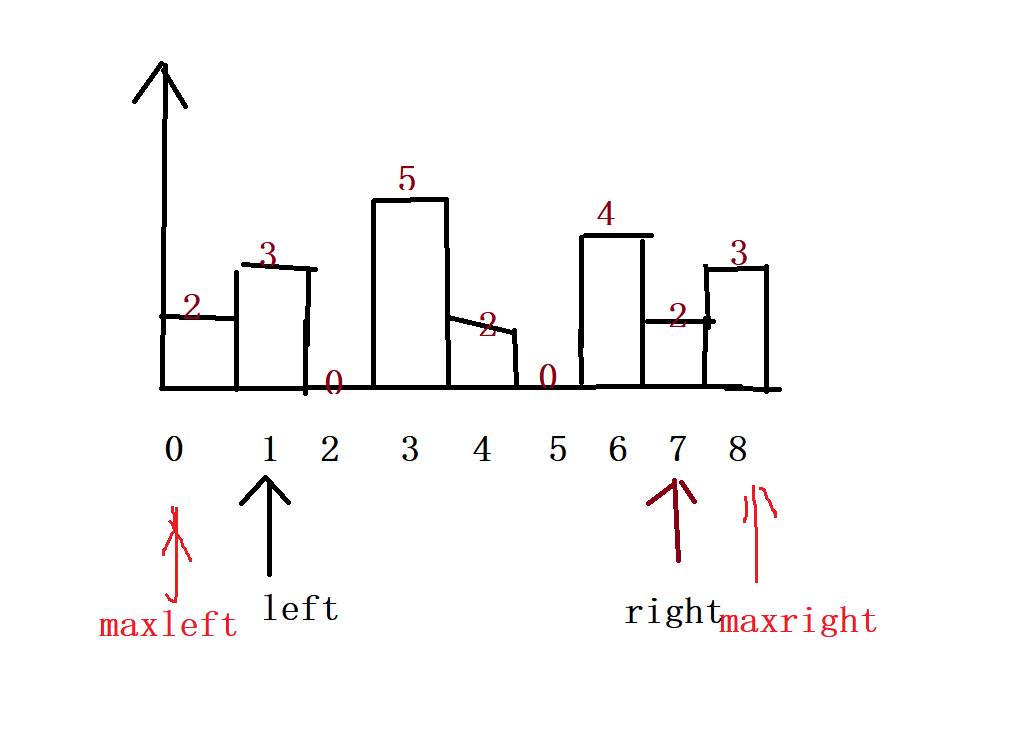
我们可以利用“短板”,什么意思呢?我们可以设置几个变量,maxleft 为 left 左边的最大高度,maxright 为 right 右边的最大高度,当我利用 left 和 right 进行遍历时,可以通过比较 maxleft 和 maxright 更新 left 或 right 位置的雨水存储。
按照上图,当 maxleft < maxright 时,是不是 left 位置的短板就一定是 maxleft 了,因为你 maxleft已经是小的一方了,你在 left 左边再怎么找比 maxleft 或者 maxright 大的都无济于事了,因为短的那一方决定了盛雨水的多少,此时就可以通过 maxleft - height[left] 得到盛的雨水量,然后再让left++对不对?不是,你要先更新 maxleft = max(maxleft , height[left]) 才能让 left++。
同理,如果 maxleft > maxright 时,是不是 right 位置的短板就一定是 maxright,通过 maxright - height[right] 得到盛的雨水量,更新 maxright = max(maxright , height[right]) 才能让 right--。
如果 maxleft == maxright,更新谁都可以;这里注意循环条件应该是 left <= right,因为进入循环时,我们是通过比较决定统计谁的雨水量,那说明统计前left 和 right 都是没有被统计的,如果仅仅是 left < right,最后肯定有一个位置的雨水一定没有被统计。
class Solution {
public:
    int trap(vector<int>& height) {
        //利用短板,使用双指针
        int n = height.size();
        //maxleft: left左边的最大高度
        //maxright: right右边的最大高度
        int maxleft = height[0], maxright = height[n-1];
        int left = 1, right = n - 2;//因为左右两端不可能有雨水
        int ret = 0;
        while(left <= right)
        {
            //left和right雨水还没有统计
            //思想:统计left还是right位置的雨水,取决于min(maxleft, maxright)
            if(maxleft < maxright)
            {
                //更新left位置,左边的maxleft已经是短板了,右边即使有比当前maxright更大的高度
                //也没有用,left位置的雨水已经可以统计了
                //为什么不更新right位置的雨水,因为短板不确定
                //:在left到right-1的区间可能存在比maxright或者比maxleft小的高度
                int tmp = maxleft - height[left];
                if(tmp > 0) ret += tmp;
                //更新maxleft
                maxleft = max(maxleft, height[left++]);
            }
            else
            {
                int tmp = maxright - height[right];
                if(tmp > 0) ret += tmp;
                //更新maxleft
                maxright = max(maxright, height[right--]);
            }
        }
        return ret;
    }
};
438. 找到字符串中所有字母异位词
1、题解
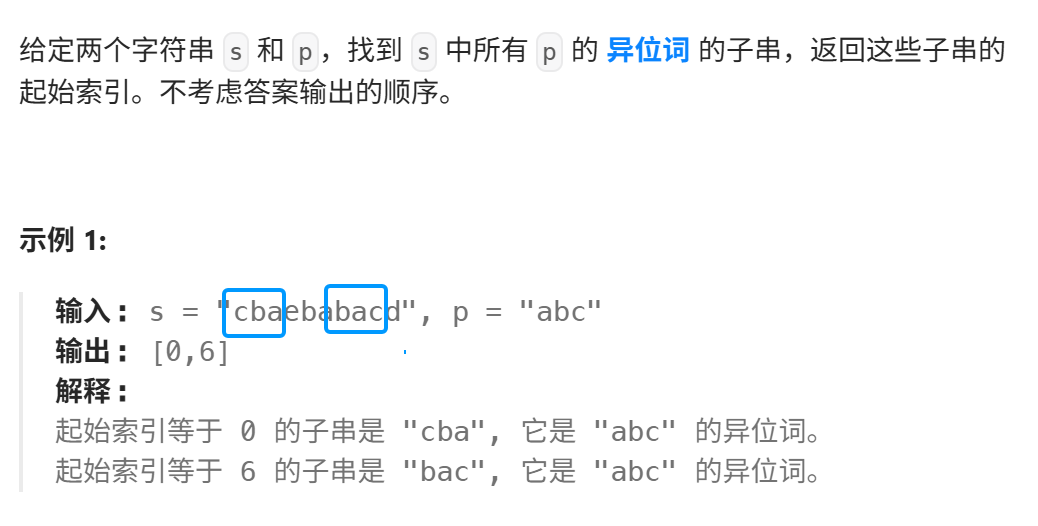
这道题首先要搞懂什么是异位词,根据示例只要 s 的某个子串的大小等于 p ,并且字符个数一一对应,不需要一样顺序,就可以成立,并且返回 s 子串索引。
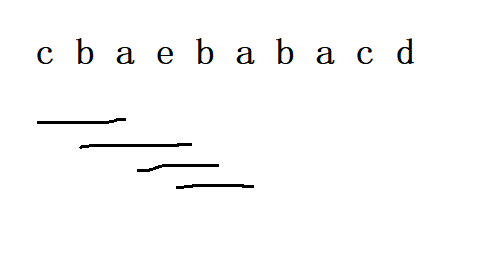
(1)直接暴力解法,遍历字符串 s ,每次都选取p.size() 个大小,可以通过hash表和 p 进行比较,这样的算法复杂度是O(N2)
(2)滑动窗口:我们在比较完 "cba" 后其实不用再从 b 开始往后遍历,你会发现下一次比较选取的是子串 "bae" ,对比之前的子串,是不是就是少了一个"c",多了一个"e",所以我们完全可以每次都只加入一个字符,去除最左边的字符;然后只要窗口大小(right - left + 1)和 p.size() 相等,就可以对两个字符数组进行比较。
(3)比较方式:因为题目说了字符都是在 a~z ,直接用两个数组hash[26]统计两个被比较的字符串的个数:hash[字符-‘a’]++,最后只需要循环26次,判断两个hash对应字符个数是否一样即可。
但是如果题目不是字符都是在 a~z那怎么办,我们可以通过一个变量count-->统计字符有效个数。
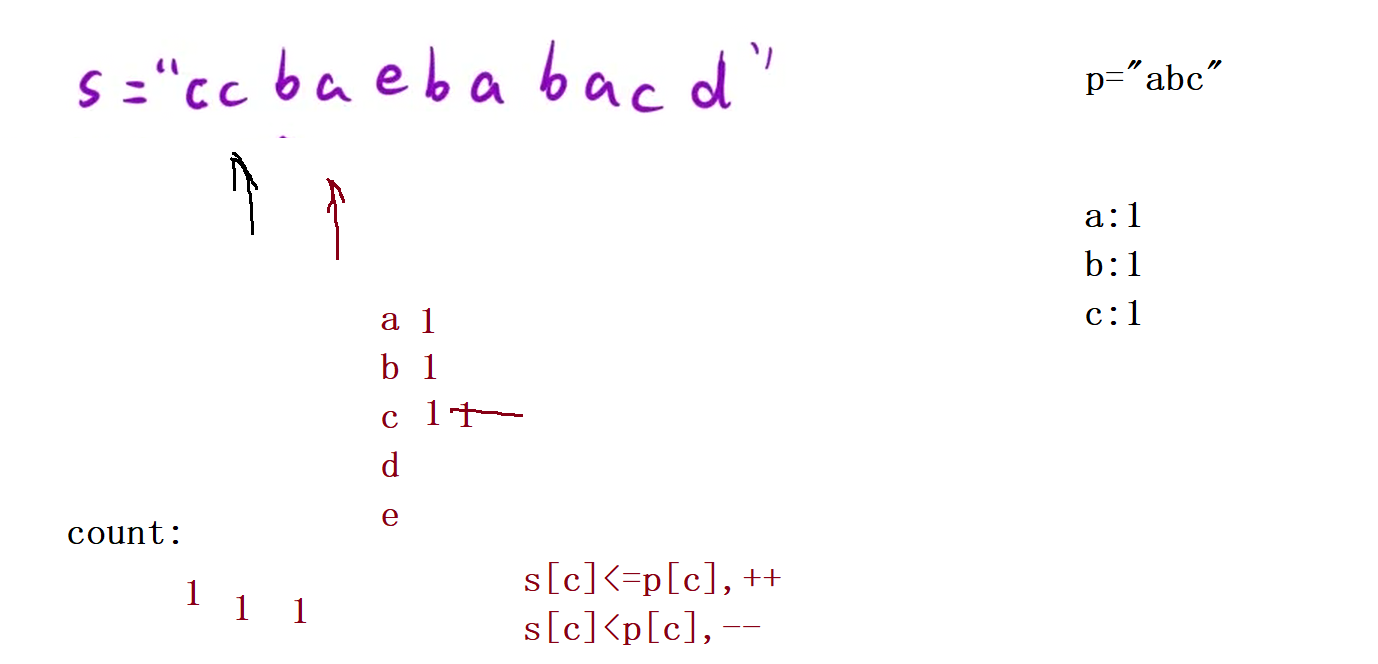
什么意思呢?遍历 s 字符串时,字符 c 进窗口后,hashs中 c 的个数 <= hashp 中 c 的个数,那么滑动窗口中对于p,是不是有效个数应该+1;而第二个字符 c 进入窗口后,hashs中 c 的个数变成2了,我们就不应该让有效字符个数+1,因为这个 c 对于字符串 p 是多余的;所以当 right 走到 b 位置,进窗口后判断是否是字母异位词时,就不需要通过循环26次判断两个字符串是否一致了,直接通过count == 2判断条件不成立。
当 right 走到 a 位置,进窗口后发现滑动窗口个数为4了,就要出窗口,那我在把第一个 c 出窗口后,hashs中 c 的个数变成 1 ,正好和 hashp中 c 的个数对应,count没必要--,只有当出窗口后,left 位置的 hashs[s[left] - 'a'] < hashp[s[left] - 'a'],count才要 - 1。
下面两个比较方法都给出:
(1)循环26次比较
class Solution {
public:
    vector<int> findAnagrams(string s, string p) {
        vector<int> ret;
        int left = 0, right = 0;
        int hashp[26] = {0}, hashs[26] = {0};
        for (int i = 0; i < p.size(); i++) {
            hashp[p[i] - 'a']++;
        }
        while (right < s.size()) {
            // 进窗口
            hashs[s[right] - 'a']++;
            // 判断
            if (right - left + 1 > p.size()) {
                hashs[s[left] - 'a']--; // 出窗口
                left++;
            }
            if (right - left + 1 == p.size()) {
                // 更新结果:比较两个hash表
                int flag = 0;
                for (int i = 0; i < 26; i++) {
                    if (hashp[i] != hashs[i])
                        flag = 1;
                }
                if (flag == 0)
                    ret.push_back(left);
            }
            right++;
        }
        return ret;
    }
};
(2)通过有效字符个数count
class Solution {
public:
    vector<int> findAnagrams(string s, string p) {
        vector<int> ret;
        int left = 0, right = 0;
        int hashp[26] = {0}, hashs[26] = {0};
        for (int i = 0; i < p.size(); i++) {
            hashp[p[i] - 'a']++;
        }
        int count = 0;//统计有效字符
        while (right < s.size()) {
            // 进窗口
            hashs[s[right] - 'a']++;

            if(hashs[s[right] - 'a'] <= hashp[s[right] - 'a']) count++;

            // 判断
            if (right - left + 1 > p.size()) {
                hashs[s[left] - 'a']--; // 出窗口

                if(hashs[s[left] - 'a'] < hashp[s[left] - 'a']) count--;

                left++;
            }
            if(count == p.size()) ret.push_back(left);
            right++;
        }
        return ret;
    }
};
面试题 16.25. LRU 缓存
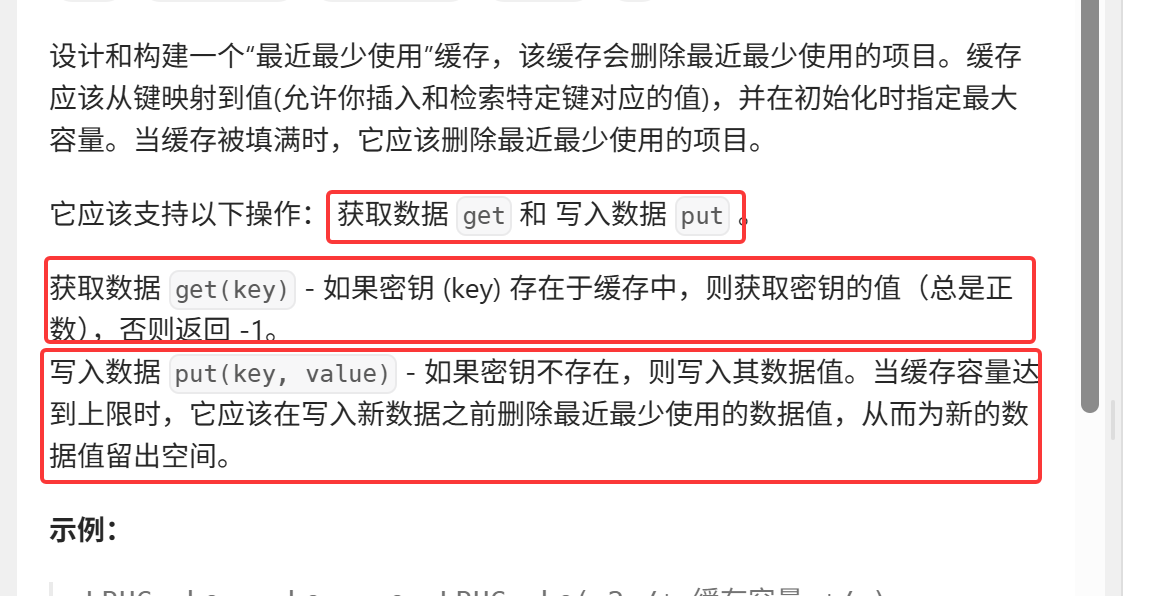
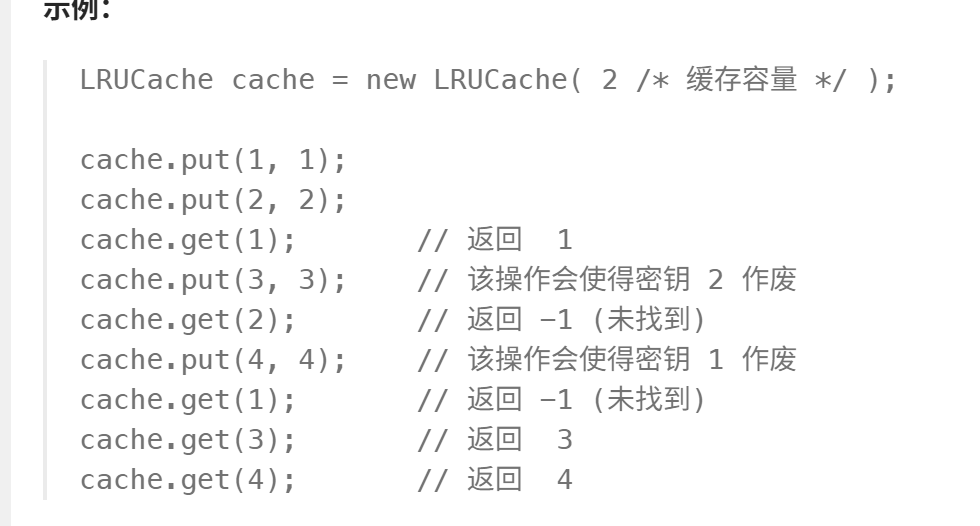
1、题解:示例1先是插入(1,1),再插入(2,2),当get(1)后,再插入(3,3)时,发现淘汰的是(2,2),说明不管是查找元素还是插入元素,都要让这个元素成为最近使用的。如果说只想到单链表,把访问的元素移到头结点,或者插入新元素时加在头结点,那么会有两个问题:
(1)查找节点时,时间复杂度是O(N)
(2)淘汰最近最久未被使用的节点时也需要对链表进行遍历
改进办法:使用 unordered_map,保存节点的<key,链表节点>,可以使查找时间复杂度到O(1),那为什么要把“链表节点”当成value 呢?主要是为了在访问节点后,需要把这个节点移到链表头,保持它是最近被使用的状态,实现移动节点也是O(1)的复杂度。
只有单向链表是不够的,因为在淘汰最近最久未被使用的节点时,我也不知道这个节点的 key 值,没办法利用哈希表来找到对应节点指针;既然要淘汰的节点肯定是链表最后一个节点,那我使用双向链表,维护一个尾指针,不保存有效数据,只为了在淘汰最后一个有效节点时通过 tail->prev找到它。而无效数据的头结点和尾节点也可以减少判空问题。
这里的代码实现涉及到某个结点移动时或者删除时,它的前驱节点和后继节点的指向关系,通过画图理解就可以实现;还有一点就是插入新节点时(key,value),如果这个key已经存在,那我就把value的值覆盖即可,记得不管是查找get,还是put都要把对应节点移动到链表第一个有效节点的位置。
struct Node
{
    int key;
    int value;
    Node* prev;
    Node* next;
    Node(int k, int v):key(k), value(v)
    {
        prev = nullptr;
        next = nullptr;
    }
};

class LRUCache {
    unordered_map<int, Node*> map;
    Node* _head;
    Node* _tail;
    int _capacity;
    int _size;
public:
    LRUCache(int capacity) {
        _capacity = capacity;
        _size = 0;
        //记得先new
        _head = new Node(-1,-1);
        _tail = new Node(-1,-1);
        _head->next = _tail;
        _tail->prev = _head;
    }

    int get(int key) {
        if(map.count(key) == 0) return -1;
        Node* node = map[key];
        Remove(node);
        AddFront(node);
        return node->value;
    }

    void put(int key, int value) {
        if(map.count(key) == 1)//key存在,更新值,并且更新链表状态
        {
            Node* node = map[key];
            Remove(node);
            AddFront(node);
            node->value = value;
            return;
        }
        if(map.count(key) == 0)//key不存在,插入链表,更新状态
        {
            Node* node = new Node(key, value);
            map[key] = node;
            AddFront(node);
        }
        if(_size > _capacity)
        {
            map.erase(_tail->prev->key);//必须先删除hash表的node指针
            PopBack();//再释放链表节点
        }
    }

    void AddFront(Node* node)
    {
        Node* tmp = _head->next;
        _head->next = node;
        node->prev = _head;
        node->next = tmp;
        tmp->prev = node;
        _size++;
    }
    void Remove(Node* node)
    {
        Node* pre = node->prev;
        Node* nex = node->next;
        pre->next = nex;
        nex->prev = pre;
        _size--;
    }
    void PopBack()
    {
        Node* back = _tail->prev;
        back->prev->next = _tail;
        _tail->prev = back->prev;
        delete back;
        back = nullptr;
        _size--;
    }
};

/**
 * Your LRUCache object will be instantiated and called as such:
 * LRUCache* obj = new LRUCache(capacity);
 * int param_1 = obj->get(key);
 * obj->put(key,value);
*/ 1105


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


