大语言模型中一个调皮的EOS token

要不要设置tokenizer.pad_token = tokenizer.eos_token? ——对pad_token和eos_token的分析 pad_token和eos_token在训练过程和推理中扮演的角色是不同的。 如何设置pad_token。能不能让pad_token=eos_token。 tokenizer.pad_token = tokenzier.eos_token. 阅读详情
AI摘要

文章介绍了在微调ChatGLM2-6B模型时遇到的EOStoken问题,LoRA微调导致模型疯狂输出。问题源于在输入中添加EOS时使用的是字符而非token_id,使得模型处理不当。解决方案是按照PTuning的方式,正确添加EOStoken_id到输入中,从而解决了模型的异常输出问题。

背景
最近需要做一个微调的培训,所以不可避免地需要上手一下相关的微调,而受限于机器资源,暂时没法做全参数微调,所以就尝试了目前比较火的两种高效微调方式,分别是PTuning和LoRA。模型选择得自然是现在中文做的比较好的ChatGLM2-6B。

微调的代码分别用的是

  • PTuning
  • LoRA
    在分别尝试了两个结果后,发现LoRA微调出来的结果有点抽风,喜欢疯狂输出,而它就是咱们今天的主角:ChatGLM2-6B的Tokenizer所使用的EOS(end-of-sequence) token。
EOS token 介绍
其实从名字就可以看出来,EOS的作用就是标记一个序列的结束,这样模型就可以知道这个序列已经结束了,不需要再继续输出了。 如果以为例,一般模型在推理的时候,觉得可以结束一句话了,就会输出,但是模型的脑子里肯定没有的概念呀,它只能输出数字,所以我们需要把转换成数字,这个数字就是EOS token ID。在ChatGLM2-6B的Tokenizer中,EOS token ID是2,而模型输出的时候,输出的也是2,而不是

分析BUG
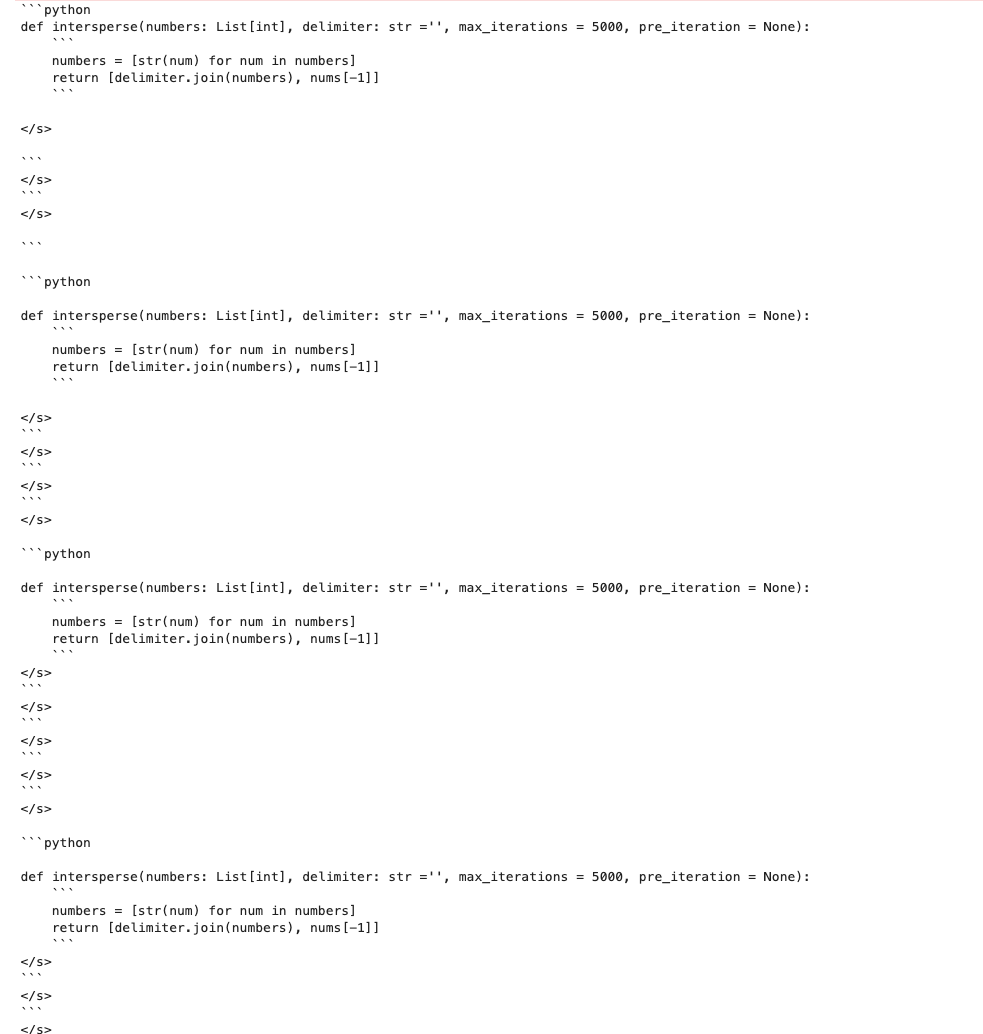
既然模型会输出文字版的,那是不是模型的输入中,给它喂进去了不合适的语料呢?

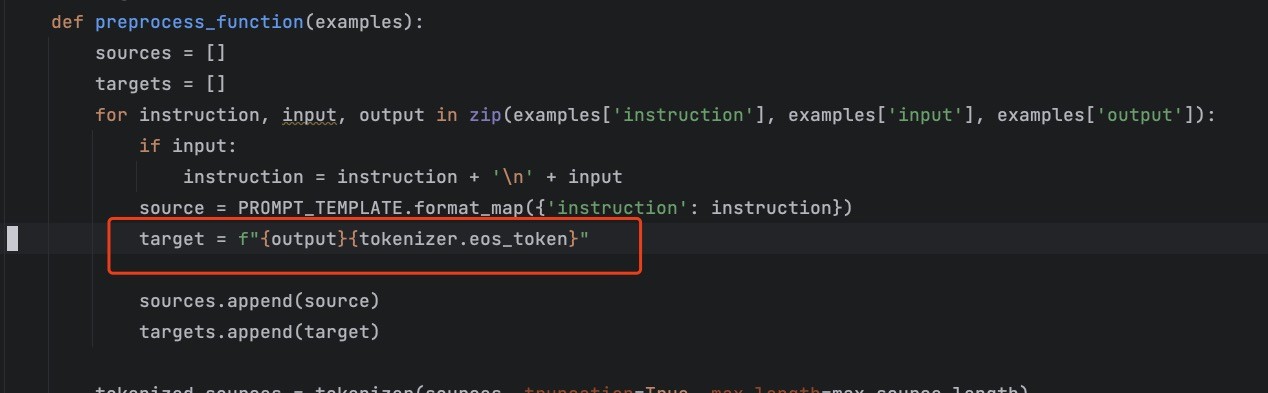
进一步查找发现所使用的LoRA库中是这么添加EOS的:
medicalGPT

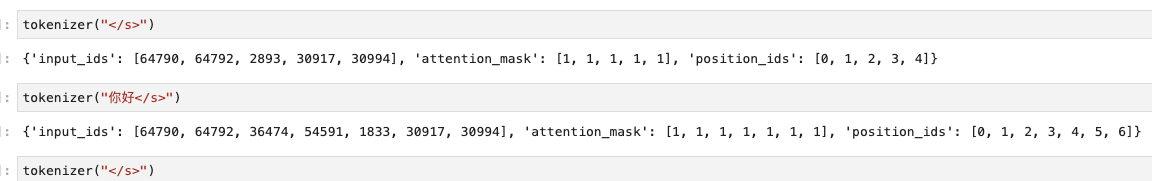
尝试一下直接用喂给tokenizer,看看tokenizer会怎么处理。

tokenize_s

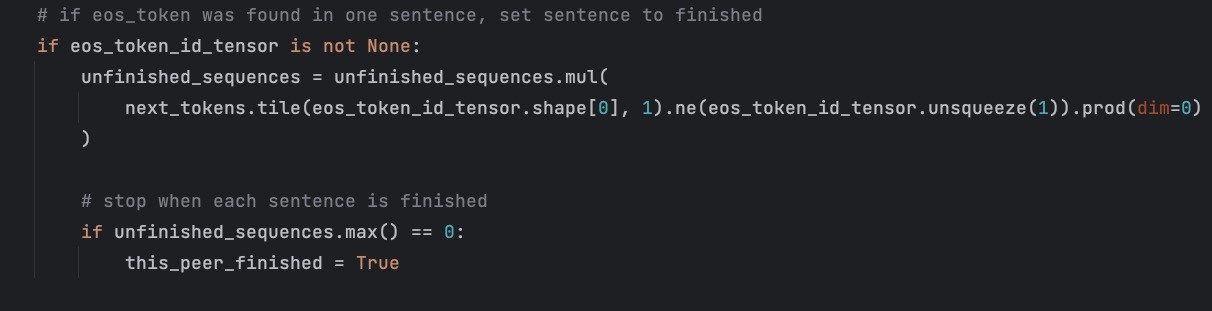
看到这原因的就很明显了,因为这个EOS添加的是字符,而不是token_id,所以tokenizer有时候会把当成了分开的token,比如</和s和>,模型就把这3它当成了三个token,而不是一个token,所以在推理的时候,遇到结尾,有时候就会输出</+s+>。而transformers的库在推理看一个句子是否以EOS结尾,看的是token_id而不是token。就会认为生成还没有结束,就继续生成了,直到某一次推理,模型想起来预训练时的记忆,在遇到结尾的时候输出了2的token id(也就是),transformers库才会认为生成结束,停止生成。
transformers

既然知道了问题的原因,那么就需要解决这个问题,解决的方法也很简单,就是把EOS token_id添加到输入中,而不是字符。具体代码就是按照PTuning的方式,把EOS token_id添加到输入中。
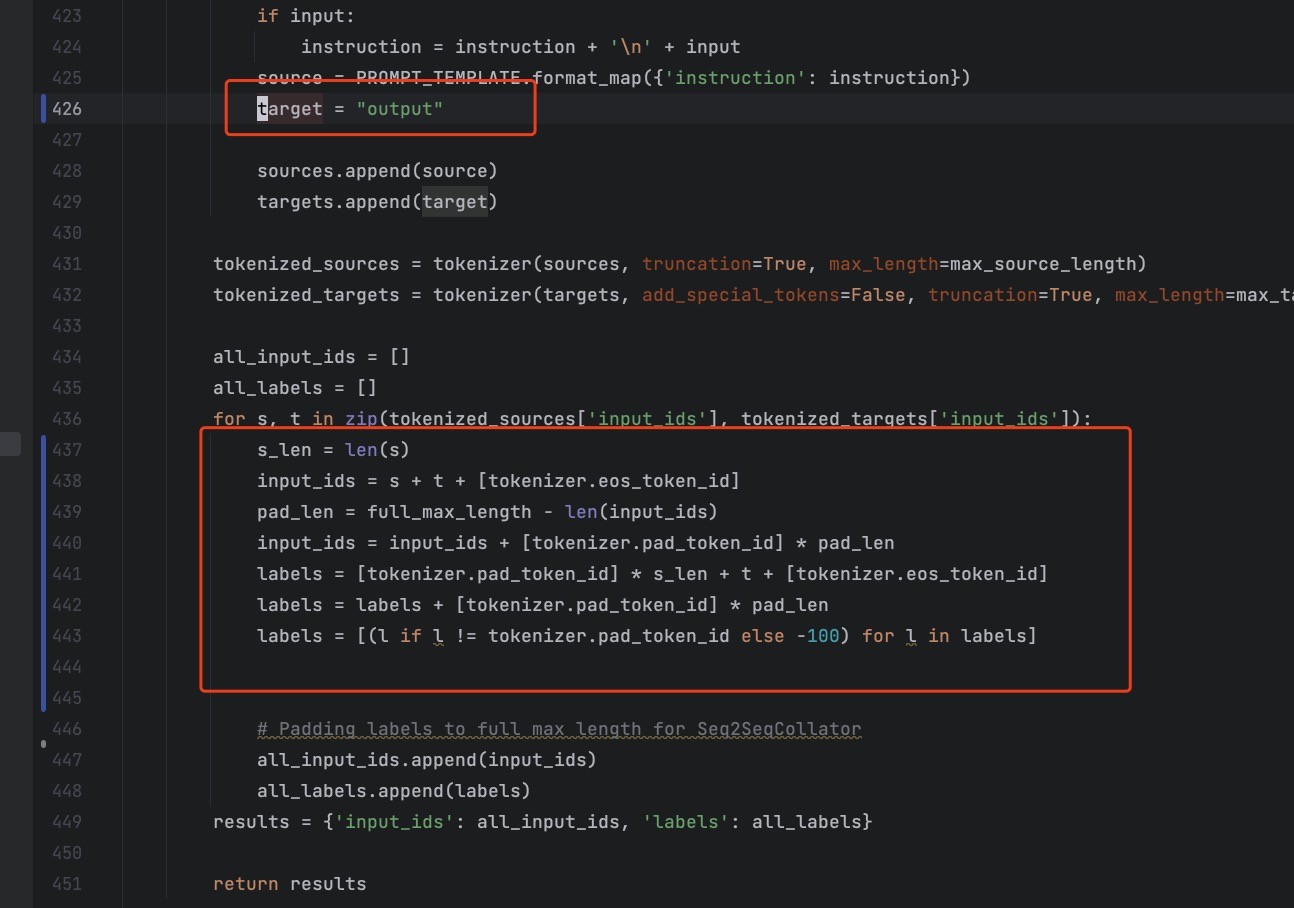
refactor

改完之后重新train一遍LoRA,模型不再疯狂输出了。

尾声
要改这个bug,其实需要挺多tokenization的知识的,最近没有时间好好研究,之后有时间再来补充一下。

大语言模型停机机制:EOS Token与Max Token的工程原理 大语言模型的生成终止并非基于语义理解,而依赖于底层token级的确定性信号。其核心是结束符(EOS Token)——如</s>、<|im_end|>等特殊控制符号,模型通过训练数据中高频共现模式学会预测该token;配合外在的max token长度限制,构成双重停机保障。这种设计兼顾了推理效率、部署稳定性与工程可控性,广泛应用于API调用、RAG系统及Agent编排等场景。理解EOS token的embedding表征、tokenizer切分逻辑及stop参数配置方式,是实现精准输出、避免截断或冗余的关键基 阅读详情

相关推荐

我的 LLM 停不下来生成内容,怎么解决?

在对大型语言模型(LLM)进行数据微调后,你可能会发现模型不知道何时停止生成标记。虽然最初的标记能恰当回应你的提示,但模型会持续生成无关标记,直到达到最大序列长度。这是个非常普遍的问题。当序列结束(EOS)标记未正确配置时就会出现此问题。这种情况可能发生在 Llama 3、Qwen2 等众多 LLM 模型上。正确配置 EOS 标记进行微调可能具有挑战性,通常需要多次迭代才能找到有效解决方案。本文提出并实施了三项简单测试来诊断 EOS 标记问题。

人工智能领域专家 1889

大模型是如何知道何时停止生成的?

EOS 是 “End of Sequence”(序列结束)的缩写。就像我们写文章会用句号来结束句子,大模型使用一个特殊的标记——EOS Token 来表示"我说完了"。</s>或<|end|>ChatGLM:对应的数字 ID 是 2大模型知道何时停止,主要依靠的是 EOS Token 这个"句号"。通过在训练时学习什么时候应该结束,模型能够在生成时做出合理的停止决策。而最大长度限制则作为一个保险机制,确保模型不会无限制地输出下去。

weixin_43674266的博客 2854

国产数据库迁移必看:达梦到ES的CDC方案优化全记录(含完整代码)

本文详细记录了从达梦数据库到Elasticsearch的CDC方案优化全过程,涵盖触发器方案局限性、Debezium架构优势及完整代码实现。通过Flink集成和性能调优,实现毫秒级延迟同步,显著降低数据库负载,为国产数据库迁移提供可落地的技术方案。

weixin_29079671的博客 499

Transformers 库中的 Tokenizer 使用

使用 Transformers 库的 Tokenizer 时发现的一些问题,并给出解决措施。

wtfloser的博客 2万+

Stata新手避坑:用reghdfe搞定行业、地区多重固定效应,告别‘共线性’报错

本文详细介绍了如何使用Stata中的reghdfe命令高效处理多重固定效应问题,解决传统方法在面板回归中遇到的共线性报错和低R²问题。通过实战案例和高级技巧,帮助新手快速掌握行业、地区等多维固定效应的控制方法,提升经济学和金融学研究的分析效率。

weixin_30635053的博客 420

树莓派4B网线直连Windows全流程:从IP查询到SSH登录避坑指南

本文提供了一份详细的树莓派4B通过网线直连Windows电脑的实战指南。核心步骤包括配置Windows网络共享、查询树莓派IP地址以及通过SSH进行安全登录与初始配置。文章深入解析了直连的网络原理,并重点分享了使用CMD命令和工具定位IP、避免常见错误的避坑技巧,帮助用户在没有显示器或路由器的环境下快速完成树莓派初始化。

grape的博客 1081

tokenizer.pad_token = tokenizer.eos_token这句话是什么意思?

tokenizer.pad_token = tokenizer.eos_token 这个设置的意思是指定填充标记(pad_token)使用结束标记(eos_token)。一般如果我们的模型使用了 [SEP] 标记,那么设置填充标记也为 [SEP] 会使模型处理填充部分的表示更加连贯,效果会更好。所以,这个设置就是指定我们使用 [SEP] 标记来进行补充填充,而不是默认的 [PAD] 标记。因为输入序列只有7个标记,不足 max_length=10,所以添加了3个[SEP]填充标记来补充。

kewei chen 7572

C#创建COM组件,QT调用COM组件简单测试(VS2008+QT4.6.4)

一. C#创建组件: 1. VS2008新建一个项目,选择Visual C#, Class library 修改Properties下面的AssemblyInfo.cs文件,ComVisible属性设置为True,即:[assembly: ComVisible(true)] 2. 右击项目,选择“属性”, 选择“生成”选项卡,把“为COM互操作注册”勾选上 选择“签名”选项卡,把“

3517

生成模型特殊标记含义

这些特殊标记有助于控制文本生成的结构和格式。它们在训练和推断时使用,以便模型能够识别生成文本中的不同部分,并且可以更好地理解任务的要求。在具体的应用中,这些标记的具体取值可以根据需要进行自定义,但通常采用的约定是使用特殊的标记字符串,如。在使用生成模型生成文本时,可以将。当生成模型生成句子时,可以将。在生成长篇文本时,可以将。插入到输入文本的开头,以指示模型开始生成新的句子。插入到段落的结尾,以指示模型生成新的段落。插入到句子的末尾,以指示模型停止生成。是在文本生成任务中常用的特殊标记。

i++; 5225

040、未来展望:MLIR与编译技术的演进方向

MLIR不是又一个编译框架,它更像是一套“元框架”——提供构建专用编译工具的能力。未来几年,我们会看到更多垂直领域(自动驾驶、射频信号处理、生物计算)出现基于MLIR的专用编译器,它们可能不会挂“MLIR”的名字,但内核都是这套可扩展的IR基础设施。不要等MLIR“成熟”再用,现在就该把它当成一把瑞士军刀,先挑刀口最锋利的那个功能(比如图优化、循环变换)用起来。编译技术的演进不再是学术界的独角戏,而是越来越贴近实际生产中的异构、动态、领域专用需求。

m0_50546716的博客 175

第14.11章 高翔博士最新开源框架Lightning-LM源码解读(十一):离线定位模块全解析,从激光匹配到位姿图优化的极致优化

本文介绍了Lightning-LM离线定位模块的技术架构与实现细节。该模块基于3D激光雷达与IMU融合,采用改进版NDT匹配算法实现高精度定位,具备动态图层更新、多源信息融合等特性。核心流程包括数据预处理、激光里程计处理、IMU预测与点云去畸变、位姿图优化等环节,通过轻量级miao库实现高效增量优化。文章详细解析了模块的代码结构、关键函数功能及数据流,为SLAM系统的开发与优化提供了实践参考。

行知SLAM 375

Beam Search介绍与代码梳理(transformer、tensor2tensor)

最近在学transformer,tensor2tensor库中用了beam search(束搜索),了解了下束搜索的原理,但是实现中还是有很多细节问题需要梳理。

qq_41809534的博客 5128

SPD-Conv+YOLOv8:空间深度转换卷积赋能小目标检测,从原理到实战的科研级优化指南

从理解SPD-Conv“空间到深度+逐步卷积”的核心设计,到亲手将其嵌入YOLOv8并验证在小目标场景的表现,再到基于此探索属于自己的科研与工程方向——这个过程能让你深刻理解“小目标特征保留”在检测任务中的核心价值。现在就开始行动,相信你会在小目标检测的“细节捕捉”之路上,走出一条属于自己的技术路径。实验通常会证明:嵌入SPD-Conv后,YOLOv8在小目标AP上提升5-8个百分点,mAP50-95提升3-5个百分点,而推理速度仅下降5%以内,充分体现了其“保细节+提精度”的优势。

m0_64661770的博客 163

EOS源码分析(6)Token

# Token(通证)区块链一直就有币圈和链圈之分,币圈的人有的埋头挖矿,有的专卖矿机,有的专心炒币,还有的搬砖套利做交易。而链圈的人则更关注区块链技术研发及应用。之前这两个圈子间相互鄙视,谁也看不起谁,币圈的人鄙视链圈贫穷,装清高;链圈的人鄙视币圈只知道炒作投机,唯利是图。但这一切都已成为过去,2015年末,以太坊的上线为两圈融合提供了可能,通过以太坊发行自己的Token(也就是常说的发币,后续...

尹成的技术博客 1740

YOLO26优化:特征融合 | 一种新颖的多尺度特征融合iAFF,适配小目标检测

在YOLO26中如何使用:iAFF加入Neck替代Concat;

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 270

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

千元内的AI艾克斯开发板,也能跑GPT模型推理了!

本次文本生成任务的输入为一个自然语言的序列,在此基础上,GPT-2模型会生成相关内容的长文本。由于自然语言处理模型通常将一个分词的列表作为标准输入,一个分词通常是将一个单词映射成的一个整数值。因此,为了提供正确的输入,我们使用词汇表文件来处理映射。

m0_59448707的博客 2100

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

huggingface generate函数简介

函数的一些重要参数,它们控制了生成过程的各个方面,如起始输入、序列长度、解码策略、采样行为等。根据具体任务和需求,适当调整这些参数可以获得更好的生成效果。函数是用于生成文本序列的核心函数。它通常应用于自然语言生成任务,如机器翻译、文本摘要、对话系统等。其他参数可以使用默认值,除非你有特殊的需求。合理设置这些参数对于获得良好的生成效果非常重要。在 Hugging Face Transformers 库中,通常,你只需要根据任务需求设置。和生成策略相关参数(

鲨鱼儿的博客 1万+

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

大模型基础:unk_token、bos_token、eos_token、pad_token

本文介绍了自然语言处理中的四种特殊标记:unk_token(未知标记,用于词汇表外的词)、bos_token(序列开始标记)、eos_token(序列结束标记)和pad_token(填充标记)。这些标记在文本处理中起关键作用,如批量处理时统一序列长度。文中还提供了使用Hugging Face的AutoTokenizer查看这些标记的代码示例,并说明当pad_token缺失时可将其设置为eos_token。这些标记对模型训练和文本生成任务至关重要。

zfjBIT的专栏 570

transformers.generator_utils函数源码解析之beam_search

#beam_search主体函数 while True: model_inputs = self.prepare_inputs_for_generation(input_ids, **model_kwargs) #整理下一步decoder所需数据 outputs = self( **model_inputs, return_dict=True, output_attentions=output_attentions, o.

yangyanbao8389的博客 2181

DeepSeek 部署中的常见问题及解决方案001

DeepSeek 是一款先进的大语言模型,在部署过程中可能会遇到各种问题。:响应包含额外标签或格式不符。:模型加载失败,报错。:生成文本重复或不连贯。:多个请求导致显存溢出。:API调用超时错误。

老韩的Linux云计算架构师进阶之路 1069

mT5_multilingual_XLSum结束令牌配置:eos_token参数详解

在自然语言处理(NLP)的文本生成任务中,结束令牌(End-of-Sequence Token,简称eos_token)扮演着至关重要的角色。它就像是文本生成过程中的"停止信号",告诉模型何时应该停止生成新的词汇。对于多语言摘要生成模型mT5_multilingual_XLSum来说,正确配置eos_token参数不仅影响生成文本的质量,还直接关系到模型的性能和用户体验。 ## eos_toke...

gitblog_00017的博客 1387

Android-多线程:Handler、Looper、Message原理详解

1.职责与关系 2.消息循环 3.线程与更新 4.几点小结 -------------------------------------------------------------------------------------------------- 1)接下来,我们开始这部分的内容,首先了解一下各自的职责及相互之间的关系。 职责 Message:消息,其中包含了消息ID,消...

weixin_30686845的博客 186

torchetext处理数据

利用Torchtext处理文本数据torchtextFieldclassificationtranslationDatasetclassificationtranslationBucketIterator 参考资料:官方文档: pytorch. torchtext torchtext主要包含三部分,分别是Field、Dataset和Iterator三部分,每部分的作用如下: Field:配置对数据的预处理信息,比如指定分词方法、是否是序列、指定起始字符和结束字符等等。 Dataset:用于加载数据集。 I

weixin_38792559的博客 725

精准控制AI生成:DeepSeek-V3的eos_token_id与max_new_tokens协同策略

你是否遇到过AI生成文本时突然中断或长篇累牍的问题?在使用DeepSeek-V3进行文本生成时,这两个关键参数——`eos_token_id`(结束标记ID)和`max_new_tokens`(最大新标记数)共同决定了生成内容的边界。本文将深入解析这两个参数的协同工作机制,帮助你精准控制AI输出的长度和完整性。 读完本文你将掌握: - 如何通过参数组合避免生成内容截断或溢出 - 两种终止条件的优...

gitblog_00193的博客 709

AI智能体研发之路-模型篇(二):DeepSeek-V2-Chat 训练与推理实战

本文首先针对deepseek-v2-chat这个大模型价格屠夫的模型特点和技术架构进行介绍,之后以LLaMA-factory为训练和推理框架,进行SFT微调训练和Infer推理测试。 deepseek-v2-chat巧妙的将attention注意力机制和MoE网络架构与大模型相结合,通过模型算法与架构的升级,提升了推理和训练效率,最终呈现的就是成本的优化和商业市场价值的转化。是一个典型的通过技术创新直接创造商业价值的案例。值得互联网从业人员学习!

人工智能领域博客 8781
上一篇: 如何定制一个智能洒水装置(养狗/养花人士请进)
下一篇: 喝个水也要整智能家居?
boydfd
博客等级 码龄16年 101粉丝 92原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值