python:sklearn 决策树(Decision Tree)

Python机器学习-Sklearn-decision tree ML 阅读详情

5. 决策树(Decision Tree) - 第5章

算法思想:基于信息增益(ID3)或基尼不纯度(CART)递归划分特征。

编写 test_dtree_1.py  如下

# -*- coding: utf-8 -*-
""" 5. 决策树(Decision Tree) """
from sklearn.datasets import load_breast_cancer
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import train_test_split

# 加载 乳腺癌数据
data = load_breast_cancer()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)

model = DecisionTreeClassifier(criterion='entropy', max_depth=3)
model.fit(X_train, y_train)
print("Accuracy:", model.score(X_test, y_test))

Anaconda 3
运行 python test_dtree_1.py 
 Accuracy: 0.9736842105263158


编写  test_dtree_2.py  如下

# -*- coding: utf-8 -*-
""" 5. 决策树(Decision Tree) """
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn import preprocessing
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import confusion_matrix,accuracy_score
from sklearn.tree import plot_tree

# 加载鸢尾花数据集
iris = datasets.load_iris()
X = iris.data
y = iris.target
f_names = iris.feature_names
t_names = iris.target_names

# 数据预处理:按列归一化
X = preprocessing.scale(X)
# 切分数据集:测试集 20%
X_train,X_test,y_train,y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 初始化 决策树 分类模型
dtc = DecisionTreeClassifier()
# 模型训练
dtc.fit(X_train,y_train)
# 模型预测
y_pred = dtc.predict(X_test)
# 模型评估
# 混淆矩阵
#print(confusion_matrix(y_test,y_pred))
print("准确率: %.4f" % accuracy_score(y_test,y_pred))

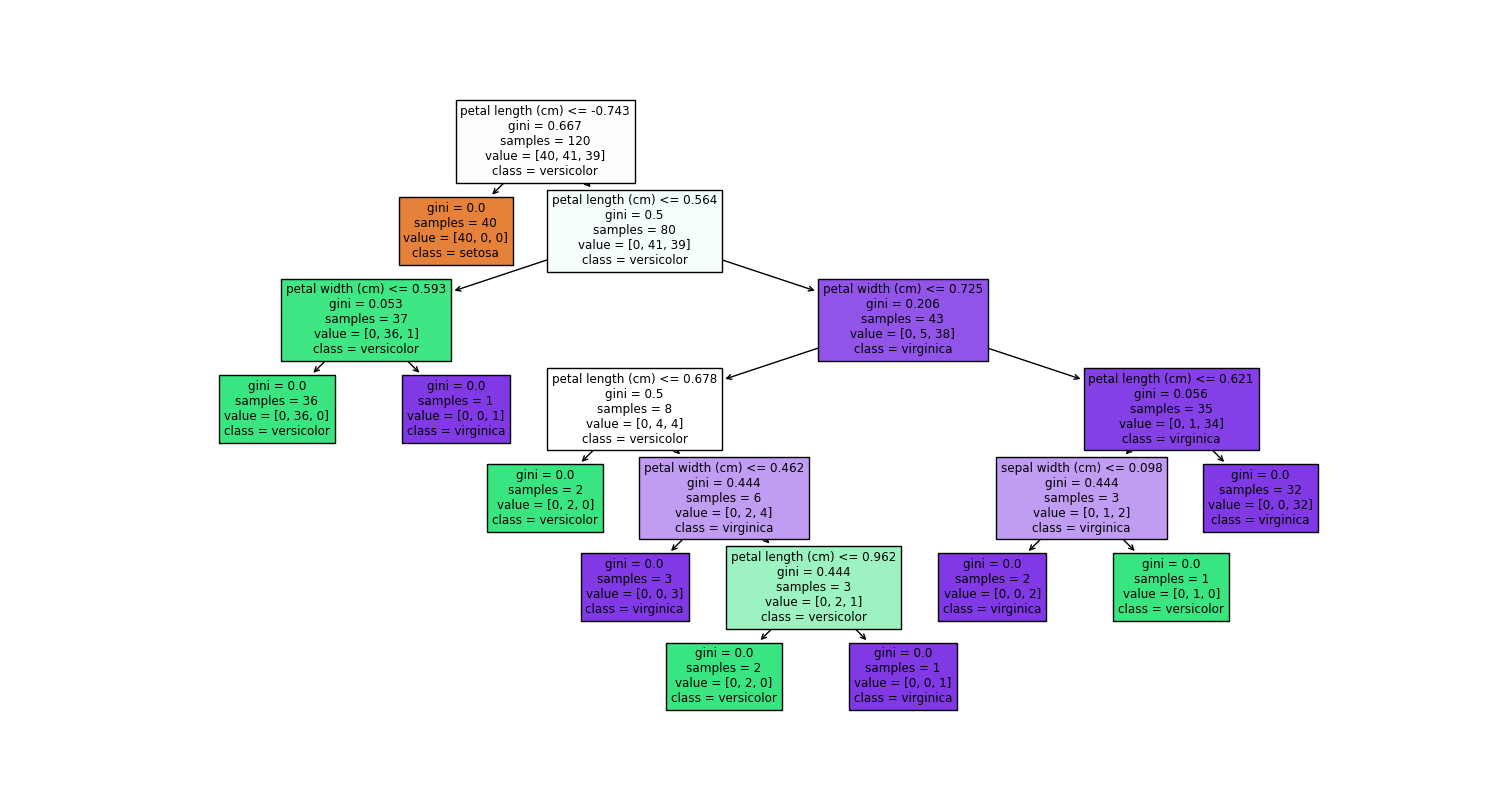
# 可视化决策树
plt.figure(figsize=(12,10))
plot_tree(dtc, feature_names=f_names, class_names=t_names, filled=True)
plt.show()

 运行 python test_dtree_2.py 
一文速学数模-分类模型(二)决策树(Decision Tree)算法详解及python实现 前言 本人大数据专业初入大三刚刚接触机器学习这一课程,最近在学习这本书《机器学习实战》,第三章的内容就是决策树,概念非常简单,但是实现的话根据不同聚类情况要做出不同调整会有些许难。当然初入一些算法和机器学习的一些库还不是很熟练掌握,有待提升自己的编程结合能力。在此领域本人有诸多不明确疑问,可能文章会有些许错误,望大家在评论区指正,本篇文章错误将会不断更正维护。 提示:以下是本篇文章正文内容,下面案例可供参考 一、决策树概述 决策树(Decision Tree)是在已知各种情况发生概率的基础上,... 阅读详情

相关推荐

纯手写GBDT三合一实现:回归/二分类/多分类全链路Python代码+每棵树可视化

从零开始用Python逐行实现GBDT算法,覆盖回归、二分类、多分类三大任务场景。核心模块分工明确:gbdt.py构建提升框架,decision_tree.py实现CART树分裂与剪枝逻辑,loss_function.py封装平方误差、对数损失、Softmax交叉熵及其梯度计算,tree_plot.py调用Graphviz导出每轮生成的决策树结构图(含NO.1_tree.png至NO.5_tree.png及all_trees.png等可视化结果)。所有关键步骤——残差计算、负梯度拟合、学习率加权、叶子节点值

tgb34567890的博客 208

【python库学习】 sklearn中的决策树Decision Trees

本库的决策树通过分段常数逼近目标分布,深度越大,其分段越细致,同时复杂度越大,拟合越好,过拟合风险上升。决策树易于理解与解释,且生成的决策树可以可视化;无需做数据标准化处理,空值剔除等,注意的是本库不支持缺失值;其拟合时间复杂度是0(logN) N为样本数;可以处理多输出问题,可以同时接受连续值与类别型数据,注意本库不支持类别型数据;对数据假设要求不严格,在部分违反下,表现仍然不错。当然根据决策树的原理,也有一些缺点,一是不加限制会学到复杂的树结构,需要注意控制过拟合问题;

qq_38142901的博客 5489

大疆C板使用C610电调驱动M2006电机(hal库)

大疆C板使用C610电调驱动M2006电机,以及遇到代码没问题,但是电机死活不转的处理

qq_46210601的博客 6020

python实现-决策树2-sklearn

李航统计学习方法python实现-决策树2-sklearn

Sun123234的博客 1270

BIOS更新后PIN不可用怎么办?从原理到实操的完整修复指南

在计算机维护中,BIOS更新是常见的固件升级操作,但其引发的登录异常却常让用户措手不及。Windows Hello PIN并非传统密码,它通过TPM芯片与设备启动环境(PCR状态)强绑定,一旦主板固件或安全启动配置改变,TPM便会拒绝释放密钥,导致“由于此设备上的更改,你的PIN不再可用”。理解这一原理后,恢复路径清晰可控:优先尝试密码登录,或通过WinRE替换utilman.exe创建临时管理员,必要时还需处理BitLocker恢复密钥。本文面向系统维护与数据安全场景,系统梳理PIN失效的恢复流程与避坑方

weixin_31364787的博客 365

LabVIEW小白福音:手把手教你用NI采集卡搭建振动信号采集系统(附源码和避坑指南)

本文为LabVIEW初学者提供详细的NI采集卡振动信号采集系统搭建指南,涵盖硬件连接、驱动安装、信号处理及性能优化等关键步骤。特别针对振动信号采集系统中的常见问题提供解决方案,并附源码和避坑指南,帮助用户快速上手并避免常见错误。

weixin_30485379的博客 103

决策树Python代码[sklearn]

【代码】决策树Python代码[sklearn]

qq_44992157的博客 774

价值投资/指标选股(akshare)

利用akshare的数据源,可以获取所有的股票数据以及公开的财务数据,可以进行条件筛选,获取满足条件的股票。 这套模板可以用于价值投资,指标选股。选股周期为日线级别。然后结果可以邮箱发送。 import time import akshare as ak ## A 股上市公司的实时行情数据 stock_zh_a_spot_df = ak.stock_zh_a_spot() #print(stock_zh_a_spot_df) ##取前300测试 ##取前300测试 df_stock =...

qq_26742269的博客 1万+

sklearn的系统学习——决策树分类器(含有python完整代码)

scikit-learn,又写作sklearn,是一个开源的基于python语言的机器学习工具包。它通过NumPy, SciPy和Matplotlib等python数值计算的库实现高效的算法应用,并且涵盖了几乎所有主流机器学习算法。scikit-learn中文社区Scikit-learn(以前称为scikits.learn,也称为sklearn)是针对Python 编程语言的免费软件机器学习库。它具有各种分类,回归和聚类算法,包括支持向量机,随机森林,梯度提升,k均值和DBSCAN。......

weixin_44904136的博客 1万+

CentOS8静默安装Oracle11.2.0.1

背景 新安装oracle,用静默安装方式就不需要安装图形界面了,省时省力。 前期准备工作与图形化安装一样,如创建用户|用户组、环境变量、内核参数、创建目录等. 可参考图形化安装,链接:https://blog.youkuaiyun.com/heroicpoem/article/details/104229369 环境 平台 版本 操作系统 centOS 8 Oracle 11gR2 1.响应文件 响应文件的内容就是图形化安装时手工设置的选项内容。 解压后,database/response/db

heroicpoem的专栏 4518

【逆向实战】Unity游戏资源提取与解密全攻略:从AssetBundle到libil2cpp.so的破解技巧

本文详细介绍了Unity游戏资源提取与解密的完整流程,涵盖从AssetBundle到libil2cpp.so的破解技巧。通过AssetStudio和Il2CppDumper等工具,读者可以学习如何提取未加密资源、处理加密文件,并掌握动态dump技术。文章还提供了自动化脚本编写和常见问题解决方案,帮助逆向工程爱好者高效完成资源提取任务。

weixin_29012765的博客 1048

决策树decision tree原理介绍_python sklearn建模_乳腺癌细胞分类器(推荐AAA)

sklearn实战-乳腺癌细胞数据挖掘(博主亲自录制视频) https://study.163.com/course/introduction.htm?courseId=1005269003&utm_campaign=commission&utm_source=cp-400000000398149&utm_medium=share 医药统计项目可...

weixin_30408739的博客 1135

vue接入海康4G版摄像头通过萤石云平台推送视频流教程

vue-video-player接入海康视频,videojs-contrib-hls,vue播放视频

renkai721的专栏 7278

python_sklearn机器学习算法系列之Decision_tree(决策树算法)-DecisionTreeClassifier

       本文主要目的是通过及其简单的小程序来快速学习python 中sklearn的DecisionTreeClassifier这一函数的基本操作和使用,注意不是用python纯粹从头到尾自己构建DecisionTreeClassifier,既然sklearn提供了现成的我们直接拿来用就可以了,当然其原理十分重要,这里仅给出最核心部分:1)树以代表训练样本的单个结点开始。2)如果样本都在同一...

爱吃火锅的博客 1万+

人工智能训练师三级考试大纲深度解读|理论+实操分值分布+六大模块占比

三级人工智能训练师考试分为理论和实操两大模块(各100分,合格线60分)。理论考试包含AI基础(30%)、数据标注(25%)、模型训练(20%)、测试(15%)和系统运维(10%),题型为客观题;实操考核侧重数据标注(40%)、模型测试(35%)和系统运维(25%),采用现场操作形式。复习应优先关注AI基础和数据标注等高分值模块,实操需重点掌握标准流程和结果准确性(占评分70%)。考试要求两模块均达标,理论侧重概念理解,实操强调规范执行与文档完整。

白话机器学习 1096

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

决策树 python sklearn_Python_sklearn机器学习库学习笔记(四)decision_tree(决策树)...

# 决策树import pandas aspdfromsklearn.tree import DecisionTreeClassifierfromsklearn.cross_validation import train_test_splitfromsklearn.metrics import classification_reportfromsklearn.pipeline import Pip...

weixin_39927059的博客 143

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

python决策树sklearn_Python_sklearn机器学习库学习笔记(四)decision_tree(决策树)...

# 决策树import pandas as pdfrom sklearn.tree import DecisionTreeClassifierfrom sklearn.cross_validation import train_test_splitfrom sklearn.metrics import classification_reportfrom sklearn.pipeline impor...

weixin_39916549的博客 320

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

python - 决策树

决策树(decision tree)是一种基本的分类与回归方法。分类决策树模型是一种描述对实例进行分类的树形结构。决策树由结点(node)和有向边(directed edge)组成。结点有两种类型:内部结点(internal node)和叶结点(leaf node)。内部结点表示一个特征或属性,叶结点表示一个类。 参考:决策树基础篇 https://cuijiahua.com/blog/201...

rojyang的博客 332

python决策树分类器_决策树decision tree原理介绍_python sklearn建模_乳腺癌细胞分类器(推荐AAA)...

机器学习,统计项目可联系QQ:231469242决策树优点和缺点决策树优点1.简单易懂,很好解读,可视化2.可以变量筛选 缺点1.决策树不稳定,容易过渡拟合2.决策树用的贪婪算法,返回局部最优,而非全局最优,最后得到有偏见的树(用随机森林改善) 分类树VS回归树回归树应用场景:变量是连续性的,使用平均数参数分类树应用场景:变量是分类型的,使用众数参数树的延伸太多,会造成过渡拟合,返回局部最优,即对...

weixin_39662955的博客 474

Python_sklearn机器学习库学习笔记(四)decision_tree(决策树)

# 决策树 import pandas as pd from sklearn.tree import DecisionTreeClassifier from sklearn.cross_validation import train_test_split from sklearn.metrics import classification_report from sklearn.pi...

weixin_34387468的博客 135

Agent异常处理实战:三种策略保障项目稳定

在AI Agent工程化中,异常处理往往比业务逻辑更能决定系统的稳定性。Agent执行链路涉及模型推理、工具调用与多轮循环,任何环节的瞬时故障或解析失败都可能导致任务中断。传统try-catch难以应对动态路径下的复杂异常,工程上需要一套组合策略。本地捕获与结构化记录确保异常可观测,重试与指数退避能有效应对API超时和限流等瞬时故障,而CompletableFuture异步编排则通过exceptionally、handle等方法实现子任务故障隔离与降级恢复。这些技术不仅适用于Java技术栈,也可在Sprin

weixin_34168880的博客 488

Python小白记录2:Decision Tree中tree.plot_tree参数解释

1.参考网站:sklearn.tree.plot_tree — scikit-learn 1.0 documentationhttps://scikit-learn.org/stable/modules/generated/sklearn.tree.plot_tree.html2. 中英文解释(自己 Parameters: 1. decision_tree:decision tree regressor or classifier #决策树 2. max_depth:int, default=No..

chanwoyee1的博客 7378

python的模块导入问题_Python import 模块导入问题

最近在用Python做决策树(Decision tree)时, 遇见了一个以前没有遇到的问题,就是用'import sklearn.tree'时一切正常,但是'import sklearn..... sklearn.tree'时却报错说: AttributeError: 'module' object has no attribute 'tree'.python的导入机制是这样的,在用 'impo...

weixin_39830012的博客 186

python处理grd格式文件_GBDT原理及利用GBDT构造新的特征-Python实现

背景Gradient BoostingGradient Boosting是一种Boosting的方法,它主要的思想是,每一次建立模型是在之前建立模型损失函数的梯度下降方向。损失函数是评价模型性能(一般为拟合程度+正则项),认为损失函数越小,性能越好。而让损失函数持续下降,就能使得模型不断改性提升性能,其最好的方法就是使损失函数沿着梯度方向下降(讲道理梯度方向上下降最快)。Gradient Boos...

weixin_39929259的博客 801

神经网络 python sklearn_Python-sklearn常用算法分类以及调用列表

总的来说,Sklearn可实现的函数或功能可分为以下几个方面:分类算法回归算法聚类算法降维算法文本挖掘算法模型优化数据预处理最后再说明一下可能不支持的算法(也可能是我没找到,但有其他模块可以实现)分类算法线性判别分析(LDA)>>> from sklearn.discriminant_analysis import LinearDiscriminantAnalysis >&...

weixin_39758953的博客 1104

Python实战:用sklearn和matplotlib绘制决策树(附完整代码与图像优化技巧)

本文详细介绍了如何使用Python的sklearn和matplotlib库绘制决策树,包括环境准备、数据加载、模型构建、基础与高级可视化实现,以及决策树解读和优化技巧。通过完整的代码示例和图像优化建议,帮助读者快速掌握决策树可视化技术,提升模型解释能力。

weixin_30955617的博客 401
上一篇: python:mido 提取 midi文件中某一音轨的音乐数据
下一篇: python:sklearn 主成分分析(PCA)
belldeep
博客等级 码龄20年 1820粉丝 584原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

