爬虫解析Selenium 之(九) --- Selenium模块


Selenium

  elenium 是一套完整的web应用程序测试系统,

  包含:

    1. 测试的录制(selenium IDE)

    2.编写及运行(Selenium Remote Control)

    3.测试的并行处理(Selenium Grid)

  Selenium的核心Selenium Core基于JsUnit,完全由JavaScript编写,因此可以用于任何支持JavaScript的浏览器上。

  selenium可以模拟真实浏览器,自动化测试工具,支持多种浏览器,爬虫中主要用来解决JavaScript渲染问题。

selenium使用

 1 # 从selenium中导入webdriver
 2 from selenium import webdriver
 3 from time import sleep
 4 
 5 # 创建一个浏览器驱动对象
 6 browser = webdriver.Chrome(executable_path=r"/Users/guoyapeng/Downloads\chromedriver")
 7 print(browser) # <selenium.webdriver.chrome.webdriver.WebDriver (session="48509673bcc1473b2165e9db6f3593bc")>
 8 
 9 # 用浏览打开一个网页
10 browser.get("https://www.baidu.com/")
11 sleep(1)
12 
13 # 查找页面上的某个标签元素
14 # news = browser.find_elements_by_class_name
15 news = browser.find_element_by_link_text("新闻")
16 print(news)
17 # 点击
18 news.click()
19 # 向文本框中输入内容
20 input = browser.find_element_by_id("ww")
21 input.send_keys("老王")
22 browser.find_element_by_id("s_btn_wr").click()
23 
24 # 获取经过浏览器解析运行以后生成的那个html源码
25 html = browser.page_source
26 print(html)
27 # 退出浏览器
28 browser.quit()
基本使用

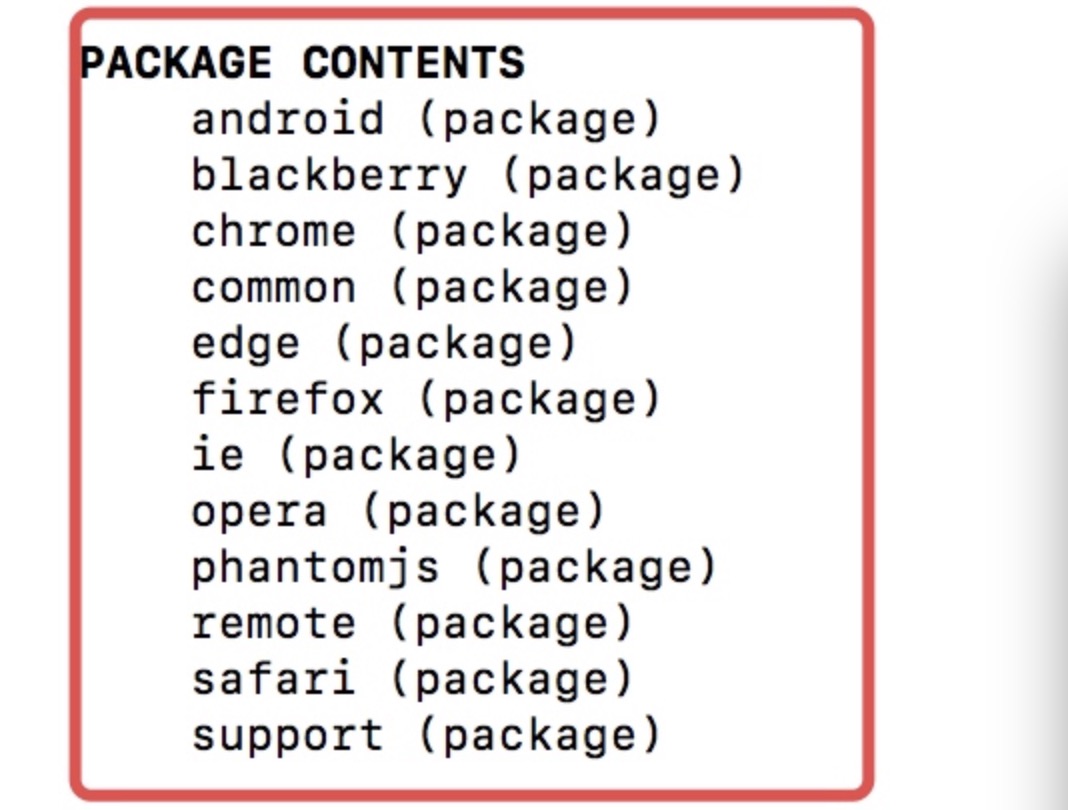
  用python写爬虫的时候,主要用的是selenium的Webdriver,我们可以通过下面的方式先看看Selenium.Webdriver支持哪些浏览器


  这里要说一下比较重要的PhantomJS,PhantomJS是一个而基于WebKit的服务端JavaScript API,支持Web而不需要浏览器支持,

  其快速、原生支持各种Web标准:Dom处理,CSS选择器,JSON等等。PhantomJS可以用用于页面自动化、网络监测、网页截屏,以及无界面测试

声明浏览器对象

1 from selenium import webdriver
2 
3 browser = webdriver.Chrome()
4 browser = webdriver.Firefox()

访问页面

1 from selenium import webdriver
2 
3 browser = webdriver.Chrome()
4 # 自动打开Chrome浏览器,并登陆百度打印百度首页的源代码,然后关闭浏览器
5 browser.get("http://www.baidu.com")
6 print(browser.page_source)
7 browser.close()

查找元素

单个元素查找

 1 from selenium import webdriver
 2 
 3 browser = webdriver.Chrome()
 4 browser.get("http://www.taobao.com")
 5 
 6 input_first = browser.find_element_by_id("q") # 第一种是通过id的方式
 7 input_second = browser.find_element_by_css_selector("#q") # 第二个中是CSS选择器
 8 input_third = browser.find_element_by_xpath('//*[@id="q"]') # 第三种是xpath选择器
 9 # 结果都是相同的
10 print(input_first)
11 print(input_second)
12 print(input_third)
13 browser.close()

  常用的查找元素方法

1 find_element_by_name
2 find_element_by_id
3 find_element_by_xpath
4 find_element_by_link_text
5 find_element_by_partial_link_text
6 find_element_by_tag_name
7 find_element_by_class_name
8 find_element_by_css_selector

  By方式是比较通用一种方式

1 from selenium import webdriver
2 from selenium.webdriver.common.by import By. # 需要By模块所以需要导入
3 
4 browser = webdriver.Chrome()
5 browser.get("http://www.taobao.com")
6 # 方式是通用的,browser.find_element(By.ID,"q")这里By.ID中的ID可以替换为其他几个
7 input_first = browser.find_element(By.ID,"q")
8 print(input_first)
9 browser.close()

多个元素查找

  多个元素和单个元素的区别:多个元素是find_elements,单个元素是find_element

1 from selenium import webdriver
2 
3 browser = webdriver.Chrome()
4 browser.get("http://www.taobao.com")
5 lis = browser.find_elements_by_css_selector('.service-bd li')
6 print(lis)    # 获得就是一个列表
7 browser.close()

  也是可以通过导入from selenium.webdriver.common.by import By 这种方式实现

  lis = browser.find_elements(By.CSS_SELECTOR,'.service-bd li')

1 find_elements_by_name
2 find_elements_by_id
3 find_elements_by_xpath
4 find_elements_by_link_text
5 find_elements_by_partial_link_text
6 find_elements_by_tag_name
7 find_elements_by_class_name
8 find_elements_by_css_selector

元素交互操作

  对于获取的元素调用交互方法

  程序会自动打开Chrome浏览器并打开淘宝输入ipad,然后删除,重新输入MakBook pro,并点击搜索

 1 from selenium import webdriver
 2 import time
 3 
 4 browser = webdriver.Chrome()
 5 browser.get("http://www.taobao.com")
 6 input_str = browser.find_element_by_id('q')
 7 input_str.send_keys("ipad")
 8 time.sleep(1)
 9 input_str.clear()
10 input_str.send_keys("MakBook pro")
11 button = browser.find_element_by_class_name('btn-search')
12 button.click()

交互动作

将动作附加到动作链中串行执行

 1 from selenium import webdriver
 2 from selenium.webdriver import ActionChains
 3 
 4 browser = webdriver.Chrome()
 5 
 6 url = "http://www.runoob.com/try/try.php?filename=jqueryui-api-droppable"
 7 browser.get(url)
 8 browser.switch_to.frame('iframeResult')
 9 source = browser.find_element_by_css_selector('#draggable')
10 target = browser.find_element_by_css_selector('#droppable')
11 actions = ActionChains(browser)
12 actions.drag_and_drop(source, target)
13 actions.perform()

执行JavaScript

  可以直接调用js方法来实现一些操作,通过登录知乎然后通过js翻到页面底部,并弹框提示

1 from selenium import webdriver
2 browser = webdriver.Chrome()
3 browser.get("http://www.zhihu.com/explore")
4 browser.execute_script('window.scrollTo(0, document.body.scrollHeight)')
5 browser.execute_script('alert("To Bottom")')

获取元素属性
  get_attribute('class')

1 from selenium import webdriver
2 
3 browser = webdriver.Chrome()
4 url = 'https://www.zhihu.com/explore'
5 browser.get(url)
6 logo = browser.find_element_by_id('zh-top-link-logo')
7 print(logo)
8 print(logo.get_attribute('class'))

获取文本值
  text

1 from selenium import webdriver
2 
3 browser = webdriver.Chrome()
4 url = 'https://www.zhihu.com/explore'
5 browser.get(url)
6 input = browser.find_element_by_class_name('zu-top-add-question')
7 print(input.text)

获取ID,位置,标签名
  id、location、tag_name、size

 1 from selenium import webdriver
 2 
 3 browser = webdriver.Chrome()
 4 url = 'https://www.zhihu.com/explore'
 5 browser.get(url)
 6 input = browser.find_element_by_class_name('zu-top-add-question')
 7 print(input.id)
 8 print(input.location)
 9 print(input.tag_name)
10 print(input.size)

略


转载于:https://www.cnblogs.com/TMMM/p/10840981.html

Python网络爬虫模拟登录与验证解析 在互联网上存在大量需要登录才能访问的网站,要爬取这些网站,就需要学习爬虫的模拟登录。对于一个需要登录才能访问的网站,它的页面在登录前和登录后可能是不一样的。 阅读详情

相关推荐

五分钟学会Python网络爬虫

但不管怎样,爬虫技术是无罪的,还是值得我们开发人员去学习了解一下的。在学习之前,我们还是要先了解一下相关概念。 什么是爬虫 网络爬虫:又被称为网页蜘蛛,网络机器人,是一种按照一定的规则,自动的抓取万维网信息的程序或者脚本。 大数据时代,要进行数据分析,首先要有数据源,可数据源从哪里来,花钱买,没预算,只能从其它网站就行抓取。 细分下来,业内分为两类:爬虫和反爬虫。 反爬虫:顾名思义,就是防止你来我网站或APP上做爬虫的。 爬虫工程师和反爬虫工程师是一对相爱相杀的小伙伴,经常因为对方要加班写代码,

python588的博客 2355

爬虫解析Selenium 之(四) --- Selenium模块

Selenium   elenium 是一套完整的web应用程序测试系统,   包含:     1.测试的录制(selenium IDE)     2.编写及运行(Selenium Remote Control)     3.测试的并行处理(Selenium Grid)   Selenium的核心Selenium Core基于JsUnit,完全由JavaScr...

weixin_30347335的博客 185

网络爬虫和前端相关知识

初级阶段:Requests + BeautifulSoup 抓取静态页面中级进阶:Scrapy框架实现分布式爬取,Selenium处理动态内容高级对抗:逆向工程+协议破解,结合机器学习绕过验证合规边界:遵守《网络安全法》及目标网站robots.txt规则注:爬虫开发者需警惕法律风险,禁止爬取个人隐私、商业秘密等敏感数据。

2301_81499791的博客 3941

selenium下的webdriver方法,webdriver常见的操作方法

move_to_element(setting_button) 设置悬停 里面传入的定位到这个元素。ActionChains(driver):进行类的实例化传入的是打开的浏览器对象driver。perform(): 执行所有 ActionChains 中存储的行为;# print("当前网页title:", driver.title)# print("测试不通过")# print("测试通过")# print("测试通过")# print("测试失败")

colala6688的博客 641

[Python]网络爬虫总结

# [Python]网络爬虫总结 本文将对Python网络爬虫进行简要的总结,涵盖了我目前所使用的所有方法。 静态网页对于静态网页,就不多说了,太简单了。只要用requests库直接把html爬下来,然后用正则表达式匹配即可。但是到了目前互联网发展阶段,已经很少有静态网页了。如果你遇到要爬虫静态网页,那你一定是非常幸福了。动态网页动态网页是比较常见的爬虫目标,这里我给出一些比较常见的爬虫方法,仅

stary_yan的博客 1万+

如何使用PHP和Selenium快速构建自己的网络爬虫系统

近年来,随着互联网的普及,网络爬虫逐渐成为了信息采集的主要手段之一,然而,常规的爬虫技术不稳定、难以维护,市面上的纯web网页爬虫也只能在静态页面上进行操作。ChromeDriver则是Selenium中调用Chrome浏览器的驱动程序,可以使Selenium直接操作Chrome,从而实现动态页面的爬取。综上所述,本文通过介绍如何使用PHP和Selenium构建网页爬虫系统,并通过实际示例说明如何获取页面中的节点信息,该爬虫具有稳定性高、数据采集全面等优点,具有一定的应用价值。三、创建网页源码解析类。

wx_19970108018的博客 2720

selenium无法打开浏览器问题

selenium环境配置时出现的问题,希望对大家有帮助

killer_LIN的博客 6103

Claude AI实战指南:从注册到精通,突破手机验证的终极解决方案

本文提供了一份详尽的Claude AI实战指南,重点解决了国内用户注册过程中的手机号验证难题,并分享了使用技巧。文章详细介绍了如何通过虚拟手机号服务等方案完成注册,并深入解析了Opus、Sonnet、Haiku三大模型的特点与选择策略,帮助用户从注册到精通,高效利用这一安全、健谈的AI助手进行内容创作、编程开发与学习研究。

weixin_29092031的博客 1231

selenium用法详解

selenium用法详解 selenium主要是用来做自动化测试,支持多种浏览器,爬虫中主要用来解决JavaScript渲染问题。 模拟浏览器进行网页加载,当requests,urllib无法正常获取网页内容的时候 一、声明浏览器对象 注意点一,Python文件名或者包名不要命名为selenium,会导致无法导入 from selenium import webdriver #...

weixin_30241919的博客 486

从工艺到器件:用Silvaco ATLAS仿真PIN二极管击穿电压的保姆级指南

本文详细介绍了使用Silvaco ATLAS仿真PIN二极管击穿电压的全流程指南,从工艺仿真基础搭建到器件结构构建,再到击穿特性仿真和结果分析。通过Silvaco工具链,工程师可以在设计阶段精准预测器件性能,优化击穿电压,提升研发效率。

weixin_34259816的博客 355

华为数通---配置风暴控制案例

风暴控制可以通过阻塞报文或关闭端口来阻断广播、未知组播和未知单播报文的流量。

2301_77081516的博客 1624

elenium方法大全

  om.thoughtworks.selenium Interface Selenium   All Known Implementing Classes:     DefaultSelenium, WebDriverBackedSelenium   public interface Selenium   Defines an object that runs Selenium...

qq3245505的博客 330

Linux下科大讯飞离线语音识别SDK从下载到实战(附常见问题解决)

本文详细介绍了在Linux系统下,如何从科大讯飞开放平台获取离线语音识别SDK,完成环境准备、编译部署到实战开发的完整流程。文章重点解析了SDK目录结构、语法词典定制、示例代码修改,并针对开发中常见的“词典加载失败”、音频格式、交叉编译及性能优化等问题提供了深度解决方案,助力嵌入式与IoT开发者快速实现稳定可靠的离线命令识别功能。

honey的博客 1241

网络爬虫解析

网络爬虫(也称为网页蜘蛛、网络机器人)是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。网络爬虫可以用于从网站提取数据,例如监测社交媒体平台上的活动,或者从网上收集新闻和文章。它们也可以用于搜索引擎,如Google和Bing,来抓取和索引网页,以便在用户进行搜索时提供结果。URL通常由多个部分组成,包括协议类型(如HTTP、HTTPS)、主机名(域名或IP地址)、路径(资源在主机上的位置)以及可选的查询参数(用于传递额外的信息)。通过URL,用户可以方便地访问和定位到特定的网络资源。

2301_82032652的博客 2634

别再手动巡检了!用Zabbix 5.0 + SNMPv2自动监控华为S系列交换机(附完整命令集)

本文详细介绍了如何利用Zabbix 5.0与SNMPv2实现华为S系列交换机的自动化监控,告别低效的手动巡检。通过配置SNMPv2c安全基线、核心功能启用及Zabbix Server端深度配置,构建7×24小时监控体系,实时预警接口状态、流量波动等关键指标,大幅提升运维效率与故障响应速度。

weixin_30940783的博客 628

PCL 快速均匀下采样

快速均匀下采样 是一种点云降采样技术,通过设置采样步长来实现等距降采样,从而减少点的数量。用户可以通过指定步长,选择每隔一定数量的点采样一个点,这样可以在保持点云几何特性的同时,显著减少点的数量。

纵马踏花向自由 870

从入门到精通:网络爬虫开发实战总结

学习是一种持续不断的过程,无论在什么领域,都需要不断地努力和探索。在这段爬虫学习历程中,我不仅获得了丰富的知识和技能,也结交了很多志同道合的朋友和粉丝,他们对我的学习和进步都提供了极大的支持和鼓励,支持我继续写下去。 总的来说,这段时间的学习和写作让我认识到了自己的不足和缺陷,也让我更加坚定了继续学习和进步的决心。我相信,在未来的学习和工作中,这段经历将成为我前行的动力和支撑。在这里,我将过去写过的爬虫文章总结一下,不仅是在爬虫学习这里留下一个里程碑,也是为了能够总结一下阶段性学习成果。

weixin_50804299的博客 6560

(五)C++自制植物大战僵尸游戏LoadingScene的实现讲解

游戏启动后就会立即切换到游戏加载场景中。只有游戏资源文件加载完成后,才能进入游戏。Loadingscene类继承Cocos2d-x中的Scene父类,表明Loadingscene是一个场景类。切换到LoadingScene场景中,首先会创建该场景,会调用函数,在该函数中调用自己定义的方法实现指定功能。代码文件的位置如下图所示。

尔灵尔亿的博客 2006

python网络爬虫爬取静态网页

网络爬虫又称网页蜘蛛、网络机器人,是一种按照一定的规则、自动请求万维网网站并提取网络数据的程序或脚本。如果说网络像一张网,那么爬就是网上的一只小电子,在网上爬行的过程中遇到了数据,就把它爬取下来。网络爬虫的常用功能:如图所示。获取大量数据,用来做数据分析公司项目的测试数据,公司业务所需数据Python做爬虫优势1、Python :请求模块、解析模块丰富成熟,强大的Scrapy网络爬虫框架2、PHP :对多线程、异步支持不太好3、JAVA:代码笨重,代码量大。

m0_74198026的博客 3272

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

快速了解网络爬虫

网络爬虫(Web Crawler),又称网络蜘蛛、网络机器人,是一种按照一定规则自动抓取互联网信息的程序或脚本。它的核心作用是模拟人类浏览网页的行为,从网页中提取结构化或非结构化数据,为数据分析、信息聚合、内容存档等场景提供数据支持。

wzdzgdf的博客 3391

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

爬虫——网页蜘蛛

大数据下的数据筛取技术

码刀攻城 1240

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

Scrapy对比Selenium:哪个最适合您的网络爬虫项目

Scrapy是一个强大且高效的开源网络爬虫框架,采用Python编写。它专为抓取网页并从中提取结构化数据而设计,具有高效、可扩展和可定制的特点,是大规模网络爬虫项目的理想之选。Selenium是一个开源的Web自动化工具,允许用户以编程方式控制Web浏览器。虽然它主要用于测试Web应用程序,但由于其能够与重度JavaScript网站交互,在Web爬虫领域也广受欢迎,这些网站使用传统方法难以爬取。需要注意的是,Selenium只能测试Web应用程序,不能用于测试任何桌面(软件)应用程序或移动应用程序。

守城小轩的技术窝棚 2312

【爬虫】基于 Selenium 的 Python 淘宝评论爬取

随着电子商务的发展,消费者评论已经成为购买决策中重要的参考因素之一。如何高效地抓取并分析大量的在线评论,成为了数据分析领域的重要课题。本文将探讨如何使用 Selenium 和 Python 自动化工具抓取网页中的评论数据,并结合技术实现分析过程。我们将详细介绍相关的抓取原理,如何利用 Selenium 库编写 Python 程序来实现这一目标,以及每段代码的详细解析。本篇文章不仅适合初学者学习如何使用 Selenium 进行网页抓取,也对有一定编程经验的读者提供了详细的技

2303_77200324的博客 5907

《Python 网络爬虫》

本文介绍了 Python 网络爬虫的基本概念、技术原理、常用工具以及实战案例,希望能够帮助读者快速掌握 Python 网络爬虫技术。在实际应用中,需要根据具体的需求选择合适的工具和方法,并注意遵守法律法规和网站的使用条款,避免对网站造成过大的负担和影响。Scrapy 是一个功能强大的 Python 爬虫框架,它提供了一套完整的爬虫开发工具,包括请求发送、网页解析、数据存储等。网络爬虫,又称为网页蜘蛛、网络机器人,是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。(一)爬取新闻网站数据。

weixin_47266126的博客 1705

【网络爬虫】

Selenium是一个开源的、便携式的自动化测试工具、它最初是为网站自动化测试而开发的,Selenium支持与主流浏览器的配合使用。网络爬虫的应用非常广泛。然后,它会解析HTML代码,提取出想要的数据,如标题、内容、链接等。urlopen不支持代理、Cookie等其他的HTTP/HTTPS高级功能,所以如果想要设置代理,不能使用自带的urlopen,而是要自定义opener。上述代码调用了urllib.resquest模块中的urlopen方法,导入了百度首页的url,使用的协议是http。

z12180534why_zyt的博客 1958
上一篇: python高级 之(五) --- 文件操作
下一篇: 爬虫解析PyQuery 之(十) --- PyQuery模块
baoding4359
博客等级 码龄11年 2粉丝 0原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值