机器学习2之回归

[机器学习-回归实例] 李宏毅机器学习作业一:PM2.5 预测实例 [机器学习-回归实例] 李宏毅机器学习作业一:PM2.5 预测实例 简介   这是一个回归预测的实例,数据集来自李宏毅的《机器学习》课程的第一次作业,可以用来训练一个线性回归模型或者其他的回归模型,动手实践学习到的理论知识,在实践中去发现问题。这篇文章主要包括数据集的解释、数据的预处理过程及线性回归模型的代码实现这三个部分。由于这个数据集并不能直接使用,还需进行一些重构,为了对初学者更友好一些,我会提供重构完的可以读取后就直接使用的数据集,我也会提供 Matlab\rm MatlabMatlab 可直接使用 阅读详情

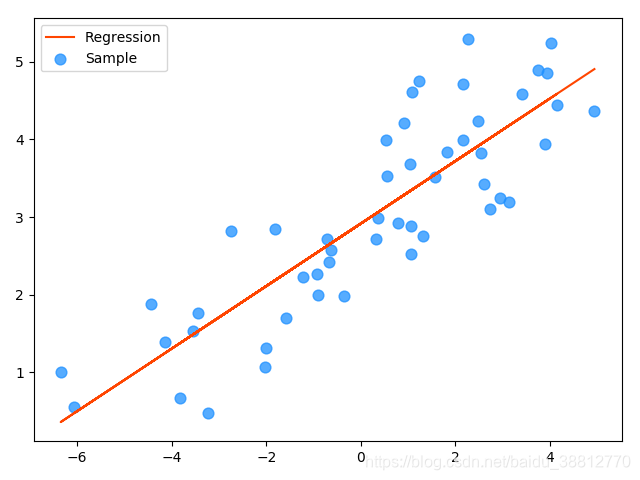
1.线性回归

# 基于线性回归训练single.txt中的训练样本,使用模型预测测试样本。
import numpy as np
import sklearn.linear_model as lm
import matplotlib.pyplot as mp
# 采集数据
x, y = np.loadtxt('../data/ml_data/single.txt',
                  delimiter=',',
                  usecols=(0, 1),
                  unpack=True)
print(x)
x = x.reshape(-1, 1)
print(x)
# 创建模型
model = lm.LinearRegression()  # 线性回归
# 训练模型
model.fit(x, y)
# 根据输入预测输出
pred_y = model.predict(x)
mp.scatter(x, y, c='dodgerblue', alpha=0.75, s=60, label='Sample')
mp.plot(x, pred_y, c='orangered', label='Regression')
mp.legend()
mp.show()

# 误差估计
import sklearn.metrics as sm

# 平均绝对值误差:1/m∑|实际输出-预测输出|
print(sm.mean_absolute_error(y, pred_y))
# 平均平方误差:SQRT(1/mΣ(实际输出-预测输 出)^2)
print(sm.mean_squared_error(y, pred_y))
# 中位绝对值误差:MEDIAN(|实际输出-预测输出|)
print(sm.median_absolute_error(y, pred_y))
# R2得分,(0,1]区间的分值。分数越高,误差越小。
print(sm.r2_score(y, pred_y))

import pickle
# 将训练好的模型对象保存到磁盘文件中
with open('../../data/linear.pkl', 'wb') as f:
    pickle.dump(model, f)

# 从磁盘文件中加载模型对象

with open('../../data/linear.pkl', 'rb') as f:
    model = pickle.load(f)
# 根据输入预测输出
pred_y = model.predict(x)
2.岭回归

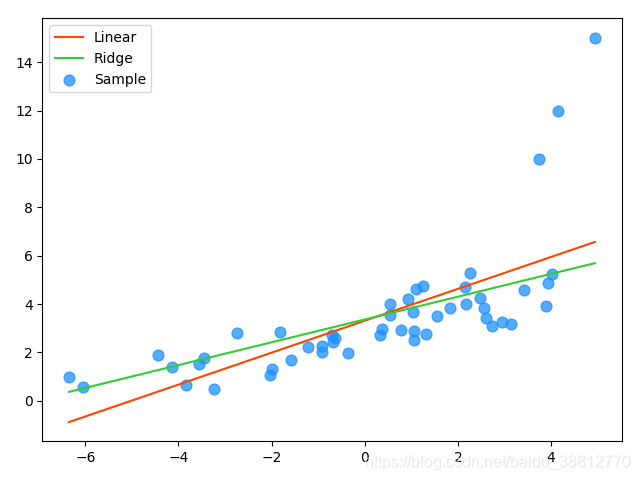
"""
异常值对模型所带来影响无法在训练过程中被识别出来。为此,岭回归在模型迭代过程
所依据的损失函数中增加了正则项
"""
# 岭回归
x, y = np.loadtxt('../data/ml_data/abnormal.txt',
                  delimiter=',',
                  usecols=(0, 1),
                  unpack=True)
print(x)
x = x.reshape(-1, 1)
print(x)

# 创建线性模型
model = lm.LinearRegression()  # 线性回归
# 训练模型
model.fit(x, y)
# 根据输入预测输出
pred_y1 = model.predict(x)
# 创建岭回归模型
model = lm.Ridge(150, fit_intercept=True, max_iter=10000)
# 训练模型
model.fit(x, y)
# 根据输入预测输出
pred_y2 = model.predict(x)
sorted_indices = x.T[0].argsort()
mp.scatter(x, y, c='dodgerblue', alpha=0.75, s=60, label='Sample')
mp.plot(x[sorted_indices], pred_y1[sorted_indices],
        c='orangered', label='Linear')
mp.plot(x[sorted_indices], pred_y2[sorted_indices],
        c='limegreen', label='Ridge')

mp.legend()
mp.show()
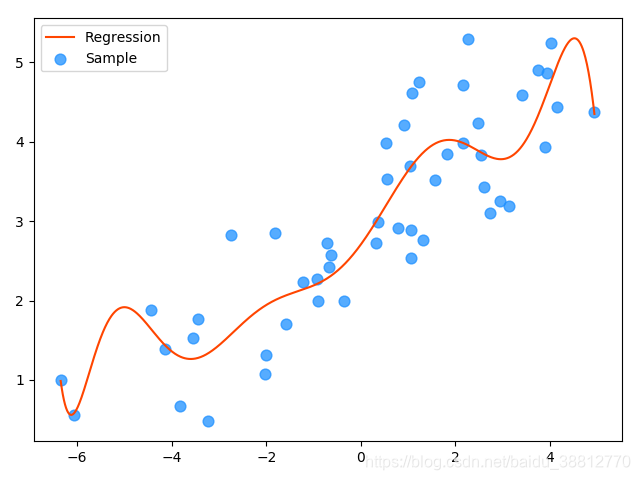
3.多项式回归

"""
所以一元多项式回归的实现需要两个步骤:

1. 将一元多项式回归问题转换为多元线性回归问题(只需给出多项式最高次数即可)。
2. 将1步骤得到多项式的结果中 参数
当做样本特征,交给线性回归器训练多元线性模型。
"""

import numpy as np
import sklearn.pipeline as pl
import sklearn.preprocessing as sp
import sklearn.linear_model as lm
import sklearn.metrics as sm
import matplotlib.pyplot as mp
# 采集数据
x, y = np.loadtxt('../data/ml_data/single.txt', delimiter=',', usecols=(0,1), unpack=True)
x = x.reshape(-1, 1)

# 创建模型(管线)
model = pl.make_pipeline(
    sp.PolynomialFeatures(10),
    lm.LinearRegression()
)
# 模型训练
model.fit(x, y)
# 根据输入预测输出
pred_y = model.predict(x)
test_x = np.linspace(x.min(), x.max(), 1000).reshape(-1, 1)
pred_test_y = model.predict(test_x)

mp.scatter(x, y, c='dodgerblue', alpha=0.75, s=60, label='Sample')
mp.plot(test_x, pred_test_y, c='orangered', label='Regression')
mp.legend()
mp.show()
4.决策树

import sklearn.datasets as sd
import sklearn.utils as su

# 加载波士顿地区房价数据集
boston = sd.load_boston()
print(boston.feature_names)
# 打乱原始数据集的输入和输出
x, y = su.shuffle(boston.data, boston.target, random_state=7)

# 划分训练集和测试集
train_size = int(len(x) * 0.8)
train_x, test_x, train_y, test_y = \
    x[:train_size], x[train_size:], \
    y[:train_size], y[train_size:]

import sklearn.tree as st
import sklearn.metrics as sm
import sklearn.ensemble as se
# 创建决策树回归模型
model = st.DecisionTreeRegressor(max_depth=4)
# 训练模型
model.fit(train_x, train_y)
# 测试模型
pred_test_y = model.predict(test_x)
print(sm.r2_score(test_y, pred_test_y))         # 0.8202560889408634

import matplotlib.pyplot as mp
import numpy as np

model = st.DecisionTreeRegressor(max_depth=4)
model.fit(train_x, train_y)
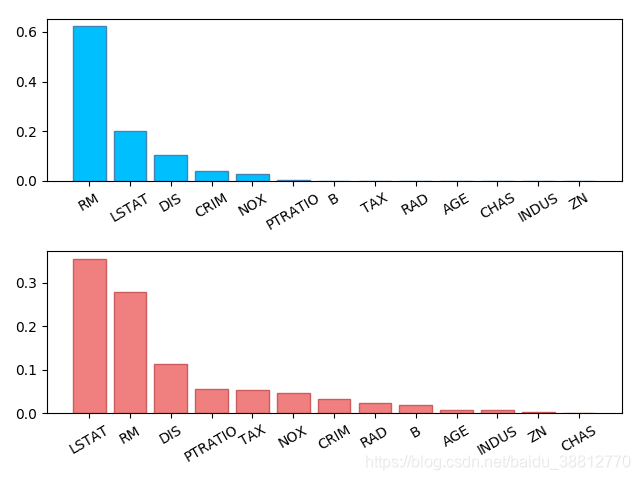
# 决策树回归器给出的特征重要性
fi_dt = model.feature_importances_
model = se.AdaBoostRegressor(
    st.DecisionTreeRegressor(max_depth=4), n_estimators=400, random_state=7)
model.fit(train_x, train_y)
# 基于决策树的正向激励回归器给出的特征重要性
fi_ab = model.feature_importances_

mp.subplot(211)
sorted_indices = fi_dt.argsort()[::-1]
pos = np.arange(sorted_indices.size)
mp.bar(pos, fi_dt[sorted_indices], facecolor='deepskyblue', edgecolor='steelblue')
mp.xticks(pos, boston.feature_names[sorted_indices], rotation=30)

mp.subplot(212)
sorted_indices = fi_ab.argsort()[::-1]
pos = np.arange(sorted_indices.size)
mp.bar(pos, fi_ab[sorted_indices], facecolor='lightcoral', edgecolor='indianred')
mp.xticks(pos, boston.feature_names[sorted_indices], rotation=30)

mp.tight_layout()
mp.show()

"""
随机森林
在自助聚合的基础上,每次构建决策树模型时,不仅随机选择部分样本,
而且还随机选择部分特征,这样的集合算法,不仅规避了强势样本对预测结果的影响,
而且也削弱了强势特征的影响,使模型的预测能力更加泛化。
"""
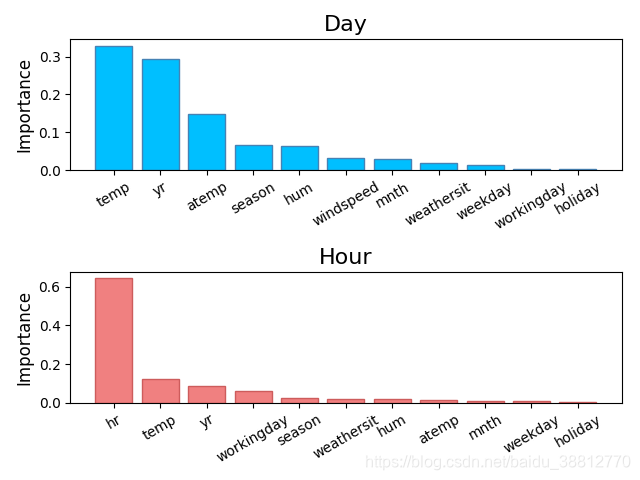
# 分析共享单车的需求,从而判断如何进行共享单车的投放。
import numpy as np
import sklearn.utils as su
import sklearn.ensemble as se
import sklearn.metrics as sm
import matplotlib.pyplot as mp

data = np.loadtxt('../data/ml_data/bike_day.csv',
                  unpack=False, dtype='U20', delimiter=',')
day_headers = data[0, 2:13]
x = np.array(data[1:, 2:13], dtype=float)
y = np.array(data[1:, -1], dtype=float)

x, y = su.shuffle(x, y, random_state=7)
print(x.shape, y.shape)
train_size = int(len(x) * 0.9)
train_x, test_x, train_y, test_y = \
    x[:train_size], x[train_size:], y[:train_size], y[train_size:]

# 随机森林回归器
model = se.RandomForestRegressor(max_depth=10, n_estimators=1000, min_samples_split=2)
model.fit(train_x, train_y)
# 基于“天”数据集的特征重要性
fi_dy = model.feature_importances_
pred_test_y = model.predict(test_x)
print(sm.r2_score(test_y, pred_test_y))

data = np.loadtxt('../data/ml_data/bike_hour.csv',
                  unpack=False, dtype='U20', delimiter=',')

hour_headers = data[0, 2:13]
x = np.array(data[1:, 2:13], dtype=float)
y = np.array(data[1:, -1], dtype=float)
x, y = su.shuffle(x, y, random_state=7)
train_size = int(len(x) * 0.9)
train_x, test_x, train_y, test_y = \
    x[:train_size], x[train_size:], \
    y[:train_size], y[train_size:]
# 随机森林回归器
model = se.RandomForestRegressor(
    max_depth=10, n_estimators=1000,
    min_samples_split=2)
model.fit(train_x, train_y)
# 基于“小时”数据集的特征重要性
fi_hr = model.feature_importances_
pred_test_y = model.predict(test_x)
print(sm.r2_score(test_y, pred_test_y))

mp.subplot(211)
mp.title('Day', fontsize=16)
mp.ylabel('Importance', fontsize=12)
sorted_indices = fi_dy.argsort()[::-1]
pos = np.arange(sorted_indices.size)
mp.bar(pos, fi_dy[sorted_indices], facecolor='deepskyblue', edgecolor='steelblue')
mp.xticks(pos, day_headers[sorted_indices], rotation=30)

mp.subplot(212)
mp.title('Hour', fontsize=16)
mp.ylabel('Importance', fontsize=12)
sorted_indices = fi_hr.argsort()[::-1]
pos = np.arange(sorted_indices.size)
mp.bar(pos, fi_hr[sorted_indices], facecolor='lightcoral', edgecolor='indianred')
mp.xticks(pos, hour_headers[sorted_indices], rotation=30)

mp.tight_layout()
mp.show()
机器学习线性回归算法预测PM2.5 数据集: train.csv: 每个月前 20 天的完整数据。 test.csv : 从剩下的数据当中取样出连续的 10 小时为一笔,前九小时的所有观测数据当作 feature,第十小时的 PM2.5 当作 answer。一共取出 240 笔不重复的 test data,请根据 feature 预测这 240 笔的 PM2.5。 数据集下载链接:https://aistudio.baidu.com/aistudio/datasetlist/2 项目代码: from sklearn import linear 阅读详情

相关推荐

第L2周:ML|线性回归模型

如果你只使用一个特征来预测另一个特征,那么这种情况下模型是可以工作的,但通常这不是机器学习中的标准做法,因为模型将无法从多个特征中学习。这里我们采用“学习时长-成绩”数据集,采用LinearRegression简单线形回归模型,通过学习时长去预测学生成绩。(3) fit 的作用:找到最佳的线性关系,即最佳拟合线,来描述。(2) 这段代码初始化了一个线性回归模型,并使用训练数据集。对象可以用来对新的特征数据进行预测,以估计目标变量的值。

qq_40879041的博客 936

线性回归 Week4

预测函数y=w0+w1x。w0和w1模型参数。

XXXxxx2003的博客 547

【机器学习案例一】PM2.5的预测(回归)

基于回归分析的PM2.5预测案例背景数据预处理普通线性回归要求模型参数训练模型训练效果岭回归要求模型参数格子搜索确定最优惩罚因子用最优惩罚因子训练模型Lasso回归要求模型参数格子搜索确定最优惩罚因子用最优惩罚因子训练模型基于lasso回归,评价模型变量的重要性 案例背景 数据集 pm2.5 中给出了与预测 pm2.5 有关的气象数据。请利用 2010 年至 2013 年的数据作为训练集对 201...

认真写的博客 2万+

R2决定系数(R2 得分)详细计算

机器学习之线性模型模型评估指标 R2决定系数(R2得分)计算过程,一起sklearn中关于模型评估的API

后端博客,UE博客,数据库博客,C++博客,数字孪生应用,Python(小工具,爬虫等),没事儿写写AI的博客,算法博客,不定时更新 5万+

什么是plm系统?-数字化转型网

当今世界,产品研发能力是企业在激烈的市场竞争中保持战略优势的核心竞争力之一。如何有效地缩短产品研发周期、改善产品服务的设计迭代流程、有效降低产品的研发成本,也是企业面临的主要问题之一。PLM(Product Lifecycle Management,产品生命周期管理)在优化产品研发的全管理流程、增强企业产品的市场竞争力方面具有关键的作用。

cxo17757154043的博客 883

梦幻西游端游脚本开发实战:从易语言到大漠多线程全解析

本文详细解析了梦幻西游端游脚本开发的全流程,从易语言基础入门到大漠插件多线程实战。重点介绍了易语言中文编程优势、大漠插件图色识别技术,以及多线程控制台开发技巧,帮助开发者高效实现游戏自动化,提升脚本稳定性和执行效率。

weixin_29251567的博客 1061

Python每日一记42>>>机器学习中特征重要性feature_importances_

在进行机器学习算法中,我们常用的算法就像下面的代码形式类型 经历导入数据-预处理-建模-得分-预测 但是总觉得少了点什么,虽然我们建模的目的是进行预测,但是我们想要知道的另一个信息是变量的重要性,在线性模型中,我们有截距和斜率参数,但是其他机器学习算法,如决策树和随机森林,我们貌似没有这样的参数 值得庆幸的是我们有变量重要性指标feature_importances_,但是就目前而言,这个参数好...

教练我想学编程 2万+

树莓派34/100 - Pico读取MPU6050加速度和陀螺仪传感器数据

树莓派Pico连接MPU-6050模块(三轴陀螺仪+三轴加速度),读取运动姿态数据。

申龙斌的程序人生 5088

sklearn 中的评分

import numpy as np import sklearn.metrics as sm from sklearn.metrics import confusion_matrix # 评分回归模型 """ metrics 做模型观察 sm.mean_absolute_error(y, predict_y) 平均绝对值误差 sm.mean_squared_error(y, predict_y) 平方误差 sm.median_absolute_error(y, preditc_y) 中位数绝对值...

weixin_43910988的博客 476

新英格兰10机39节点matlab建模,ieee10机39节点系统数据

【实例简介】ieee10机39节点系统数据,主要是BPA数据!【实例截图】【核心代码】ne_039_bus└── ne_039_bus├── 039readme.doc├── bpa│ ├── 039bpa.dat│ ├── 039bpa.swi│ ├── LFerr.LIS│ ├── OneNote 目录.onetoc2│ └── STERR.LIS├── eurostag│...

weixin_39851809的博客 3273

从PCB走线到天线:用史密斯圆图搞定2.4GHz频段的阻抗匹配陷阱

本文深入探讨了2.4GHz频段PCB设计中阻抗匹配的挑战与解决方案,重点介绍了史密斯圆图在射频和天线阻抗匹配中的应用。通过实战案例和详细步骤,帮助工程师有效解决高频信号传输中的阻抗失配问题,提升物联网设备的通信性能。

uuu88的博客 721

机器学习之决策树

一、决策树的原理 《决策树》 1、既可以用于回归,又可以用于分类; 2、相似的输入都会有相似的输出; (决策树与随机森林)深入学习请移步:https://www.cnblogs.com/fionacai/p/5894142.html 回归 -- 平均问题 分类 -- 投票问题 《优化》: (信息熵 -- 混乱度) 1)结合...

小小良 466

YOLOv11涨点改进 | 全网独家创新,注意力改进篇 | TGRS 2025 | 引入APCM自适应像素级协同机制,动态增强目标区域、抑制背景噪声,助力YOLOv11做红外小目标检测有效涨点

本文提出了一种基于APCM模块改进的YOLOv11网络模型,通过像素级局部-全局协同建模增强目标特征并抑制背景噪声。APCM模块采用轻量化设计,无需复杂参数,能有效提升小目标检测性能。文章详细介绍了APCM的原理、优势及其在红外小目标检测中的应用,包括模块结构、核心代码实现和YAML配置文件修改方法。实验结果表明,该方法在NUAA-SIRST和IRSTD-1K数据集上优于现有技术,显著提高了复杂场景下的检测精度与鲁棒性。

Ai缝合怪、助力小伙伴高效发论文 117

[笔记]机器学习之线性回归、L1回归、L2回归

  线性回归是机器学习领域里研究最多的算法,至今已有200年研究历史了。 线性回归   线性回归可用一条线表示输入值X和输出值Y之间的关系,这条线的斜率的值,也叫系数。最简单的线性回归可表示为y=ax+b。机器学习的目的就是给定数据样本(x,y),利用学习得到a,b。得到a和b后,就可以给定已知的x求出未知的y,这就是机器学习的目的和意思。   进而我们可以推广到多个变量的情况,求得对于...

kestiny的专栏 8414

C#里使用NModbus来创建一个TCP从站服务

摘要:本文介绍了一个用C#实现的Modbus TCP从站服务器,基于.NET Framework 4.6.1开发。代码使用NModbus库创建TcpListener和ModbusSlaveNetwork,支持设置IP地址、端口号和从站ID。服务器实现了数据存储初始化功能(包括线圈和保持寄存器),并提供了启动/停止操作的UI界面和日志记录功能。该解决方案适用于需要调试Modbus TCP协议的场景,特别适合无法升级到更高版本.NET Framework的环境。

大坡3D软件开发 478

【WorkBuddy专栏52】Codex与WorkBuddy生态适配、用户争夺与未来走向(下)

【WorkBuddy专栏52】Codex与WorkBuddy在中国大陆的发展——生态适配、用户争夺与未来走向(下)

AI人人懂 679

【ML2】机器学习之线性回归

【知识储备】 线性回归: 1: 函数模型(Model): 假设有训练数据   那么为了方便我们写成矩阵的形式   2: 损失函数(cost):  现在我们需要根据给定的X求解W的值,这里采用最小二乘法。    最小二乘法:如果有很多的给定点,这时候我们需要找出一条线去拟合它,那么先假设这个线的方程,然后把数据点代入假设的方程得到观测值,求使得实际值与观测值相减的平方和最小的参...

安徐正静 250

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

机器学习的复习笔记2-回归

回归的定义及评价方法

qq_27017791的博客 1695

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

机器学习代码基础——ML2 使用梯度下降的线性回归

该函数应将 NumPy 数组 X(具有一列截距的特征)和 y(目标)作为输入,以及学习率 alpha 和迭代次数,并返回一个 NumPy 数组,表示线性回归模型的系数。对于只有一个训练样本的训练组而言,每走一步,𝜃𝑗(𝑗= 0,1,…这样,每次根据所有数据求出偏导,然后根据特定的步长𝛼,就可以不断更新𝜃𝑗,直到其收敛。3️⃣ 如果新的𝜃能使𝐽(𝜃)继续减少,继续利用上述步骤更新𝜃,否则收敛,停止迭代。第1行输入X,第2行输入y,第3行输入alpha,第4行输入迭代次数。在梯度为零或趋近于

weixin_47692652的博客 1015

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

ML之回归预测:利用九大类机器学习算法对无人驾驶汽车系统参数(2018年的data,18+2)进行回归预测值VS真实值

ML之回归预测:利用九大类机器学习算法对无人驾驶汽车系统参数(2018年的data,18+2)进行回归预测值VS真实值 相关文章ML之回归预测:利用九大类机器学习算法对无人驾驶汽车系统参数(2018年的data,18+2)进行回归预测值VS真实值 目录 输出结果 核心代码 输出结果 数据的初步查验:输出回归目标值的差异 The max ta...

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1万+

机器学习之回归模型预测性能评估指标(RMSE、MSE、MAE、MAPE、SMAPE、R^2 Score、R^2 )

机器学习就是通过大量的数据进行训练,然后得出输入数据的模型特征;再次输入相关的数据时,能得到一个预测的结果。这在现实生活中解决了大量的问题,如:股票预测、物体分类、房价预测等等,这些都依赖机器学习带给我们的便利。......

有你真好的博客 2万+

学习机器学习四 回归模型——线性回归、L1正则化(Lasso回归)、L2正则化(ridge回归)

还记得什么是回归吗?回忆下回归就是连续的输出,分类是离散的。 回归模型一般分为:①线性回归——就是线性方程,类似为一元一次方程(y=wx+b),比如你的年龄; ②逻辑回归(类似为曲线方程) 线性回归 先来详细的学习下线性回归,线性回归就是回归模型中最简单的,就像一元一次方程(y=wx+b)是数学方程组中最简单易学的一样。假设我...

TOTOLOG的博客 3107

ML之ME/LF:机器学习中回归预测模型评估指标之“调整确定系数R2”的简介、代码实现之详细攻略

ML之ME/LF:机器学习中回归预测模型评估指标之“调整确定系数R2”的简介、代码实现之详细攻略目录回归预测模型中常用的评估指标“调整确定系数R2*”的简介1、R²的缺点——调整确定系数Adjusted R2(R2*)的引入2、R²和R2*的对比3、调整确定系数R2的使用方法回归预测模型中常用的评估指标“调整的R2”的代码实现 R²表示回归平方和与总离差平方和的比值,这一比值越大,表示总离差平方和中可以由回归平方和解释的比例越大,模型越精确,回归效果越显著。R²∈[0~1],越接近1,回归

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1万+

ML之回归预测:利用九大类机器学习算法对无人驾驶系统参数(2018年的data,18+2)进行回归预测+评估九种模型性能

ML之回归预测:利用九大类机器学习算法对无人驾驶系统参数(2018年的data,18+2)进行回归预测+评估九种模型性能 相关文章ML之回归预测:利用九大类机器学习算法对自动驾驶系统参数(2018年的data,18+2)进行回归预测+评估九种模型性能 目录 输出记录 1、第一次输出错误记录 2、第二次输出评估模型性能记录 输出记录 1、第一次输出错误记录 数据的...

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1万+

人工智能之机器学习5-回归算法2【培训机构学习笔记】

即决定系数,是在回归分析中用于评估回归模型拟合优度的一个重要指标,其衡量的是回归模型对观测数据的拟合程度,它表示因变量的总变异中能够被自变量解释的比例。换句话说,值反映了模型能够在多大程度上解释因变量的变化。

crazy_cz的博客 1269

机器学习回归模型的r2低。该怎样解决

要解决机器学习回归模型的R2低,可以尝试以下几种方法:1. 增加训练数据的数量和质量;2. 改变模型的结构,增加模型的复杂度;3. 改变训练方法,使用更高级的算法;4. 调整正则化参数,防止模型过拟合;5. 特征工程,挖掘更多有效的特征。 ...

weixin_42588555的博客 4276
上一篇: 机器学习1之基础
下一篇: 机器学习3之分类
陌上无双
博客等级 码龄9年 7粉丝 34原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值