


目录
序列式容器和关联式容器
前⾯我们已经接触过STL中的部分容器如:string、vector、list、deque、array、forward_list等,这些容器统称为序列式容器,因为逻辑结构为线性序列的数据结构,两个位置存储的值之间⼀般没有紧密的关联关系,⽐如交换⼀下,他依旧是序列式容器。顺序容器中的元素是按他们在容器中的存储位置来顺序保存和访问的。
关联式容器也是⽤来存储数据的,与序列式容器不同的是,关联式容器逻辑结构通常是⾮线性结构,两个位置有紧密的关联关系,交换⼀下,他的存储结构就被破坏了。顺序容器中的元素是按关键字来保存和访问的。关联式容器有map/set系列和unordered_map/unordered_set系列。
本章节讲解的map和set底层是红⿊树,红⿊树是⼀颗平衡⼆叉搜索树。set是key搜索场景的结构,map是key/value搜索场景的结构。
熟识set
在STL中的底层结构:
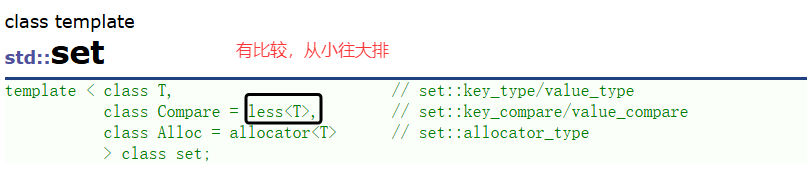
set默认要求T⽀持⼩于⽐较,如果不⽀持或者想按⾃⼰的需求⾛可以⾃⾏实现仿函数传给第⼆个模版参数。
set底层存储数据的内存是从空间配置器申请的,如果需要可以⾃⼰实现内存池,传给第三个参数。 ⼀般情况下,我们都不需要传后两个模版参数。
set底层是⽤红⿊树实现,增删查效率是 O(logN) ,迭代器遍历是⾛的搜索树的中序,所以是有序的。
set的构造和迭代器
⽀持迭代器就意味着⽀持范围for,set的iterator和const_iterator都不⽀持迭代器修改数据,修改
关键字数据,破坏了底层搜索树的结构。set迭代器是一个双向迭代器(支持的操作:*(解引用)、++(递增)、--(递减)、==和!=(比较))。
set的构造我们关注以下⼏个接⼝即可。
// empty (1) ⽆参默认构造
explicit set (const key_compare& comp = key_compare(),
const allocator_type& alloc = allocator_type());
// range (2) 迭代器区间构造
template <class InputIterator>
set (InputIterator first, InputIterator last,
const key_compare& comp = key_compare(),
const allocator_type& = allocator_type());
// copy (3) 拷⻉构造
set (const set& x);
// initializer list (5) initializer 列表构造
set (initializer_list<value_type> il,
const key_compare& comp = key_compare(),
const allocator_type& alloc = allocator_type());
// 迭代器是⼀个双向迭代器
iterator
-> a bidirectional iterator to const value_type
// 正向迭代器
iterator begin();
iterator end();
// 反向迭代器
reverse_iterator rbegin();
reverse_iterator rend();
测试用例:
void test_set()
{
	//无参默认构造
	set<int> s1;
	//迭代器区间构造
	vector<int> v1;
	for (int i = 0; i < 10; i++)
	{
	v1.push_back(i);
	}
	set<int> s2(v1.begin(), v1.end());
	for (auto& e : s2)
	{
		cout << e<<' ';
	}
	cout << endl;
	//拷贝构造
	set<int> s3(s2);
	for (auto& e : s3)
	{
		cout << e <<' ';
	}
	cout << endl;
	//列表构造
	set<int> s4({ 4,5,6,7,8 });
	for (auto& e : s4)
	{
		cout << e << ' ';
	}
	cout << endl;
}
set的增删查
set的增删查关注以下⼏个接⼝即可:
Member types
key_type
-> The first template parameter (T)
value_type -> The first template parameter (T)
// 单个数据插⼊,如果已经存在则插⼊失败
pair<iterator,bool> insert (const value_type& val);
// 列表插⼊,已经在容器中存在的值不会插⼊
void insert (initializer_list<value_type> il);
// 迭代器区间插⼊,已经在容器中存在的值不会插⼊
template <class InputIterator>
void insert (InputIterator first, InputIterator last);
// 查找val,返回val所在的迭代器,没有找到返回end()
iterator find (const value_type& val);
// 查找val,返回Val的个数
size_type count (const value_type& val) const;
// 删除⼀个迭代器位置的值
iterator erase (const_iterator position);
// 删除val,val不存在返回0,存在返回1
size_type erase (const value_type& val);
// 删除⼀段迭代器区间的值
iterator erase (const_iterator first, const_iterator last);
// 返回大于等于val位置的迭代器
iterator lower_bound (const value_type& val) const;
// 返回小于val位置的迭代器
iterator upper_bound (const value_type& val) const;
测试用例:
void test_set()
{
    int a[] = { 3,1,4,6,7,9,2,5,9,5,1 };
	set<int> s1;
	for(auto& e:a)
	{
		//单个数据插入
		s1.insert(e);
    }
	for (auto& e : s1)
	{
		cout << e << ' ';
	}
	cout << endl;
	 set<int>s2;
	 //列表插入
	 s2.insert({ 3,1,4,6,7,9,2,5,9,5,1 });
	 for (auto& e : s1)
	 {
		 cout << e << ' ';
	 }
	 cout << endl;
	 vector<int> v1;
	for (int i = 0; i < 10; i++)
	{
	v1.push_back(i);
	}
	set<int>s3;
	//迭代器区间插入
	//s3.insert(v1.begin(), v1.end());
	s3.insert(s1.begin(), s1.end());
	for (auto& e : s3)
	{
		cout << e << ' ';
	}
	cout << endl;
	auto it = s1.lower_bound(2);
	auto it1 = s1.upper_bound(5);
	//删除大于等于2小于等于5的区间
	s1.erase(it, it1);
	for (auto& e : s1)
	{
		cout << e << ' ';
	}
	cout << endl;
	//find
	//用算法库寻找O(N)
	auto pos1=find(s1.begin(), s1.end(), 9);
	//用set的成员函数寻找O(logN)
	auto pos2=s1.find(9);
	//利用count快速寻找
	int x;
	//set不冗余,所以即使有相同的,在s1中存在的个数都为1
	cin >>x ;
	if (s1.count(x))
	{
		cout << "在" << endl;
	}
	else
	{
		cout << "不在" << endl;
	}
}
multiset和set的差异
multiset和set的使⽤基本完全类似,主要区别点在于multiset⽀持值冗余,那么
insert/find/count/erase都围绕着⽀持值冗余有所差异,具体参看下⾯的样例代码理解。
#include<iostream>
#include<set>
using namespace std;
int main()
{
// 相⽐set不同的是,multiset是排序,但是不去重
multiset<int> s = { 4,2,7,2,4,8,4,5,4,9 };
auto it = s.begin();
while (it != s.end())
{
cout << *it << " ";
++it;
}
cout << endl;
// 相⽐set不同的是,x可能会存在多个,find查找中序的第⼀个
int x;
cin >> x;
auto pos = s.find(x);
while (pos != s.end() && *pos == x)
{
cout << *pos << " ";
++pos;
}
cout << endl;
// 相⽐set不同的是,count会返回x的实际个数
cout << s.count(x) << endl;
// 相⽐set不同的是,erase给值时会删除所有的x
s.erase(x);
for (auto e : s)
{
cout << e << " ";
}
cout << endl;
return 0;
}
练习题:
思路:先让两个数组用set排序,再去遍历两个对象中的数据,如果第一个对象中的数比第二个对象中的数据要大,那么这时候我们就要让第二个对象向后走;同理,如果第一个对象中的数比第二个对象中的数据要小,那么这时候我们就要让第一个对象向后走;如果相同我们就尾插进vector对象中,同时记得set对象同时都要向后走。
class Solution {
public:
    vector<int> intersection(vector<int>& nums1, vector<int>& nums2) {
        set<int>s1(nums1.begin(),nums1.end());
        set<int> s2(nums2.begin(),nums2.end());
        vector<int> v1;
        auto it1=s1.begin();
        auto it2=s2.begin();
        while(it1!=s1.end()&&it2!=s2.end())
        {
            if(*it1<*it2)
            {
                it1++;
            }
            else if(*it1>*it2)
            {
                it2++;
            }
            else{
                v1.push_back(*it1);
                it1++;
                it2++;
            }
        }
        return v1;
    }
};当时在学习数据结构的时候我们也遇到过这道题,当时我们运用了快慢指针,即快指针走三步,而慢指针走一步。
但今天我们学习了set,就可以轻松解决这道题。在上面学习count成员函数的时候,我们可以直接用count来查找val是否存在。
思路:定义一个存放节点指针的对象,对链表进行循环的过程中用count成员函数检查set中是否存在节点,如果没有就插入进对象中,如果有就返回该节点(进入环的节点)。如果遍历完了链表还没有找到,那么就是单链表,不存在环,返回nullptr。
class Solution {
public:
    ListNode *detectCycle(ListNode *head) {
        set<ListNode*>s1;
        ListNode*cur=head;
        while(cur)
        {
            if(s1.count(cur))
            {
                return cur;
            }
            s1.insert(cur);
            cur=cur->next;
        }
        return nullptr;
    }
};
熟识map
map类的介绍
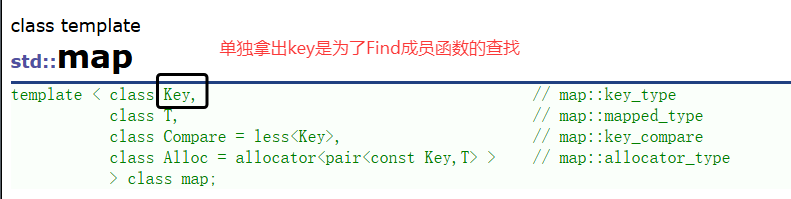
map的声明如下,Key就是map底层关键字的类型,T是map底层value的类型,set默认要求Key⽀持⼩于⽐较,如果不⽀持或者需要的话可以⾃⾏实现仿函数传给第⼆个模版参数,map底层存储数据的内存是从空间配置器申请的。⼀般情况下,我们都不需要传后两个模版参数。map底层是⽤红⿊树实现,增删查改效率是 O(logN) ,迭代器遍历是⾛的中序,所以是按key有序顺序遍历的。
pair类型介绍
map底层的红⿊树节点中的数据,使⽤pair<Key, T>存储键值对数据。
typedef pair<const Key, T> value_type;
template <class T1, class T2>
struct pair
{
typedef T1 first_type;
typedef T2 second_type;
T1 first;
T2 second;
pair(): first(T1()), second(T2())
{}
pair(const T1& a, const T2& b): first(a), second(b)
{}
template<class U, class V>
pair (const pair<U,V>& pr): first(pr.first), second(pr.second)
{}
};
template <class T1,class T2>
inline pair<T1,T2> make_pair (T1 x, T2 y)
{
return ( pair<T1,T2>(x,y) );
}
map的构造
map的⽀持正向和反向迭代遍历,遍历默认按key的升序顺序,因为底层是⼆叉搜索树,迭代器遍历⾛的中序;⽀持迭代器就意味着⽀持范围for,map⽀持修改value数据,不⽀持修改key数据,修改关键字数据,破坏了底层搜索树的结构。//pair(key,value)
// empty (1) ⽆参默认构造
explicit map (const key_compare& comp = key_compare(),
const allocator_type& alloc = allocator_type());
// range (2) 迭代器区间构造
template <class InputIterator>
map (InputIterator first, InputIterator last,
const key_compare& comp = key_compare(),
const allocator_type& = allocator_type());
// copy (3) 拷⻉构造
map (const map& x);
// initializer list (5) initializer 列表构造
map (initializer_list<value_type> il,
const key_compare& comp = key_compare(),
const allocator_type& alloc = allocator_type());
// 迭代器是⼀个双向迭代器
iterator
-> a bidirectional iterator to const value_type
// 正向迭代器
iterator begin();
iterator end();
// 反向迭代器
reverse_iterator rbegin();
reverse_iterator rend();
map的增删查
map接⼝,插⼊的pair键值对数据,跟set所有不同,但是查和删的接⼝只⽤关键字key跟set是完全类似的,不过find返回iterator,不仅仅可以确认key在不在,还找到key映射的value,同时通过迭代还可以修改value.
Member types
key_type
-> The first template parameter (Key)
mapped_type -> The second template parameter (T)
value_type
-> pair<const key_type,mapped_type>
// 单个数据插⼊,如果已经key存在则插⼊失败,key存在相等value不相等也会插⼊失败
pair<iterator,bool> insert (const value_type& val);
// 列表插⼊,已经在容器中存在的值不会插⼊
void insert (initializer_list<value_type> il);
// 迭代器区间插⼊,已经在容器中存在的值不会插⼊
template <class InputIterator>
void insert (InputIterator first, InputIterator last);
// 查找k,返回k所在的迭代器,没有找到返回end()
iterator find (const key_type& k);
// 查找k,返回k的个数
size_type count (const key_type& k) const;
// 删除⼀个迭代器位置的值
iterator erase (const_iterator position);
// 删除k,k存在返回0,存在返回1
size_type erase (const key_type& k);
// 删除⼀段迭代器区间的值
iterator erase (const_iterator first, const_iterator last);
// 返回⼤于等k位置的迭代器
iterator lower_bound (const key_type& k);
// 返回⼤于k位置的迭代器
const_iterator lower_bound (const key_type& k) const;
map的数据修改
map第⼀个⽀持修改的⽅式时通过迭代器,迭代器遍历时或者find返回key所在的iterator修改,map还有⼀个⾮常重要的修改接⼝operator[],但是operator[]不仅仅⽀持修改,还⽀持插⼊数据和查找数据,所以他是⼀个多功能复合接⼝.
需要注意从内部实现⻆度,map这⾥把我们传统说的value值,给的是T类型,typedef为
mapped_type。⽽value_type是红⿊树结点中存储的pair键值对值。⽇常使⽤我们还是习惯将这⾥的T映射值叫做value。
Member types
key_type
-> The first template parameter (Key)
mapped_type -> The second template parameter (T)
value_type
-> pair<const key_type,mapped_type>
// 查找k,返回k所在的迭代器,没有找到返回end(),
//如果找到了通过iterator可以修改key对应mapped_type值
iterator find (const key_type& k);
// ⽂档中对insert返回值的说明
// insert插⼊⼀个pair<key, T>对象
// 1、如果key已经在map中,插⼊失败,则返回⼀个pair<iterator,bool>对象,返回pair对象
first是key所在结点的迭代器,second是false
// 2、如果key不在在map中,插⼊成功,则返回⼀个pair<iterator,bool>对象,返回pair对象
first是新插⼊key所在结点的迭代器,second是true
// 也就是说⽆论插⼊成功还是失败,返回pair<iterator,bool>对象的first都会指向key所在的迭
代器
// 那么也就意味着insert插⼊失败时充当了查找的功能,正是因为这⼀点,insert可以⽤来实现
operator[]
// 需要注意的是这⾥有两个pair,不要混淆了,⼀个是map底层红⿊树节点中存的pair<key, T>,另
⼀个是insert返回值pair<iterator,bool>
pair<iterator,bool> insert (const value_type& val);
mapped_type& operator[] (const key_type& k);
// operator的内部实现
mapped_type& operator[] (const key_type& k)
{
// 1、如果k不在map中,insert会插⼊k和mapped_type默认值,同时[]返回结点中存储
mapped_type值的引⽤,那么我们可以通过引⽤修改返映射值。所以[]具备了插⼊+修改功能
// 2、如果k在map中,insert会插⼊失败,但是insert返回pair对象的first是指向key结点的
迭代器,返回值同时[]返回结点中存储mapped_type值的引⽤,所以[]具备了查找+修改的功能
pair<iterator, bool> ret = insert({ k, mapped_type() });
iterator it = ret.first;
return it->second;
}
测试样例:
void  map_test()
{
	map<string, string>dict;
	dict.insert(make_pair ("sort", "排序"));
	dict.insert({ "left","左边" });
	dict.insert(pair<string, string>("second", "第二"));
	pair<string, string>kv("right", "右边");
	dict.insert(kv);
	//插入失败,冗余了
	dict.insert({ "left","左边,剩余" });
	auto it = dict. begin();
	while (it != dict.end())
	{
		cout << it->first << "->" << it->second<<endl;
		it++;
	}
	cout << endl;
	for (auto& e : dict)
	{
		cout << e.first << ":" << e.second << endl;
	}
	cout << endl;
	string str;
	while (cin >> str)
	{
		auto ret = dict.find(str);
		if (ret != dict.end())
		{
			cout << "找到了" << endl;
		}
		else
			cout << "没找到" << endl;
	}

}
void map_test1()
{
	//测试迭代器和[]运算符的使用
	string arr[] = { "苹果", "西⽠", "苹果", "西⽠", "苹果", "苹果", "西⽠",
"苹果", "⾹蕉", "苹果", "⾹蕉" };
	map<string, int> countMap;
	/*for (auto& e : arr)
	{
		auto ret = countMap.find(e);
		if (ret != countMap.end())
		{
			ret->second++;
		}
		else
		{
			countMap.insert({ e,1 });
		}
	}
	for (auto& e : countMap)
	{
		cout << e.first << ":" << e.second << endl;
	}
	cout << endl;*/
	//[]的用法
	//1.插入
	map<string, string> dict;
	dict["left"];
	//2.修改
	dict["right"] = "右边";
	dict["right"] = "右边,向右";
		//3.插入加修改
	dict["sort"] = "排序";
	for (auto& e : dict)
	{
		cout << e.first << ":" << e.second << endl;
	}
	cout << endl;
	//上面的countMap可以运用[]计算个数
	for (auto& e : arr)
	{
		countMap[e]++;
	}
	for (auto& e : countMap)
	{
		cout << e.first << ":" << e.second << endl;
	}
	cout << endl;
}
int main()
{
	//map_test();
	map_test1();
	return 0;
}
multimap和map的差异
multimap和map的使⽤基本完全类似,主要区别点在于multimap⽀持关键值key冗余,那么
insert/find/count/erase都围绕着⽀持关键值key冗余有所差异,这⾥跟set和multiset完全⼀样,⽐如find时,有多个key,返回中序第⼀个。其次就是multimap不⽀持[],因为⽀持key冗余,[]就只能⽀持插⼊了,不能⽀持修改。
void multimap_test()
{
	multimap<string, string> dict;
	dict.insert({ "left","左边" });
	dict.insert({ "left","剩余" });
	for (auto& e : dict)
	{
		cout << e.first << ":" << e.second << endl;
	}
	cout << endl;
	//dict["left"] = "激进分子";//报错,multimap中[]不能修改value值。
}
int main()
{
	multimap_test();
	return 0;
}
练习
在之前我们用C语言写这道题的时候,代码要敲很多,今天我们学习了map,就可以用map类轻松解决。
思路:我们建立一个map对象,pair中放两个节点的指针,当我们在遍历链表的时候,让新链表和原链表构成映射关系。(新链表和原链表有着一一对应的关系,可以通过原链表的节点就可以找到新链表的节点,且节点内容相同)
1.遍历链表。往新链表中插入节点,并让新链表的节点和原链表的节点构成映射关系。
2.处理random。在重新遍历数组,让新链表中的节点的random成员等于原链表中的节点的random。
class Solution {
public:
    Node* copyRandomList(Node* head) {
        //先复制单链表
        Node*cur=head;
        map<Node*,Node*>copyNode;
        Node*copyhead=nullptr;
        Node*copytail=nullptr;
        while(cur)
        {
            if(copyhead==nullptr)
            {
                copyhead=copytail=new Node(cur->val);
            }
            else
            {
                copytail->next=new Node(cur->val);
                copytail=copytail->next;
            }
            copyNode[cur]=copytail;//成映射关系
            cur=cur->next;
        }
        //复制
        cur=head;
        Node*pre=copyhead;
        while(cur)
        {
            if(cur->random==nullptr)
            {
                pre->random=nullptr;
            }
            else
            {
                pre->random=copyNode[cur->random];//不可pre->random=cur->random,
//指向的地址不一样,相当于pre节点的random指针指向了原链表,不是指向新链表。
            }
            cur=cur->next;
            pre=pre->next;
        }
        return copyhead;
    }
};
692. 前K个⾼频单词 - ⼒扣(LeetCode)
题目中让我们按单词出现频率由高到低排序。如果不同的单词有相同出现频率, 按字典顺序 排序。在排序之前我们应该对数组中的字符串进行统计个数,然后才能按照它的要求排序。
该题有三种排序思路:
1.运用算法库中的sort函数进行排序。sort函数是运用快排的思想,是不稳定的,所以在仿函数的时候我们不仅要比较字典顺序还要比较出现频率。
2.运用stable_sort函数进行排序。在插入map对象的时候,map对象里的字符串都已经按照字典顺序进行排序了,而stable_sort函数具有稳定性,那么在仿函数中我们只需要比较出现的频率就可以了。
3.运用priority_queue容器适配器进行建大堆实现。在前面的学习中我们就了解到priority_queue是优先级队列,每个元素都会有一个优先级概念,会按照固定的顺序定义。 在C++ STL中,默认情况下,优先级队列(priority_queue)的首元素始终是最大的元素。
思路1:
class Solution {
public:
struct compare
{
    bool operator()(pair<string,int> v1,pair<string,int>v2)
    {
        return (v1.second==v2.second&&v1.first<v2.first)||v1.second>v2.second;
    }
};
    vector<string> topKFrequent(vector<string>& words, int k) {
        map<string,int>mapsort;
        for(auto&e:words)
        {
            mapsort[e]++;
        }
        vector<pair<string,int>>v(mapsort.begin(),mapsort.end());
        sort(v.begin(),v.end(),compare());
        vector<string>v1;
        for(int i=0;i<k;i++)
        {
            v1.push_back(v[i].first);
        }
        return v1;
    }
};
思路2:
class Solution {
public:
struct compare
{
    bool operator()(pair<string,int> v1,pair<string,int>v2)
    {
        return v1.second>v2.second;
    }
};
    vector<string> topKFrequent(vector<string>& words, int k) {
        map<string,int>mapsort;
        for(auto&e:words)
        {
            mapsort[e]++;
        }
        vector<pair<string,int>>v(mapsort.begin(),mapsort.end());
        stable_sort(v.begin(),v.end(),compare());
        vector<string>v1;
        for(int i=0;i<k;i++)
        {
            v1.push_back(v[i].first);
        }
        return v1;
    }
};
思路3:
class Solution {
public:
struct compare
{
    bool operator()(pair<string,int> v1,pair<string,int>v2)
    {
        //要注意优先级队列底层是反的,⼤堆要实现⼩于⽐较,所以这⾥次数相等,想要字典
        //序⼩的在前⾯,要⽐较字典序⼤的为真
        return (v1.second==v2.second&&v1.first>v2.first)||v1.second<v2.second;
    }
};
    vector<string> topKFrequent(vector<string>& words, int k) {
        map<string,int>mapsort;
        for(auto&e:words)
        {
            mapsort[e]++;
        }
        //创建一个优先队列 p,其元素类型是 pair<string, int>。
        //使用 vector<pair<string, int>> 作为底层容器。
        //使用自定义的比较函数 Compare 来确定元素的优先级顺序。
        //将 mapsort 中的所有键值对初始化到优先队列 p 中,并按照 Compare 的规则进行排序。
        priority_queue<pair<string,int>,vector<pair<string,int>>,compare>p(mapsort.begin(),mapsort.end());
        vector<string>v1;
        for(int i=0;i<k;i++)
        {
            v1.push_back(p.top().first);
            p.pop();
        }
        return v1;
    }
}; 349


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


