动手练习 | 3步用Python运行机器学习

机器学习完整代码及运行结果 (2)创建新的DataFrame,用于存储转换后的udmap数据,并将其与原始数据合并。此外,还要计算每个用户ID的目标值均值,创建一个决策树分类器来训练模型。(3)使用训练好的模型对测试数据进行预测,并将预测结果与测试数据的'uuid'列一起写入到'submit.csv'文件中。通过遍历字典中的key,将对应的值赋给一个零数组的对应位置,如果遇到未知情况则返回一个全零数组。4,创建全0数组,如果d=unknown,返回0,如果d!中的每列都被重命名为 'key1'、'key2'、...、'key9' 阅读详情

根据经验,用Python运行机器学习包含了3个步骤:

1. 获取数据

2. 建立机器学习模型

3. 优化机器学习模型

1.目标

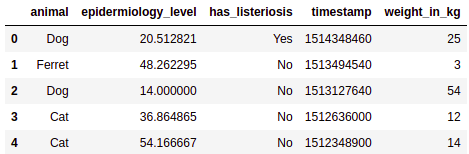
我们有2008~2018年的兽医数据集,它包含了动物(狗、猫和雪貂)的注册信息。
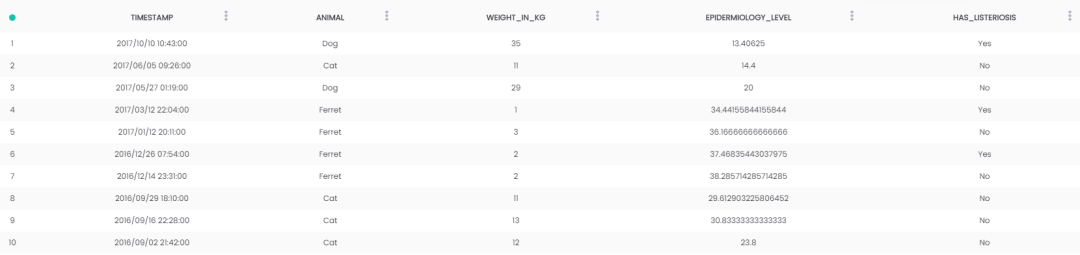
如上图,数据集特征包含了时间戳、动物名称、体重(单位Kg)、表皮病学水平、是否有李氏杆菌病。

表皮病学水平的检测是非常昂贵的,且对动物可能有伤害,因此我们的目标是建立机器模型,通过其他特征预测表皮病学水平,从而防止动物受到伤害并能节约成本。

2.你需要准备什么

  • 任何版本的Python(https://www.python.org/downloads/)

  • Pip(https://www.makeuseof.com/tag/install-pip-for-python/)

  • 安装Sklearn ,Panda,openblender(利用Pip)

pip install pandas OpenBlender scikit-learn
  • 推荐使用Jupyter Notebook的Python编辑器(https://jupyter.org/install)

步骤1:获取数据

导入将要使用的Python库:

import OpenBlender
import pandas as pd
import numpy as np
import json
import sklearn
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error

我们通过OpenBlender API获取数据。您需要在https://www.openblender.io中创建一个acount账户来获得一个令牌和user_id(它是免费的)

首先,我们定义参数(在本例中它只是数据集的id):

# It only contains the id, we'll add more parameters later.
parameters = {
    'token' : 'YOUR_TOKEN',
    'id_user' : 'YOUR_USER_ID',
    'id_dataset':'5db079199516296099c9fb1e'
}

数据转换为dataframe格式:

# This function pulls the data and orders by timestamp
def pullObservationsToDF(parameters):
    action = 'API_getObservationsFromDataset'
    df = pd.read_json(json.dumps(OpenBlender.call(action,parameters)['sample']), convert_dates=False,convert_axes=False) .sort_values('timestamp', ascending=False)
    df.reset_index(drop=True, inplace=True)
    return df
df_vet = pullObservationsToDF(parameters)

查看返回的dataframe数据:

print(df_vet.shape)
df_vet.head()
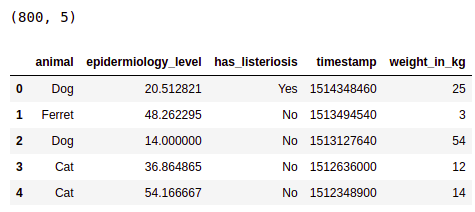
如上图,我们有800个数据,5个特征。

步骤2:建立机器学习模型

我们首先观察表皮病学水平和体重的关系:

%matplotlib inline
df_vet.plot.scatter('epidermiology_level', 'weight_in_kg')
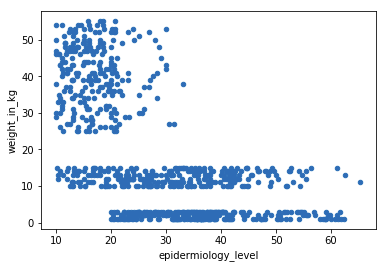
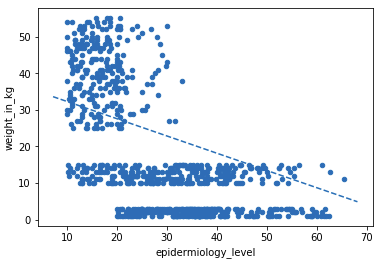
由上图可知,表皮病学水平和体重呈负相关的关系。

我们首先用简单的线性回归模型来学习:
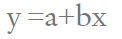
每个点的误差是给定输入值x,预测值和真实值的距离,最小化该误差来选择a和b。
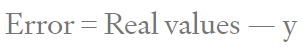
通过数据集构建线性回归模型的代码:

# First we declare it
regr = LinearRegression()
# Then we fit (or train) it to relate epidermiology with weight
regr.fit(df_vet[['weight_in_kg']], df_vet[['epidermiology_level']])
# Let's take a look at the intercpt (Our 'a')
print(regr.intercept_)
# And the slope (Our 'b')
print(regr.coef_)

回归模型系数a和b的结果:
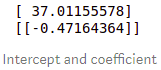
把该模型添加到上图:

axes = df_vet.plot.scatter('epidermiology_level', 'weight_in_kg')
x_vals = np.array(axes.get_xlim())
y_vals = 37.01155578 + -0.47164364 * x_vals
axes.plot(x_vals, y_vals, '-')
数据集划分为训练集和测试集,测试集的作用是检测机器学习模型的泛化水平:

# First we define 'X' and 'y'
X = df_vet[['weight_in_kg']]
y = df_vet[['epidermiology_level']]
# Then we separate 500 to train
X_train = X[:500]
y_train = y[:500]
print("Train X and y:")
print(X_train.shape)
print(y_train.shape)
# And 300 to test
X_test = X[500:]
y_test = y[500:]
print("Test X and y:")
print(X_test.shape)
print(y_test.shape)
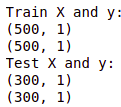
我们利用均方误差(MSE)来测试模型的泛化水平:
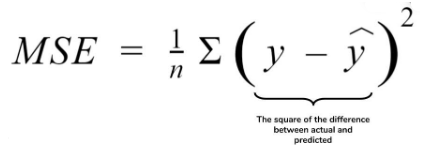
# First we traqin the model with the Test Set
lm = LinearRegression()
lm.fit(X_test, y_test)
# Then we generate predictions and compare to ‘y’ test
predictions = lm.predict(X_test)
mean_squared_error(y_test, predictions)

测试集的均方误差:

输出预测值和真实值结果:

df_preds_res = pd.DataFrame({'y_test':y_test['epidermiology_level'], 'y_pred':pred[:,0]})
df_preds_res.head(15)
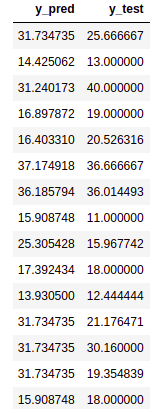
现在让我们看看是否可以通过增加输入变量来优化该模型。

步骤3:优化ML模型

线性回归的输入值一般是数值型的,我们首先将特征'animal'和'has_listeriosis'转换为数值类型。

转换前的数据:
转换代码:

#We add the 'categorical_treatment' parameter and pull again.
parameters = {
    'token' : 'YOUR_TOKEN',
    'id_user' : 'YOUR_USER_ID',
    'id_dataset':'5db079199516296099c9fb1e',
    'categorical_treatment': {"treatment" : "convert_to_numeric", "exclude" : ["weight_in_kg"]}
}
df_vet_numerical = pullObservationsToDF(parameters)

转换后的数据:
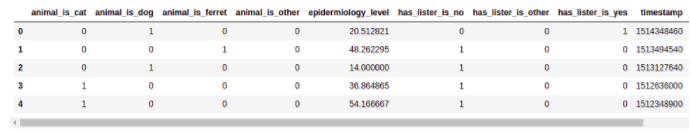
为了获得更多有用的特征,我们将日期细分为许多与时间相关的特征,如星期几,几月份。

parameters = {
    'token' : 'YOUR_TOKEN',
    'id_user' : 'YOUR_USER_ID',
    'id_dataset':'5db079199516296099c9fb1e',
    'categorical_treatment': {"treatment" : "convert_to_numeric",
    'exclude' : ["weight_in_kg"]},
 'date_treatment':{"treatment":"breakdown"}
}
df_vet_numerical = pullObservationsToDF(parameters)
df_vet_numerical.columns

特征有:
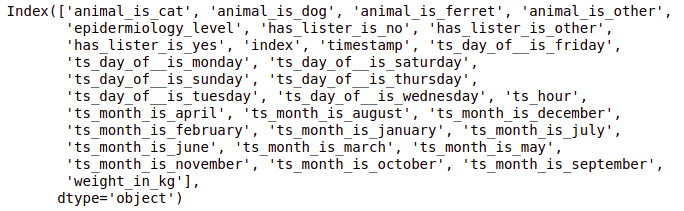
数据集划分为训练集和测试集:

target_variable = 'epidermiology_level'
# First we define ‘X’ and ‘y'
X = df_vet_numerical.loc[:, df_vet_numerical.columns != target_variable].values
y = df_vet_numerical.loc[:,[target_variable]].values
# Then we separate 500 to train
X_train = X[:500]
y_train = y[:500]
print("Train X and y:")
print(X_train.shape)
print(y_train.shape)
# And 300 to test
X_test = X[500:]
y_test = y[500:]
print("Test X and y:")
print(X_test.shape)
print(y_test.shape)
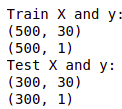
现在我们有30个特征构建回归模型,表达式为:
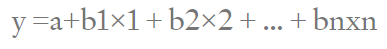
对比单变量的线性回归模型,看看MSE是否有降低。

# First we traqin the model with the Test Set
lm = LinearRegression()
lm.fit(X_test, y_test)
# Then we generate predictions and compare to ‘y’ test
pred = lm.predict(X_test)
mean_squared_error(y_test, pred)
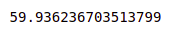
由结果可知,多变量的MSE降低了,因此多变量的模型性能更好了。

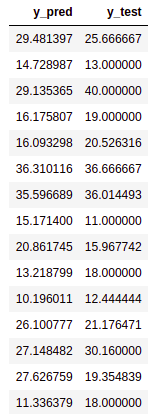
输出预测值和真实值。

df_preds_res = pd.DataFrame({'y_test':y_test[:,0], 'y_pred':pred[:,0]})
df_preds_res.head(15)
推荐阅读

干货 | 清晰易懂的机器学习算法原理介绍

欢迎扫码关注:
机器学习算法代码运行实践 机器学习算法代码,帮助大家一起学习。运用pycharm进行运行 立即下载

相关推荐

DBC到ARXML:AUTOSAR CAN通信栈自动化配置完整指南

在AUTOSAR架构下,DBC(CAN数据库文件)与ARXML(AUTOSAR XML)分别扮演着描述总线通信和ECU内部配置的关键角色。DBC定义了网络上的报文与信号,而ARXML则是AUTOSAR工具链交换配置数据的标准格式。在实际的ECU开发中,如何将DBC中的通信信息高效、准确地转换为ARXML,并自动生成可编译的CAN通信栈BSW配置,是许多工程师面临的痛点。借助DaVinci Configurator等工具,我们可以通过自动化导入链路消除手工映射带来的字节序错误、信号起始位偏差等高风险问题,大幅

weixin_34183910的博客 545

python机器学习(一)算法学习的步骤、机器学习的应用及流程(获取数据、特征工程、模型、模型评估)

算法学习的步骤、机器学习的应用及流程(获取数据、特征工程、模型、模型评估)

hwwaizs的博客 4267

Lmcache+vllm——KVcache卸载CPU/SSD探索

目前查看了vllm、Nvidia dynamo、mooncake都没有找到将kvcache卸载到SSD的方法,幸好lmcache支持。以下进行lmcache+vllm实践,对比将kvcache分别卸载到CPU-ram和SSD上的TTFT性能差异。目前的query只是单并发,对比的效果已经比较明显了,可能多并发下对存储的要求就会更高了。

weixin_43579058的博客 2657

常见的机器学习算法代码及其Python代码

例如, 想要了解一个完全陌生的人, 你也许想要去找他的好朋友们或者他的囶子来获得他的信息。在这种情况下,降维算法和别的一些算法(比如决策树、随机森林、PCA、因子 分析)帮助我们根据相关矩阵、缺失的值的比例和别的要素来找出这些重要变量。他很可能会目测人们的身高和体形,综合这些可见的参数来排列他们,这是现实生活中使用线性回归的例子.实际上,这个孩子发现了身高和体形、体重有一定的关系,这个关系看起来很像上面的等式。使用 均值算法来将一个数据归入一定数量的集群(假设有 个集群)的过程是简单的。

2301_76161259的博客 3697

FinRL实战:5步搞定股票量化交易策略(附Python代码)

本文详细介绍了如何使用FinRL框架,通过5个步骤构建基于深度强化学习的股票量化交易策略。内容涵盖从环境搭建、数据获取与预处理,到交易环境构建、模型训练(如PPO算法),以及策略回测评估与优化的完整流程,并提供了可运行的Python代码示例,帮助读者快速入门AI驱动的量化交易。

weixin_29062865的博客 631

非目标代谢组学(untargeted metabolomics)中常用的方法学考察的方法(四)

最早使用的一种方法,从QC样本的总离子流图中选择具有代表性的离子峰(覆盖不同的保留时间,不同的强度),在对QC样本进行重复检测之后,计算这些离子的保留时间以及峰面积的相对标准偏差(RSD),用以考察分析方法的稳定性以及重复性。所有样品检测完之后,收集所有的QC样本的原始数据进行数据预处理,包括(峰提取,排列,归一化等),经过数据过滤(80%规则)之后,计算剩下的峰的峰面积的RSD值。由于QC样本是 等量混合了所有的被检测样本,理论上QC样本包含了所有样本中的代谢物,因此QC样本理论上会。

hlllllllhhhhh的博客 1490

Jupyter学习

Jupyter Notebook学习 1.Jupyter Notebook介绍 Jupyter项目是一个非盈利的开源项目,源于2014年的ipython项目,因为它逐渐发展为支持跨所有编程语言的交互式数据科学和科学计算 Jupyter Notebook,原名IPython Notbook,是IPython的加强网页版,一个开源Web应用程序 名字源自Julia、Python 和 R(数据科学的三...

weixin_45439324的博客 404

UE5实现距离测量功能

UE5实现距离测量功能

专注GIS开发 6270

人工智能: 手把手教你运行机器学习代码(EGNet)

文章目录手把手教你运行EGNet并进行量化评估建立信心功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 手把手教你运行EGNet并进行量化评估 大神大佬?先表示一下敬仰。 建立信心 各位广大刚刚开始学习人工智能的小伙伴们,看到矩阵运

m0_45314033的博客 6878

OpenCV实例(二)手势识别

手势识别的范围很广泛,在不同场景下,有不同类型的手势需要识别,例如:● 识别手势所表示的数值。● 识别手势在特定游戏中的含义,如“石头、剪刀、布”等。● 识别手势在游戏中表示的动作,如前进、跳跃、后退等。● 识别特定手势的含义,如表示“OK”的手势、表示胜利的手势等。理论基础凸包和凸缺陷在图像处理中具有非常重要的意义,被广泛地用于图像识别等领域。逼近多边形是轮廓的高度近似,但是有时候,我们希望使用一个多边形的凸包来简化它。凸包和逼近多边形很像,只不过凸包是物体最外层的凸多边形。

小幽余生不加糖 9411

关于 SAP UI5 应用 url 中的特殊符号 # 的作用介绍

符号在 SAP UI5 的 URL 中不仅仅是一个分隔符,更是动态路由、状态管理和深链接的关键所在。通过合理使用,开发者可以实现高效、流畅的用户体验,同时保持系统的可维护性和扩展性。通过 SAP UI5 提供的灵活路由机制,企业应用可以轻松实现复杂导航需求,同时为用户提供直观的交互体验。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 415

如何快速掌握机器学习:Hands-on ML3 终极零基础入门指南

欢迎来到机器学习的世界!如果你一直想学习机器学习但不知道从何开始,那么Hands-on ML3项目就是为你量身打造的完美起点。这个开源项目提供了一系列Jupyter笔记本,通过Scikit-Learn、Keras和TensorFlow 2等流行工具,手把手教你掌握机器学习和深度学习的核心概念。 ## 🚀 为什么选择Hands-on ML3? Hands-on ML3是《动手学机器学习》第三版

gitblog_01161的博客 818

Android框架WiFi架构

动平台,它主要是用来支持WEP,WPA/WPA2和WAPI无线协议和加密认证的,而实际上工作内容是通过socket(不管是wpa_supplicant与上层还是wpa_spplicant与驱动都采用socket通讯)与驱动交互上报数据给用户,而用户可以通过socket发送命令给wpa_supplicant调试来对wifi芯片操作,简单的说,二、android wifi 系统架构:andtoid wifi 系统引入了wpa_supplicant,它的整个wifi系统。

手机-手表蓝牙开发工程师的博客 3459

零基础入门Hands-On ML3:机器学习工作流详解

想要快速掌握机器学习,但面对复杂的理论和代码感到无从下手?Hands-On ML3项目为你提供了一条清晰的**机器学习学习路径**,通过20个精心设计的Jupyter笔记本,带你从零开始构建完整的**机器学习项目工作流**。这个项目使用Python、Scikit-Learn、Keras和TensorFlow 2等流行工具,让学习过程更加直观和实践导向。 ## 🤖 什么是机器学习工作流? **

gitblog_00621的博客 571

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

机器学习入门书:动手学机器学习

上海交通大学ACM班创办人俞勇教授团队编写,"西瓜书"作者周志华力荐的机器学习入门书:《动手学机器学习》出版啦!

人邮异步社区 1216

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

《动手学机器学习》项目教程

《动手学机器学习》项目教程 1. 项目目录结构及介绍 本项目是基于《动手学机器学习》的第二版,包含了书中所有的示例代码和练习题答案。项目的目录结构如下: handson-ml2/ ├── datasets/ # 存放数据集的目录 ├── docker/ # 存放Docker相关文件的目录 ├── images/ # 存放项目相关图片的目...

gitblog_00312的博客 371

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

ML for Beginners 第一课精读:什么是机器学习——从 AI/ML/深度学习关系图到本地学习环境搭建

本篇指南基于 ML for Beginners(12 周、26 课、52 题测验的经典机器学习课程)第一组“Introduction”的第一课 [Introduction to machine learning](https://link.gitcode.com/i/86cb44c9e224f358869ee2f777df06f9) 展开:讲清机器学习的定义、它与 AI 和深度学习的边界、课程覆盖

gitblog_00297的博客 657

交大ACM班团队出品,动手学机器学习!

Datawhale分享学习生态伙伴:上海交大ACM班最近,彪悍的上海交大 ACM 班俞勇教授团队推出了一本重量级新书——《动手学机器学习》。这对于技术人来说是难得的福音,因为它一次性讲明白了机器学习这回事。上海交大 ACM 班到底有多彪悍?看看它的杰出校友们吧。科研领域有在斯坦福任教的杨笛一,有在卡耐基梅隆大学任教的陈天奇,他也是 XGBoost 作者、TVM发起人。企业界则有依图科技联合创始...

Datawhale 464

探索ML2021-Spring: 一个实战型机器学习教程项目

探索ML2021-Spring: 一个实战型机器学习教程项目 去发现同类优质开源项目:https://gitcode.com/ 项目简介 是一个基于GitCode平台的开源项目,旨在提供一套全面、实践性强的机器学习教程。该项目由ga642381发起,以2021年春季学期为背景,涵盖了广泛的机器学习主题,并提供了丰富的代码示例和实际应用案例,帮助开发者和学生快速理解和掌握机器学习技术。 技术分析 该...

gitblog_00006的博客 367

开源机器学习项目Handson-ML的常见问题解答

开源机器学习项目Handson-ML的常见问题解答 【免费下载链接】handson-ml 该仓库包含《Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow》一书的所有代码示例,为初学者提供实战式的学习路径。 ...

gitblog_00169的博客 414

ML2Scratch深度解析:如何在Scratch中构建可视化机器学习应用

ML2Scratch是一个革命性的开源项目,它将TensorFlow.js的强大机器学习能力无缝集成到Scratch可视化编程环境中,让教育工作者和学生能够在熟悉的积木式编程界面中体验和创建AI应用。这个项目打破了机器学习的技术壁垒,为初学者提供了一个零代码的AI开发平台。 ## 技术价值宣言:重新定义AI教育工具 在当今AI技术蓬勃发展的时代,ML2Scratch代表着机器学习民主化的重要一

gitblog_00837的博客 1064

《动手学机器学习第二版》环境配置完全指南

《动手学机器学习第二版》是一本广受欢迎的机器学习实践教程,通过Jupyter Notebook形式提供了大量可运行的代码示例。本文将详细介绍如何搭建完整的开发环境,让你能够顺利运行书中的所有示例代码。 ## 环境准备 ### 1. 获取项目代码 首先需要将项目代码下载到本地开发环境。推荐使用git工具进行克隆: ```bash cd ~ # 切换到用户主目录 git clone 项目仓库...

gitblog_00794的博客 515

探索机器学习世界:Avik Jain的《100天ML代码》项目

探索机器学习世界:Avik Jain的《100天ML代码》项目 100-Days-Of-ML-Code100 Days of ML Coding项目地址:https://gitcode.com/gh_mirrors/10/100-Days-Of-ML-Code 项目简介 在这个高速发展的数字化时代,机器学习(Machine Learning)已经成为了一种重要的工具,助力我们处理复杂的数据问题。...

gitblog_00028的博客 1126

图灵程序设计丛书:用Python动手学系列

图灵程序设计丛书:用Python动手学系列

hacker707的博客 2万+

探秘PowersYang的Coursera_ML_Exercise:机器学习实战宝典

探秘PowersYang的Coursera_ML_Exercise:机器学习实战宝典 去发现同类优质开源项目:https://gitcode.com/ 在这个数据爆炸的时代,机器学习已经成为我们理解和挖掘这些海量信息的关键工具。 的 项目,就是一份基于吴恩达在Coursera上的《机器学习》课程的实战练习集,旨在帮助初学者和有经验的数据科学家更好地掌握机器学习的核心概念。 项目简介 该项目是一个...

gitblog_00022的博客 312

机器学习入门第一课:理解 ML-For-Beginners 课程中的经典机器学习、环境搭建与学习路径

本课是《Machine Learning for Beginners》(ML-For-Beginners)12 周课程体系的第一课,也是整个课程的开篇与"地基":它既回答"机器学习到底是什么、它与人工智能、深度学习、数据科学有何区别",也手把手指导你完成 Python、Scikit-learn、Node.js 等本地环境的搭建。读完本文,你将掌握这一课程的学习节奏(课前测验 → 精读课文 → 动手

gitblog_00438的博客 433
上一篇: 孙悟空无姓无名的时候,阎王生死簿是怎么写的呢?
下一篇: 初学者也能看懂的隐马尔科夫模型介绍
机器学习算法那些事
博客等级 码龄9年 1633粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值