* 一、集合框架的概述
*
* 1. 集合、数组都是对多个数据进行存储操作的结构,简称Java 容器。
* 说明:此时的存储,主要指的是内存层面的存储,不涉及到持久化的存储(. txt, . jpg, . avi,数据库中)
*
* 2.1 数组在存储多个数据方面的特点:
* > 一旦初始化以后,其长度就确定了。
* > 数组一旦定义好,其元素的类型也就确定了。我们也就只能操作指定类型的数据了。
* 比如:String [ ] arr; int [ ] arr1; Object [ ] arr2;
* 2.2 数组在存储多个数据方面的缺点:
* > 一旦初始化以后,其长度就不可修改。
* > 数组中提供的方法非常有限,对于添加、删除、插入数据等操作,非常不便,同时效率不高。
* > 获取数组中实际元素的个数的需求,数组没有现成的属性或方法可用
* > 数组存储数据的特点:有序、可重复。对于无序、不可重复的需求,不能满足。
*
* 二、集合框架
* | -- -- Collection 接口:单列集合,用来存储一个一个的对象
* | -- -- List 接口:存储有序的、可重复的数据。 -- > “动态”数组
* | -- -- ArrayList 、LinkedList 、Vector
*
* | -- -- Set 接口:存储无序的、不可重复的数据 -- > 高中讲的“集合”
* | -- -- HashSet 、LinkedHashSet 、TreeSet
*
* | -- -- Map 接口:双列集合,用来存储一对( key - value) 一对的数据 -- > 高中函数:y = f ( x)
* | -- -- HashMap 、LinkedHashMap 、TreeMap 、Hashtable 、Properties
*
*
* contains ( Object obj) : 判断当前集合中是否包含obj
向Collection 接口的实现类的对象中添加数据obj时,要求obj所在类要重写equals ( ) .
* containsAll ( Collection coll1) : 判断形参coll1中的所有元素是否都存在于当前集合中。
@Test
public void test1 ( ) {
Collection coll = new ArrayList ( ) ;
coll. add ( 123 ) ;
coll. add ( 456 ) ;
coll. add ( new Person ( "Jerry" , 20 ) ) ;
coll. add ( new String ( "Tom" ) ) ;
coll. add ( false ) ;
boolean contains = coll. contains ( 123 ) ;
System . out. println ( contains) ;
System . out. println ( coll. contains ( new String ( "Tom" ) ) ) ;
System . out. println ( coll. contains ( new Person ( "Jerry" , 20 ) ) ) ;
Collection coll1 = Arrays . asList ( 123 , 4567 ) ;
System . out. println ( coll. containsAll ( coll1) ) ;
}
* remove ( Object obj) : 从当前集合中移除obj元素。
* removeAll ( Collection coll1) : 差集:从当前集合中移除coll1中所有的元素。
@Test
public void test2 ( ) {
Collection coll = new ArrayList ( ) ;
coll. add ( 123 ) ;
coll. add ( 456 ) ;
coll. add ( new Person ( "Jerry" , 20 ) ) ;
coll. add ( new String ( "Tom" ) ) ;
coll. add ( false ) ;
coll. remove ( 1234 ) ;
System . out. println ( coll) ;
coll. remove ( new Person ( "Jerry" , 20 ) ) ;
System . out. println ( coll) ;
Collection coll1 = Arrays . asList ( 123 , 456 ) ;
coll. removeAll ( coll1) ;
System . out. println ( coll) ;
}
* retainAll ( Collection coll1) : 交集:获取当前集合和coll1集合的交集,并返回给当前集合
* equals ( Object obj) : 要想返回true ,需要当前集合和形参集合的元素都相同。
@Test
public void test3 ( ) {
Collection coll = new ArrayList ( ) ;
coll. add ( 123 ) ;
coll. add ( 456 ) ;
coll. add ( new Person ( "Jerry" , 20 ) ) ;
coll. add ( new String ( "Tom" ) ) ;
coll. add ( false ) ;
Collection coll1 = new ArrayList ( ) ;
coll1. add ( 456 ) ;
coll1. add ( 123 ) ;
coll1. add ( new Person ( "Jerry" , 20 ) ) ;
coll1. add ( new String ( "Tom" ) ) ;
coll1. add ( false ) ;
System . out. println ( coll. equals ( coll1) ) ;
}
* hashCode ( ) : 返回当前对象的哈希值
* 集合 -- -> 数组:toArray ( )
* 数组 -- -> 集合: 调用Arrays 类的静态方法asList ( )
@Test
public void test4 ( ) {
Collection coll = new ArrayList ( ) ;
coll. add ( 123 ) ;
coll. add ( 456 ) ;
coll. add ( new Person ( "Jerry" , 20 ) ) ;
coll. add ( new String ( "Tom" ) ) ;
coll. add ( false ) ;
System . out. println ( coll. hashCode ( ) ) ;
Object [ ] arr = coll. toArray ( ) ;
for ( int i = 0 ; i < arr. length; i++ ) {
System . out. println ( arr[ i] ) ;
}
List < String > = Arrays . asList ( new String [ ] { "AA" , "BB" , "CC" } ) ;
System . out. println ( list) ;
List arr1 = Arrays . asList ( new int [ ] { 123 , 456 } ) ;
System . out. println ( arr1. size ( ) ) ;
List arr2 = Arrays . asList ( new Integer [ ] { 123 , 456 } ) ;
System . out. println ( arr2. size ( ) ) ;
}
* 集合元素的遍历操作,使用迭代器Iterator 接口
* 1. 内部的方法:hasNext ( ) 和 next ( )
* 2. 集合对象每次调用iterator ( ) 方法都得到一个全新的迭代器对象,
* 默认游标都在集合的第一个元素之前。
* 3. 内部定义了remove ( ) , 可以在遍历的时候,删除集合中的元素。此方法不同于集合直接调用remove ( )
public void test1 ( ) {
Collection coll = new ArrayList ( ) ;
coll. add ( 123 ) ;
coll. add ( 456 ) ;
coll. add ( new Person ( "Jerry" , 20 ) ) ;
coll. add ( new String ( "Tom" ) ) ;
coll. add ( false ) ;
Iterator iterator = coll. iterator ( ) ;
while ( iterator. hasNext ( ) ) {
System . out. println ( iterator. next ( ) ) ;
}
}
@Test
public void test2 ( ) {
Collection coll = new ArrayList ( ) ;
coll. add ( 123 ) ;
coll. add ( 456 ) ;
coll. add ( new Person ( "Jerry" , 20 ) ) ;
coll. add ( new String ( "Tom" ) ) ;
coll. add ( false ) ;
while ( coll. iterator ( ) . hasNext ( ) ) {
System . out. println ( coll. iterator ( ) . next ( ) ) ;
}
}
@Test
public void test3 ( ) {
Collection coll = new ArrayList ( ) ;
coll. add ( 123 ) ;
coll. add ( 456 ) ;
coll. add ( new Person ( "Jerry" , 20 ) ) ;
coll. add ( new String ( "Tom" ) ) ;
coll. add ( false ) ;
Iterator iterator = coll. iterator ( ) ;
while ( iterator. hasNext ( ) ) {
Object obj = iterator. next ( ) ;
if ( "Tom" . equals ( obj) ) {
iterator. remove ( ) ;
}
}
iterator = coll. iterator ( ) ;
while ( iterator. hasNext ( ) ) {
System . out. println ( iterator. next ( ) ) ;
}
* for ( 集合元素的类型 局部变量 : 集合对象)
* 内部仍然调用了迭代器。
@Test
public void test1 ( ) {
Collection coll = new ArrayList ( ) ;
coll. add ( 123 ) ;
coll. add ( 456 ) ;
coll. add ( new Person ( "Jerry" , 20 ) ) ;
coll. add ( new String ( "Tom" ) ) ;
coll. add ( false ) ;
for ( Object obj : coll) {
System . out. println ( obj) ;
}
}
@Test
public void test2 ( ) {
int [ ] arr = new int [ ] { 1 , 2 , 3 , 4 , 5 , 6 } ;
for ( int i : arr) {
System . out. println ( i) ;
}
}
@Test
public void test3 ( ) {
String [ ] arr = new String [ ] { "MM" , "MM" , "MM" } ;
for ( String s : arr) {
s = "GG" ;
}
for ( int i = 0 ; i < arr. length; i++ ) {
System . out. println ( arr[ i] ) ;
}
}
* 1. List 接口框架
*
* | -- -- Collection 接口:单列集合,用来存储一个一个的对象
* | -- -- List 接口:存储有序的、可重复的数据。 -- > “动态”数组, 替换原有的数组
* | -- -- ArrayList :作为List 接口的主要实现类;线程不安全的,效率高;底层使用Object [ ] elementData存储
* | -- -- LinkedList :对于频繁的插入、删除操作,使用此类效率比ArrayList 高;底层使用双向链表存储
* | -- -- Vector :作为List 接口的古老实现类;线程安全的,效率低;底层使用Object [ ] elementData存储
*
*
* 2. ArrayList 的源码分析:
* 2.1 jdk 7 情况下
* ArrayList list = new ArrayList ( ) ;
* list. add ( 123 ) ;
* . . .
* list. add ( 11 ) ;
* 默认情况下,扩容为原来的容量的1.5 倍,同时需要将原有数组中的数据复制到新的数组中。
*
* 结论:建议开发中使用带参的构造器:ArrayList list = new ArrayList ( int capacity)
*
* 2.2 jdk 8 中ArrayList 的变化:
* ArrayList list = new ArrayList ( ) ;
*
* list. add ( 123 ) ;
* . . .
* 后续的添加和扩容操作与jdk 7 无异。
* 2.3 小结:jdk7中的ArrayList 的对象的创建类似于单例的饿汉式,而jdk8中的ArrayList 的对象
* 的创建类似于单例的懒汉式,延迟了数组的创建,节省内存。
*
* 3. LinkedList 的源码分析:
* LinkedList list = new LinkedList ( ) ; 内部声明了Node 类型的first和last属性,默认值为null
* list. add ( 123 ) ;
*
* 其中,Node 定义为:体现了LinkedList 的双向链表的说法
* private static class Node < E > {
E item;
Node < E > ;
Node < E > ;
Node ( Node < E > , E element, Node < E > ) {
this . item = element;
this . next = next;
this . prev = prev;
}
}
*
* 4. Vector 的源码分析:jdk7和jdk8中通过Vector ( ) 构造器创建对象时,底层都创建了长度为10 的数组。
* 在扩容方面,默认扩容为原来的数组长度的2 倍。
*
* 面试题:ArrayList 、LinkedList 、Vector 三者的异同?
* 同:三个类都是实现了List 接口,存储数据的特点相同:存储有序的、可重复的数据
* 不同:见上
void add ( int index, Object ele) : 在index位置插入ele元素
boolean addAll ( int index, Collection eles) : 从index位置开始将eles中的所有元素添加进来
Object get ( int index) : 获取指定index位置的元素
int indexOf ( Object obj) : 返回obj在集合中首次出现的位置
int lastIndexOf ( Object obj) : 返回obj在当前集合中末次出现的位置
Object remove ( int index) : 移除指定index位置的元素,并返回此元素
Object set ( int index, Object ele) : 设置指定index位置的元素为ele
List subList ( int fromIndex, int toIndex) : 返回从fromIndex到toIndex位置的子集合
总结:常用方法
增:add ( Object obj)
删:remove ( int index) / remove ( Object obj)
改:set ( int index, Object ele)
查:get ( int index)
插:add ( int index, Object ele)
长度:size ( )
遍历:① Iterator 迭代器方式
② 增强for 循环
③ 普通的循环
@Test
public void testListRemove ( ) {
List list = new ArrayList ( ) ;
list. add ( 1 ) ;
list. add ( 2 ) ;
list. add ( 3 ) ;
updateList ( list) ;
System . out. println ( list) ;
}
private void updateList ( List list) {
list. remove ( new Integer ( 2 ) ) ;
}
* | -- -- Collection 接口:单列集合,用来存储一个一个的对象
* | -- -- Set 接口:存储无序的、不可重复的数据 -- > 高中讲的“集合”
* | -- -- HashSet :作为Set 接口的主要实现类;线程不安全的;可以存储null 值
* | -- -- LinkedHashSet :作为HashSet 的子类;遍历其内部数据时,可以按照添加的顺序遍历( 双向链表记住添加时的位置)
| -- -- 对于频繁的遍历操作,LinkedHashSet 效率高于HashSet .
| -- -- 内部使用HashMap 来存储数据,数据存储在HashMap 的key中,value都是同一个默认值。
* | -- -- TreeSet :可以按照添加对象的指定属性,进行排序。
*
* 1. Set 接口中没有额外定义新的方法,使用的都是Collection 中声明过的方法。
*
* 2. 要求:向Set ( 主要指:HashSet 、LinkedHashSet ) 中添加的数据,其所在的类一定要重写hashCode ( ) 和equals ( )
* 要求:重写的hashCode ( ) 和equals ( ) 尽可能保持一致性:相等的对象必须具有相等的散列码
* 重写两个方法的小技巧:对象中用作 equals ( ) 方法比较的 Field ,都应该用来计算 hashCode 值。
一、Set :存储无序的、不可重复的数据
以HashSet 为例说明:
1. 无序性:不等于随机性。存储的数据在底层数组中并非按照数组索引的顺序添加,而是根据数据的哈希值决定的。
2. 不可重复性:保证添加的元素按照equals ( ) 判断时,不能返回true . 即:相同的元素只能添加一个。
二、添加元素的过程:以HashSet 为例:
我们向HashSet 中添加元素a, 首先调用元素a所在类的hashCode ( ) 方法,计算元素a的哈希值,
此哈希值接着通过某种算法计算出在HashSet 底层数组中的存放位置(即为:索引位置),判断
数组此位置上是否已经有元素:
如果此位置上没有其他元素,则元素a添加成功。 -- -> 情况1
如果此位置上有其他元素b ( 或以链表形式存在的多个元素),则比较元素a与元素b的hash值:
如果hash值不相同,则元素a添加成功。-- -> 情况2
如果hash值相同,进而需要调用元素a所在类的equals ( ) 方法:
equals ( ) 返回true , 元素a添加失败
equals ( ) 返回false , 则元素a添加成功。-- -> 情况2
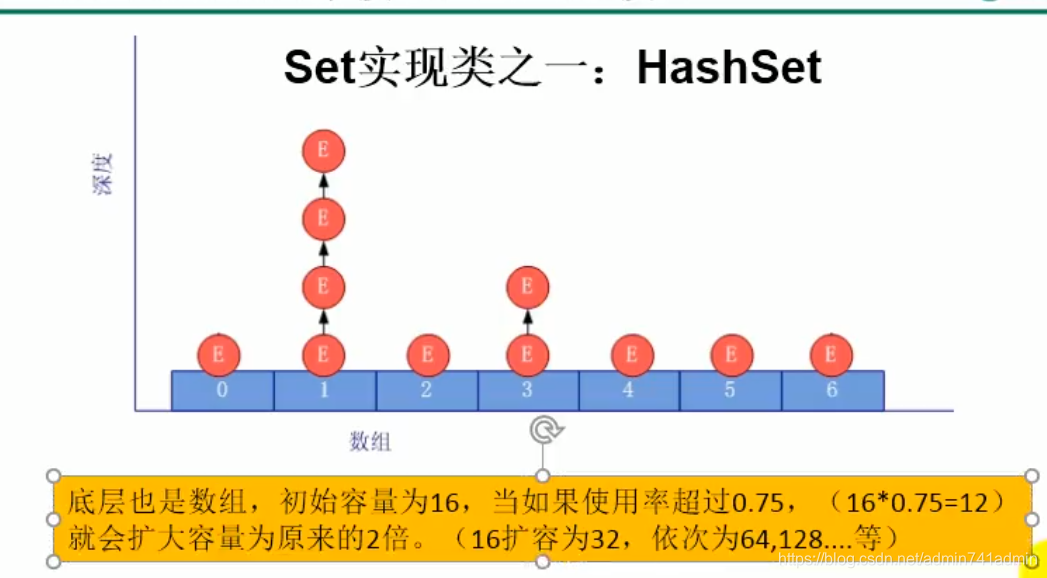
对于添加成功的情况2 和情况3 而言:元素a 与已经存在指定索引位置上数据以链表的方式存储。
jdk 7 : 元素a放到数组中,指向原来的元素。
jdk 8 : 原来的元素在数组中,指向元素a
总结:七上八下
HashSet 底层:数组+ 链表的结构。
内部使用HashMap 来存储数据,数据存储在HashMap 的key中,value都是同一个默认值。
* LinkedHashSet 作为HashSet 的子类,在添加数据的同时,每个数据还维护了两个引用,记录此数据前一个
* 数据和后一个数据。
* 优点:对于频繁的遍历操作,LinkedHashSet 效率高于HashSet
* 向TreeSet 中添加的数据,要求是相同类的对象。
* 两种排序方式:自然排序(实现Comparable 接口) 和 定制排序(Comparator )
* 自然排序中,比较两个对象是否相同的标准为:compareTo ( ) 返回0. 不再是equals ( ) .
* 定制排序中,比较两个对象是否相同的标准为:compare ( ) 返回0. 不再是equals ( ) .
* 一、Map 的实现类的结构:
* | -- -- Map : 双列数据,存储key- value对的数据 -- - 类似于高中的函数:y = f ( x)
* | -- -- HashMap : 作为Map 的主要实现类;线程不安全的,效率高;存储null 的key和value
* | -- -- LinkedHashMap : 保证在遍历map元素时,可以按照添加的顺序实现遍历。
* 原因:在原有的HashMap 底层结构基础上,添加了一对指针,指向前一个和后一个元素。
* 对于频繁的遍历操作,此类执行效率高于HashMap 。
* | -- -- TreeMap : 保证按照添加的key- value对进行排序,实现排序遍历。此时考虑key的自然排序或定制排序
* 底层使用红黑树
* | -- -- Hashtable : 作为古老的实现类;线程安全的,效率低;不能存储null 的key和value
* | -- -- Properties : 常用来处理配置文件。key和value都是String 类型
*
*
* HashMap 的底层:数组+ 链表 (jdk7及之前)
* 数组+ 链表+ 红黑树 (jdk 8 )
* 二、Map 结构的理解:
* Map 中的key: 无序的、不可重复的,使用Set 存储所有的key -- -> key所在的类要重写equals ( ) 和hashCode ( ) (以HashMap 为例)
* Map 中的value: 无序的、可重复的,使用Collection 存储所有的value -- -> value所在的类要重写equals ( )
* 一个键值对:key- value构成了一个Entry 对象。
* Map 中的entry: 无序的、不可重复的,使用Set 存储所有的entry
* 三、HashMap 的底层实现原理?以jdk7为例说明:
* HashMap map = new HashMap ( ) :
* 在实例化以后,底层创建了长度是16 的一维数组Entry [ ] table。
* . . . 可能已经执行过多次put. . .
* map. put ( key1, value1) :
* 首先,调用key1所在类的hashCode ( ) 计算key1哈希值,此哈希值经过某种算法计算以后,得到在Entry 数组中的存放位置。
* 如果此位置上的数据为空,此时的key1- value1添加成功。 -- -- 情况1
* 如果此位置上的数据不为空,( 意味着此位置上存在一个或多个数据( 以链表形式存在) ) , 比较key1和已经存在的一个或多个数据
* 的哈希值:
* 如果key1的哈希值与已经存在的数据的哈希值都不相同,此时key1- value1添加成功。-- -- 情况2
* 如果key1的哈希值和已经存在的某一个数据( key2- value2) 的哈希值相同,继续比较:调用key1所在类的equals ( key2) 方法,比较:
* 如果equals ( ) 返回false : 此时key1- value1添加成功。-- -- 情况3
* 如果equals ( ) 返回true : 使用value1替换value2。
*
* 补充:关于情况2 和情况3 :此时key1- value1和原来的数据以链表的方式存储。
*
* 在不断的添加过程中,会涉及到扩容问题,当超出临界值( 且要存放的位置非空) 时,扩容。默认的扩容方式:扩容为原来容量的2 倍,并将原有的数据复制过来。
*
* jdk8 相较于jdk7在底层实现方面的不同:
* 1. new HashMap ( ) : 底层没有创建一个长度为16 的数组
* 2. jdk 8 底层的数组是:Node [ ] , 而非Entry [ ]
* 3. 首次调用put ( ) 方法时,底层创建长度为16 的数组
* 4. jdk7底层结构只有:数组+ 链表。jdk8中底层结构:数组+ 链表+ 红黑树。
* 4.1 形成链表时,七上八下(jdk7: 新的元素指向旧的元素。jdk8:旧的元素指向新的元素)
4.2 当数组的某一个索引位置上的元素以链表形式存在的数据个数 > 8 且当前数组的长度 > 64 时,此时此索引位置上的所数据改为使用红黑树存储。
*
* DEFAULT_INITIAL_CAPACITY : HashMap 的默认容量,16
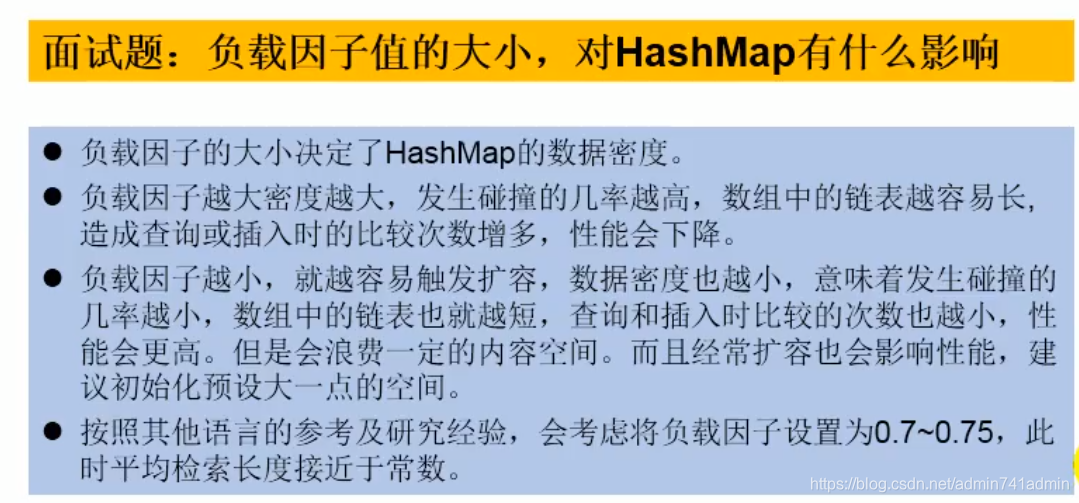
* DEFAULT_LOAD_FACTOR :HashMap 的默认加载因子:0.75
* threshold:扩容的临界值,= 容量* 填充因子:16 * 0.75 = > 12
* TREEIFY_THRESHOLD :Bucket 中链表长度大于该默认值,转化为红黑树: 8
* MIN_TREEIFY_CAPACITY :桶中的Node 被树化时最小的hash表容量: 64
* 四、LinkedHashMap 的底层实现原理(了解)
* 源码中:
* static class Entry < K , V > extends HashMap. Node < K , V > {
Entry < K , V > , after;
Entry ( int hash, K key, V value, Node < K , V > ) {
super ( hash, key, value, next) ;
}
}
* 五、Map 中定义的方法:
添加、删除、修改操作:
Object put ( Object key, Object value) :将指定key- value添加到( 或修改) 当前map对象中
void putAll ( Map m) : 将m中的所有key- value对存放到当前map中
Object remove ( Object key) :移除指定key的key- value对,并返回value
void clear ( ) :清空当前map中的所有数据
元素查询的操作:
Object get ( Object key) :获取指定key对应的value
boolean containsKey ( Object key) :是否包含指定的key
boolean containsValue ( Object value) :是否包含指定的value
int size ( ) :返回map中key- value对的个数
boolean isEmpty ( ) :判断当前map是否为空
boolean equals ( Object obj) :判断当前map和参数对象obj是否相等
元视图操作的方法:
Set keySet ( ) :返回所有key构成的Set 集合
Collection values ( ) :返回所有value构成的Collection 集合
Set entrySet ( ) :返回所有key- value对构成的Set 集合
* 总结:常用方法:
* 添加:put ( Object key, Object value)
* 删除:remove ( Object key)
* 修改:put ( Object key, Object value)
* 查询:get ( Object key)
* 长度:size ( )
* 遍历:keySet ( ) / values ( ) / entrySet ( )
Map map = new HashMap ( ) ;
map. put ( "AA" , 123 ) ;
map. put ( 45 , 1234 ) ;
map. put ( "BB" , 56 ) ;
Set set = map. keySet ( ) ;
Iterator iterator = set. iterator ( ) ;
while ( iterator. hasNext ( ) ) {
System . out. println ( iterator. next ( ) ) ;
}
System . out. println ( "**********************************" ) ;
Collection values = map. values ( ) ;
Iterator iterator1 = values. iterator ( ) ;
while ( iterator1. hasNext ( ) ) {
System . out. println ( iterator1. next ( ) ) ;
}
System . out. println ( "**********************************" ) ;
Set set1 = map. entrySet ( ) ;
for ( Object obj: set1) {
Map. Entry item = ( Map. Entry ) obj;
System . out. println ( item. getKey ( ) ) ;
System . out. println ( item. getValue ( ) ) ;
}
Iterator iterator2 = set. iterator ( ) ;
while ( iterator2. hasNext ( ) ) {
Object key = iterator2. next ( ) ;
System . out. println ( key) ;
System . out. println ( map. get ( key) ) ;
}
* 向TreeMap 中添加key- value,要求key必须是由同一个类创建的对象
* 因为要按照key进行排序:自然排序 、定制排序
@Override
public int compareTo ( Object o) {
if ( o instanceof User ) {
User user = ( User ) o;
int compare = - this . name. compareTo ( user. name) ;
if ( compare != 0 ) {
return compare;
} else {
return Integer . compare ( this . age, user. age) ;
}
} else {
throw new RuntimeException ( "输入的类型不匹配" ) ;
}
}
@Test
public void test1 ( ) {
TreeMap map = new TreeMap ( ) ;
User u1 = new User ( "Tom" , 23 ) ;
User u2 = new User ( "Jerry" , 32 ) ;
User u3 = new User ( "Jack" , 20 ) ;
User u4 = new User ( "Rose" , 18 ) ;
map. put ( u1, 98 ) ;
map. put ( u2, 89 ) ;
map. put ( u3, 76 ) ;
map. put ( u4, 100 ) ;
Set entrySet = map. entrySet ( ) ;
Iterator iterator1 = entrySet. iterator ( ) ;
while ( iterator1. hasNext ( ) ) {
Object obj = iterator1. next ( ) ;
Map. Entry entry = ( Map. Entry ) obj;
System . out. println ( entry. getKey ( ) + "---->" + entry. getValue ( ) ) ;
}
}
@Test
public void test2 ( ) {
TreeMap map = new TreeMap ( new Comparator ( ) {
@Override
public int compare ( Object o1, Object o2) {
if ( o1 instanceof User && o2 instanceof User ) {
User u1 = ( User ) o1;
User u2 = ( User ) o2;
return Integer . compare ( u1. getAge ( ) , u2. getAge ( ) ) ;
}
throw new RuntimeException ( "输入的类型不匹配!" ) ;
}
} ) ;
User u1 = new User ( "Tom" , 23 ) ;
User u2 = new User ( "Jerry" , 32 ) ;
User u3 = new User ( "Jack" , 20 ) ;
User u4 = new User ( "Rose" , 18 ) ;
map. put ( u1, 98 ) ;
map. put ( u2, 89 ) ;
map. put ( u3, 76 ) ;
map. put ( u4, 100 ) ;
Set entrySet = map. entrySet ( ) ;
Iterator iterator1 = entrySet. iterator ( ) ;
while ( iterator1. hasNext ( ) ) {
Object obj = iterator1. next ( ) ;
Map. Entry entry = ( Map. Entry ) obj;
System . out. println ( entry. getKey ( ) + "---->" + entry. getValue ( ) ) ;
}
}
public static void main ( String [ ] args) {
FileInputStream fis = null ;
try {
Properties pros = new Properties ( ) ;
fis = new FileInputStream ( "jdbc.properties" ) ;
pros. load ( fis) ;
String name = pros. getProperty ( "name" ) ;
String password = pros. getProperty ( "password" ) ;
System . out. println ( "name = " + name + ", password = " + password) ;
} catch ( IOException e) {
e. printStackTrace ( ) ;
} finally {
if ( fis != null ) {
try {
fis. close ( ) ;
} catch ( IOException e) {
e. printStackTrace ( ) ;
}
}
}
}
List list = new ArrayList ( ) ;
list. add ( 123 ) ;
list. add ( 43 ) ;
list. add ( 765 ) ;
list. add ( - 97 ) ;
list. add ( 0 ) ;
List dest = Arrays . asList ( new Object [ list. size ( ) ] ) ;
System . out. println ( dest. size ( ) ) ;
Collections . copy ( dest, list) ;
System . out. println ( dest) ;



 807


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


